Data Transmission Service (DTS) を使用して、ApsaraDB RDS for PostgreSQL から AnalyticDB for PostgreSQL へ向けて継続的なデータパイプラインを構築します。DTS は論理レプリケーションを用いて初期の完全ロードおよび継続的な増分変更データキャプチャ(CDC)の両方を処理するため、ソースデータの変更に応じて分析用データベースを常に同期状態に保つことができます。
前提条件
開始する前に、以下の条件を満たしていることを確認してください。
ソースの ApsaraDB RDS for PostgreSQL インスタンス内の全データサイズよりも大きな利用可能なストレージ容量を持つ AnalyticDB for PostgreSQL インスタンス。詳細については、「インスタンスの作成」をご参照ください。
同期対象のデータを受信するためのデータベースを、宛先の AnalyticDB for PostgreSQL インスタンス内に作成済みであること。詳細については、「SQL 構文」の「CREATE DATABASE」セクションをご参照ください。
ソースの ApsaraDB RDS for PostgreSQL インスタンス上で、対象データベースを所有する特権アカウント。詳細については、「アカウントの作成」および「データベースの作成」をご参照ください。
宛先の AnalyticDB for PostgreSQL インスタンス上で、読み取りおよび書き込み権限を持つデータベースアカウント。初期アカウントまたは RDS_SUPERUSER 権限を持つアカウントでも構いません。詳細については、「データベースアカウントの作成」および「ユーザーと権限の管理」をご参照ください。
課金
| 同期タイプ | 料金 |
|---|---|
| スキーマ同期および完全データ同期 | 無料 |
| 増分データ同期 | 課金対象です。「課金概要」をご参照ください。 |
増分同期でサポートされる SQL 操作
| 操作タイプ | SQL ステートメント |
|---|---|
| DML | INSERT、UPDATE、DELETE |
| DDL | CREATE TABLE、DROP TABLE、TRUNCATE TABLE(ソースの自主管理 PostgreSQL データベース 11+)、CREATE INDEX ON TABLE、および RENAME TABLE、ADD COLUMN、ADD COLUMN DEFAULT、ALTER COLUMN TYPE、DROP COLUMN、ADD CONSTRAINT、ADD CONSTRAINT CHECK、ALTER COLUMN DROP DEFAULT を含む ALTER TABLE 操作 |
DDL 同期の要件:
DDL 同期は、2020 年 10 月 1 日以降に作成されたタスクのみで利用可能です。
2023年5月12日より前に作成されたタスクについては、タスクの設定を行う前に、ソースデータベースでトリガーおよび関数を設定します。詳細については、「PostgreSQL データベース向けの増分 DDL 移行を実装するためのトリガーおよび関数の使用方法」をご参照ください。
DDL 同期には、ソースインスタンス上の特権データベースアカウントおよびマイナーエンジンバージョン 20210228 以降が必要です。詳細については、「マイナーエンジンバージョンの更新」をご参照ください。
増分データ同期中は BIT 型のデータを同期できません。
以下の DDL 操作は同期されません。
CASCADE や RESTRICT などの追加修飾子を含む DDL ステートメント
SET session_replication_role = replicaを実行したセッションからの DDL ステートメント関数を介して呼び出された DDL ステートメント
DML ステートメントと同じトランザクション内でコミットされた DDL ステートメント
同期範囲に含まれていないオブジェクトに対する DDL ステートメント
制限事項
テーブルおよびスキーマの要件
テーブルには PRIMARY KEY またはすべてのフィールドが一意である UNIQUE 制約が必要です。これを満たさないと、宛先データベースに重複レコードが発生する可能性があります。
説明DTS 外部で宛先テーブルを作成する場合(同期タイプで スキーマ同期 を選択しない場合)、宛先テーブルにはソーステーブルと同一の PRIMARY KEY または NOT NULL UNIQUE 制約を設定してください。
同期対象として選択できるのはテーブルのみであり、ビュー、関数、その他のオブジェクトタイプは選択できません。
1 つのタスクでは 1 つのデータベースからのみデータを同期できます。複数のデータベースを同期する場合は、それぞれのデータベースに対して個別のタスクを作成してください。
スキーマ間の継承関係を持つテーブルは同期できません。
宛先テーブルは append-optimized(AO)テーブルであってはなりません。
DTS は以下のデータ型を同期しません:VARBIT、GEOMETRY、UUID、TSQUERY、TSVECTOR、TXID_SNAPSHOT。
列マッピングおよびスキーマの差異
非完全テーブル同期で列マッピングを使用する場合、またはソースと宛先のテーブルスキーマが異なる場合、ソースに存在し宛先に存在しない列のデータは失われます。
オブジェクト名マッピング機能を用いて宛先データベースでテーブルまたは列の名前を変更する場合、1 つのタスクで 5,000 を超えるテーブルを同期するとリクエストエラーが発生します。5,000 を超えるテーブルを同期する場合は、複数のタスクを設定するか、代わりにデータベース全体を同期してください。
WAL ログの要件
ソースデータベースは、以下の先行書き込みログ(WAL)要件を満たす必要があります。
wal_levelをlogicalに設定します。増分のみの同期の場合:WAL ログを 24 時間以上保持します。
完全+増分同期の場合:WAL ログを最低 7 日間保持します。完全同期完了後は、保持期間を 24 時間以上に設定できます。
これらの要件を満たさない場合、DTS が WAL ログを取得できず、タスクが失敗するほか、例外的なケースではデータの不整合や損失が発生する可能性があります。
実行時の制約
スキーマ同期または完全データ同期中に DDL ステートメントを実行しないでください。実行するとタスクが失敗します。
同期対象のスキーマにテーブルを追加したり、RENAME を用いてテーブル名を変更したりする場合、そのテーブルにデータを書き込む前に、
ALTER TABLE schema.table REPLICA IDENTITY FULL;を実行してください。これによりデータの不整合を防止できます。デッドロックを回避するため、この操作は非ピーク時間帯に実行してください。説明schemaおよびtableは、実際のスキーマ名およびテーブル名に置き換えてください。ソースデータベース内に DTS が作成する一時テーブル:
public.dts_pg_class、public.dts_pg_attribute、public.dts_pg_type、public.dts_pg_enum、public.dts_postgres_heartbeat、public.dts_ddl_command、public.dts_args_session、public.aliyun_dts_instanceを削除しないでください。DTS はインスタンスのリリース時にこれらのテーブルを自動的に削除します。ソースデータベース内の長時間実行トランザクションは、WAL ログの蓄積を引き起こし、ディスク領域を枯渇させる可能性があります。
タスク実行中にソースデータベースでメジャーバージョンアップが行われると、タスクは失敗し、復旧できません。タスクを再構成してください。
単一の増分データ変更が 256 MB を超えてはなりません。超えた場合、タスクは失敗し、復旧できません。タスクを再構成してください。
レプリケーションスロット
DTS はソースデータベース内に、プレフィックス dts_sync_ を付与したレプリケーションスロットを作成します。このスロットは直近 15 分間の増分ログを保持します。
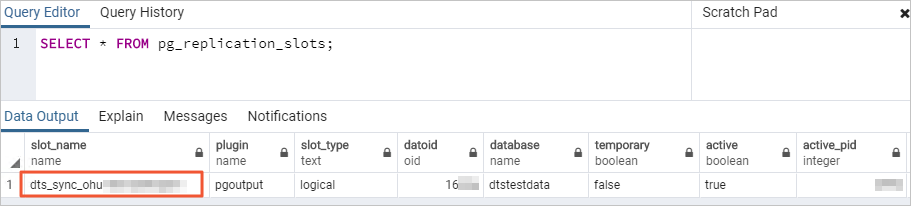
レプリケーションスロットは、DTS インスタンスのリリース時に自動的に削除されます。ただし、ソースデータベースのパスワードを変更したり、ホワイトリストから DTS の IP アドレスを削除したりした場合、スロットは自動削除されません。蓄積を防ぐため、手動で削除してください。
タスクがリリースまたは失敗した場合、DTS はレプリケーションスロットを自動的に削除します。ソースの PostgreSQL データベースでプライマリ/セカンダリスイッチオーバーが発生した後は、セカンダリデータベースにログインして、レプリケーションスロットを手動で削除してください。
DTS はまた、同期遅延を追跡するために、ソースデータベースに dts_postgres_heartbeat という名前のハートビートテーブルも追加します。
ソース固有の制約
ApsaraDB RDS for PostgreSQL:
タスク実行中にソースの ApsaraDB RDS for PostgreSQL インスタンスのエンドポイントまたはゾーンを変更しないでください。変更するとタスクが失敗します。
ソースインスタンスでプライマリ/セカンダリ スイッチオーバーを実行するには、まず論理レプリケーションスロットフェールオーバー機能を有効化します。「論理レプリケーションスロットフェールオーバー」を参照してください。
自主管理 PostgreSQL:
max_wal_sendersおよびmax_replication_slotsを、既存のレプリケーションスロット数と今後作成する DTS インスタンス数の合計より大きい値に設定してください。自主管理 PostgreSQL データベースでのプライマリ/セカンダリスイッチオーバーはタスクを失敗させます。
Google Cloud SQL for PostgreSQL:
データベースアカウント パラメーターを、
cloudsqlsuperuser権限を持つアカウントに設定してください。同期対象オブジェクトを選択する際は、そのアカウントが管理権限を持つオブジェクトのみを選択するか、該当オブジェクトに対して OWNER 権限をアカウントに付与してください。説明cloudsqlsuperuser権限を持つアカウントは、同じ権限を持つ他のアカウントが所有するデータを管理できません。
データ整合性
タスク開始前に、ソースおよび宛先データベースのパフォーマンスへの影響を評価してください。タスクは非ピーク時間帯に実行することを推奨します。
完全データ同期中、同時実行の INSERT 操作により宛先データベースでテーブルの断片化が発生するため、完全同期完了後の宛先表領域はソースよりも大きくなる可能性があります。
同期中に DTS 以外のソースから宛先データベースへデータが書き込まれると、データの不整合が発生します。他のソースが宛先へ書き込みを行う状態で Data Management(DMS)を用いてオンライン DDL 操作を実行した場合、データ損失が発生する可能性があります。
DTS のみを使用して送信先にデータを書き込む場合、同期中にソーステーブルでオンライン DDL 操作を実行するために DMS を使用します。詳細については、「テーブルのロックを解除せずにスキーマを変更する」をご参照ください。
タスクの復旧
DTS タスクが失敗した場合、DTS テクニカルサポートは 8 時間以内に回復を試みます。 回復中、タスクが再起動されたり、タスクパラメーター (データベースパラメーターではない) が変更されたりする場合があります。 変更される可能性のあるパラメーターの詳細については、「DTS インスタンスのパラメーターを変更する」の インスタンスパラメーターの変更 セクションをご参照ください。
データ同期タスクの構成
ステップ 1:データ同期タスクに移動
Data Management(DMS)コンソール にログインします。
上部のナビゲーションバーで、Data + AI をクリックします。
左側のナビゲーションウィンドウで、DTS(DTS) > データ同期 を選択します。
説明ナビゲーションは、DMS コンソールのモードおよびレイアウトによって異なる場合があります。『シンプルモード』および『DMS コンソールのレイアウトとスタイルをカスタマイズする』をご参照ください。
直接、新しい DTS コンソールのデータ同期タスクページ にアクセスすることもできます。
ステップ 2:タスクの作成
データ同期タスク の右側で、同期インスタンスを配置するリージョンを選択します。
説明新しい DTS コンソールでは、上部のナビゲーションバーでリージョンを選択します。
タスクの作成 をクリックします。
(任意)右上隅の 新規構成ページ をクリックします。
説明前のバージョンに戻る が表示されている場合は、このステップをスキップしてください。
新規構成ページを使用してください。バージョン間で一部のパラメーターが異なります。
ステップ 3:ソースおよび宛先データベースの構成
以下のパラメーターを構成します。
タスク名
| パラメーター | 説明 |
|---|---|
| タスク名 | DTS タスクの名前。DTS がデフォルト名を生成しますが、タスクを容易に識別できるよう、意味のある名前を指定することを推奨します。名前は一意である必要はありません。 |
ソースデータベース
| パラメーター | 説明 |
|---|---|
| DMS データベースインスタンスの選択 | 既存の登録済みデータベースを選択して設定を自動入力するか、空白のままにして手動で設定します。 データベースを登録するには、「Alibaba Cloud データベースインスタンスを登録する」または「サードパーティのクラウドサービス上のデータベースまたは自己管理データベースを登録する」をご参照ください。 DTS コンソールでの登録については、「データベース接続を管理する」をご参照ください。 |
| データベースタイプ | PostgreSQL を選択します。 |
| アクセス方法 | Alibaba Cloud インスタンス を選択します。 |
| インスタンスリージョン | ソースの ApsaraDB RDS for PostgreSQL インスタンスのリージョン。 |
| Alibaba Cloud アカウント間でのデータ複製 | 現在のアカウント内のデータベースを使用する場合は、いいえ を選択します。 |
| インスタンス ID | ソースの ApsaraDB RDS for PostgreSQL インスタンスの ID。 |
| データベース名 | 同期対象のデータを含むソースデータベースの名前。 |
| データベースアカウント | ソースインスタンスの特権アカウント。 |
| データベースパスワード | データベースアカウントのパスワード。 |
| 暗号化 | 標準接続の場合は、[暗号化なし] を選択し、暗号化接続の場合は [SSL 暗号化] を選択します。SSL の場合、CA 証明書 をアップロードし、必要に応じて クライアント証明書 および クライアント証明書の秘密鍵 もアップロードした後、[クライアント証明書の秘密鍵のパスワード] を設定します。「SSL 暗号化」をご参照ください。 |
宛先データベース
| パラメーター | 説明 |
|---|---|
| DMS データベースインスタンスの選択 | 設定を自動入力するため、既に登録済みのデータベースを選択するか、手動で構成します。 |
| データベースタイプ | AnalyticDB for PostgreSQL を選択します。 |
| アクセス方法 | Alibaba Cloud インスタンス を選択します。 |
| インスタンスリージョン | 宛先の AnalyticDB for PostgreSQL インスタンスのリージョン。 |
| インスタンス ID | 宛先の AnalyticDB for PostgreSQL インスタンスの ID。 |
| データベース名 | 宛先データベースの名前。 |
| データベースアカウント | 宛先インスタンスのアカウントで、読み取りおよび書き込み権限が必要です。 |
| データベースパスワード | データベースアカウントのパスワード。 |
ステップ 4:接続性のテスト
接続性のテストと続行 をクリックします。
DTS は、自動的にそのサーバーの CIDR ブロックを Alibaba Cloud データベースインスタンスのホワイトリストおよび ECS でホストされるデータベースのセキュリティグループルールに追加します。データセンター内またはサードパーティのクラウドプラットフォーム上の自己管理データベースの場合、DTS サーバーの CIDR ブロックを手動でデータベースのホワイトリストに追加します。詳細については、「DTS サーバーの CIDR ブロック」をご参照ください。
DTS の CIDR ブロックをホワイトリストまたはセキュリティグループに追加することは、セキュリティリスクを伴います。続行する前に、強力な認証情報の導入、公開ポートの制限、API 呼び出しの認証、ホワイトリストルールの定期監査、Express Connect、VPN Gateway、または Smart Access Gateway を用いたデータベースと DTS の接続など、予防措置を講じてください。
ステップ 5:同期対象の構成
同期タイプの選択
ご使用のユースケースに合った同期タイプを選択します。
| 同期タイプ | 選択タイミング |
|---|---|
| スキーマ同期 | DTS が宛先テーブルを自動作成する場合に選択します。完全データ同期も選択する場合は必須です。 |
| 完全データ同期 | 増分同期開始前に、ソースから宛先へ既存データをすべてコピーする場合に選択します。初期セットアップに必須です。 |
| 増分データ同期 | デフォルトで選択されています。論理レプリケーションを用いて、ソースにおける継続的な変更に応じて宛先を同期状態に保ちます。継続的な同期に必須です。 |
ほとんどの環境では、3 つの同期タイプすべてを選択することを推奨します。スキーマ同期によりテーブルが作成され、完全データ同期により履歴データがコピーされ、増分データ同期により宛先が最新の状態に保たれます。
オブジェクトおよび競合処理の構成
| パラメーター | 説明 |
|---|---|
| 同期対象の DDL および DML 操作 | 同期する SQL 操作。テーブルごとに構成する場合は、選択済みオブジェクト 内のオブジェクトを右クリックし、操作を選択します。詳細については、「増分同期でサポートされる SQL 操作」をご参照ください。 |
| 競合テーブルの処理モード | 事前チェックとエラー報告オブジェクト名マッピング:宛先テーブルとソーステーブルの名前が一致する場合、事前チェックが失敗します。競合を解決するには、 を使用してください。エラーを無視して続行:名前競合のチェックをスキップします。完全同期中は、主キーまたは一意キーが一致する既存の宛先レコードが保持され、増分同期中は上書きされます。スキーマが異なる場合、初期化が部分的に失敗する可能性があります。 |
| 宛先インスタンスにおけるオブジェクト名の大文字小文字 | DTS が宛先におけるデータベース名、テーブル名、および列名をどのように処理するか。デフォルトは DTS デフォルトポリシー です。詳細については、「宛先インスタンスにおけるオブジェクト名の大文字小文字の指定」をご参照ください。 |
| ソースオブジェクト | このセクションからオブジェクトを選択し、 をクリックして 選択済みオブジェクト に追加します。選択可能な粒度:列、テーブル、またはスキーマ。 |
| 選択済みオブジェクト | テーブルを右クリックして、その名前を変更したり、データフィルターを設定したり、テーブルごとの SQL 操作を構成したりできます。複数のオブジェクトの名前を一度に変更するには、[バッチ編集] をクリックします。詳細については、「オブジェクト名のマッピング」および「フィルター条件の設定」をご参照ください。 |
オブジェクト名マッピングを用いたオブジェクト名の変更により、依存オブジェクトの同期が失敗する場合があります。
高度な設定の構成
次へ:高度な設定 をクリックし、以下のパラメーターを構成します。
| パラメーター | 説明 |
|---|---|
| タスクスケジューリング用専用クラスター | DTS はデフォルトで共有クラスターを使用します。より高い安定性を実現するには、専用クラスターを購入してください。詳細については、「DTS 専用クラスターとは」をご参照ください。 |
| 失敗した接続の再試行時間 | タスク開始後に、DTS が失敗した接続を再試行する時間。範囲:10~1440 分。デフォルト:720 分。30 分を超える値を設定してください。この期間内に DTS が再接続できた場合、タスクは再開されます。それ以外の場合はタスクが失敗します。同一のソースまたは宛先を共有するタスク間では、最も短い値が適用されます。 |
| その他の問題の再試行時間 | DTS が失敗した DDL または DML 操作を再試行する時間。範囲:1~1440 分。デフォルト:10 分。10 分を超える値を設定し、かつ 失敗した接続の再試行時間 よりも短い値にしてください。 |
| 完全データ同期の負荷制御の有効化 | 完全同期中のソースおよび宛先データベースへの読み取り/書き込み負荷を制限します。ソースデータベースへのクエリ数(QPS)、完全データ移行の RPS、完全移行のデータ移行速度(MB/s) を構成します。完全データ同期 を選択した場合にのみ利用可能です。 |
| 増分データ同期の負荷制御の有効化 | 増分同期中の負荷を制限します。増分データ同期の RPS および 増分同期のデータ同期速度(MB/s) を構成します。 |
| 環境タグ | DTS インスタンスを環境別に識別するための任意のタグ。 |
| ETL の構成 | ETL 処理を有効にするには、[はい] に設定し、データ変換文を入力します。スキップするには、[いいえ] に設定します。「ETL とは?」および「データ移行またはデータ同期タスクで ETL を設定する」をご参照ください。 |
| モニタリングとアラート | [はい] に設定すると、タスクが失敗した場合、または同期遅延がしきい値を超えた場合にアラートを受信します。アラートのしきい値と通知設定を設定します。詳細については、「モニタリングとアラートを設定する」をご参照ください。 |
データ検証の構成
データ検証を設定するには、[次へ: データ検証] をクリックします。詳細については、「データ検証タスクの設定」をご参照ください。
(任意)データベースおよびテーブルフィールドの構成
次へ:データベースおよびテーブルフィールドの構成 をクリックして、宛先の AnalyticDB for PostgreSQL インスタンスにおけるテーブル構造を設定します。
| パラメーター | 説明 |
|---|---|
| タイプ | 宛先インスタンスにおけるテーブルタイプ。 |
| プライマリキー列 | プライマリキー列。複数の列を指定すると複合プライマリキーになります。 |
| 分散キー | テーブルの分散キー。これはプライマリキー列のいずれかである必要があります。詳細については、「テーブルの管理」および「テーブル分散の定義」をご参照ください。 |
このステップは、スキーマ同期 を選択した場合にのみ利用可能です。定義ステータス を すべて に設定すると、すべてのテーブルを表示および変更できます。
ステップ 6:設定の保存および事前チェックの実行
次へ:タスク設定の保存および事前チェック をクリックします。
このタスク構成の OpenAPI パラメーターをプレビューするには、ボタンにカーソルを合わせて OpenAPI パラメーターのプレビュー をクリックします。
DTS はタスク開始前に事前チェックを実行します。事前チェックが成功した場合にのみタスクが開始されます。
事前チェックが失敗した場合は、各失敗項目の横にある 詳細の表示 をクリックし、問題を解決した後、再度事前チェック をクリックします。
アラートがトリガーされた場合:無視できないアラートは、問題を解決してから再度事前チェックを実行してください。無視できるアラートの場合は、アラートの詳細の確認 をクリックし、その後 無視、OK、再度事前チェック の順にクリックします。アラートを無視すると、データの不整合が発生する可能性があります。
ステップ 7:インスタンスの購入および開始
成功率 が 100% に達するまで待機し、その後 次へ:インスタンスの購入 をクリックします。
購入ページで、以下の項目を構成します。
| パラメーター | 説明 |
|---|---|
| 課金方法 | サブスクリプション:固定期間分を前払いする方式で、長期利用の場合にコスト効率が高くなります。従量課金:1 時間単位で課金され、短期利用に適しています。インスタンスが不要になった場合は、課金を停止するためにインスタンスをリリースしてください。 |
| リソースグループ設定 | インスタンスのリソースグループです。デフォルト:default resource group。詳細については、「What is Resource Management? |
| インスタンスクラス | 同期速度の階層です。詳細については、「Instance classes of data synchronization instances」をご参照ください。 |
| サブスクリプション期間 | サブスクリプション課金方法でのみ利用可能です。選択肢:1~9 か月、1 年、2 年、3 年、または 5 年。 |
Data Transmission Service(従量課金)サービス利用規約 を読み、同意した上で、購入および開始 をクリックします。確認ダイアログで OK をクリックします。
タスクはタスクリストに表示されます。そこから進捗をモニターできます。
次のステップ
論理レプリケーションスロットのフェールオーバー — プライマリ/セカンダリ スイッチオーバーを実行する予定がある場合は、ソース RDS インスタンスでこの機能を有効化します。
オブジェクト名のマップ — 送信先のオブジェクトを名前変更し、ソース オブジェクトを変更せずに実行します。
「DTS インスタンスのパラメーターを変更する」— タスク開始後にタスクパラメーターを調整します。
データ検証タスクの設定 — ソースと送信先間のデータ整合性を検証します。