このガイドでは、Alibaba Cloud Data Management (DMS) ワークスペース内でマネージド MLflow サービスを作成、構成、使用する方法について説明します。DMS MLflow は、ご利用の Virtual Private Cloud (VPC) 内で機械学習の実験を追跡するための安全で安定したプラットフォームを提供し、モデルトレーニングの実行におけるメタデータ、パラメーター、メトリックを効率的に管理するのに役立ちます。
基本アーキテクチャ
マネージドサービス:DMS は、MLflow インスタンスのライフサイクルと、その基盤となるリソースのメンテナンスを管理します。
ネイティブ VPC 統合:MLflow サービスは、Application Load Balancer (ALB) を通じて VPC 内で安全に公開され、ネットワークの分離とセキュリティを確保します。
従量課金制:DMS Notebook などの環境とシームレスに統合され、実際の計算リソースの消費量に基づいて課金されます。
サポート対象リージョン
中国 (北京)、中国 (上海)、中国 (杭州)。 (このサービスは現在限定プレビュー中です。利用可能性は、コンソールでのサービスエントリの表示状況に依存します。)
前提条件
MLflow インスタンスを作成する前に、以下の前提条件を満たしてください。
ネットワークリソース
Virtual Private Cloud (VPC):既存の VPC が必要です。
vSwitch:高可用性を確保するために、VPC 内に異なるアベイラビリティゾーンにある少なくとも 2 つの vSwitch が必要です。
セキュリティグループ:セキュリティグループが必要です。MLflow サービスへのネットワークアクセスは、このセキュリティグループのインバウンドルールによって制御されます。
操作手順:「VPC と vSwitch」、「セキュリティグループの使用」をご参照ください。
Object Storage Service (OSS)
目的:モデルトレーニングのアーティファクト (モデルファイルやデータセットなど) を保存します。DMS MLflow はメタデータ (トレーニングプロセスのメトリックやアーティファクトの保存場所のメタデータを含む) のみを記録し、アーティファクトはお客様が提供する OSS バケットに保存する必要があります。
操作手順:「バケットの作成」をご参照ください。
ワークスペース
目的:ワークスペースは DMS の共同作業単位です。DMS MLflow インスタンスの作成、管理、可視化はワークスペース内で行う必要があります。
操作手順:「ワークスペースの準備」をご参照ください。
ALB サービスリンクロール
目的:DMS MLflow は、Application Load Balancer (ALB) を介して VPC 内でアクセスを提供します。ご利用のアカウントで ALB を一度も使用したことがない場合、必要なサービスリンクロールが存在せず、MLflow インスタンスの作成に失敗します。
操作手順:「サービスリンクロールの作成」をご参照ください。サービスリンクロールを作成 パネルで、信頼するクラウドサービス に [ALB] を選択します。
Notebook の作成
DMS 5.0 にログインします。
上部のメニューバーから [Data+AI] > [ワークスペース] を選択するか、シンプルモードで左上の
 アイコンをクリックして [すべての機能] > [Data+AI] > [ワークスペース] を選択します。
ワークスペースリストページで、対象のワークスペースを見つけ、その ID をクリックして入ります。
ワークスペース内で、Notebook セッション管理ページに移動します。
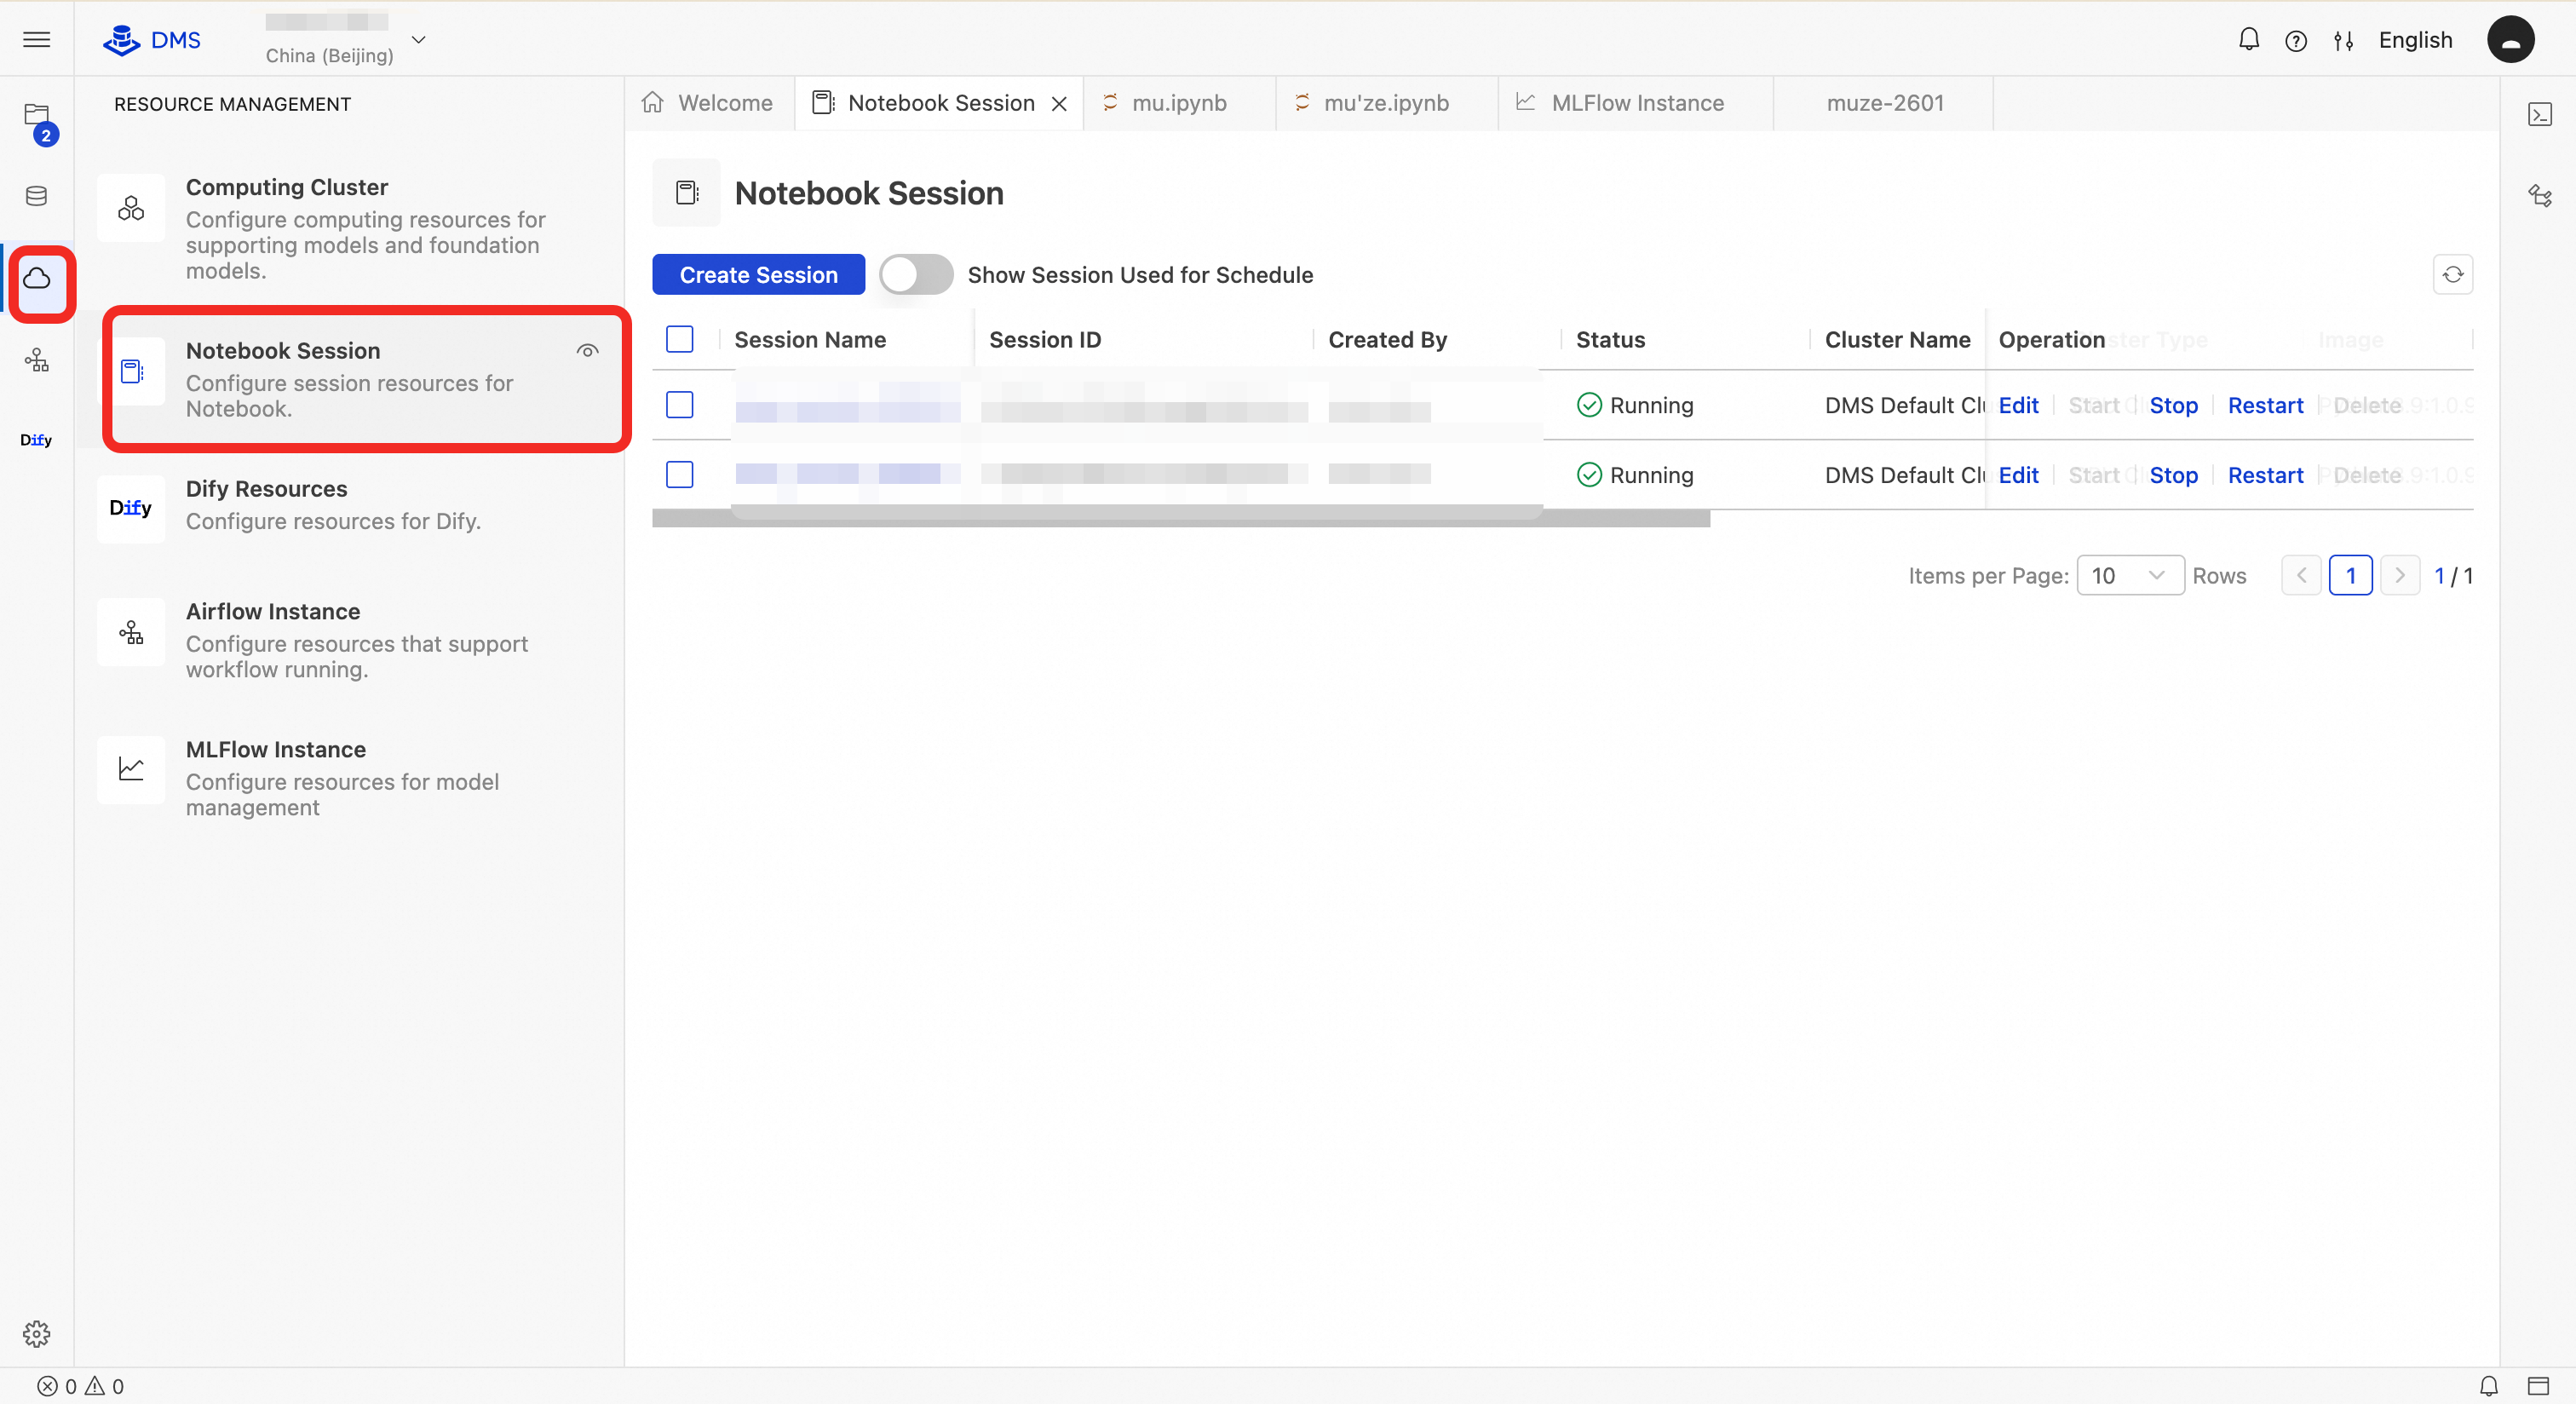
セッション作成ボタンをクリックします。表示されるダイアログボックスで、必須情報を入力し、[完了して作成] をクリックします。
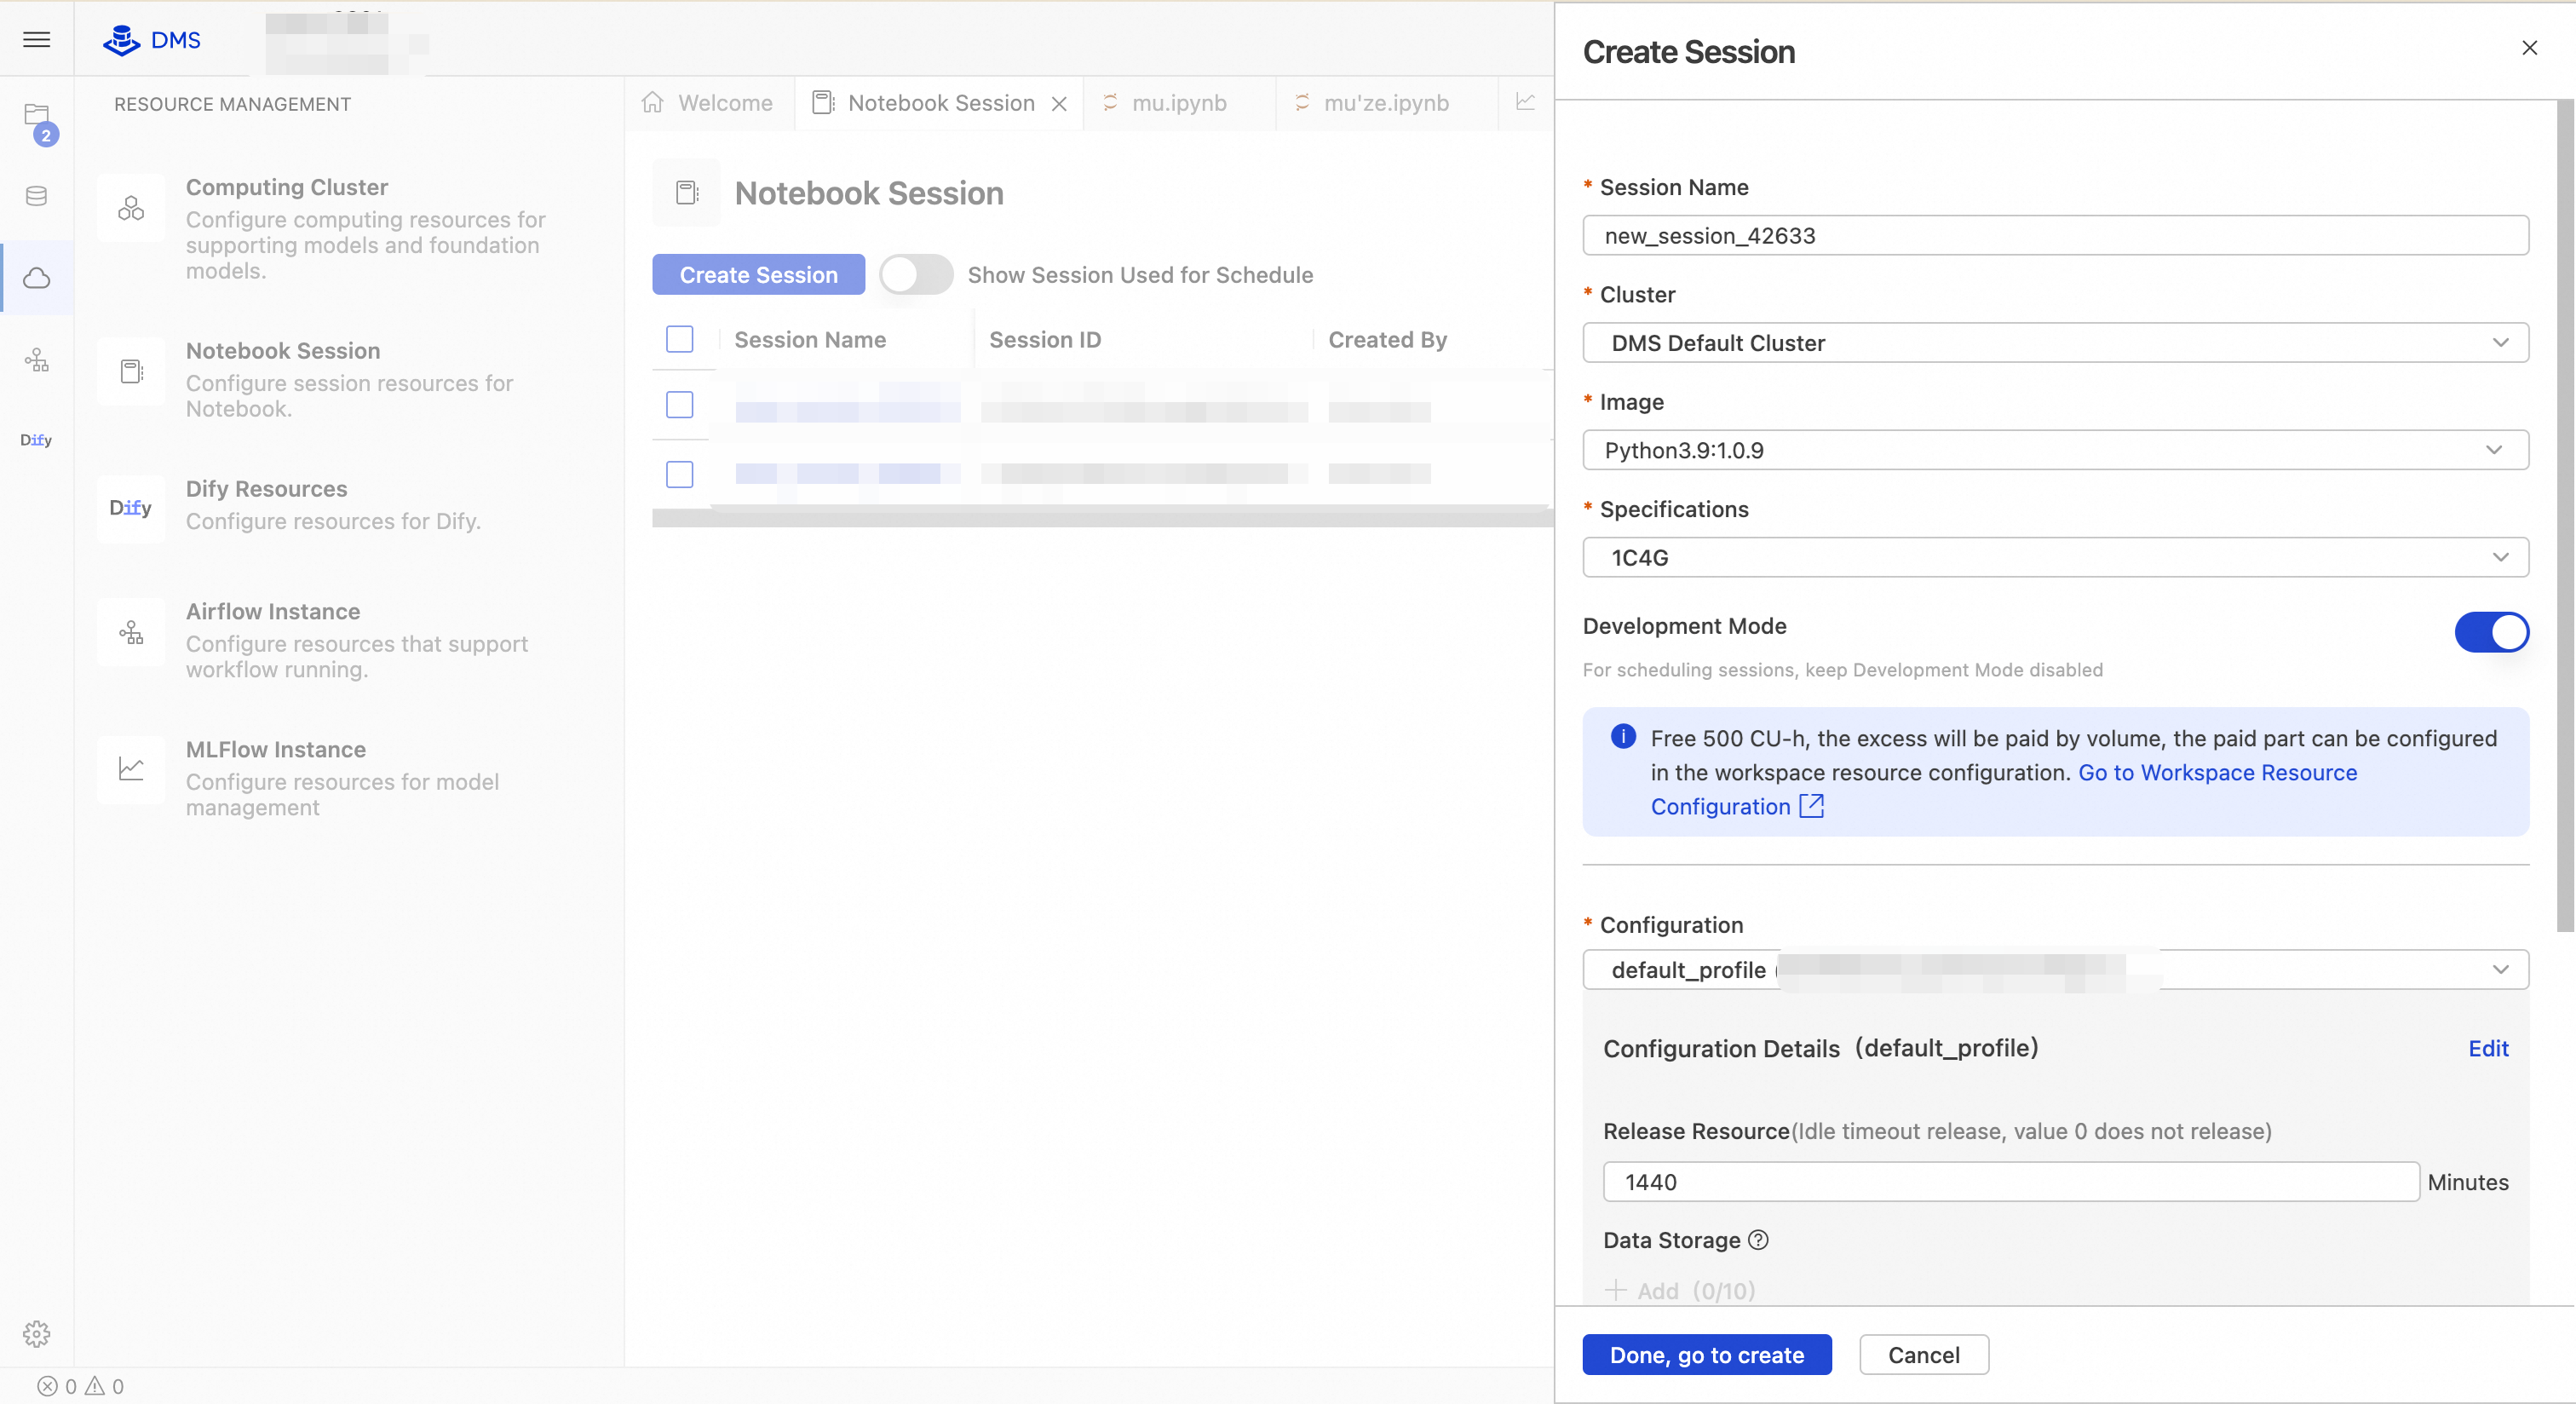
パラメーター
説明
例
セッション名
異なるタスクを区別するための Notebook セッションの一意の名前。名前には文字、数字、アンダースコアを含めることができ、64 文字以下である必要があります。
new_session_20250401クラスター
Notebook が実行される計算クラスター。デフォルトでは、DMS が提供する共有クラスターが使用されます。承認された専用クラスターを選択することもできます。
DMS デフォルトクラスターイメージ
ランタイム環境のベースとなるコンテナイメージ。プリインストール済みの Python バージョンと、pandas、numpy、dashscope などの一般的な AI およびデータサイエンスライブラリが含まれています。
Python3.9:1.0.9仕様
Notebook インスタンスに割り当てられる計算リソース。「CPU コア数 + メモリサイズ」の形式で指定します。リソースが多いほど処理能力は高くなりますが、コストも増加します。
1C4G(1 CPU コア、4 GB メモリ)開発モード
自動保存やホットリロードなど、強化されたデバッグ機能やインタラクティブな機能を有効にするかどうかを制御します。このモードを有効にすると、リソース消費がわずかに増加し、開発やデバッグに適しています。本番環境では無効にすることを推奨します。
オフ/オン構成
ネットワークポリシー、マウントポイント、Security Context などを含む、プリセットされたランタイム構成テンプレート。
default_profileはシステムのデフォルトのセキュリティ構成です。default_profileリソースの解放
セッションが自動的に解放されるまでのアイドルタイムアウト期間 (分)。タイムアウト後、インスタンスはリソースを節約するために回収されます。保存されていないコンテンツは失われる可能性があるため、データを永続化するようにしてください。
1440(24 時間)データストレージ
永続ストレージボリュームをマウントするかどうかを指定します。「なし」を選択した場合、すべてのデータは一時的なコンテナに保存され、セッションが停止または再起動すると失われます。データを永続化するには、OSS または NAS ボリュームをバインドします。
なし/oss://my-bucket/notebookPyPI で管理されるパッケージ
pip を介してインストールする追加のサードパーティ Python パッケージのリスト。複数のパッケージはカンマで区切ります。バージョンを指定することもできます。例:
dashscope==1.19.0。なし/dashscope, pandas==2.1.0環境変数
カスタムのランタイム環境変数。API キー、リージョン、ログレベルの設定によく使用されます。
KEY=VALUEの形式を使用します。複数の変数は改行またはセミコロンで区切ります。なし/DASHSCOPE_API_KEY=sk-xxx[Notebook セッション] リストで、対象のセッションを見つけ、[操作] 列の [開始] をクリックします。
MLflow インスタンスの作成と構成
MLflow インスタンスの作成
DMS ワークスペースで、MLflow 管理ページに移動します。
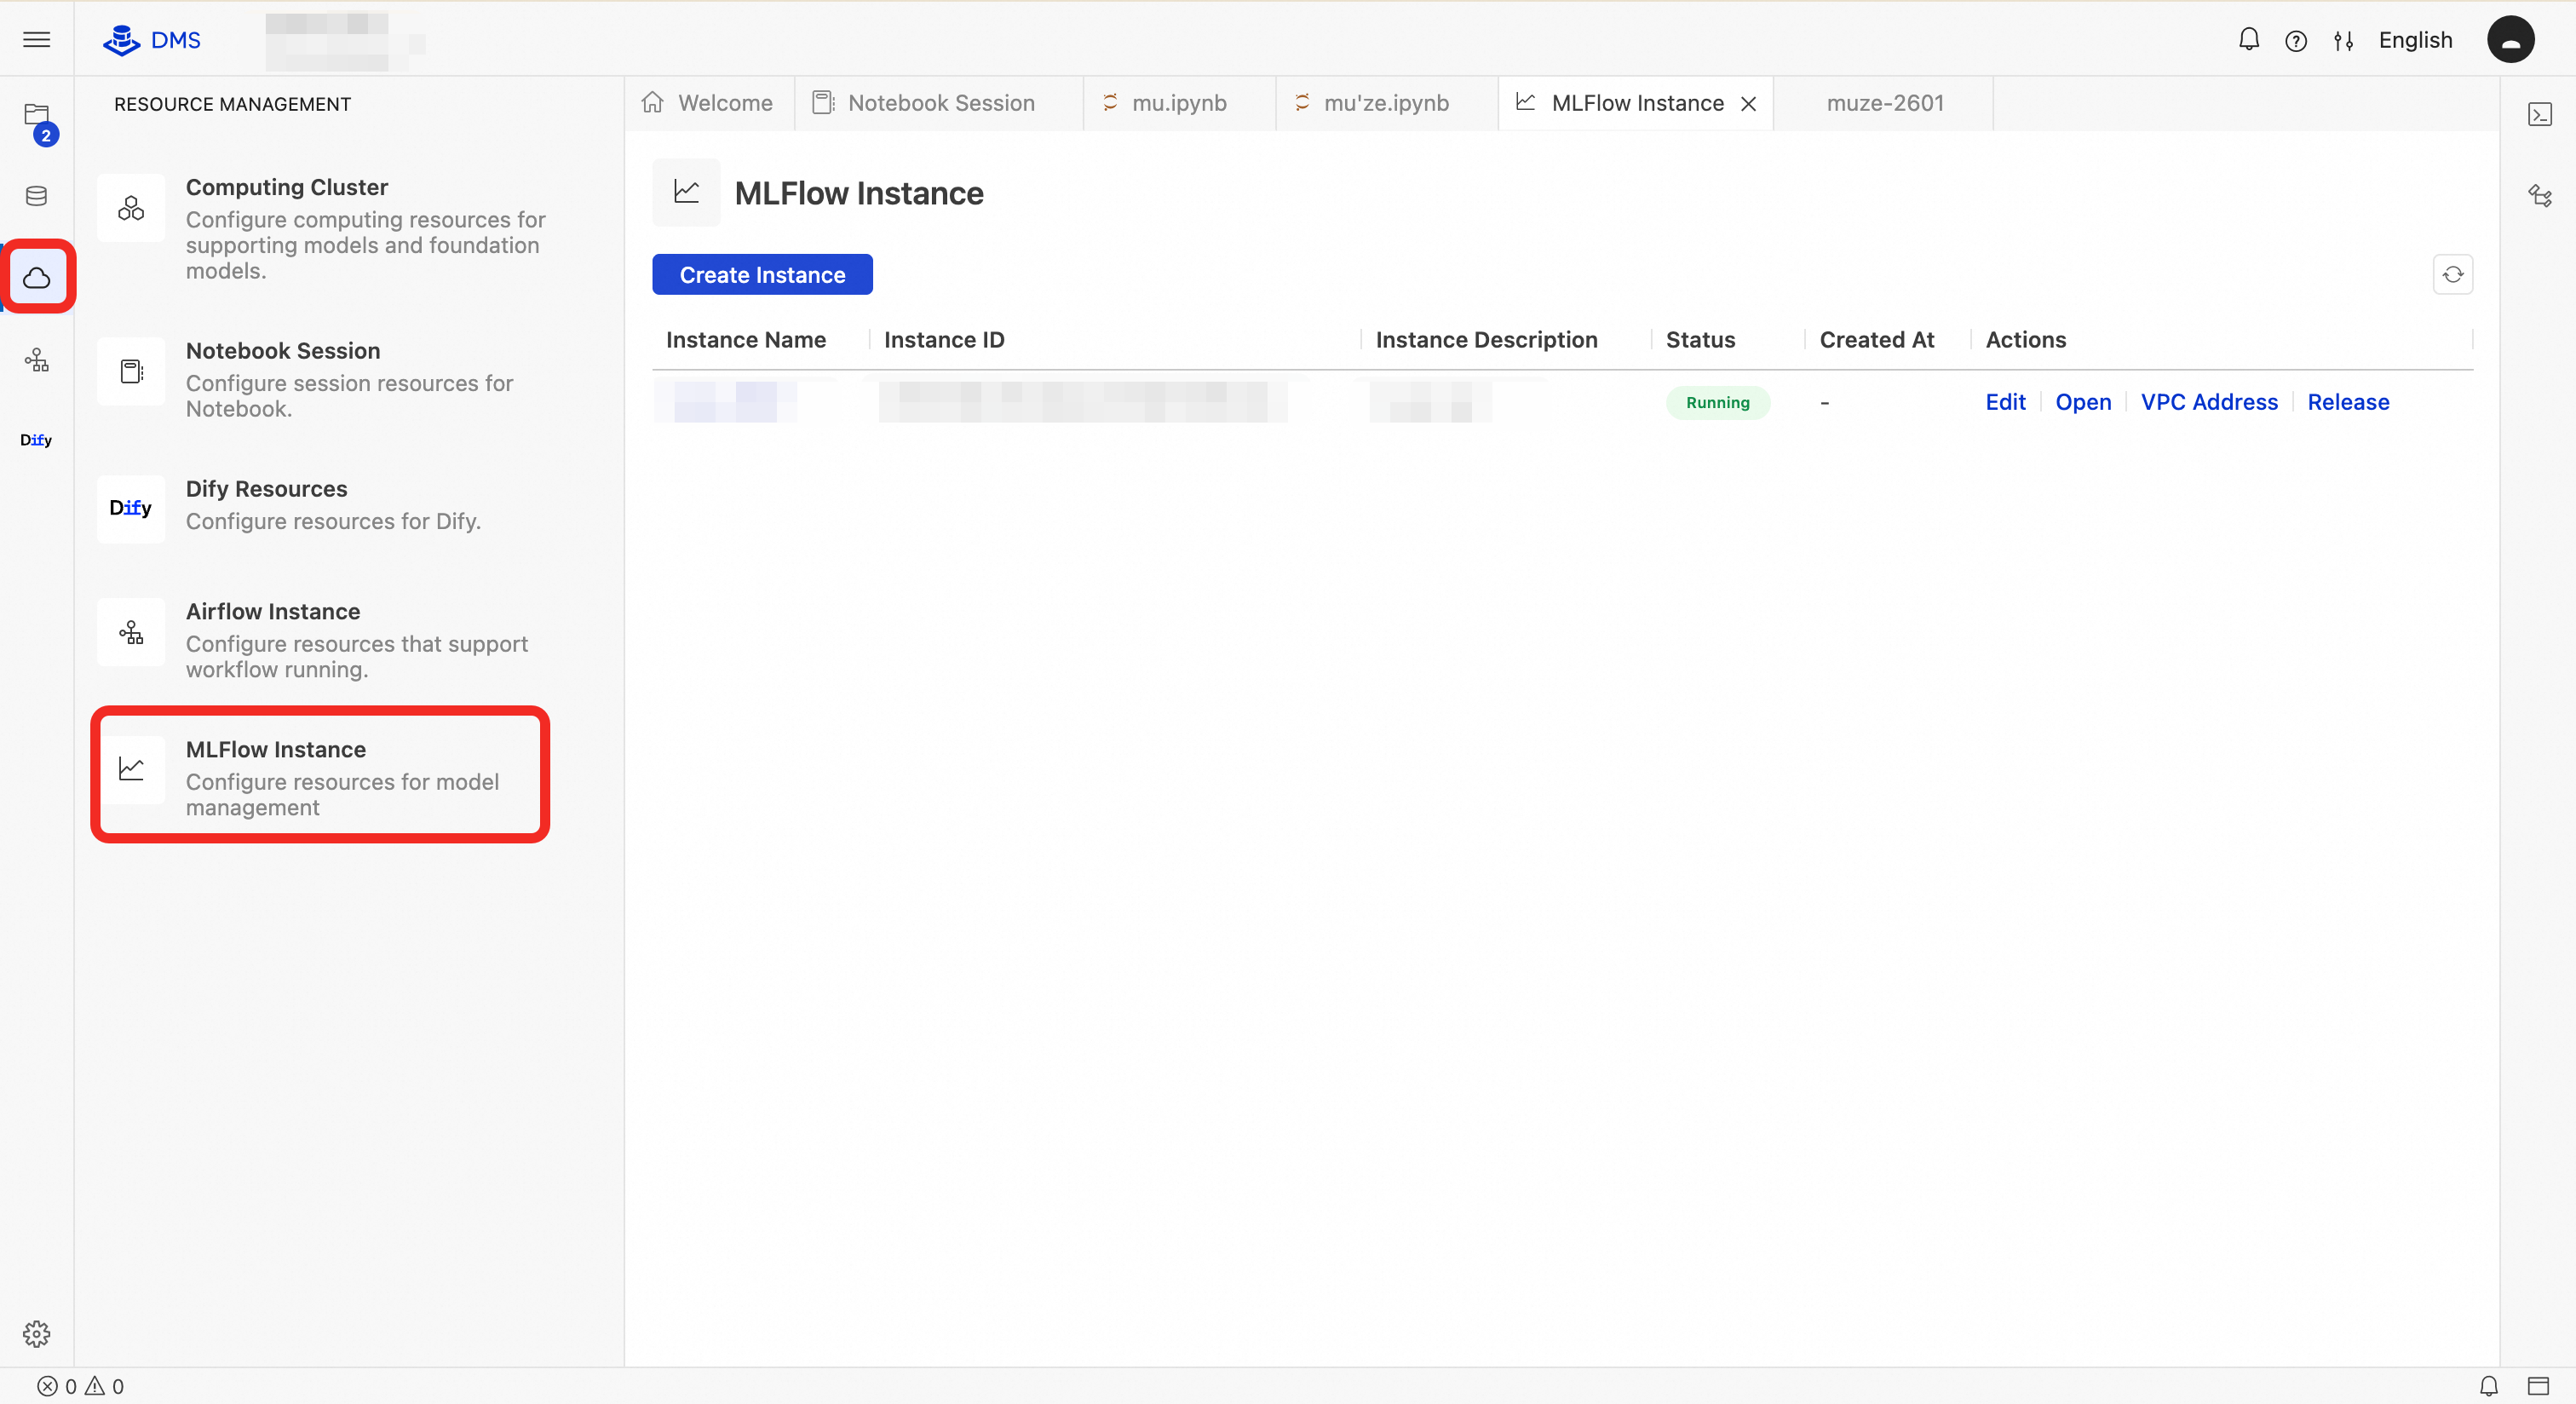
[インスタンスの作成] をクリックし、ウィザードで次のパラメーターを構成します:
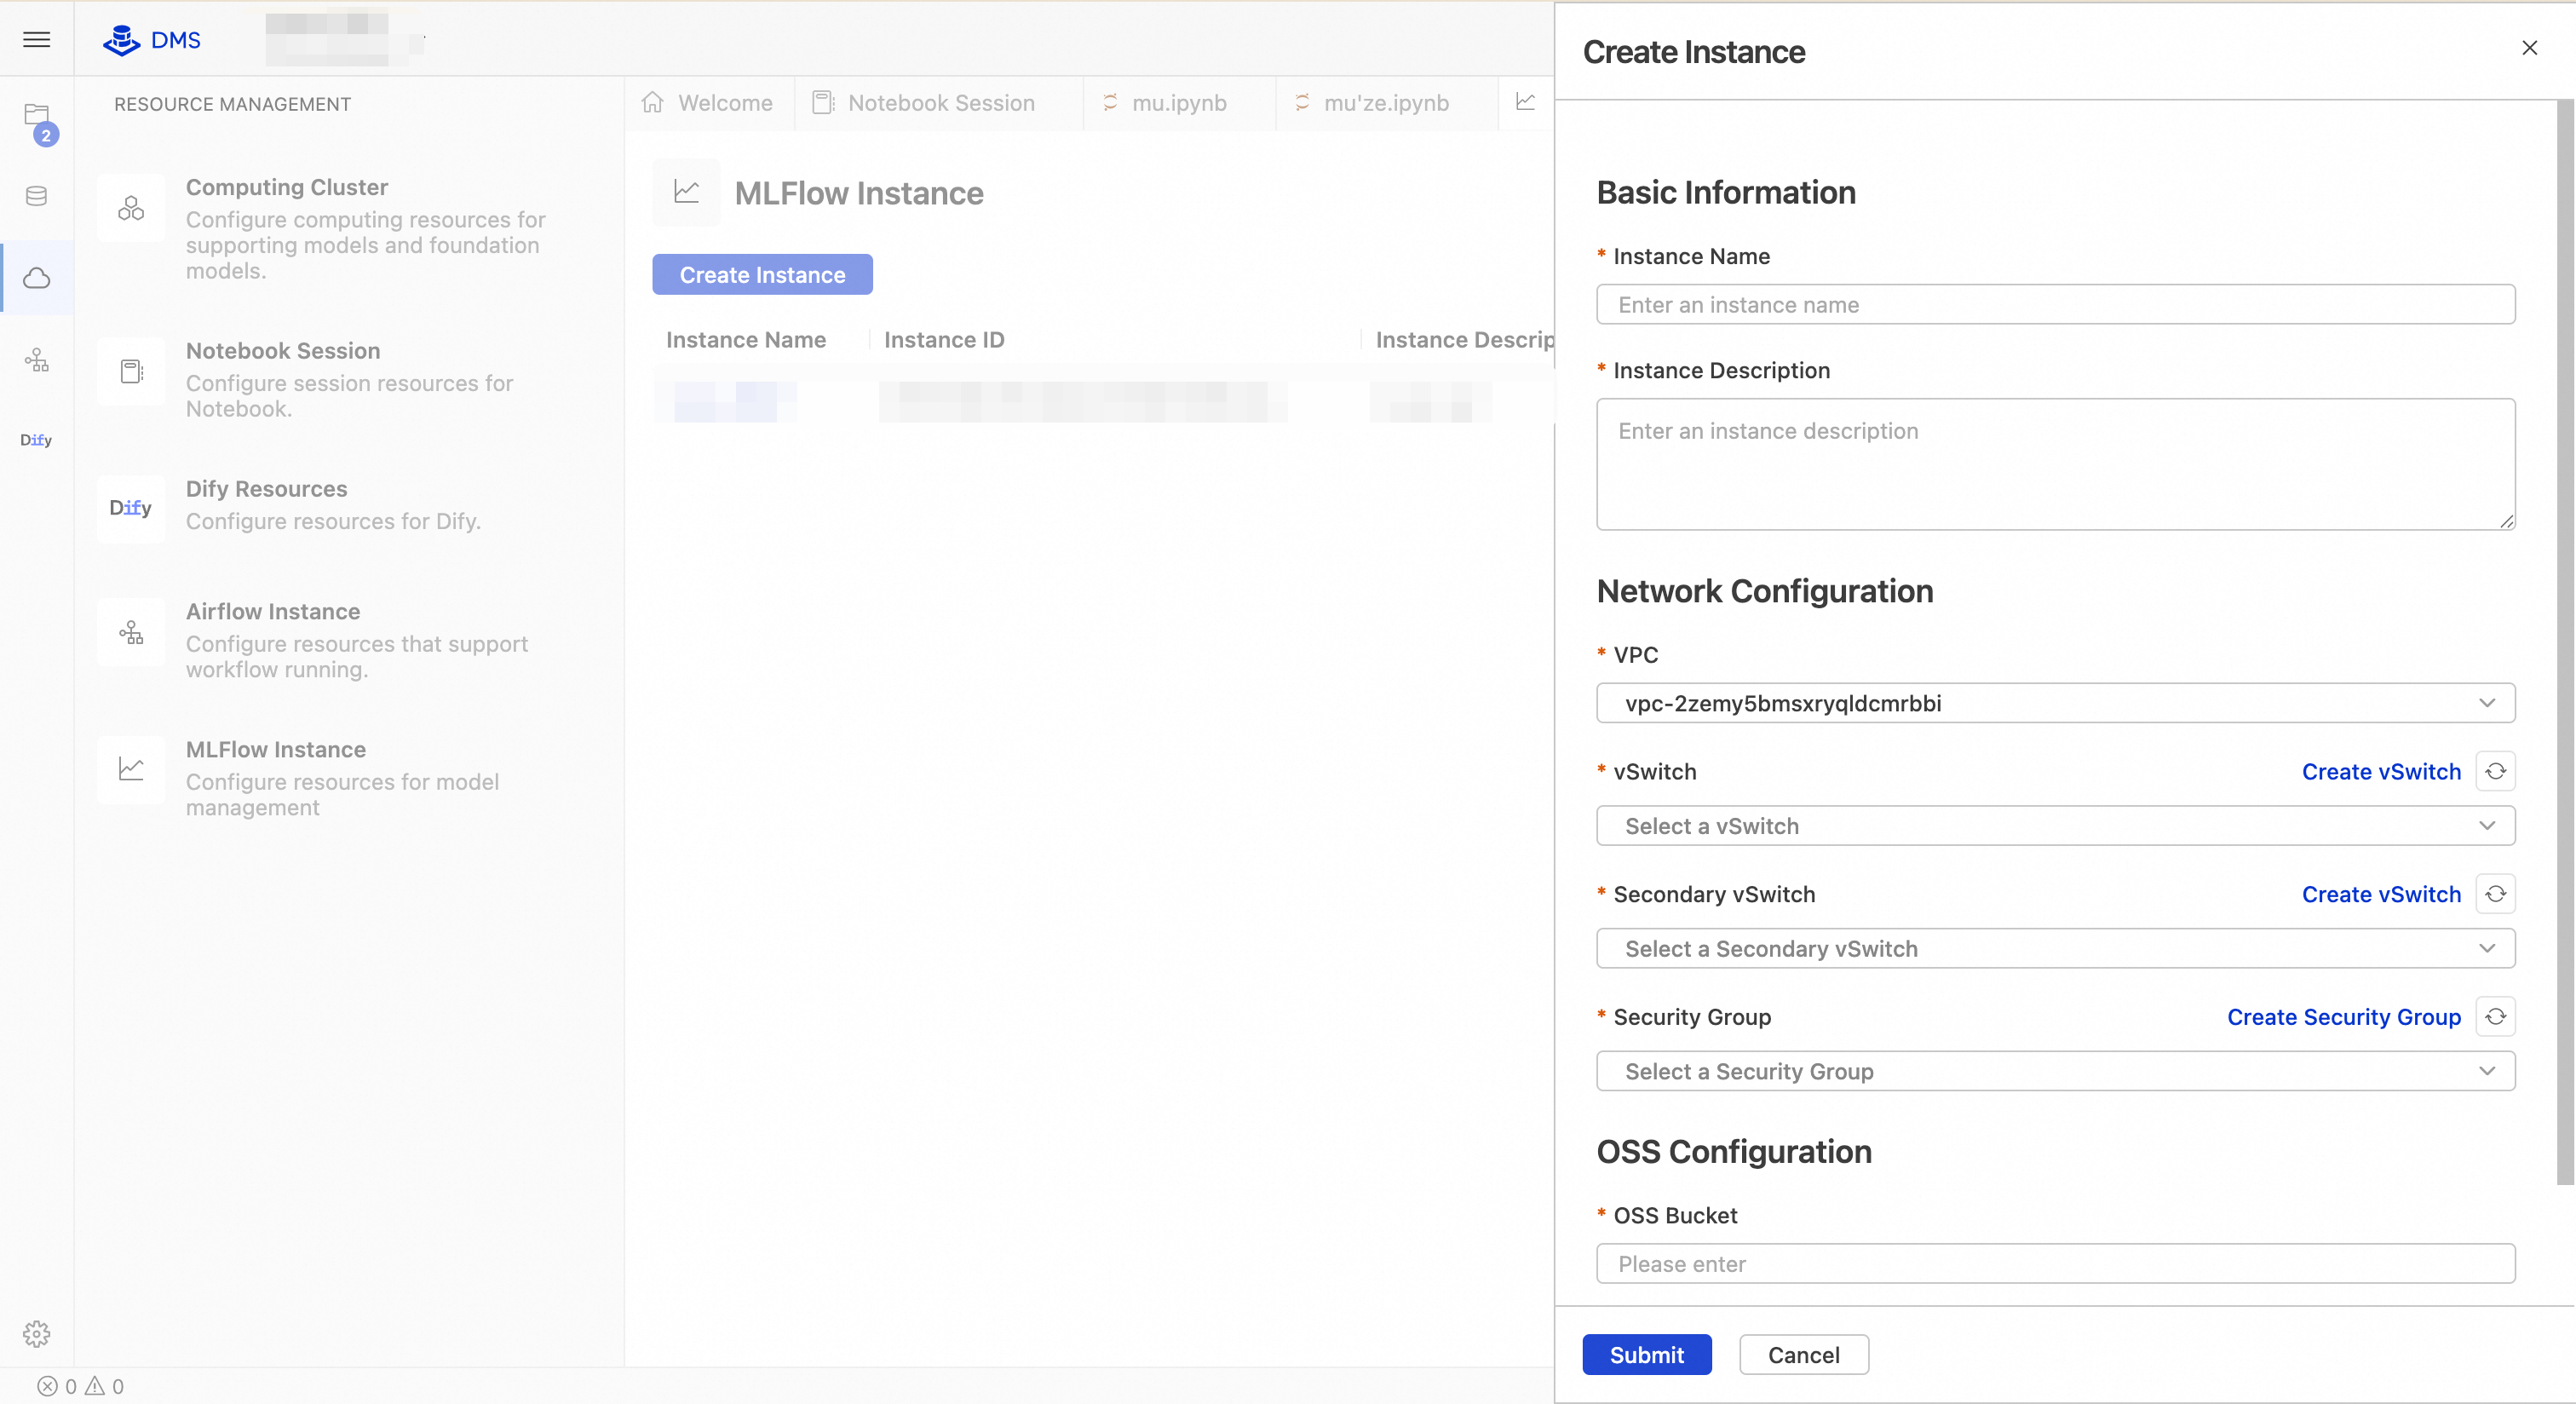
パラメーター
説明
例
インスタンス名
MLflow インスタンスの名前。
my-mlflow
インスタンスの説明
MLflow インスタンスの説明。
私の MLflow の説明。
VPC
使用する VPC を選択します。デフォルトでは、現在のワークスペースの VPC が選択されます。異なる VPC にある Notebook と MLflow インスタンスは互いに通信できません。
vpc-fs******4a
vSwitch
プライマリ vSwitch を選択します。MLflow リソースとロードバランサーは、それぞれこの vSwitch 内の 1 つの IP アドレスを占有します。vSwitch に十分な利用可能な IP アドレスがあることを確認してください。
vsw-sg******7h
スタンバイ vSwitch
ロードバランサーの高可用性のためにスタンバイ vSwitch を選択します。ロードバランサーはこの vSwitch 内の 1 つの IP アドレスを占有します。スタンバイ vSwitch はプライマリ vSwitch とは異なるアベイラビリティゾーンにある必要があります。そうでない場合、MLflow インスタンスの作成は失敗します。
vsw-hq******v9
セキュリティグループ
セキュリティグループを選択します。MLflow インスタンスへのネットワークアクセスは、このセキュリティグループのインバウンドルールによって制御されます。ルールがソース IP アドレス (Notebook の IP など) からのアクセスを許可していることを確認してください。そうでない場合、MLflow インスタンスは到達不能になります。標準のセキュリティグループを選択する必要があります。マネージドセキュリティグループを使用すると、インスタンスの作成が失敗します。
sg-zb******iq
OSS バケット
ご利用の Alibaba Cloud OSS バケットの名前。実験の作成時にアーティファクトルートを指定しない場合、DMS MLflow はデフォルトで
oss://<OSS Bucket>/<OSS Path>を使用します。my-bucket
OSS パス
ご利用の Alibaba Cloud OSS バケット内のパス。実験の作成時にアーティファクトルートを指定しない場合、DMS MLflow はデフォルトで
oss://<OSS Bucket>/<OSS Path>を使用します。mlflow-root
構成を確認した後、[OK] をクリックします。インスタンスの作成プロセスには数分かかります。[ステータス] が [実行中] に変わるまで待ちます。
説明インスタンスの作成が明示的なエラーメッセージなしで失敗した場合、または予想以上に時間がかかる場合は、以下を確認してください:
ご利用の Alibaba Cloud アカウントに ALB サービスリンクロールが作成されていることを確認します。ご利用のアカウントで ALB を一度も使用したことがない場合、このロールは存在せず、インスタンスの作成が失敗します。
プライマリ vSwitch とスタンバイ vSwitch の両方に十分な利用可能な IP アドレスがあることを確認します。各 vSwitch に少なくとも 10 個の空き IP アドレスを確保することを推奨します。
セキュリティグループのインバウンドルールが、VPC の CIDR ブロックからのポート 80 での TCP トラフィックを許可していることを確認します。
プライマリ vSwitch とスタンバイ vSwitch が異なるゾーンにあることを確認します。同じゾーンにある場合、インスタンスの作成は失敗します。
DMS MLflow は、バックエンドストアとして機能するために、バックグラウンドで RDS データベースインスタンスを自動的にプロビジョニングします。このデータベースインスタンスはシステムによって完全に管理されており、手動での操作は不要です。RDS のプロビジョニングを含む完全なインスタンス作成プロセスは、通常 10 分以上かかります。[ステータス] が [実行中] に変わるまでお待ちください。
[操作] 列では、次の操作が提供されます:
編集:インスタンス名と説明を変更できます。
開く:埋め込みページで MLflow UI を開きます。

[VPC アドレス]:これらは、VPC 内でのアクセスのために ALB によって提供される安定した IP アドレスです。コピーアイコンをクリックして IP アドレスをコピーします。どちらのアドレスも MLflow トラッキングサーバー URI として使用できます。ポートは 80 なので、同じ VPC 内からのアクセスに直接使用できます。
再デプロイ:この操作は現在サポートされていません。
リリース:インスタンスを解放し、関連するデータベースとバックエンドの計算リソースを削除します。
ALB アクセス制御の構成
ネットワークセキュリティのため、MLflow インスタンスに関連付けられた ALB は、デフォルトですべてのトラフィックを拒否します。VPC 内からのアクセスを許可するには、アクセス制御ポリシーを構成する必要があります。
MLflow インスタンスの詳細ページで、インスタンス ID をコピーします。
ALB コンソールに移動します。MLflow インスタンスと同じリージョンを選択していることを確認してください。左側のナビゲーションウィンドウで、[インスタンス] を選択します。
[インスタンス] ページで、インスタンス ID を キーワード として使用して、対応する ALB インスタンスを検索します。
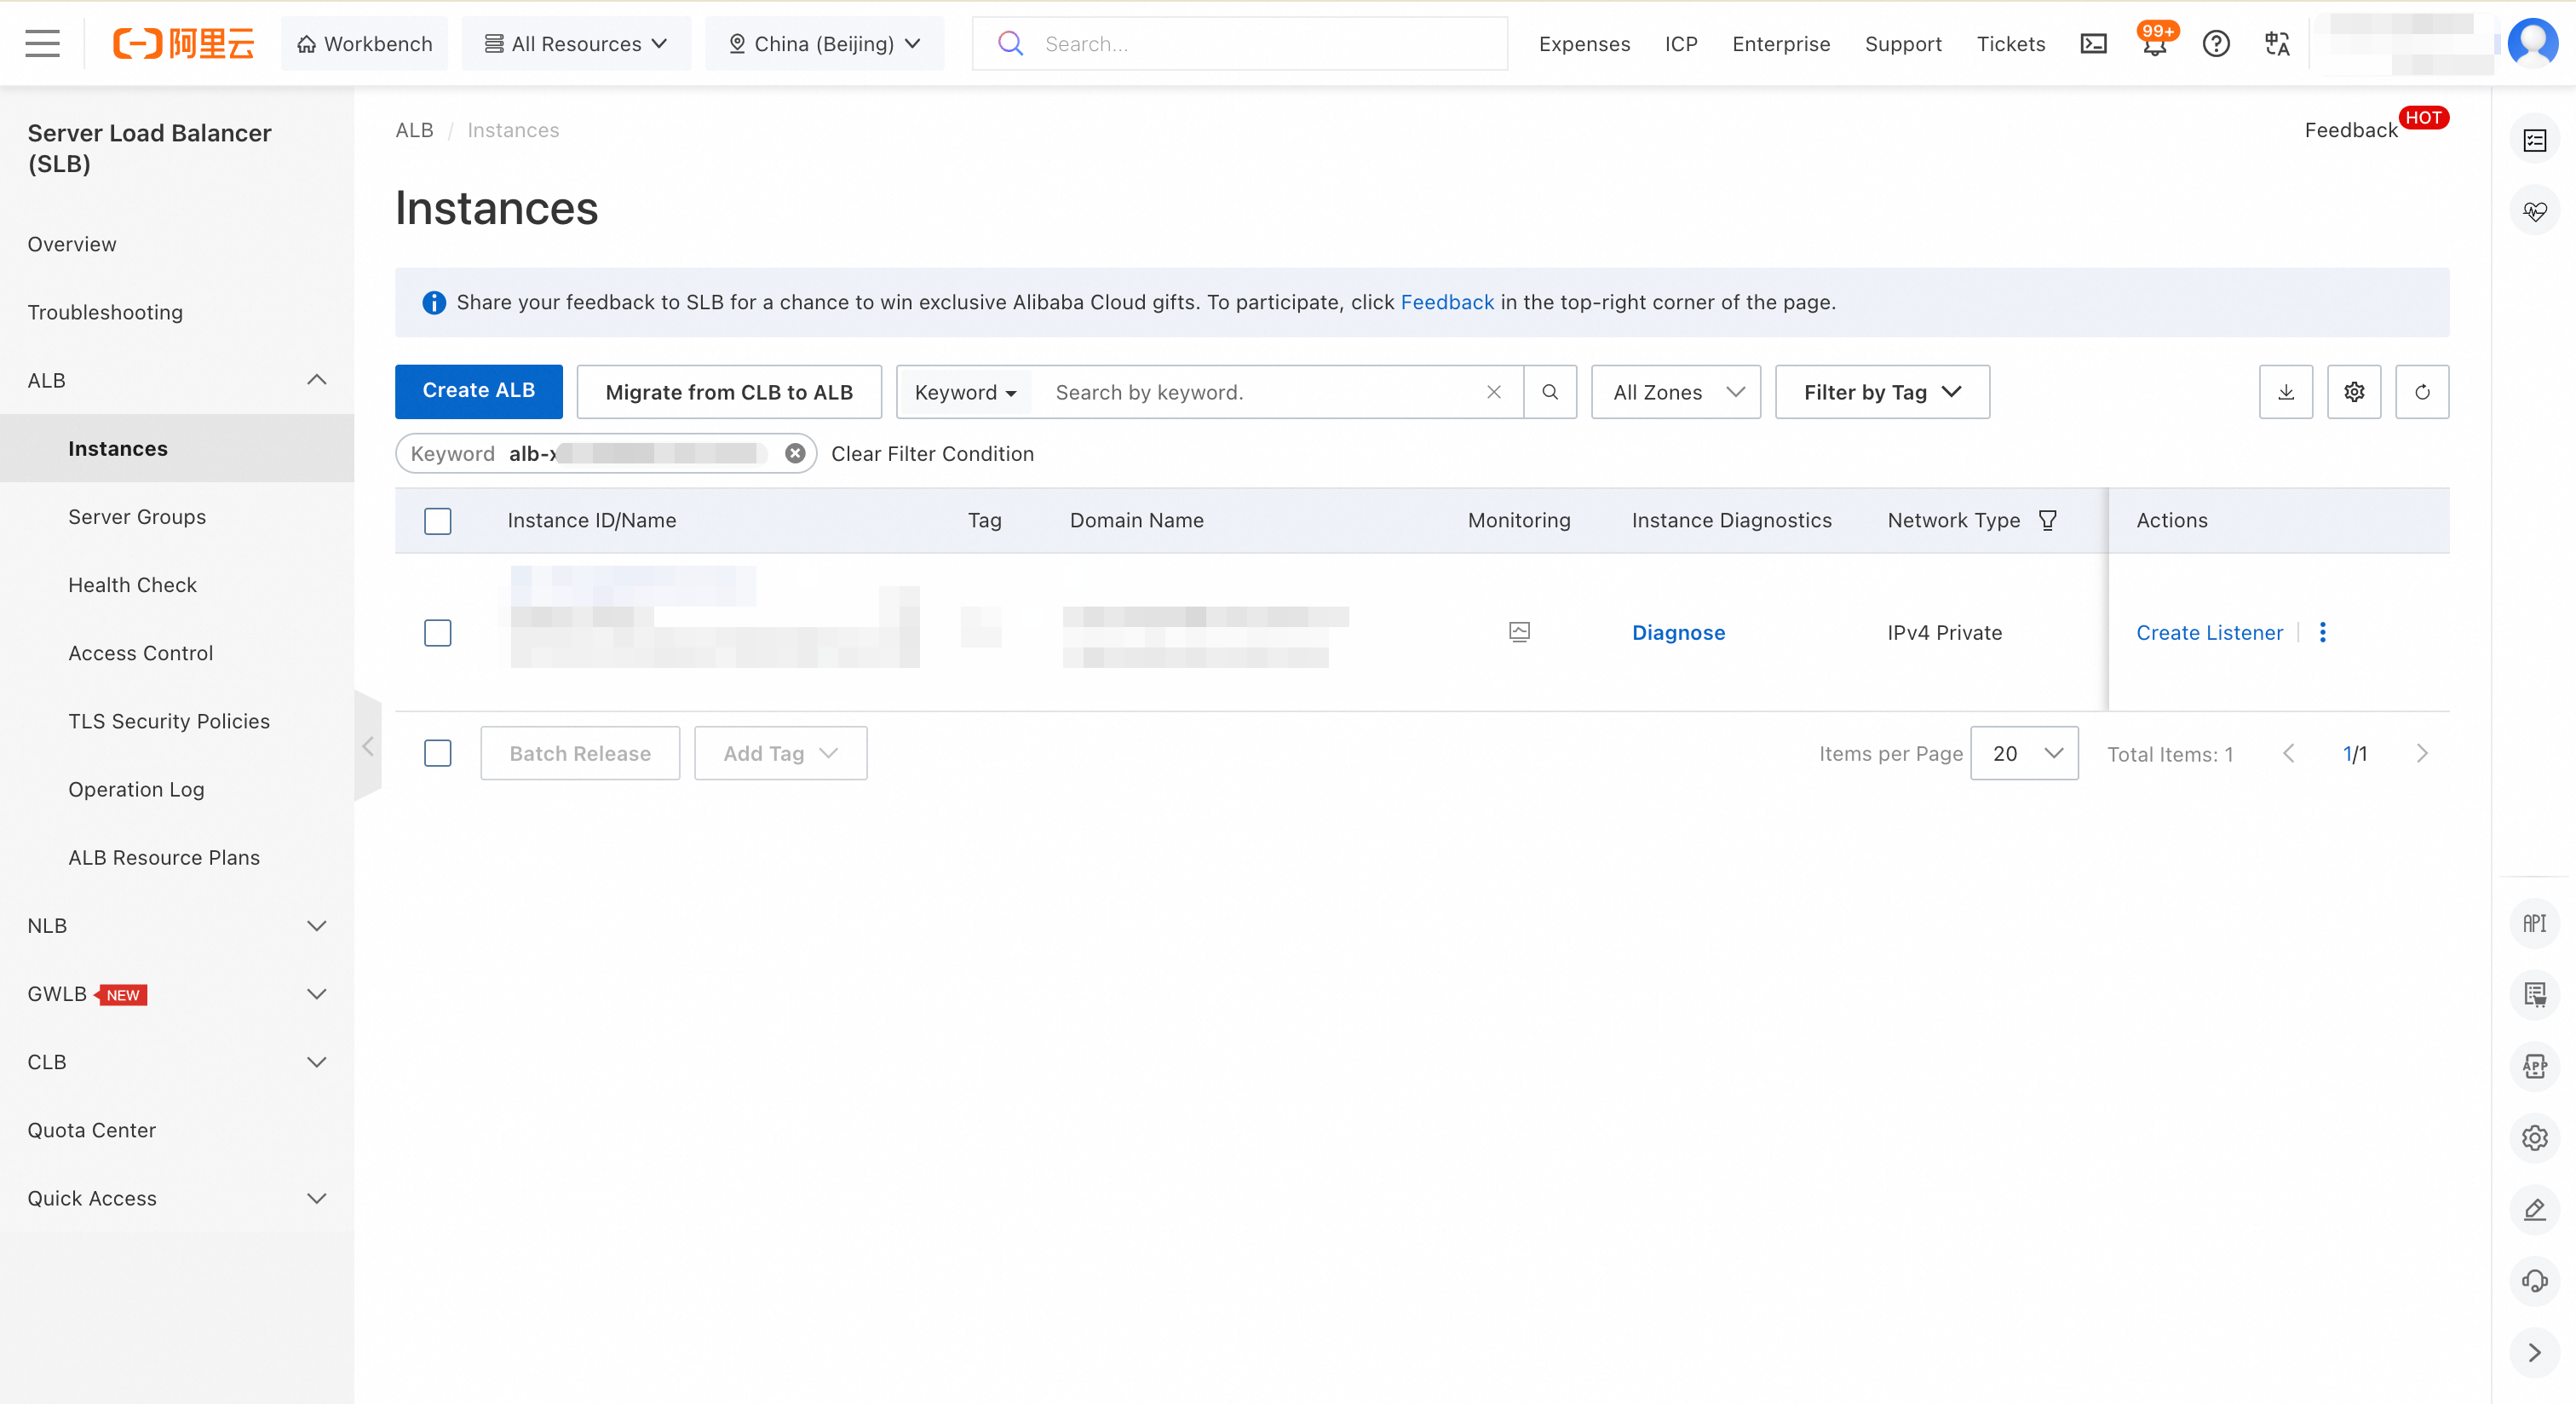
インスタンス ID をクリックして インスタンスの詳細 ページに移動し、リスナー タブに切り替えます。
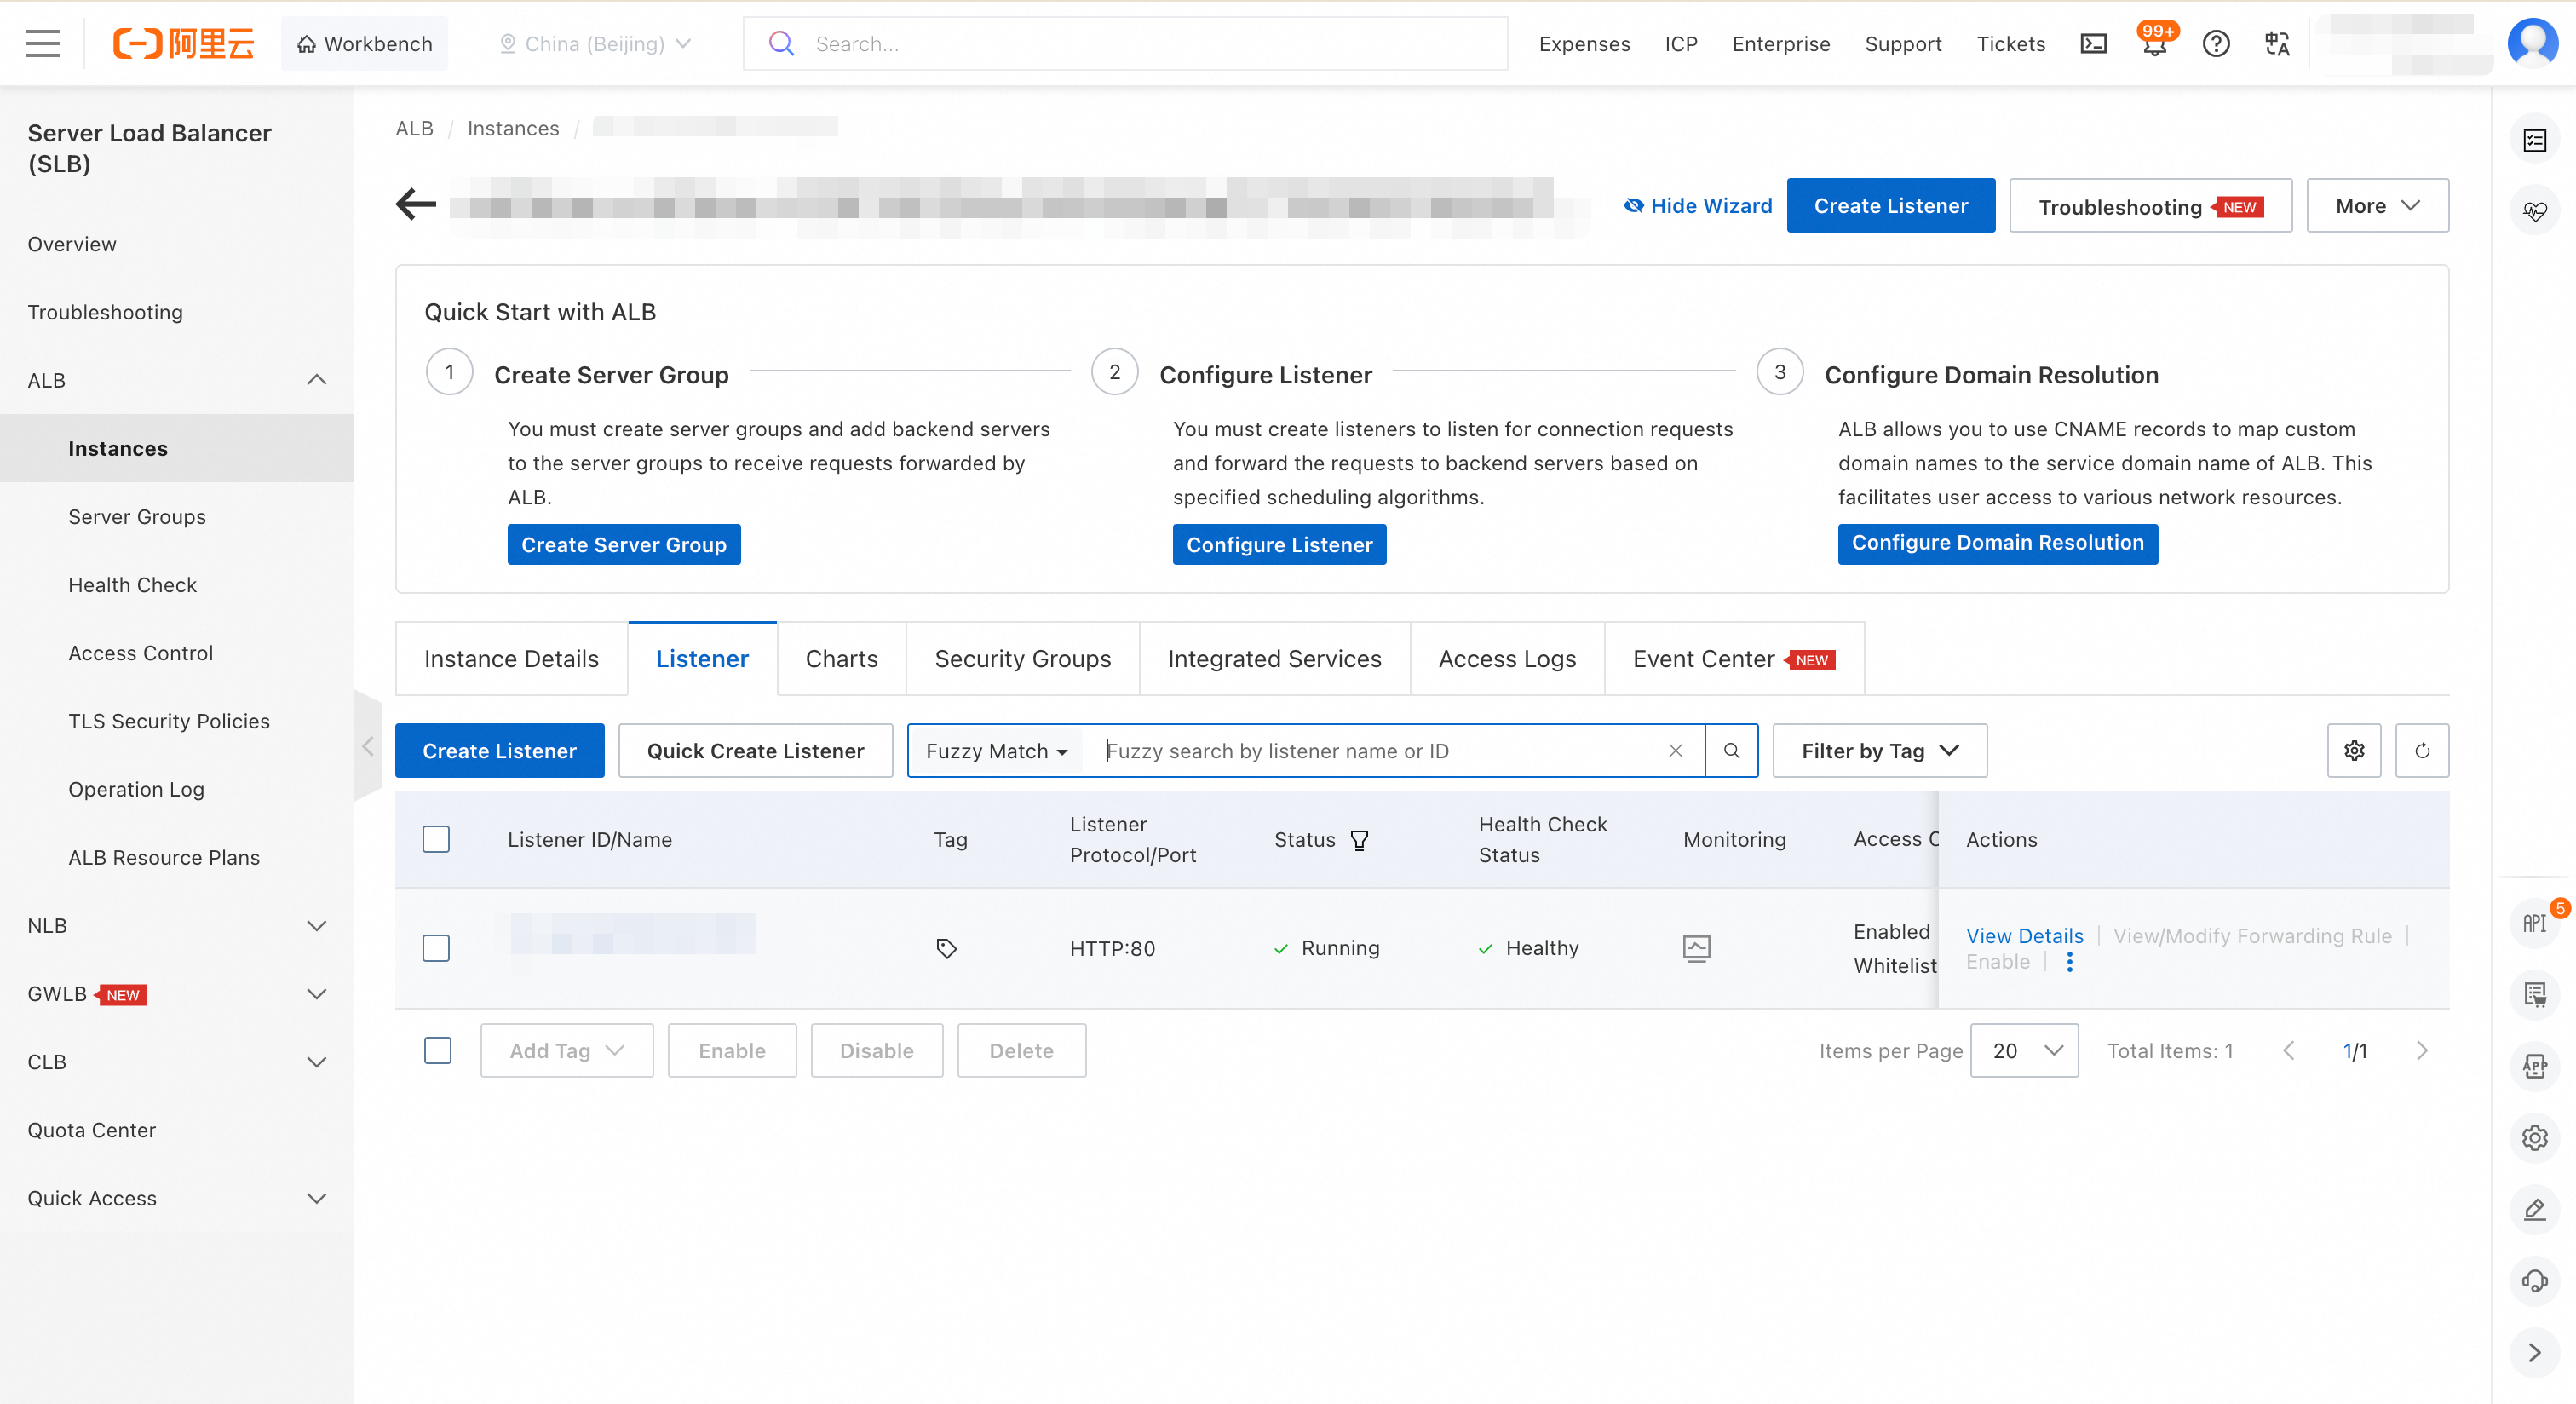
ポート 80 のリスナーを見つけ、操作 列の 詳細を表示 をクリックします。
リスナーの詳細 タブの アクセス制御 セクションで、ACL の ID をクリックします。
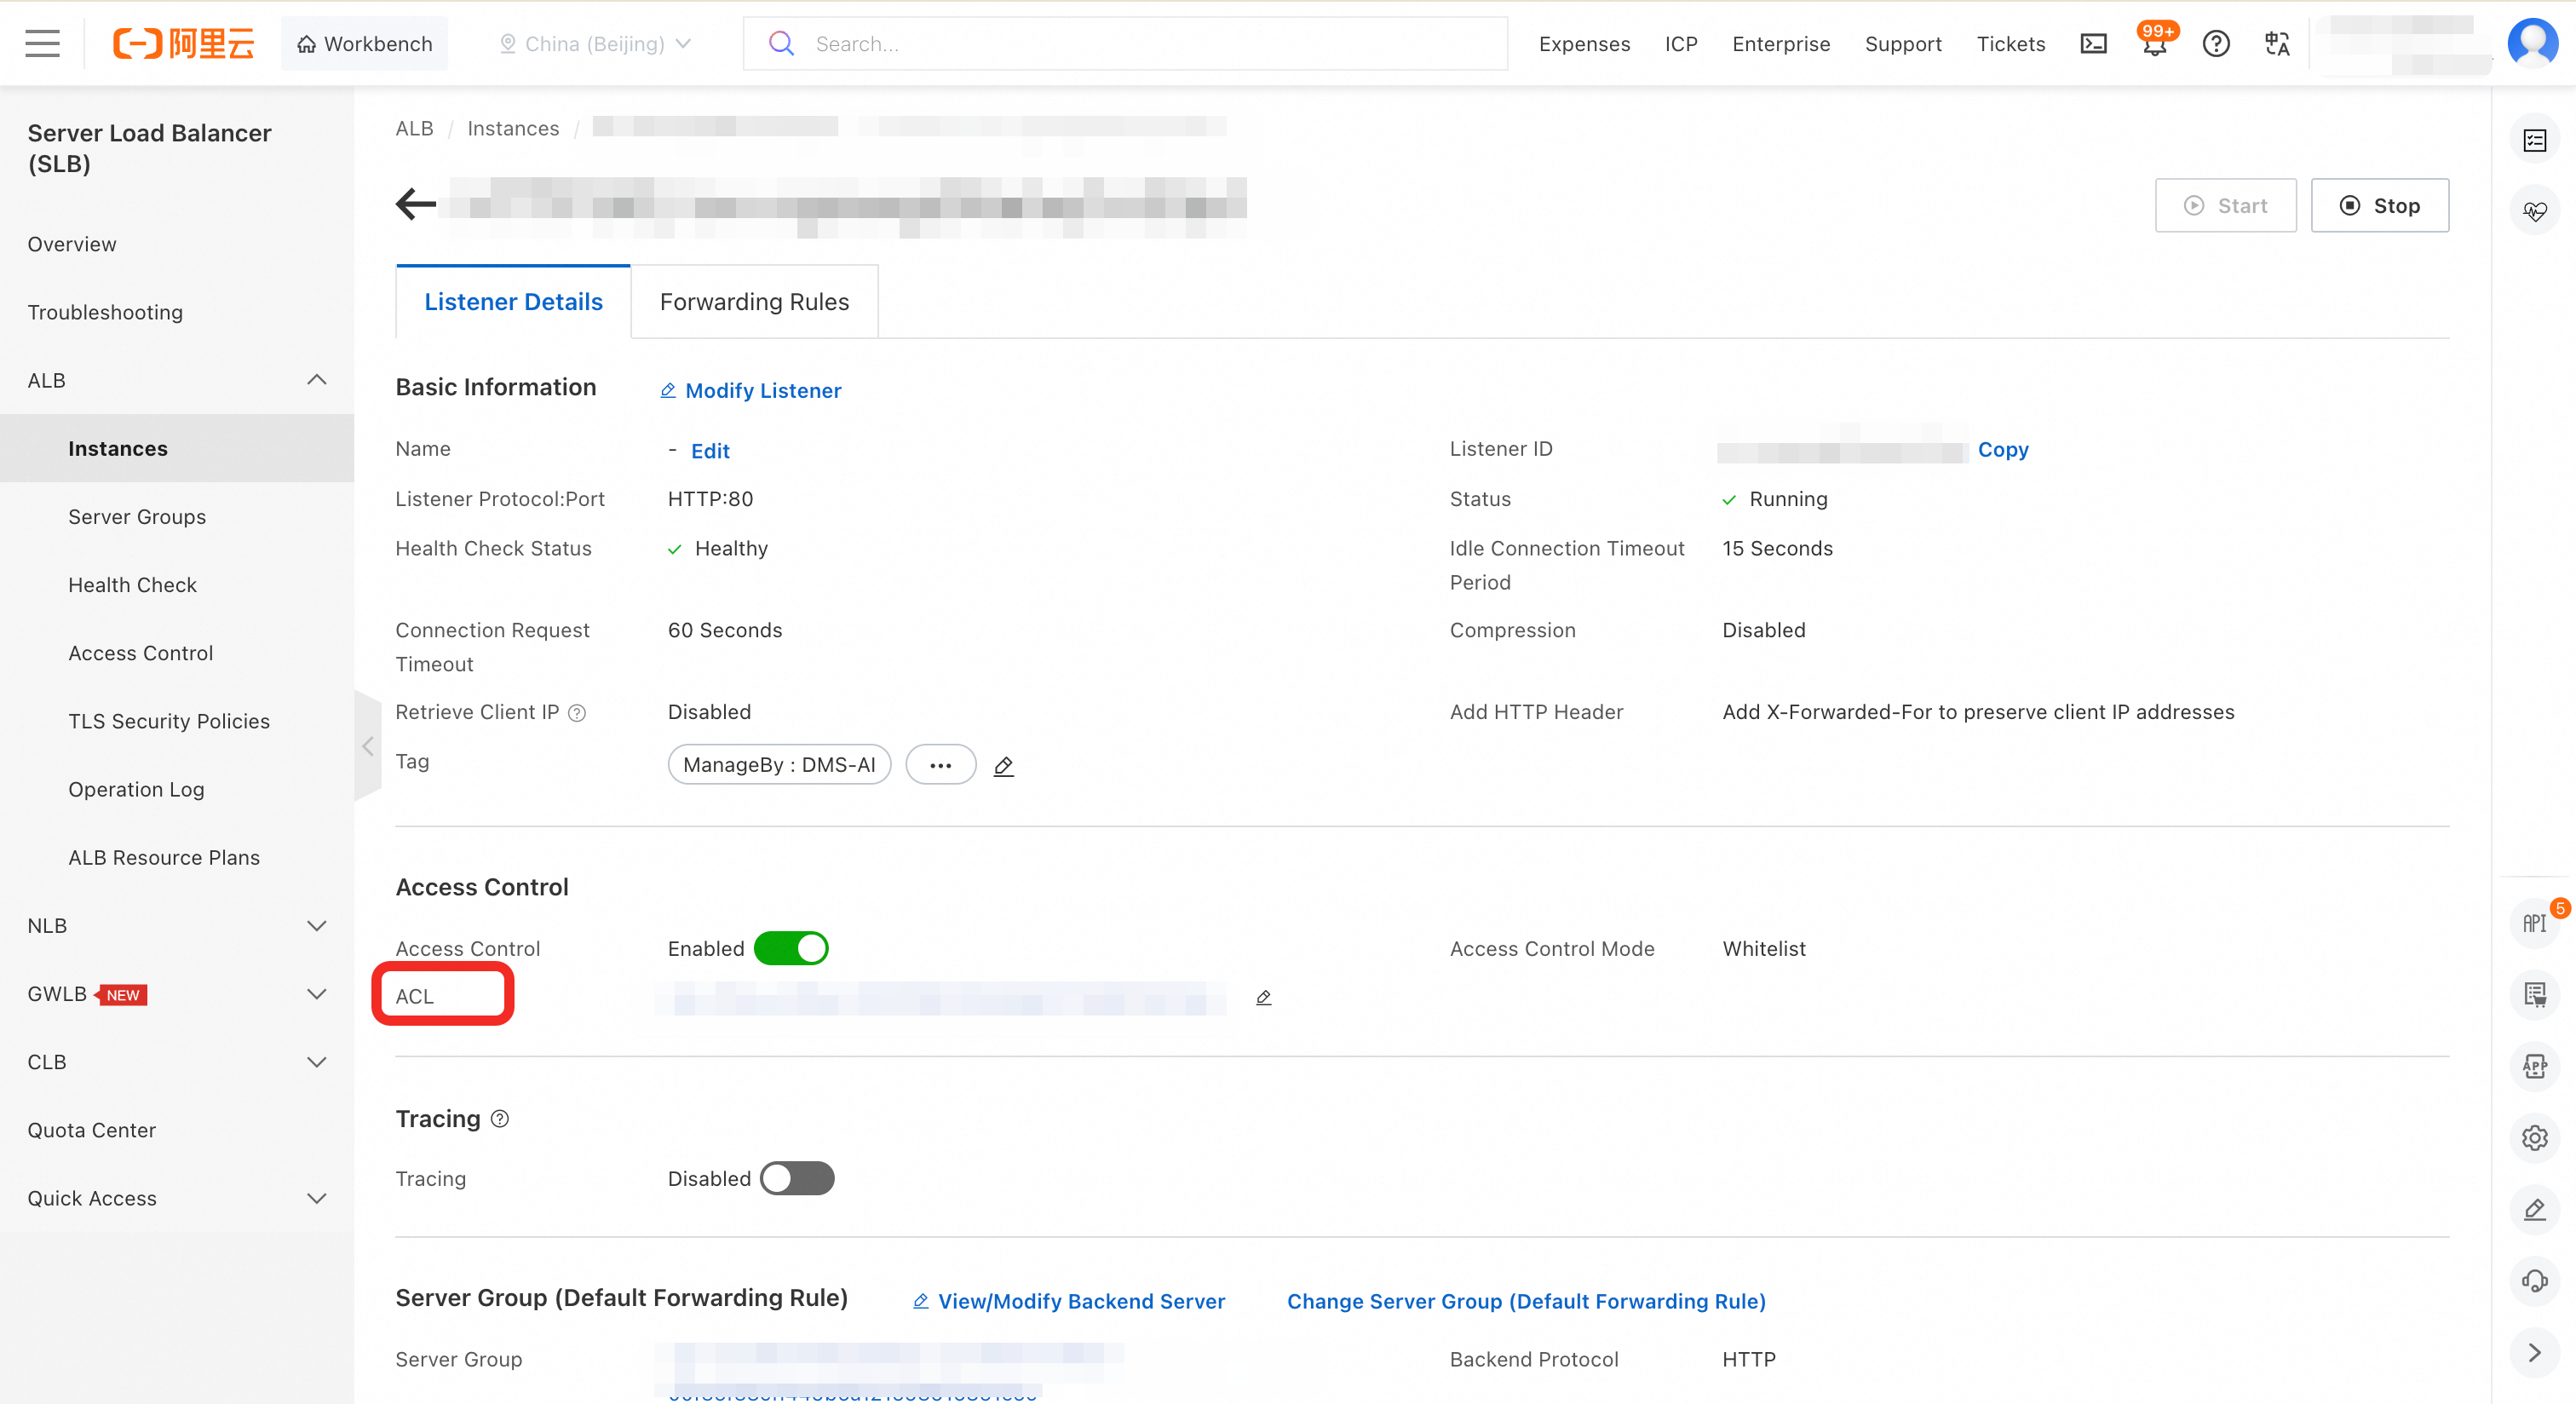
エントリ タブで、エントリの追加 をクリックして、許可するソースを構成します。VPC の CIDR ブロック (例:
192.168.0.0/16) または、より具体的な Notebook の CIDR ブロックを追加して、これらのネットワークセグメントからのアクセスを許可することを推奨します。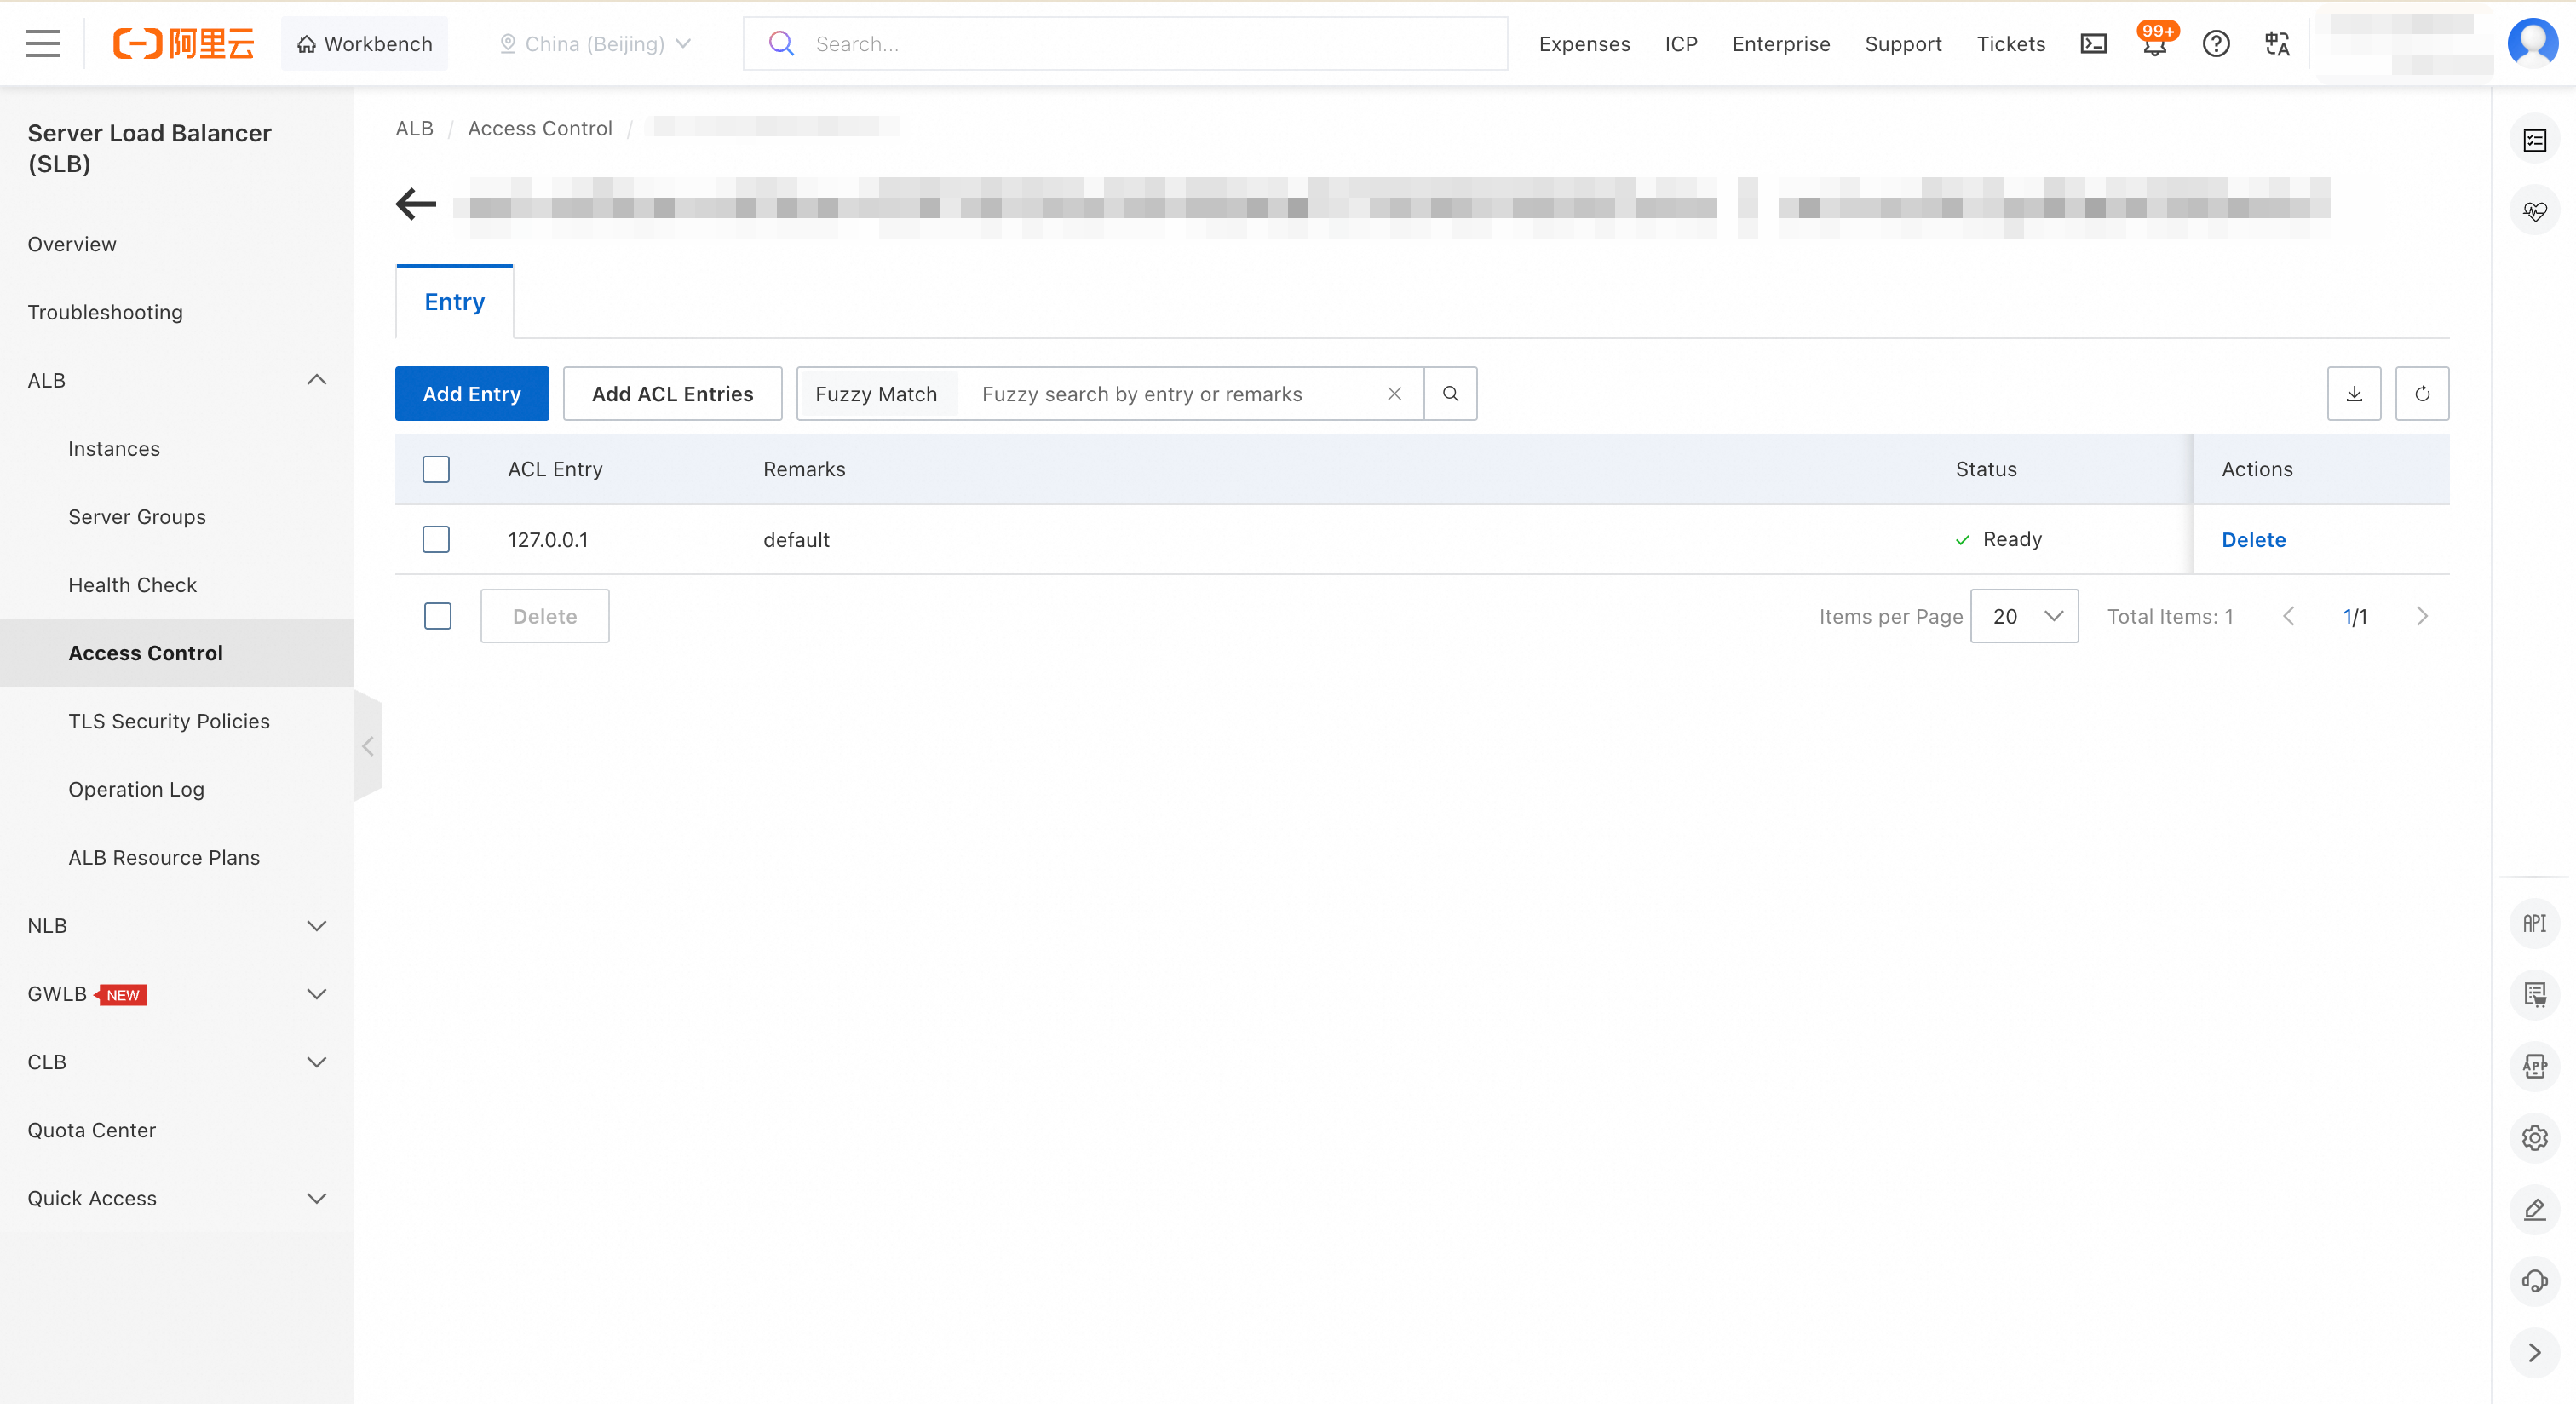
Notebook で MLflow を使用する
開始する前に、MLflow インスタンスが実行中であり、その ALB アクセス制御ポリシーが Notebook 環境からの接続を許可するように構成されていることを確認してください。
新しいファイルの作成:[エクスプローラー] で、[CODE] セクション内を右クリックし、[新しい Notebook ファイル] を選択します。
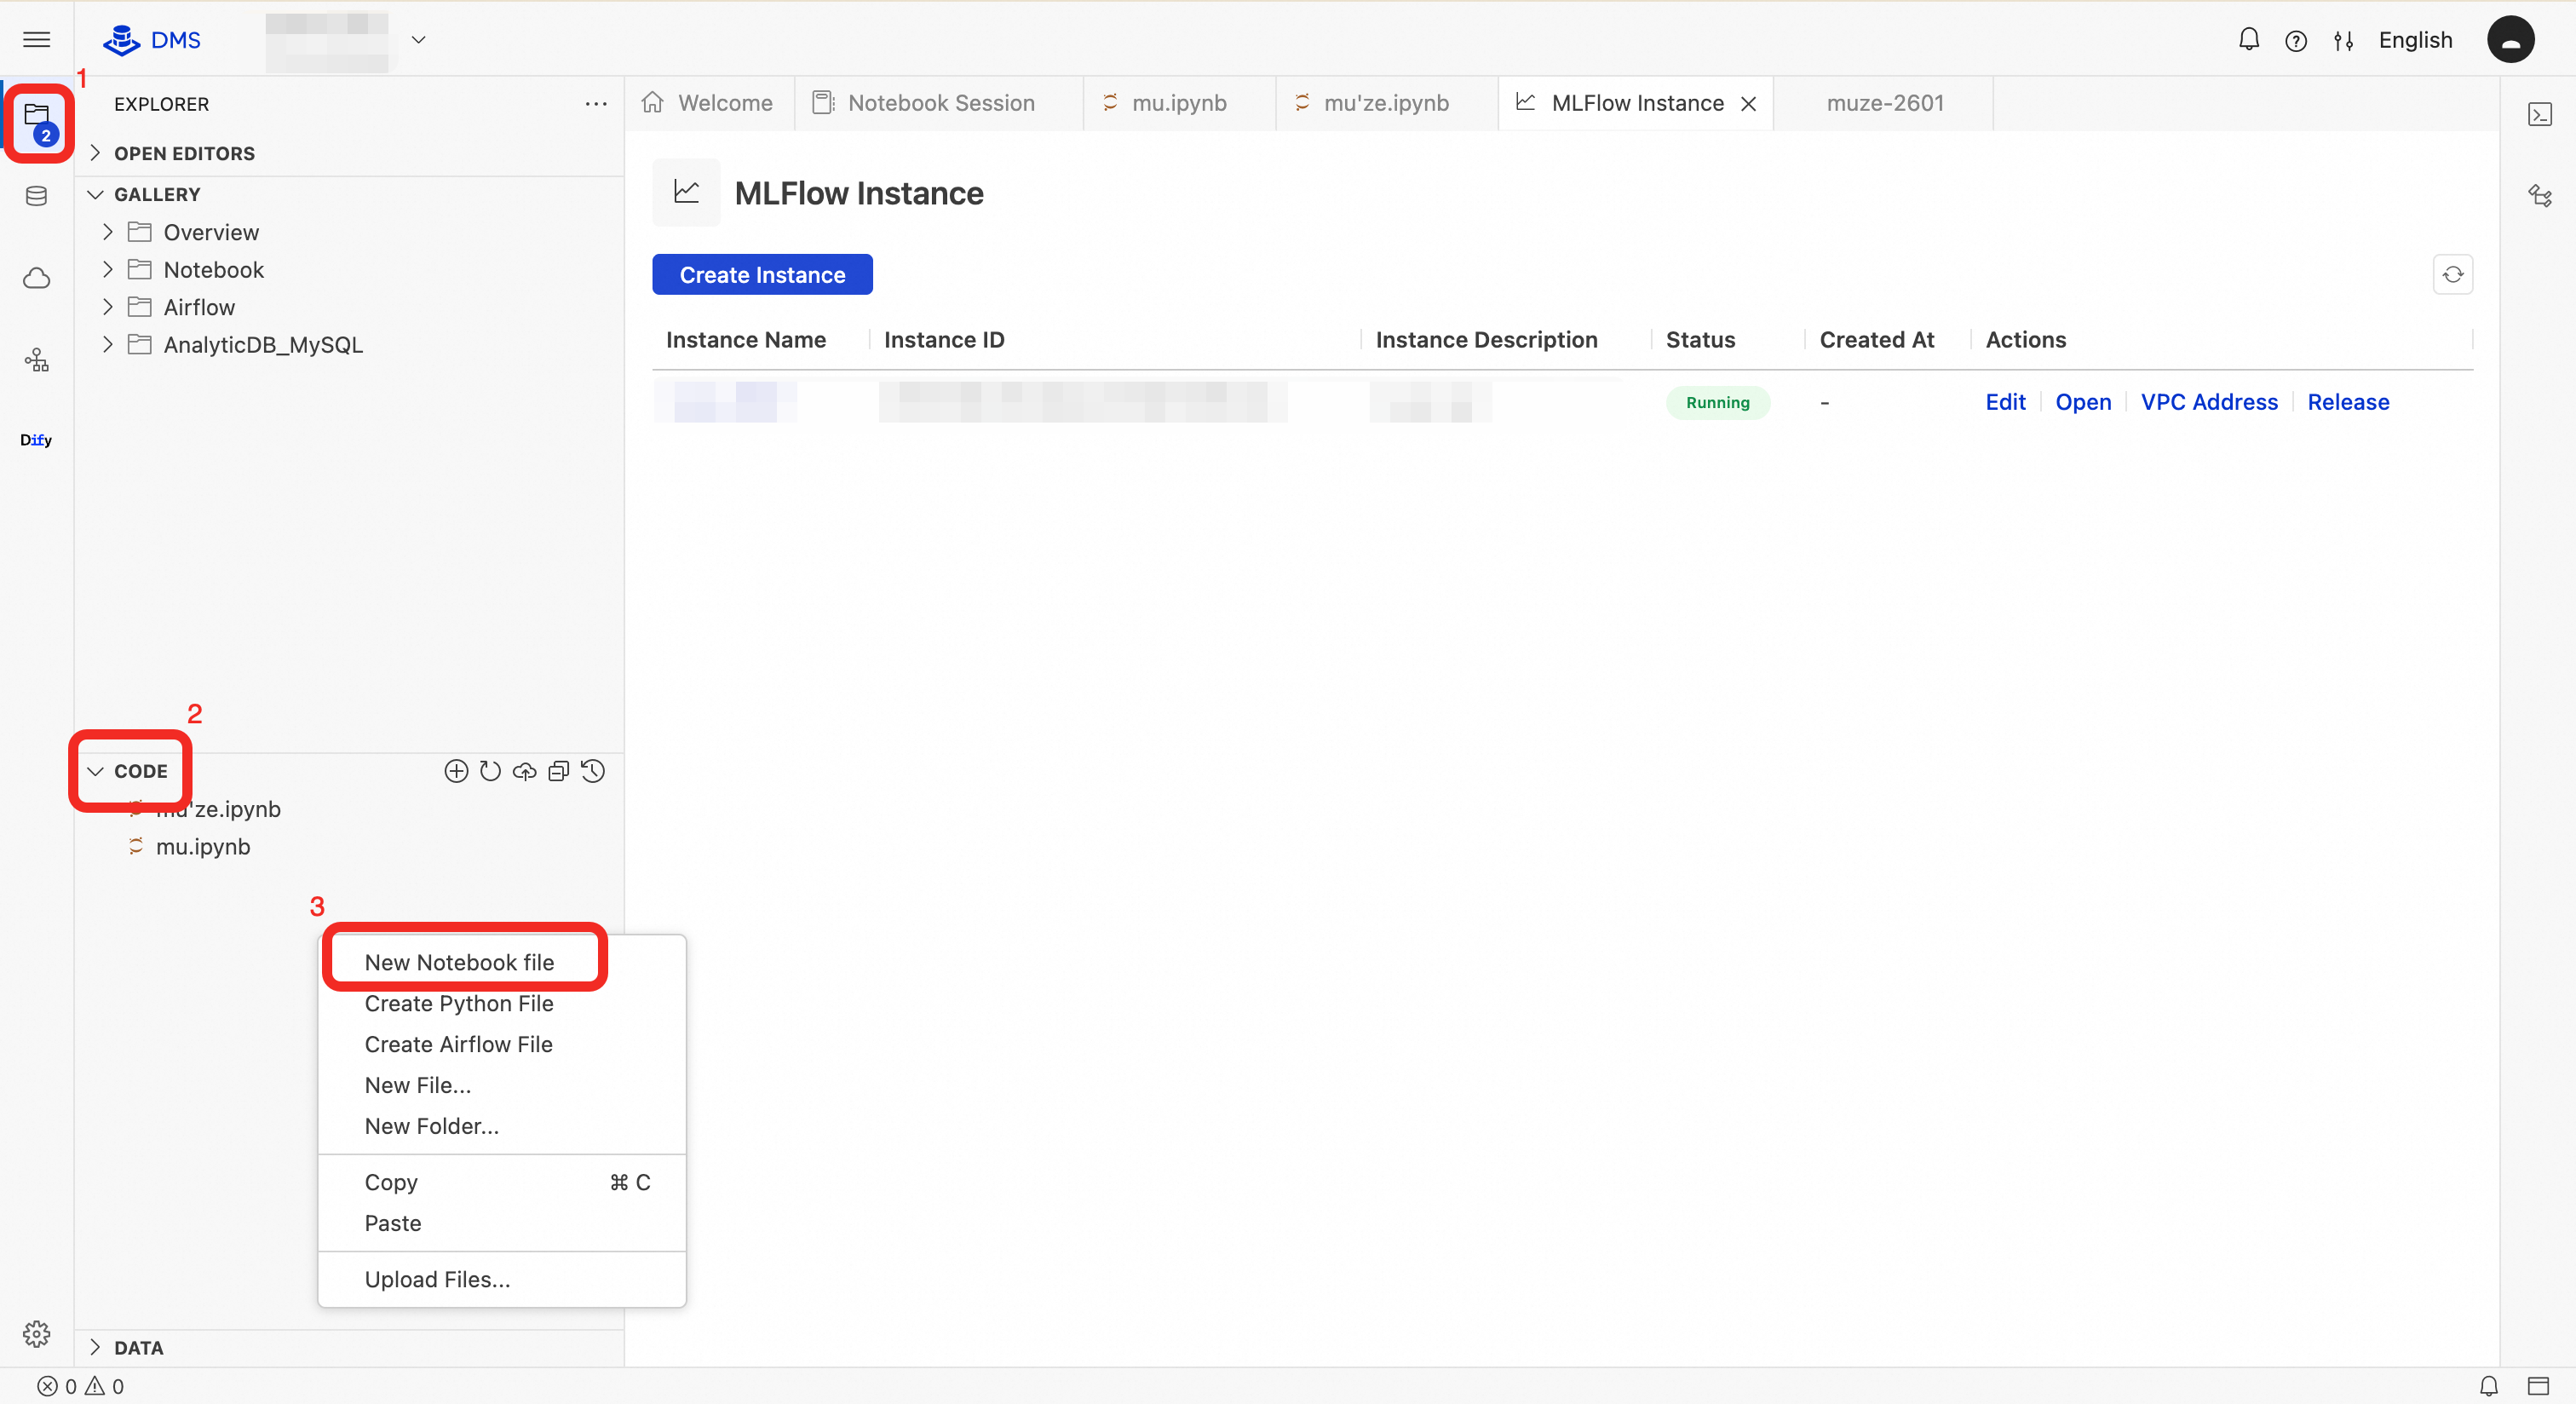
MLflow Python SDK のインストール:新しい Notebook ファイルのセルに
!pip install mlflowコマンドを入力し、実行ボタンをクリックします。
トレーニングコードの記述:コード内で、MLflow インスタンス詳細ページの [VPC アドレス] を使用して
SERVER_URLを置き換えます。import mlflow import mlflow.sklearn from sklearn import datasets from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score import pandas as pd def main(): # リモートトラッキング URI を設定 (メタデータロギング専用) mlflow.set_tracking_uri("http://SERVER_URL") # MLflow の実験名を設定 mlflow.set_experiment("Iris Classification") # Iris データセットをロード iris = datasets.load_iris() X = iris.data y = iris.target # 特徴量の名前を持つ DataFrame を作成 (オプション、ロギングを容易にするため) feature_names = iris.feature_names target_names = iris.target_names # データをトレーニングセットとテストセットに分割 X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42, stratify=y ) # ハイパーパラメーターを定義 n_estimators = 100 max_depth = 3 random_state = 42 # MLflow run を開始 with mlflow.start_run(run_name="RandomForest_Iris"): # ハイパーパラメーターをログに記録 mlflow.log_param("n_estimators", n_estimators) mlflow.log_param("max_depth", max_depth) mlflow.log_param("random_state", random_state) mlflow.log_param("test_size", 0.2) # モデルを作成してトレーニング model = RandomForestClassifier( n_estimators=n_estimators, max_depth=max_depth, random_state=random_state ) model.fit(X_train, y_train) # 予測を実行 y_pred = model.predict(X_test) # 評価メトリックを計算 accuracy = accuracy_score(y_test, y_pred) precision = precision_score(y_test, y_pred, average='weighted') recall = recall_score(y_test, y_pred, average='weighted') f1 = f1_score(y_test, y_pred, average='weighted') # 評価メトリックをログに記録 mlflow.log_metric("accuracy", accuracy) mlflow.log_metric("precision", precision) mlflow.log_metric("recall", recall) mlflow.log_metric("f1_score", f1) # 特徴量とターゲットの名前をタグとしてログに記録 mlflow.set_tag("features", ", ".join(feature_names)) mlflow.set_tag("targets", ", ".join(target_names)) mlflow.set_tag("algorithm", "RandomForestClassifier") print(f"Model trained successfully!") print(f"Accuracy: {accuracy:.4f}") print(f"Precision: {precision:.4f}") print(f"Recall: {recall:.4f}") print(f"F1 Score: {f1:.4f}") # モデルをログに記録 mlflow.sklearn.log_model(model, "iris_model") # 現在の run に関する情報を取得 run_id = mlflow.active_run().info.run_id experiment_id = mlflow.active_run().info.experiment_id print(f"Run ID: {run_id}") print(f"Experiment ID: {experiment_id}") if __name__ == "__main__": main()
よくある質問
Q:DMS MLflow に IP アドレスでアクセスできないのはなぜですか?
A:次の順序で問題を確認してトラブルシューティングしてください:アクセス制御:ALB のアクセス制御ポリシーに、現在のデバイスまたは Notebook の CIDR ブロックからのトラフィックを許可するルールを追加したことを確認します。
セキュリティグループ:MLflow インスタンスに関連付けられたセキュリティグループのインバウンドルールが、ソース IP アドレスからのポート 80 でのトラフィックを許可していることを確認します。
ネットワーク接続性:クライアント環境 (ローカル PC や ECS インスタンスなど) が、MLflow インスタンスの VPC へのネットワークパス (VPN や Cloud Enterprise Network など) を持っていることを確認します。
Q:トレーニング済みのモデルファイルはどこに保存されますか?
A:DMS MLflow はモデルファイルのようなバイナリアーティファクトを保存しません。構成した Alibaba Cloud OSS バケットとパスがデフォルトのアーティファクトルートになります。実験を作成する際に明示的にアーティファクトルートを指定することもできます。実行環境 (Notebook など) は、アーティファクトを OSS にアップロードするために必要な認証情報を持っている必要があります。アーティファクトストレージに Alibaba Cloud OSS を使用する場合は、MLflow プラグインの使用を推奨します:https://mlflow.org/docs/latest/ml/plugins/#storage--persistenceQ:DMS MLflow インスタンスをリリースした後、関連する ALB と RDS リソースは自動的に削除されますか?
A:通常の状況では、DMS MLflow インスタンスをリリースすると、システムは関連する ALB インスタンスとバックエンドの RDS データベースインスタンスの両方を自動的にクリーンアップして解放します。手動での削除は不要です。MLflow インスタンスのリリース後に ALB インスタンスが自動的にクリーンアップされず、手動での削除がエラーで失敗する場合、これは基盤となるリソースの問題が残っていることを示します。この場合は、チケットを送信して Alibaba Cloud テクニカルサポートに連絡し、支援を求めてください。
Q:DMS MLflow はパブリックネットワークアクセスをサポートしていますか?どのように構成しますか?
A:データセキュリティ上の理由から、パブリックインターネット経由で MLflow サービスに直接アクセスすることは推奨しません。VPC 内での使用を推奨します。ワークロードがパブリックネットワークアクセスを必要とする場合は、NAT Gateway 上で DNAT ルールを構成して、指定されたポート (ポート 80 など) のパブリック IP アドレスを、MLflow インスタンスに関連付けられた ALB インスタンスのプライベート IP アドレスにマッピングすることができます。
警告MLflow をパブリックインターネットに公開すると、セキュリティリスクが増大します。厳格なセキュリティグループポリシーとアクセス制御ホワイトリストを構成するようにしてください。