割り当てノードは、クエリ結果またはアップストリームノードからの出力をダウンストリームノードに渡します。 MaxCompute SQL、Python 2、および Shell をサポートしており、最後のクエリまたは出力結果をノードの出力パラメーター (outputs) に自動的に割り当てます。ダウンストリームノードは、このパラメーターを参照して結果を取得します。
使用上の注意
バージョン要件:DataWorks Standard Edition 以降でのみ利用可能です。
権限:お使いの RAM アカウントが対象の ワークスペース に追加され、開発者 または ワークスペース管理者 のロールが割り当てられている必要があります。詳細については、「ワークスペースへのメンバーの追加」をご参照ください。
主な概念:パラメーター渡しと参照
割り当てノードのコア機能は、アップストリームノードからダウンストリームノードへデータを転送する パラメーター渡し です。
アップストリームの割り当てノード:データを生成し、最後の出力またはクエリ結果を、システムが生成した
outputsという名前の 出力パラメーター に 自動的に割り当て ます。ダウンストリームのビジネスノード:データを受信して使用します。 入力パラメーター (例:
param) を設定し、その値をアップストリームノードのoutputsパラメーターを参照するように設定します。これにより、データがコードで利用可能になります。
パラメーター形式
次の表では、渡されるパラメーターの形式について説明します。
言語 | 値 | 形式 |
MaxCompute SQL | 最後の | ノードは出力を 2次元配列 としてダウンストリームノードに渡します。 |
Python 2 | 最後の | DataWorks は出力文字列を カンマ ( たとえば、割り当てノードの最終行が 重要 出力自体にカンマが含まれている場合は、エスケープする必要があります。たとえば、出力が |
Shell | 最後の |
操作手順
コンソールでの割り当てノードの作成と使用
次の例では、割り当てノードの結果を Shell ノードに渡す ことで、一般的な手順を示します。実際には、任意のノードタイプ をダウンストリームノードとして使用できます。
アップストリームの割り当てノードの設定
対象のワークフローで、割り当てノードを作成して編集します。 MaxCompute SQL、Python 2、または Shell を選択し、ダウンストリームノードに渡したい結果を生成するコードを記述します。
print '10,20,30,40'ダウンストリームの Shell ノードの設定
Shell ノードを作成します。Shell ノードの編集ページで、アップストリームの結果を参照します:
右側の スケジューリング設定 パネルで、ノードコンテキストパラメーター タブを選択します。
ノードの入力パラメータ セクションで、パラメーターの追加 をクリックします。
表示されるダイアログで、上流ノードの出力パラメーターを、前のステップで設定した代入ノードの
outputsパラメーターに設定し、現在のノードの入力パラメーターにカスタム パラメータ名 を指定します (例:param)。説明設定後、ダウンストリームノードはアップストリームの割り当てノードへの依存関係を自動的に確立します。
パラメーターを設定した後、
${param}形式を使用して、ダウンストリームの Shell ノードのコード内でアップストリームノードから渡された値を使用できます。
ダウンストリームの Data Integration ノードの設定
実際には、Data Integration のオフライン同期ノードも割り当てノードのダウンストリームノードとして機能します:
Data Integration のオフライン同期ノードを作成し、割り当てノードのダウンストリームノードとして接続します。
オフライン同期ノードのスケジューリング設定ページで、ノードコンテキストパラメーター タブをクリックします。
パラメーターの追加 をクリックして入力パラメーターを追加し、その値のソースを上流の代入ノードの
outputsパラメーターに設定します。ノードコードでパラメーターを参照します:パラメーターが文字列型の場合は、値を二重引用符 (
"") で囲みます。パラメーターが文字列型でない場合は、引用符を追加しないでください。
結果の検証
ワークフローに戻り、ツールバーの [デプロイ] をクリックします。フルデプロイメントを選択します。
オペレーションセンターでページに移動し、スモークテストを実行します。
テストインスタンスで、最終結果が期待どおりであるかを確認します。
OpenAPI を使用した割り当てノードの作成
DataWorks OpenAPI の CreateNode API を呼び出して、割り当てノードを作成することもできます。
OpenAPI を使用して割り当てノードを作成するには、DataWorks Standard Edition 以降を使用する必要があります。Basic Edition を使用している場合、次のエラーが返されます: Node type CONTROLLER_ASSIGNMENT requires STANDARD edition or higher。
既存のワークフローにノードを作成するには、ListWorkflowDefinitions を呼び出してワークフローをクエリします。次に、レスポンス内のワークフローオブジェクトのトップレベルの Id を ContainerId として使用します。Script.Id は使用しないでください。
CreateNode を呼び出す際に、次のリクエストパラメーターを設定します:
ProjectId:DataWorks ワークスペースの ID。Scene:DataWorks プロジェクトにノードを作成する場合は、このパラメーターをDATAWORKS_PROJECTに設定します。ContainerId:対象のワークフローのトップレベルのId。既存のワークフローにノードを作成する場合にのみ、このパラメーターを指定します。Spec:シリアル化された FlowSpec JSON 文字列。
次の FlowSpec の例では、MaxCompute SQL の割り当てノードを作成します。スクリプト言語、データソース、およびスクリプトの内容が一致していることを確認してください。
{
  "version": "1.1.0",
  "kind": "Node",
  "spec": {
    "nodes": [
      {
        "recurrence": "Normal",
        "instanceMode": "T+1",
        "datasource": {
          "name": "<MAXCOMPUTE_DATASOURCE_NAME>",
          "type": "odps"
        },
        "script": {
          "language": "odps-sql",
          "runtime": {
            "command": "CONTROLLER_ASSIGNMENT",
            "commandTypeId": 1100
          },
          "content": "SELECT '10' AS value UNION ALL SELECT '20';"
        },
        "trigger": {
          "type": "Scheduler",
          "cron": "00 00 00 * * ?",
          "startTime": "1970-01-01 00:00:00",
          "endTime": "9999-01-01 00:00:00",
          "timezone": "Asia/Shanghai",
          "delaySeconds": 0
        },
        "runtimeResource": {
          "resourceGroup": "<RESOURCE_GROUP_IDENTIFIER>"
        },
        "name": "assignment_node_demo",
        "owner": "<OWNER_ID>"
      }
    ]
  }
}
CreateNode の Spec パラメーターは文字列です。Python SDK を使用する場合は、json.dumps(flow_spec, ensure_ascii=False) を呼び出して FlowSpec をシリアル化してから、CreateNodeRequest.spec に値を渡してください。Python の辞書を直接渡さないでください。
spec.nodes[].runtimeResource.resourceGroup にリソースグループの識別子を指定します。表示名ではなく、リソースグループの識別子を使用してください。
ContainerId を指定すると、FlowSpec の script.path フィールドはノードの場所を決定しなくなります。
CreateNode から返される Id は、サーバーによって生成された実際のノード ID であり、FlowSpec の nodes[].id とは異なる場合があります。ノードが作成されたら、返された Id で GetNode を呼び出します。レスポンスでノードタイプ、ワークフロー、データソース、およびリソースグループを確認してください。
注意事項
受け渡し階層:割り当てノードのパラメーターは、直接のダウンストリーム子ノードにのみ渡すことができます。レベルをまたいだパラメーターの受け渡しはサポートされていません。
サイズ制限:渡される値の最大サイズは 2 MB です。出力がこの制限を超えると、割り当てノードは失敗します。
構文の制限:
割り当てノードのコードでは、コメントは サポートされていません。コメントを追加すると、予期しない結果を引き起こす可能性があります。
MaxCompute SQL モードでは、WITH 構文はサポートされていません。
データソース要件:MaxCompute SQL を使用して値を割り当てる場合は、MaxCompute コンピューティングリソースを設定し、対応する MaxCompute データソースを選択する必要があります。Python または Shell を使用して値を割り当てる場合は、MaxCompute データソースを設定する必要はありません。割り当て結果をブランチノードなどのダウンストリームノードに直接渡すことができます。
例:言語別の詳細な説明
outputs の出力形式と、ダウンストリームノードがそれをどのように参照するかは、言語によって異なります。次の例では、ダウンストリームノードとして Shell ノードを使用します。
例1:MaxCompute SQL クエリ結果の受け渡し
SQL クエリの結果は、2次元配列としてダウンストリームノードに渡されます。
アップストリームノード (割り当てノード - SQL) の設定
SQL コードが次の通りで、クエリが2行2列を返すものとします。
SELECT 'beijing', '1001'
UNION ALL
SELECT 'hangzhou', '1002';
ダウンストリームノード (Shell ノード) の設定と出力
Shell ノードで、
regionという名前の入力パラメーターを追加し、アップストリームの SQL ノードのoutputsパラメーターを参照します。次のコードを記述してデータを読み取ります:
echo "Entire result set: ${region}"
echo "First row: ${region[0]}"
echo "First row, second field: ${region[0][1]}"
DataWorks はパラメーターを直接解析し、静的な置換を実行します。出力は次のようになります:
Entire result set: beijing,1001
hangzhou,1002
First row: beijing,1001
First row, second field: 1001
例2:Python 2 の出力結果の受け渡し
Python 2 の print 文の出力は、カンマ (,) で分割され、1次元配列としてダウンストリームノードに渡されます。
アップストリームノード (割り当てノード - Python 2) の設定
Python 2 のコードは次のとおりです:
print 'Electronics, Clothing, Books';ダウンストリームノード (Shell ノード) の設定と出力
Shell ノードで、
typesという名前の入力パラメーターを追加し、アップストリームの割り当てノードのoutputsパラメーターを参照します。次のコードを記述してデータを読み取ります:
# 1次元配列全体を直接出力
echo "Entire result set: ${types}"

# インデックスで要素を出力
echo "Second element: ${types[1]}"
DataWorks はパラメーターを直接解析し、静的な置換を実行します。出力は次のようになります:
Entire result set: Electronics,Clothing,Books
Second element: Clothing
Shell ノードの処理ロジックは Python 2 と同様であるため、ここでは繰り返しません。
シナリオ:複数のビジネスラインにまたがるパーティションテーブルデータの一括処理
この例では、割り当てノード と for-each ノード を使用して、複数のビジネスラインにわたるユーザー行動データを一括処理する方法を示します。これにより、単一のロジックで複数の製品ラインに対応するデータ処理を自動化できます。

背景情報
あなたが総合インターネット企業のデータ開発エンジニアで、3つのコアビジネスライン (Eコマース (ecom)、金融 (finance)、物流 (logistics)) のデータ処理を担当しており、将来的にはさらに追加される可能性があるとします。これらの3つのビジネスラインのユーザー行動ログに対して、毎日同じ集計ロジックを実行し、ユーザーごとの 日次ページビュー (PV) を計算し、結果を統一された集計テーブルに保存する必要があります。
アップストリームのソーステーブル (DWD レイヤー):
dwd_user_behavior_ecom_d:Eコマースのユーザー行動テーブル。dwd_user_behavior_finance_d:金融のユーザー行動テーブル。dwd_user_behavior_logistics_d:物流のユーザー行動テーブル。dwd_user_behavior_${business_line}_d:将来の追加のビジネスラインのユーザー行動テーブル。これらのテーブルは同じスキーマを持ち、日次 (
dt) でパーティション分割されています。
ダウンストリームのターゲットテーブル (DWS レイヤー):
dws_user_summary_d:ユーザー集計テーブル。このテーブルは、ビジネスライン (
biz_line) と日次 (dt) で二重にパーティション分割されており、すべてのビジネスラインからの集計結果を統一的に保存します。
ビジネスラインごとに個別のタスクを作成すると、メンテナンスコストが高くなり、エラーが発生しやすくなります。for-each ノードを使用すると、単一の処理ロジックを維持するだけで、システムが自動的にすべてのビジネスラインを反復処理して計算を完了します。
データ準備
まず、サンプルテーブルを作成し、テストデータを挿入します (例として業務日付 20251010 を使用)。
データ開発のために Data Studio に移動し、MaxCompute SQL ノードを作成します。
ソーステーブル (DWD レイヤー) を作成します:次のコードを MaxCompute SQL ノードに追加して実行します。
-- Eコマースユーザー行動テーブル
CREATE TABLE IF NOT EXISTS dwd_user_behavior_ecom_d (
    user_id     STRING COMMENT 'ユーザー ID',
    action_type STRING COMMENT 'アクションタイプ',
    event_time  BIGINT COMMENT 'イベントタイムスタンプ (ミリ秒単位の Unix 時間)'
)
COMMENT 'Eコマースユーザー行動ログ詳細テーブル'
PARTITIONED BY (dt STRING COMMENT '日付パーティション、形式 yyyymmdd');
INSERT OVERWRITE TABLE dwd_user_behavior_ecom_d PARTITION (dt='20251010') VALUES
('user001', 'click',        1760004060000), -- 2025-10-10 10:01:00.000
('user002', 'browse',       1760004150000), -- 2025-10-10 10:02:30.000
('user001', 'add_to_cart',  1760004300000); -- 2025-10-10 10:05:00.000
-- Eコマースユーザー行動テーブルが正常に作成されたことを確認
SELECT * FROM dwd_user_behavior_ecom_d where dt='20251010';
-- 金融ユーザー行動テーブル
CREATE TABLE IF NOT EXISTS dwd_user_behavior_finance_d (
    user_id     STRING COMMENT 'ユーザー ID',
    action_type STRING COMMENT 'アクションタイプ',
    event_time  BIGINT COMMENT 'イベントタイムスタンプ (ミリ秒単位の Unix 時間)'
)
COMMENT '金融ユーザー行動ログ詳細テーブル'
PARTITIONED BY (dt STRING COMMENT '日付パーティション、形式 yyyymmdd');
INSERT OVERWRITE TABLE dwd_user_behavior_finance_d PARTITION (dt='20251010') VALUES
('user003', 'open_app',      1760020200000), -- 2025-10-10 14:30:00.000
('user003', 'transfer',      1760020215000), -- 2025-10-10 14:30:15.000
('user003', 'check_balance', 1760020245000), -- 2025-10-10 14:30:45.000
('user004', 'open_app',      1760020300000); -- 2025-10-10 14:31:40.000
-- 金融ユーザー行動テーブルが正常に作成されたことを確認
SELECT * FROM dwd_user_behavior_finance_d where dt='20251010';
-- 物流ユーザー行動テーブル
CREATE TABLE IF NOT EXISTS dwd_user_behavior_logistics_d (
    user_id     STRING COMMENT 'ユーザー ID',
    action_type STRING COMMENT 'アクションタイプ',
    event_time  BIGINT COMMENT 'イベントタイムスタンプ (ミリ秒単位の Unix 時間)'
)
COMMENT '物流ユーザー行動ログ詳細テーブル'
PARTITIONED BY (dt STRING COMMENT '日付パーティション、形式 yyyymmdd');
INSERT OVERWRITE TABLE dwd_user_behavior_logistics_d PARTITION (dt='20251010') VALUES
('user001', 'check_status',    1760032800000), -- 2025-10-10 18:00:00.000
('user005', 'schedule_pickup', 1760032920000); -- 2025-10-10 18:02:00.000
-- 物流ユーザー行動テーブルが正常に作成されたことを確認
SELECT * FROM dwd_user_behavior_logistics_d where dt='20251010';
ターゲットテーブル (DWS レイヤー) を作成します:次のコードを MaxCompute SQL ノードに追加して実行します。
CREATE TABLE IF NOT EXISTS dws_user_summary_d ( user_id STRING COMMENT 'ユーザー ID', pv BIGINT COMMENT '日次アクティビティ数' ) COMMENT 'ユーザー日次アクティビティ集計テーブル' PARTITIONED BY ( dt STRING COMMENT '日付パーティション、形式 yyyymmdd', biz_line STRING COMMENT 'ビジネスラインパーティション、例:ecom, finance, logistics' );重要ワークスペースが標準モードを使用している場合、このノードを本番環境にデプロイし、データをバックフィルする必要があります。
ワークフローの実装
ワークフローを作成します。右側の [スケジューリングパラメーター] セクションで、スケジューリングパラメーター bizdate を前日に設定します:
$[yyyymmdd-1]。ワークフローで、get_biz_list という名前の割り当てノードを作成し、そのノードで MaxCompute SQL を使用して次のコードを記述します。このノードは、処理するビジネスラインのリストを出力します:
-- 処理対象のすべてのビジネスラインを出力
SELECT 'ecom' AS biz_line
UNION ALL
SELECT 'finance' AS biz_line
UNION ALL
SELECT 'logistics' AS biz_line;
for-each ノードの設定
ワークフローページに戻り、割り当てノード get_biz_list のダウンストリームに for-each ノードを作成します。
for-each ノードの設定ページを開きます。 右側の [スケジューリング設定] の下にある セクションで、loopDataArray パラメーターを get_biz_list ノードの outputs にバインドします。
for-each ノードのループ本体で、[内部ノードの作成] をクリックし、MaxCompute SQL ノードを作成します。ループ本体内に処理ロジックを記述します。
説明このスクリプトは for-each ノードによって起動され、ビジネスラインごとに1回実行されます。
組み込み変数 ${dag.foreach.current} は、反復ごとに現在のビジネスライン名に動的に置換されます。期待される反復値は 'ecom'、'finance'、'logistics' です。
SET odps.sql.allow.dynamic.partition=true;
INSERT OVERWRITE TABLE dws_user_summary_d PARTITION (dt='${bizdate}', biz_line)
SELECT
    user_id,
    COUNT(*) AS pv,
    '${dag.foreach.current}' AS biz_line
FROM
    dwd_user_behavior_${dag.foreach.current}_d
WHERE
    dt = '${bizdate}'
GROUP BY
    user_id;
検証ノードの追加
ワークフローに戻ります。for-each ノードで [ダウンストリームの作成] をクリックして MaxCompute SQL ノード を作成し、次のコードを追加します。
SELECT * FROM dws_user_summary_d WHERE dt='20251010' ORDER BY biz_line, user_id;
デプロイと結果
ワークフローを本番環境にデプロイします。オペレーションセンターの ページに移動します。対象のワークフローを見つけ、業務日付を '20251010' に設定してスモークテストを実行します。
実行が完了したら、テストインスタンスで実行ログを表示します。最終ノードの期待される出力は次のとおりです:
user_id | pv | dt | biz_line |
user001 | 2 | 20251010 | ecom |
user002 | 1 | 20251010 | ecom |
user003 | 3 | 20251010 | finance |
user004 | 1 | 20251010 | finance |
user001 | 1 | 20251010 | logistics |
user005 | 1 | 20251010 | logistics |
メリット
高いスケーラビリティ:新しいビジネスラインを追加するには、処理ロジックを変更することなく、割り当てノードに SQL を1行追加するだけです。
容易なメンテナンス:すべてのビジネスラインが単一の処理ロジックを共有します。1つの変更がすべてに適用されます。
よくある質問
Q:MaxCompute SQL モードで、エラー "find no select sql in sql assignment!" が返されます。
A:MaxCompute SQL コードに
SELECT文がありません。SELECT文を追加してください。WITH 構文はサポートされておらず、WITH 文を使用した場合もこのエラーが返されます。Q:Shell または Python モードで、エラー "OutPut Result is null, cannot handle!" が返されます。
A:出力がありません。コードに print 文 (
printやecho) が含まれているか確認してください。Q:Shell または Python モードで、カンマを含む出力要素を処理するにはどうすればよいですか?
A:
\,を使用してカンマ (,) をエスケープします。次の例では Python を使用します:categories = ["Electronics", "Clothing, Shoes & Accessories"] # 各要素に含まれるカンマをエスケープ # ',' を '\,' に置換 escaped_categories = [cat.replace(",", "\,") for cat in categories] # エスケープされた要素をカンマで結合 output_string = ",".join(escaped_categories) print output_string # ダウンストリームに出力される最終的な文字列: # Electronics,Clothing\, Shoes & AccessoriesQ:ダウンストリームノードは、複数のアップストリーム割り当てノードから結果を受け取ることができますか?
A:はい。異なるノードの結果を異なるパラメーターに割り当てるだけです。
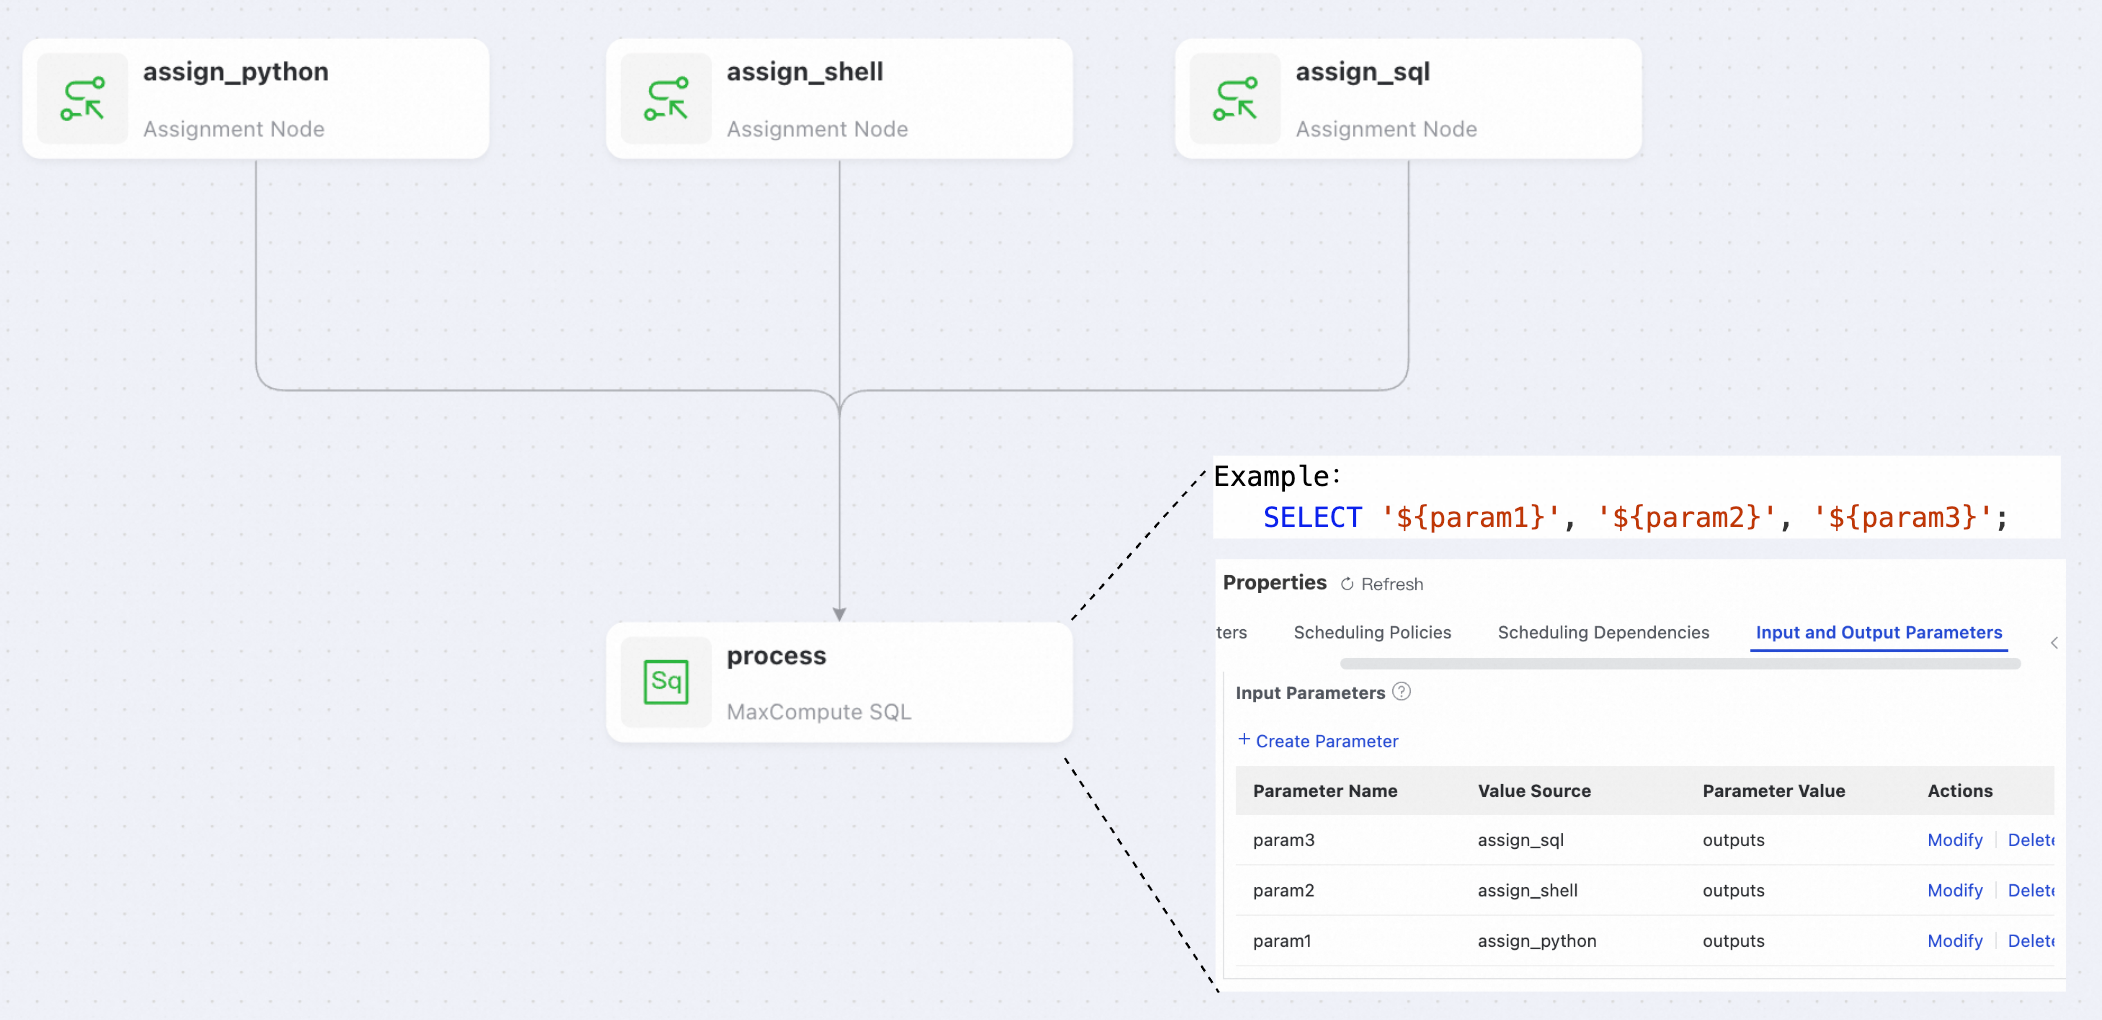
Q:割り当てノードは他の言語タイプをサポートしていますか?
A:割り当てノードは現在、MaxCompute SQL、Python 2、Shell のみをサポートしています。EMR Hive、Hologres SQL、EMR Spark SQL、AnalyticDB for PostgreSQL、ClickHouse SQL、MySQL などの一部のノードタイプは、ネイティブで 割り当てパラメーター 機能をサポートしており、同様の効果を実現できます。
[ノード出力パラメーター] セクションで、[+ 割り当てパラメーターの追加] をクリックします。詳細については、「ノードコンテキストパラメーターの設定と使用」をご参照ください。
関連ドキュメント
ダウンストリームノードがループでデータを反復処理する必要がある場合は、「Do-whileノード」および「For-eachノード」をご参照ください。
レベルをまたいでパラメーターを渡す必要がある場合は、「仮想ノード」をご参照ください。
パラメーター渡しの設定に関する詳細については、「ノードコンテキストパラメーター」をご参照ください。