このトピックでは、JDBC ドライバーを使用して Dataphin に接続する方法について説明します。
前提条件
Dataphin JDBC ドライバーは、Dataphin OpenAPI を使用して SQL クエリ機能を提供します。Dataphin JDBC ドライバーを使用する前に、Dataphin OpenAPI 機能を有効にする必要があります。
特徴
2 つの認証モード: Dataphin JDBC ドライバーは、シンプルモードとプロキシモードの 2 つの認証モードをサポートしています。詳細については、「認証モード」をご参照ください。
Dataphin JDBC ドライバーで SQL ステートメントを実行すると、Dataphin コンソールで実行した場合と同じ結果が得られます。権限、脱感作ルール、セキュリティ設定など、Dataphin の設定は、ドライバーを介して行われるクエリにも適用されます。
制限事項
JDBC を使用して、Dataphin のすべてのコンピュートソースと一部のデータソースに接続できます。サポートされているデータソースには、MySQL、Oracle、MaxCompute、Hive、AnalyticDB for MySQL 3.0、StarRocks、AnalyticDB for PostgreSQL、Doris、PostgreSQL が含まれます。
Dataphin JDBC ドライバーを使用して SQL ステートメントを実行すると、そのステートメントは SQL 変換や脱感作などのタスクのために Dataphin によって前処理されます。結果データも Dataphin を介して送信および転送されます。このプロセスによりオーバーヘッドが発生し、コンピュートエンジンを直接クエリする場合と比較してクエリ時間が増加する可能性があります。
Dataphin JDBC ドライバーを介して実行される SQL ステートメントは、OpenAPI を通じて Dataphin に送信され、その後、基盤となるコンピュートエンジンに転送されます。Dataphin JDBC ドライバーを使用する前に、予想される呼び出し量を推定して、Dataphin クラスターとコンピュートエンジンをスケールアウトする必要があるかどうかを判断してください。
説明容量のニーズを推定できない場合は、Dataphin クラスターの容量評価リクエストを Dataphin O&M チームに提出できます。この評価はコンピュートエンジンを対象としません。
Dataphin は現在、トラフィックの速度制限や同時実行制御をサポートしていません。影響を慎重に評価してください。
JDBC ドライバーのバージョンとダウンロードリンク
ドライバーの JAR ファイルを入手するには、Dataphin O&M チームにお問い合わせください。
接続パラメーター
Dataphin JDBC ドライバーがプラットフォームの AccessKey ID と AccessKey Secret (プロキシモード) を使用する場合、set 構文を使用して接続のユーザーを指定できます。
set dp_delegation_uid = 'target_source_user_uid';set dp_delegation_name = 'target_user_name';
JDBC URL フォーマット: jdbc:dataphin://host:port/catalog?[tenant_id=TenantID][&ssl=true][&log_level=Log_Level][&user=UserName][&password=PassWord][&delegation_uid=DelegationUid][&account_type=AccountType][&connect_timeout=ConnectTimeout][&engine=engine_type][compute_project=ProjectName]
パラメーター名では大文字と小文字が区別されます。
角括弧 ([]) はオプションのパラメーターを示します。接続文字列に含めないでください。
パラメーター | 必須 | 説明 | 例 |
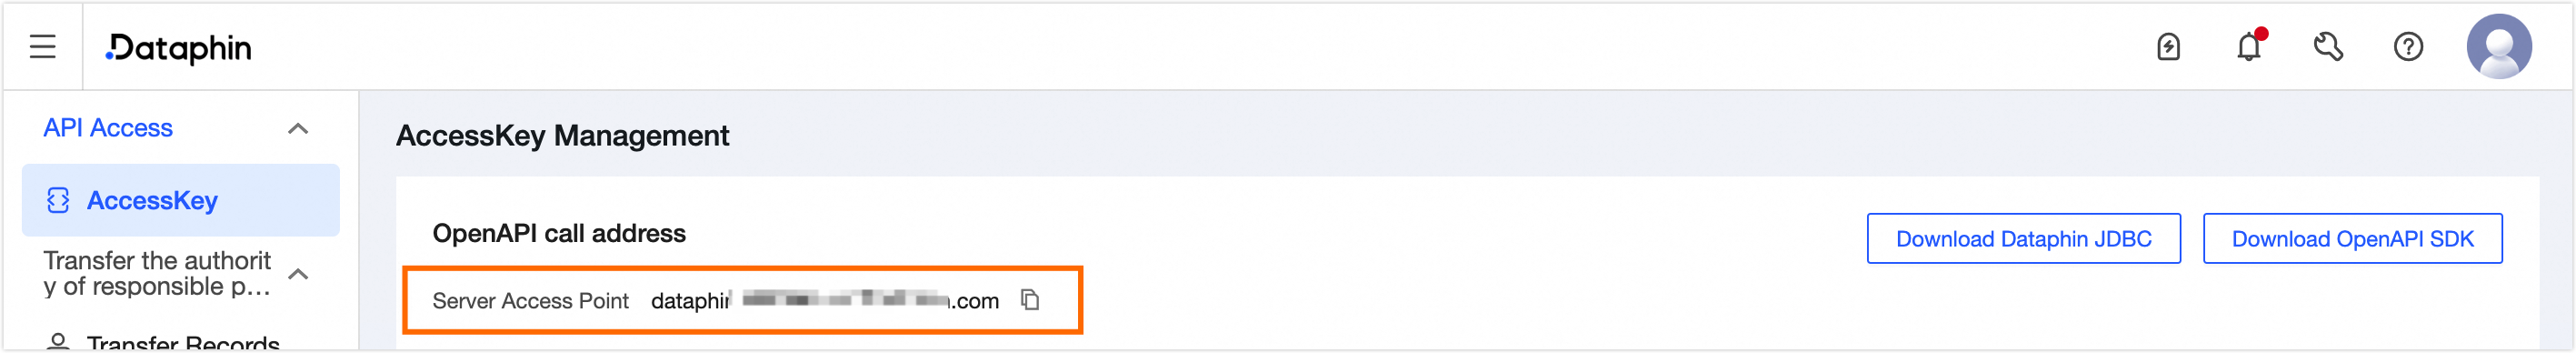
host | はい | Dataphin OpenAPI のドメイン名です。 [ユーザーセンター] > [AccessKey 管理] で、[OpenAPI 呼び出しアドレス] フィールドに Dataphin のドメイン名があります。次の図は例です。
| dataphin-openapi.****.aliyun.com |
ポート | いいえ | ポートは、Dataphin OpenAPI で HTTPS が有効になっているかどうかによって異なります。 HTTPS が有効な場合はポート | 80 |
catalog | はい | デフォルトのクエリ範囲です。
説明
| Exprojectname |
tenant_id | はい | クエリするテナント ID です。 | 111***111 |
ssl | いいえ | HTTPS を使用するかどうかを指定します。
| False |
currentschema | いいえ | データソースのスキーマです。
| information_schema |
compute_project | いいえ | 英語のプロジェクト名です。Dataphin はこのプロジェクトを SQL クエリの実行プロジェクトとして使用します。プロジェクトと、それにバインドされているコンピューティングソースは、テーブルに対する読み取り権限を持つ必要があります。
| Exprojectname |
ユーザー | はい | ユーザーの AccessKey ID またはプラットフォームの AccessKey ID です。プロキシモードでは、プラットフォームの AccessKey ID を使用します。
| kIB**********PT0 |
log_level | いいえ | ログレベル。有効な値:
| DEBUG |
password | はい | ユーザーの AccessKey シークレットです。
| Cy**************r2T |
delegation_uid | いいえ | プロキシされるユーザーの ID です。フォーマットは、指定された account_type と一致している必要があります。このパラメーターを設定すると、プロキシモードが有効になります。 プロキシ経由でアクセスされる Dataphin ユーザーの場合、選択した account_type に基づいて対応するアカウント ID を渡す必要があります。このパラメーターを設定することで、プロキシモードでの認証が有効になります。 | 999***999 |
account_type | いいえ | プロキシモードでは、プロキシユーザーのアカウントタイプを指定する必要があります。
説明
| USER_ID |
connect_timeout | いいえ | 接続タイムアウト (秒)。
| 10 |
engine | いいえ | 会話または接続文字列内の
説明 このパラメーターは、データソースへのアクセス時に無視されます。 | MaxCompute |
認証モード
シンプルモード
ユーザー名をユーザーの AccessKey ID に、パスワードをユーザーの AccessKey Secret に設定します。これにより、現在の接続はそのユーザーからのものとして識別されます。AccessKey を表示するには、「Dataphin OpenAPI AccessKey の管理」をご参照ください。
JDBC ドライバーを使用して Dataphin に接続すると、Dataphin は AccessKey を認証し、リソースへのアクセスや SQL 実行についてユーザーを承認します。その後、Dataphin はそのユーザーとして SQL ステートメントを実行します。
プロキシモード
プロキシモードを使用する前に、Dataphin の運用保守チームに連絡して、この機能を有効化し設定する必要があります。
プロキシモードは、ユーザーごとに AccessKey を配布または設定する必要がないため、システムレベルの統合に最適です。代わりに、アプリケーションは単一のプラットフォームレベルの AccessKey を使用し、接続文字列でプロキシするユーザーを指定します。例えば、delegation_uid=userA と設定した場合、リクエストは userA の代理として実行されます。Dataphin は、userA の機能とデータ権限に基づいてリクエストを検証します。
Dataphin ドライバーリファレンス
com.aliyun.dataphin.jdbc.DataphinDriver
API | 説明 | 署名 |
connect | データベース接続を確立します。 | |
acceptsURL | URL がサポートされているかどうかを確認します。 | |
com.aliyun.dataphin.jdbc.DataphinConnection
API | 説明 | 署名 |
createStatement | Statement オブジェクトを作成します。 | |
prepareStatement | PreparedStatement オブジェクトを作成します。 | |
com.aliyun.dataphin.jdbc.DataphinStatement
API | 説明 | シグネチャ |
executeQuery | SQL ステートメントを実行し、ResultSet オブジェクトを返します。 | |
setFetchSize | 指定された行数に基づいて結果データをバッチで取得します。この値が設定されていない、または 0 に設定されている場合、デフォルト値の 1000 が使用されます。 | |
cancel | Statement オブジェクトの実行をキャンセルします。 | |
com.aliyun.dataphin.jdbc.DataphinPreparedStatement
API | 説明 | 署名 |
executeQuery | SQL ステートメントを実行し、ResultSet オブジェクトを返します。 | |
com.aliyun.dataphin.jdbc.DataphinResultSetMetaData
API | 説明 | 署名 |
getColumnCount | 結果スキーマの列数を取得します。 | |
getColumnName | 結果スキーマの列名を取得します。 | |
com.aliyun.dataphin.jdbc.ResultSet
API | 説明 | シグネチャ |
next | SQL 実行の結果を 1 行ずつ取得します。 | |
com.aliyun.dataphin.jdbc.DatabaseMetaData
API | 説明 | シグネチャ |
getTables | テーブルに関する情報を取得します。
| |
getColumns | テーブルの列に関する情報を取得します。
| |
例
Dataphin JDBC ドライバーを使用してカタログ情報を取得できます。
1. テーブルリストの取得
プロジェクト内の物理テーブルと物理ビューのリストを返します。
構文
SHOW TABLES
    [FROM db_name]
    [LIKE 'pattern']
パラメーター
db_name:
Dataphin プロジェクト名:プロジェクト内の物理テーブルを表示します。
開発プロジェクトとデータプレートには、明示的に _Dev を追加する必要があります。
db_name が指定されていない場合、デフォルトで URL の project_name で指定されたプロジェクト内のテーブルが表示されます。
結果
パラメーター | タイプ | 説明 |
dim_user | 論理テーブル | ユーザーテーブル。 |
ods_user | 物理テーブル | ユーザーソーステーブル。 |
ods_user_logical_view | 論理ビュー | 論理ビュー。 |
ods_user_physical_view2 | 物理ビュー | 物理ビュー。 |
2. テーブルスキーマの取得
物理テーブルまたは物理ビューの列に関する詳細を取得します。
構文
{DESCRIBE | DESC} table_name;このコマンドは、物理テーブルと物理ビューのみをサポートします。
パラメーター
table_name:物理テーブルまたは物理ビューの名前。
結果
パラメーター | タイプ | 説明 |
ID | BigInt | ユーザー ID。 |
Name | String | ユーザー名。 |
DS | String | パーティション時間。 |
サーバーサイドの接続コントロール
最大接続数:デフォルト値は 100 です。
接続タイムアウト:デフォルトは 7,200 秒 (2 時間) です。この期間、接続がアイドル状態の場合、サーバーは自動的に接続を切断します。この接続で操作を実行しようとすると、エラーが発生するか、クライアントが予期せず終了します。
MaxCompute に送信されるタスク情報
Dataphin の JDBC タスクが MaxCompute の実行インスタンスに送信されると、Dataphin は以下の情報も送信します。
パラメーター | 説明 |
logical_project | JDBC タスクが実行される Dataphin プロジェクトの名前です。 |
EXT_JDBC_TASKRUN_ID | JDBC タスクの ID です。 |
EXT_DPN_TENANT_ID | JDBC タスクが実行される Dataphin テナントの ID です。 |
EXT_PLATFORM_ID | タスクを MaxCompute に送信する上位プラットフォームの ID です。デフォルト値は Dataphin です。 |
biz_id | JDBC タスクを実行するユーザーの Dataphin メンバー ID です。 |
odps.idata.userenv | ユーザー環境情報です。これには、Java SDK バージョン、Java バージョン、IP アドレス、MAC アドレスが含まれます。例:
|
この情報を使用して、MaxCompute の請求書を分析したり、ジョブの実行時間を表示したりできます。詳細については、「」コスト別のトップ N アカウントと時間のかかるジョブに関する統計の収集をご参照ください。