Container Compute Service (ACS) は、各 GPU-HPN ノードモデルの GPU トポロジーに基づいて、Pod に GPU デバイスを割り当てます。同じノード上で実行される Pod は、NVLink などのチャネルを介してデータを交換し、パーティション制約が GPU 通信の効率性と公平性を維持します。
前提条件
この機能は、gpu-hpn コンピュートクラス (compute-class) および対応する GPU-HPN ノードタイプを使用するポッドのみをサポートします。
背景情報
GPU-HPN ノード内では、GPU デバイスが 1 つ以上のチャネルを介して接続および通信し、異なる数の GPU をリクエストする Pod が同じノード上で実行される場合があります。GPU 通信の効率性と公平性を維持し、Pod が相互に干渉するのを防ぐため、ACS はノードの GPU トポロジーに基づいて Pod をスケジューリングします。ACS は、Pod がリクエストする GPU 数に一致するように GPU デバイスをパーティションに分割し、各 Pod に最適なパーティションを割り当てます。
次の図は、8 個の GPU を持つノードを示しています。4 個の GPU ごとに 1 つのグループを形成します。グループ内の GPU は直接相互接続されており、2 つのグループは PCIe を介して接続されています。
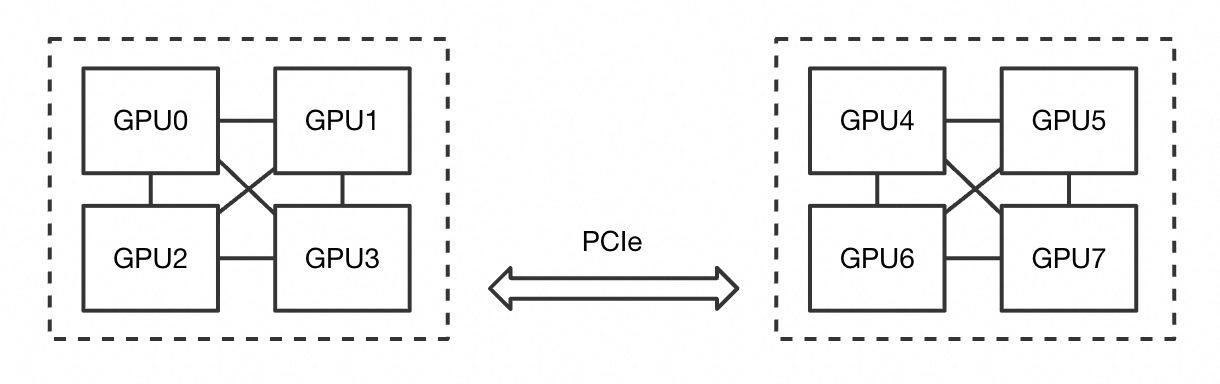
ACS は、このノードのデバイスを次のパーティションに分割します:
Pod がリクエストする GPU 数 | 利用可能なデバイス割り当て結果 |
8 | [0,1,2,3,4,5,6,7] |
4 | [0,1,2,3], [4,5,6,7] |
2 | [0,1], [2,3], [4,5], [6,7] |
1 | [0], [1], [2], [3], [4], [5], [6], [7] |
ノード上での Pod の作成と削除を繰り返すと、パーティションの断片化が発生する可能性があります。これにより、新しい Pod がスケジューリングされず、Pending 状態のままになる場合があります。Pending 状態の Pod が必要とするデバイスを解放するには、ノード上の Pod のデバイス割り当て結果を確認し、ビジネスの優先度に基づいて一部をエビクションします。このトピックの「よくある質問」では、パーティションの断片化を回避するためのノードリソースの計画方法、エビクションする Pod の選択方法、およびスケジューラの種類、バージョン、設定が、スケジューリング中にパーティションがどの程度考慮されるかにどのように影響するかについて説明します。
GPU-HPN ノードタイプのパーティション
ACS が提供する GPU-HPN ノードタイプによって、パーティションと GPU モデルは異なります。ノード上でどのパーティションが使用されているかを確認するには、そのノードで実行されている Pod のデバイス割り当て結果を表示してください。
gpu.p16en-16XL
このノードタイプには、P16EN モデルの GPU が 16 個搭載されています。次の表は、Pod がリクエストする GPU 数に応じたパーティションの一覧です。
Pod がリクエストする GPU 数 | 利用可能なデバイス割り当て結果 |
16 | [0,1,2,3,4,5,6,7,8,9,10,11,12,13,14,15] |
8 | [0,1,2,3,4,5,6,7], [8,9,10,11,12,13,14,15] |
4 | [0,1,2,3], [4,5,6,7], [8,9,10,11], [12,13,14,15] |
2 | [0,3], [1,2], [4,7], [5,6], [8,11], [9,10], [12,15], [13,14] |
1 | [0], [1], [2], [3], [4], [5], [6], [7], [8], [9], [10], [11], [12], [13], [14], [15] |
Pod のスケジューリング結果の表示
デバイス割り当て結果
GPU-HPN Pod の場合、デバイス割り当て結果は次の形式で Pod のアノテーションに記録されます:
apiVersion: v1
kind: Pod
metadata:
  annotations:
    alibabacloud.com/device-allocation: '{"gpus": {"minor": [0,1,2,3]}}'
パーティションの断片化によるスケジューリング失敗メッセージ
スケジューリングできない Pod は、Pending 状態のままになります。次のコマンドを実行して、スケジューリング失敗メッセージを表示してください:
kubectl describe pod pod-demo想定される出力 (他の内容は省略):
...
Events:
  Type     Reason            Age    From               Message
  ----     ------            ----   ----               -------
  Warning  FailedScheduling  26m    default-scheduler  0/5 nodes are available: 2 Node(s) Insufficient Partitioned GPU Devices, 1 Node(s) xxx, 2 Node(s) xxx.
0/5 nodes are available: xxx のようなメッセージ内の Insufficient Partitioned GPU Devices は、ノードのパーティションの断片化が原因でスケジューリングが失敗したことを示します。
よくある質問
パーティションの断片化を回避するには、ノードリソースとポリシーをどのように計画すればよいですか?
次のようにノードリソースとポリシーを計画してください:
リクエストされた GPU 数に応じたノードのグループ化:ノードに異なるラベルを設定して、Pod がリクエストする GPU 数に基づいてリソースを管理します。たとえば、8 個の GPU をリクエストする Pod と 1 個の GPU をリクエストする Pod を、異なるノードにスケジューリングします。
Pod がすでに Pending 状態の場合にアイドル状態のデバイスを解放:パーティションの断片化によってクラスター内の Pod が Pending 状態になった場合、デスケジューリングなどのメカニズムを使用して優先度の低い一部の Pod をエビクションし、Pending 状態の Pod のためにアイドル状態のデバイスを解放します。
ノードラベルを計画できない場合のキャパシティ予約:ノード数が少ない、またはノードラベルを計画できず、Pod がさまざまな GPU 数をリクエストする場合は、アプリケーションのリソース要件を満たすためにキャパシティを予約します。詳細については、「GPU Pod のキャパシティ予約」をご参照ください。
パーティションの断片化を解決する際に、エビクションする Pod はどのように選択すればよいですか?
Pending 状態の Pod がリクエストする GPU 数 (例:8 個) を特定してください。
ターゲットノードで、各 Pod の
alibabacloud.com/device-allocationアノテーションを読み取り、すでに割り当てられているデバイスを特定してください。詳細については、「デバイス割り当て結果」をご参照ください。割り当て結果に基づいてどの Pod をエビクションするかを決定し、エビクションによって解放されたデバイスが、Pending 状態の Pod がリクエストする GPU 数とパーティション制約の両方を満たすことを確認してください。たとえば、P16EN 上で 8 個の GPU をリクエストする場合、デバイス ID [0,1,2,3,4,5,6,7] または [8,9,10,11,12,13,14,15] のすべてが未割り当てである必要があります。
evictやdeleteなどのコマンドを実行して Pod をエビクションしてください。
カスタムスケジューラを使用する場合にパーティションについて知っておくべきことは何ですか?
カスタムスケジューラが Pod をノードに割り当てた後、ACS はそのノード上で Pod のデバイスを割り当てます。デバイスの割り当て中、ACS はパーティションの断片化を避けるために、可能な限り密にデバイスをパッキングします。
カスタムスケジューラは、ノードの合計 GPU 容量のみを考慮する必要があります。GPU リソースについては、ノードのビンパッキングポリシー (MostAllocated) を優先してください。これにより、パーティションの断片化が軽減されます。
GPU-HPN のパーティショントポロジーを認識するスケジューラはどれですか?
次の表を使用して、お使いのスケジューラが GPU-HPN ノードのパーティショントポロジーを認識しているかどうかを判断してください。
スケジューラの種類 | 条件 | 説明 |
ACS デフォルトスケジューラ | 次のすべての条件を満たしている:
かつ、次のいずれかのバージョン条件を満たしている:
サポートされているバージョンについては、「kube-scheduler」をご参照ください。 | スケジューラは現在のノードのパーティション割り当て状況を認識し、リクエストを満たせないパーティションを持つノードを除外します。Pod スケジューリング失敗イベントには、 |
ACK デフォルトスケジューラ | 次のすべての条件を満たしている:
サポートされているバージョンについては、「kube-scheduler」をご参照ください。 | スケジューラは現在のノードのパーティション割り当て状況を認識し、リクエストを満たせないパーティションを持つノードを除外します。Pod スケジューリング失敗イベントには、 |
その他のスケジューラの種類 | スケジューラの種類、条件、または設定が、前述の要件を満たしていない。 | スケジューラはパーティショントポロジーを認識しません。GPU-HPN ノードは可能な限り密にデバイスを割り当てます。パーティションがリクエストを満たせない場合、Pod はパーティションがリクエストを満たせるようになるまでノード上で Pending 状態のままになり、Pod スケジューリング失敗イベントには |