このトピックでは、ACK マネージドクラスター Pro に KubeRay Operator アドオンをデプロイし、Simple Log Service (SLS) と Prometheus を統合してログ収集とメトリクスのモニタリングを行い、可観測性と高可用性を向上させ、Kubernetes カスタムリソース (CR) を使用して Ray クラスターとアプリケーションを管理する方法について説明します。
前提条件
次のことを確認してください。
-
Kubernetes v1.24 以降 を実行している ACK マネージドクラスター Pro で、8 vCPU および 32 GB のメモリ を持つノードが少なくとも 1 つあること。GPU ワークロードには、GPU 高速化インスタンスタイプを使用します。
-
kubectl がインストールされ、クラスターに接続されていること。
必要に応じて、クラスターを作成するか、既存のクラスターをアップグレードしてください。
KubeRay Operator のインストール
KubeRay Operator は招待制プレビューです。アクセスするには、チケットを送信してください。
-
ACK コンソールにログインします。左側のナビゲーションペインで、[クラスター] をクリックします。
-
対象クラスターの名前をクリックします。
-
クラスターの詳細ページで、[操作] > [アドオン] > [アプリケーションの管理] を選択します。
-
Kuberay-Operator を見つけてインストールします。
検証: インストール後、Operator Pod が実行中であることを確認してください。
kubectl get pods -A | grep kuberayOperator Pod のステータスが Running と表示されます。ステータスが Pending のままである場合は、kubectl describe pod <pod-name> を実行して、ノードリソースの不足などのスケジューリングエラーを確認してください。
KubeRay Operator のログ収集の有効化
KubeRay Operator 自体からコントロールプレーンのログを収集します。
-
クラスターの詳細ページで、[操作] > [ログセンター] > [コントロールプレーンコンポーネント] を選択します。
-
[コンポーネントログ収集を有効化] をクリックします。
-
[kuberay-operator] を選択します。
Ray クラスターのログ収集の有効化
AliyunLogConfig カスタムリソースを使用して、Ray Pod のログを SLS に転送します。Logtail は各 Pod の Ray ログディレクトリを監視し、クラスター名とノードタイプでエントリにタグを付けます。
SLS は有料サービスです。料金の詳細については、「課金の概要」をご参照ください。
-
このマニフェストを適用して、
kube-systemにAliyunLogConfigオブジェクトを作成します。主要なパラメーター:
パラメーター 説明 logPath各 Ray Pod のログディレクトリ。 /tmp/ray/配下のすべてのセッションに一致します。クラスターが異なるパスを使用している場合はカスタマイズしてください。advanced.k8s.ExternalK8sLabelTagSLS でのフィルタリングのために、各ログエントリに _raycluster_name_タグと_node_type_タグを追加します。すべての
AliyunLogConfigパラメーターについては、「DaemonSet モードで CRD を使用してコンテナログを収集する」をご参照ください。 -
ACK コンソールでログを表示します。
-
ACK コンソールにログインします。左側のナビゲーションペインで、[クラスター] をクリックします。
-
対象クラスターの名前をクリックします。
-
[クラスター情報] > [基本情報] > [クラスターリソース] を選択します。
-
[Log Service プロジェクト] リンクをクリックして、SLS プロジェクトを開きます。
-
-
rayclustersLogstore を選択します。_raycluster_name_でフィルタリングして、特定の Ray クラスターからのログを分離します。次の例は、2 つの Ray クラスターの GCS デバッグログを示しています。異なるクラスターのログは、
_raycluster_name_ラベルで区別できます。1 02-23 16:37:54 __tag__:__user_defined_id__: k8s-group-c96xxx c4a541c67bd __tag__:__cluster_id__: c96fe15xxx 4a541c67bd __tag__:__container_ip__: 192.xxx.0.63 __tag__:__container_name__: ray-head __tag__:__image_name__: docker.io/rayproject/ray:2.7.0 __tag__:__namespace__: raycluster __tag__:__node_ip__: 192.xxx.xxx.58 __tag__:__node_name__: cn-hangzhou.192.xxx.xxx.58 __tag__:__pod_name__: myfirst-ray-cluster-head-wpnld __tag__:__pod_uid__: 6235fabd-xxx-xxx-15b699 __tag__:_raycluster_name_: myfirst-ray-cluster content: NodeInfoGcsService.grpc_server.RegisterNode - 1 total (0 active), CPU time: mean = 94.638 us, total = 94.638 us 2 02-23 16:37:52 __tag__:__user_defined_id__: k8s-group-c96xxx c4a541c67bd __tag__:__cluster_id__: c96fe15bca1fxxx c4a541c67bd __tag__:__container_ip__: 192.xxx.0.74 __tag__:__container_name__: ray-head __tag__:__image_name__: docker.io/rayproject/ray:2.7.0 __tag__:__namespace__: default __tag__:__node_ip__: 192.xxx.xxx.58 __tag__:__node_name__: cn-hangzhou.192.xxx.xxx.58 __tag__:__pod_name__: mysecond-ray-cluster-head-hfg77 __tag__:__pod_uid__: xxx-xxx-xxx-df672 __tag__:_raycluster_name_: mysecond-ray-cluster content: GcsHealthCheckManager::AddNode - 1 total (0 active), CPU time: mean = 8.978 us, total = 8.978 us
Ray クラスターのモニタリングの有効化
ワーカー用の PodMonitor とヘッドノード用の ServiceMonitor を使用して、Ray Pod から Prometheus メトリクスを収集します。ワーカーはスタンドアロンの Pod であるため PodMonitor が必要です。ヘッドノードは安定した Service エンドポイント経由でメトリクスを公開します。
Managed Service for Prometheus は有料サービスです。料金の詳細については、「Managed Service for Prometheus インスタンスの課金」をご参照ください。セットアップについては、「Managed Service for Prometheus への接続と設定」をご参照ください。
-
PodMonitorを作成して、Ray ワーカー Pod からメトリクスを収集します。apiVersion: monitoring.coreos.com/v1 kind: PodMonitor metadata: annotations: arms.prometheus.io/discovery: 'true' arms.prometheus.io/resource: arms name: ray-workers-monitor namespace: arms-prom labels: # `release: $HELM_RELEASE`: Prometheus はこのラベルを持つ PodMonitor のみを検出できます。 release: prometheus #ray.io/cluster: raycluster-kuberay # $RAY_CLUSTER_NAME: "kubectl get rayclusters.ray.io" spec: namespaceSelector: any: true jobLabel: ray-workers # "matchLabels" を持つ Kubernetes Pod のみを選択します。 selector: matchLabels: ray.io/node-type: worker # この PodMonitor で許可されているエンドポイントのリスト。 podMetricsEndpoints: - port: metrics relabelings: - action: replace regex: (.+) replacement: $1 separator: ; sourceLabels: - __meta_kubernetes_pod_label_ray_io_cluster targetLabel: ray_io_cluster -
ServiceMonitorを作成して、Ray ヘッドノードからメトリクスを収集します。apiVersion: monitoring.coreos.com/v1 kind: ServiceMonitor metadata: annotations: arms.prometheus.io/discovery: 'true' arms.prometheus.io/resource: arms name: ray-head-monitor namespace: arms-prom labels: # `release: $HELM_RELEASE`: Prometheus はこのラベルを持つ ServiceMonitor のみを検出できます。 release: prometheus spec: namespaceSelector: any: true jobLabel: ray-head # "matchLabels" を持つ Kubernetes Service のみを選択します。 selector: matchLabels: ray.io/node-type: head # この ServiceMonitor で許可されているエンドポイントのリスト。 endpoints: - port: metrics path: /metrics targetLabels: - ray.io/cluster -
Application Real-Time Monitoring Service (ARMS) でダッシュボードを表示します。
-
ARMS コンソールにログインします。左側のナビゲーションペインで、[インテグレーションセンター] をクリックします。
-
Ray を検索して選択します。
-
[Ray] パネルで、クラスターを選択し、[OK] をクリックします。
-
左側のナビゲーションペインで [インテグレーション管理] をクリックし、対象の環境名をクリックします。
-
[コンポーネント管理] タブで、[アドオンタイプ] の下にある [ダッシュボード] を見つけ、[Ray Cluster] をクリックします。
-
[Namespace]、[RayClusterName]、および [SessionName] を設定して、特定のタスクのモニタリングデータをフィルタリングします。
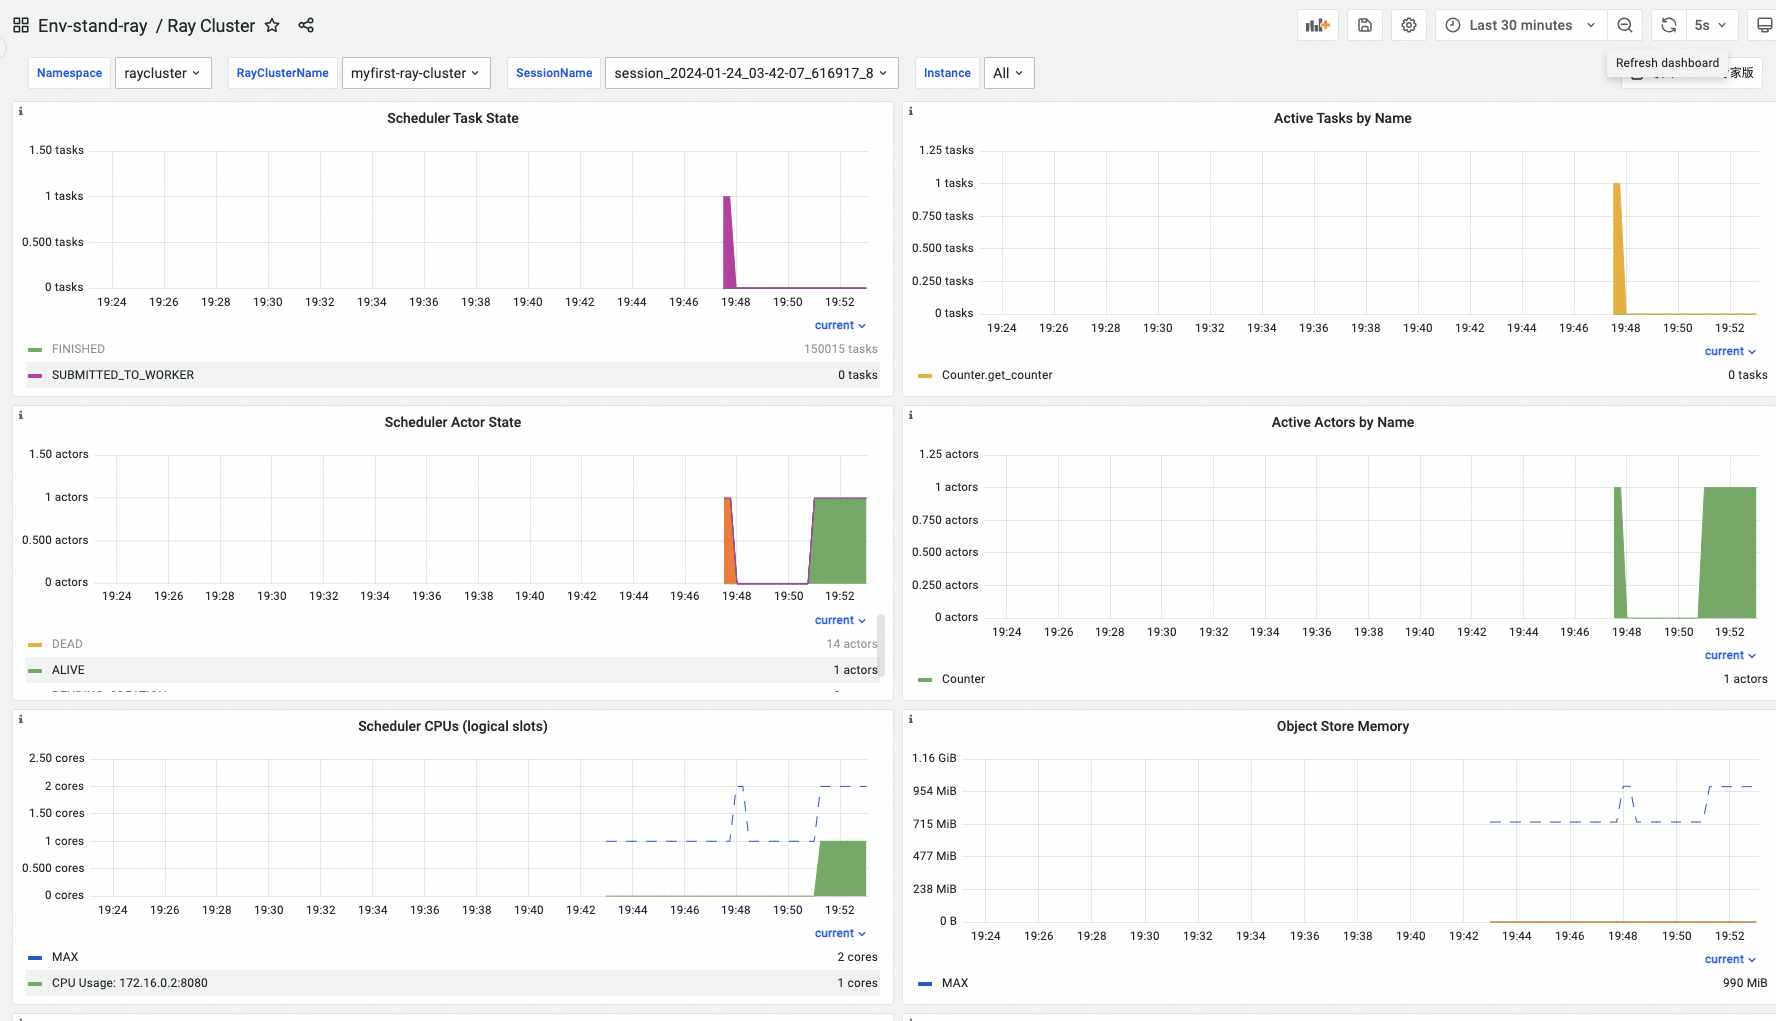
-
検証: ARMS コンソールで、ray-workers-monitor と ray-head-monitor の両方がアクティブなスクレイプターゲットとして表示されます。ターゲットが見つからない場合は、release: prometheus ラベルと、名前空間セレクターが Ray クラスターの名前空間と一致していることを確認してください。
次のステップ
-
RayCluster カスタムリソースをデプロイして、分散 Ray ワークロードを実行してください。
-
SLS で
_raycluster_name_タグを使用して、複数の Ray クラスター間のログを関連付けてください。 -
Prometheus からの Ray クラスターメトリクスに基づいて、ARMS のアラートルールを設定してください。