ack-koordinator Descheduler は、実際のリソース使用率に基づいて過負荷のノードを検出し、Pod を退避させてクラスターのバランスを再調整します。
このトピックでは、Descheduler のインストール、ホットスポット感知デスケジューリングの有効化、およびその高度なパラメーターの設定方法について説明します。
制限事項
ACK Pro 版マネージドクラスターのみをサポートします。
必要なコンポーネントのバージョン:
コンポーネント
バージョン
ACK Scheduler
v1.22.15-ack-4.0 以降、v1.24.6-ack-4.0 以降
ack-koordinator
v1.1.1-ack.1 以降
Helm
v3.0 以降
ack-koordinator Descheduler は Pod の退避のみを行い、ACK Scheduler が再スケジューリングを処理します。退避された Pod がホットスポットノードに再び配置されるのを防ぐために、デスケジューリングを負荷感知スケジューリングと併用してください。
デスケジューリング中、新しい Pod が作成される前に古い Pod が退避されます。可用性を維持するために、アプリケーションに十分な冗長レプリカがあることを確認してください。
デスケジューリングは、標準の Kubernetes Eviction API を使用します。退避後の再起動がサービスを中断しないように、Pod が再入可能であることを確認してください。
課金
ack-koordinator のインストールと使用は無料です。以下のシナリオでは追加料金が発生する場合があります:
ワーカーノードのリソース:ack-koordinator は自己管理コンポーネントであり、ワーカーノードのリソースを消費します。インストール時に各モジュールのリソースリクエストを設定してください。
Prometheus のカスタムメトリクス:[Enable Prometheus Monitoring for ACK-Koordinator] を有効にし、Managed Service for Prometheus を使用する場合、公開されるメトリクスはカスタムメトリクスとしてカウントされ、料金が発生します。料金はクラスターのサイズとアプリケーションの数によって異なります。この機能を有効にする前に、Prometheus インスタンスの課金を確認してください。使用量データのクエリを実行して、リソース消費を監視してください。
仕組み
実行サイクル
ack-koordinator Descheduler は定期的に実行されます。各実行サイクルには 3 つのステージがあります:
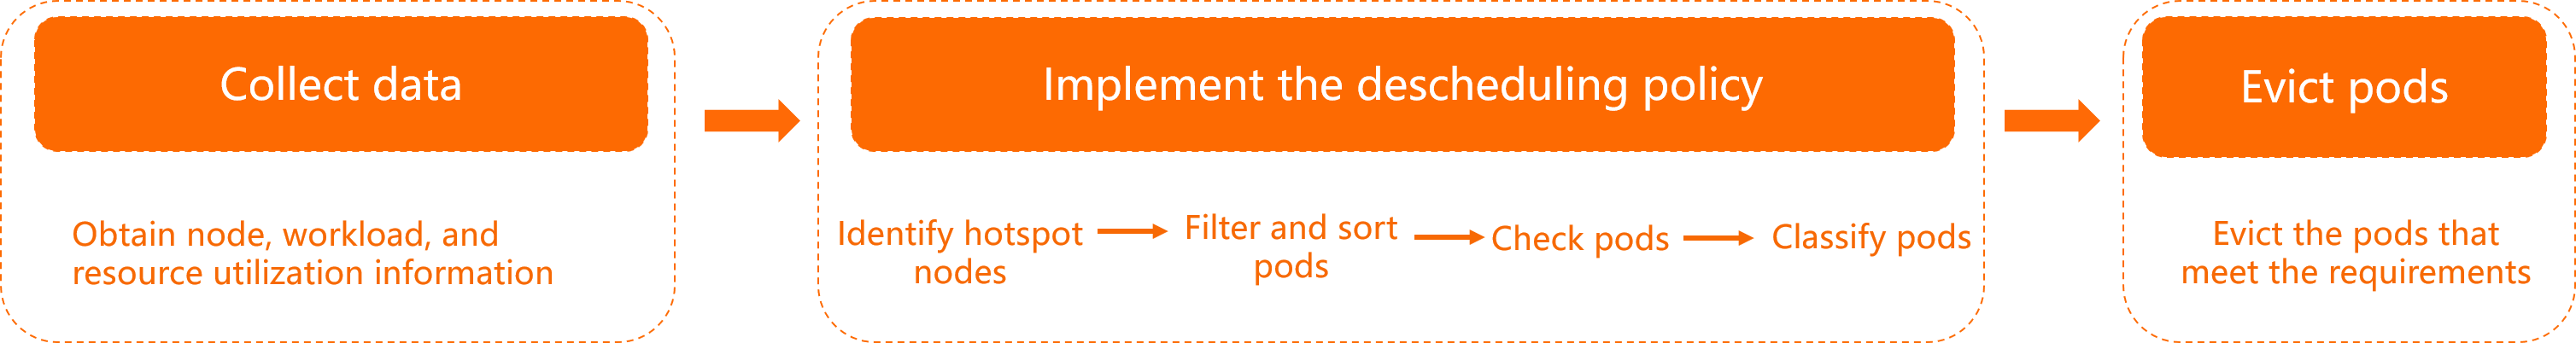
データ収集:ノードとワークロードの情報、およびリソース使用率データを取得します。
プラグインの実行 (LowNodeLoad の例):
highThresholdsとlowThresholdsに基づいてホットスポットノードを特定します。すべてのホットスポットノードを走査し、対象の Pod をスコアリングして、強制退去のためにソートします。詳細については、「Pod のスコアリングポリシー」をご参照ください。
各候補 Pod が移行制約 (クラスター容量、リソース使用率、レプリカ比率の制限) に適合するかどうかを確認します。詳細については、「負荷感知ホットスポットデスケジューリングポリシー」をご参照ください。
合格した Pod を移行候補としてマークし、残りはスキップします。
Pod の退避と移行:Eviction API を介して移行候補を退避させます。
ノードの分類
LowNodeLoad プラグインは、lowThresholds (アイドルしきい値) と highThresholds (ホットスポットしきい値) の 2 つのしきい値に基づいて、ノードを 3 つのカテゴリに分類します。
lowThresholds = 45%、highThresholds = 70% の例:

アイドルノード:リソース使用率が
lowThresholds未満 (< 45%) です。通常ノード:リソース使用率が
lowThresholdsとhighThresholdsの間 (45%–70%) です。これが目標範囲です。ホットスポットノード:リソース使用率が
highThresholdsを超えています (> 70%)。ノードの負荷が 70% 以下に低下するまで Pod が退避されます。
リソース使用率データは 1 分ごとに更新され、5 分間の平均を反映します。
すべてのノードがlowThresholdsを超えている場合、一部のノードがhighThresholdsを超えていても、クラスターの負荷は高いと見なし、デスケジューリングを中断します。
負荷感知ホットスポットデスケジューリングポリシー
ポリシー | 説明 |
ホットスポットチェックのリトライ | 一時的なスパイクによる誤検出を防ぐため、ノードは連続したサイクル (デフォルト: 5) で |
ノードのソート | デスケジューリングは、最も使用率の高いホットスポットノードから開始します。CPU とメモリをこの順序で比較します。 |
Pod のスコアリング | 各ホットスポットノードについて、Pod は退避前にスコアリングおよびソートされます。(1) PriorityClass が低いものが先 (デフォルトは 0 で最も低い)、(2) QoS クラスが低いもの、(3) 優先度と QoS が同じ場合、Pod はリソース使用率と起動時間によってランク付けされます。退避順序を制御するには、PriorityClass または QoS クラスを設定してください。 |
フィルター | ラベルセレクターを使用して、デスケジューリングの対象を特定の名前空間、Pod、またはノードに限定します。LowNodeLoad プラグインの設定にある |
事前チェック | 退避前に、Descheduler は次のことを確認します。(1) Node Affinity、Node Selector、Toleration、およびリソース要件に一致するノードが存在すること、(2) ターゲットノードが |
移行の速度制限 | ノード、名前空間、ワークロードごとの同時 Pod 移行を制限します。タイムウィンドウにより、同じワークロード内の Pod が頻繁に移行されるのを防ぎます。きめ細かい可用性制御のために、Kubernetes の Pod Disruption Budget (PDB) と互換性があります。 |
可観測性 | 各 Pod に対して移行イベントが発行され、理由とステータスが表示されます。 |
前提条件
開始する前に、以下の要件を満たしていることを確認してください:
ACK Scheduler v1.22.15-ack-4.0 以降、ack-koordinator v1.1.1-ack.1 以降、および Helm v3.0 以降
ステップ 1:ack-koordinator でデスケジューリングを有効化
新規インストール:ack-koordinator をインストールし、設定ページで [Enable ACK-Koordinator Descheduling Module] を選択します。
既存のインストール:設定ページで [Enable ACK-Koordinator Descheduling Module] を選択します。詳細については、「ack-koordinator の変更」をご参照ください。
ステップ 2:LowNodeLoad プラグインの有効化
LowNodeLoad プラグインを有効にするために、
koord-descheduler-config.yamlConfigMap を作成します。# koord-descheduler-config.yaml apiVersion: v1 kind: ConfigMap metadata: name: koord-descheduler-config namespace: kube-system data: koord-descheduler-config: | # koord-descheduler のシステム設定。このセクションは変更しないでください。 apiVersion: descheduler/v1alpha2 kind: DeschedulerConfiguration leaderElection: resourceLock: leases resourceName: koord-descheduler resourceNamespace: kube-system deschedulingInterval: 120s # 実行間隔。Descheduler は 120 秒ごとに実行されます。 # detectorCacheTimeout (デフォルト:5m) を超えてはなりません。 dryRun: false # true に設定すると、読み取り専用モードで実行されます (退避は行われません)。 # システム設定の終わり。 profiles: - name: koord-descheduler plugins: balance: enabled: - name: LowNodeLoad # ホットスポットデスケジューリングのために LowNodeLoad プラグインを有効化します。 evict: enabled: - name: MigrationController # 退避および移行コントローラーを有効化します。 pluginConfig: - name: MigrationController args: apiVersion: descheduler/v1alpha2 kind: MigrationControllerArgs defaultJobMode: EvictDirectly - name: LowNodeLoad args: apiVersion: descheduler/v1alpha2 kind: LowNodeLoadArgs # すべてのリソースの使用率が lowThresholds を下回る場合、ノードはアイドル状態と見なされます。 lowThresholds: cpu: 20 # CPU 使用率 20% memory: 30 # メモリ使用率 30% # いずれかのリソースの使用率が highThresholds を超える場合、ノードはホットスポットと見なされます。 highThresholds: cpu: 50 # CPU 使用率 50% memory: 60 # メモリ使用率 60% # デスケジューリングの対象を特定の名前空間に限定します。 # include と exclude は相互に排他的です — どちらか一方のみを設定してください。 evictableNamespaces: include: - default # exclude: # - "kube-system" # - "koordinator-system"ConfigMap をクラスターに適用します。
kubectl apply -f koord-descheduler-config.yaml新しい設定を読み込むために、ack-koordinator Descheduler を再起動します。
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 0
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 1
ステップ 3 (オプション):負荷感知スケジューリングの有効化
最適な負荷分散のために、負荷感知スケジューリングを有効化し、ACK Scheduler が退避後に Pod をホットスポットノードに配置しないようにします。
loadAwareThreshold を highThresholds と一致するように設定してください。値が一致しない場合、特に類似の使用率を持つノードが少ない状況では、退避された Pod がホットスポットノードに再スケジュールされる可能性があります。
ステップ 4:デスケジューリングの確認
この例では、各ノードが 104 コアと 396 GiB のメモリを持つ 3 ノードクラスターを使用します。
以下の内容で
stress-demo.yamlファイルを作成します。apiVersion: apps/v1 kind: Deployment metadata: name: stress-demo namespace: default labels: app: stress-demo spec: replicas: 6 selector: matchLabels: app: stress-demo template: metadata: name: stress-demo labels: app: stress-demo spec: containers: - args: - '--vm' - '2' - '--vm-bytes' - '1600M' - '-c' - '2' - '--vm-hang' - '2' command: - stress image: polinux/stress imagePullPolicy: Always name: stress resources: limits: cpu: '2' memory: 4Gi requests: cpu: '2' memory: 4Gi restartPolicy: Always負荷テスト用のワークロードをデプロイします。
kubectl create -f stress-demo.yaml想定される出力:
deployment.apps/stress-demo createdPod が実行中であることを確認し、割り当てられたノードをメモします。
kubectl get pod -o wide想定される出力:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Running 0 82s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none>cn-beijing.10.XX.XX.53の負荷を増やし、ノードの使用率を確認します。kubectl top node想定される出力:
NAME                      CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
cn-beijing.10.XX.XX.215   17611m       17%    24358Mi         6%
cn-beijing.10.XX.XX.53    63472m       63%    11969Mi         3%
ノード
cn-beijing.10.XX.XX.53の CPU 使用率は 63% で、50% のホットスポットのしきい値を超えています。ノードcn-beijing.10.XX.XX.215の CPU 使用率は 17% で、20% のアイドルのしきい値を下回っています。「ステップ 2:LowNodeLoad プラグインの有効化」の説明に従い、LowNodeLoad プラグインを有効化します。
Pod の変更を監視します。
デフォルトでは、ノードがホットスポットとして分類されるには、
highThresholdsを 5 回連続で超える必要があります (デフォルトの 120 秒間隔で約 10 分)。kubectl get pod -w想定される出力:
NAME                           READY   STATUS             RESTARTS   AGE   IP             NODE                     NOMINATED NODE   READINESS GATES
stress-demo-588f9646cf-s****   1/1     Terminating        0          59s   10.XX.XX.53    cn-beijing.10.XX.XX.53   <none>           <none>
stress-demo-588f9646cf-7****   1/1     ContainerCreating  0          10s   10.XX.XX.215   cn-beijing.10.XX.XX.215  <none>           <none>
退避イベントを確認します。
kubectl get event | grep stress-demo-588f9646cf-s****想定される出力:
2m14s   Normal   Evicting        podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
101s    Normal   EvictComplete   podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" has been evicted
2m14s   Normal   Descheduled     pod/stress-demo-588f9646cf-s****   Pod evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
2m14s   Normal   Killing         pod/stress-demo-588f9646cf-s****   Stopping container stress
ホットスポットノード上の Pod は退避され、
cn-beijing.10.XX.XX.215に移行されました。
高度な設定
すべての ack-koordinator Descheduler パラメーターは、「ステップ 2」の ConfigMap で設定します。
# koord-descheduler-config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: koord-descheduler-config
  namespace: kube-system
data:
  koord-descheduler-config: |
    # システム設定。このセクションは変更しないでください。
    apiVersion: descheduler/v1alpha2
    kind: DeschedulerConfiguration
    leaderElection:
      resourceLock: leases
      resourceName: koord-descheduler
      resourceNamespace: kube-system
    deschedulingInterval: 120s  # 実行間隔。detectorCacheTimeout を超えてはなりません。
    dryRun: false               # true に設定すると、読み取り専用モードになります (退避は行われません)。
    # システム設定の終わり。

    profiles:
    - name: koord-descheduler
      plugins:
        deschedule:
          disabled:
            - name: "*"  # すべてのプラグインはデフォルトで無効です (参考のために表示)。
        balance:
          enabled:
            - name: LowNodeLoad
        evict:
          disabled:
            - name: "*"  # すべてのプラグインはデフォルトで無効です (参考のために表示)。
          enabled:
            - name: MigrationController

      pluginConfig:
      - name: MigrationController
        args:
          apiVersion: descheduler/v1alpha2
          kind: MigrationControllerArgs
          defaultJobMode: EvictDirectly
          maxMigratingPerNode: 1       # ノードごとに同時に移行するPodの最大数。0 = 無制限。
          maxMigratingPerNamespace: 1  # 名前空間ごとに同時に移行するPodの最大数。
          maxMigratingPerWorkload: 1   # ワークロード (例:Deployment) ごとに同時に移行するPodの最大数。
          maxUnavailablePerWorkload: 2 # 移行中にワークロードごとに利用不可にできるレプリカの最大数。
          evictLocalStoragePods: false # HostPath または emptyDir ボリュームを使用する Pod を退避させるかどうか。
          objectLimiters:
            workload:               # 5 分以内にワークロードごとに最大 1 つのレプリカが移行されます。
              duration: 5m
              maxMigrating: 1

      - name: LowNodeLoad
        args:
          apiVersion: descheduler/v1alpha2
          kind: LowNodeLoadArgs

          lowThresholds:
            cpu: 20
            memory: 30
          highThresholds:
            cpu: 50
            memory: 60

          anomalyCondition:
            consecutiveAbnormalities: 5  # ノードがホットスポットとして分類される前に
                                          # highThresholds を超える連続チェックの回数。
                                          # 退避後にカウンターはリセットされます。

          detectorCacheTimeout: "5m"  # ホットスポットチェックのキャッシュ期間。
                                      # deschedulingInterval 以上でなければなりません。

          evictableNamespaces:
            include:
              - default
            # exclude:
            #   - "kube-system"
            #   - "koordinator-system"

          nodeSelector:  # 指定したノードのみを処理します。
            matchLabels:
              alibabacloud.com/nodepool-id: np77f520e1108f47559e63809713ce****

          podSelectors:  # 指定した Pod のみを処理します。
          - name: lsPods
            selector:
              matchLabels:
                koordinator.sh/qosClass: "LS"
ack-koordinator Descheduler のシステム設定
パラメーター | タイプ | 値 | 説明 | 例 |
| boolean |
| 読み取り専用モードのスイッチ。有効にすると、Pod の移行は開始されません。 |
|
| time.Duration | > 0s | 実行間隔。LowNodeLoad プラグインの |
|
退避と移行の制御設定
パラメーター | タイプ | 値 | 説明 | 例 |
| int64 | ≥ 0 (デフォルト:2) | ノードごとに同時に移行する Pod の最大数。 |
|
| int64 | ≥ 0 (デフォルト:無制限) | 名前空間ごとに同時に移行する Pod の最大数。 |
|
| intOrString | ≥ 0 (デフォルト:10%) | ワークロード (例:Deployment) ごとに同時に移行する Pod の最大数または割合。 |
|
| intOrString | ≥ 0 (デフォルト:10%)、総レプリカ数未満 | ワークロードごとに利用不可にできるレプリカの最大数または割合。 |
|
| boolean |
| HostPath または emptyDir ボリュームを持つ Pod を退避させるかどうか。データ保護のため、デフォルトで無効になっています。 |
|
| struct | Duration > 0s (デフォルト: | ワークロードレベルの移行の速度制限。 |
|
LowNodeLoad プラグインの設定
パラメーター | タイプ | 値 | 説明 | 例 |
| map[string]float64 | [0, 100] (CPU とメモリ、パーセンテージ) | ホットスポットしきい値。これを超えるノード上の Pod は退避対象となります。すべてのノードが |
|
| map[string]float64 | [0, 100] (CPU とメモリ、パーセンテージ) | アイドルしきい値。すべてのノードがこれを超える場合、クラスター全体の負荷が高いと見なし、デスケジューリングを中断します。 |
|
| int64 | > 0 (デフォルト:5) | ノードがホットスポットとして分類されるには、 |
|
| *metav1.Duration | Duration 形式をご参照ください (デフォルト: | ホットスポットチェックのキャッシュ期間。 |
|
| include: string / exclude: string | クラスター内の名前空間 | デスケジューリングの対象を特定の名前空間に限定します。すべての Pod を処理する場合は空白のままにします。 |
|
| metav1.LabelSelector | ラベルとセレクターをご参照ください | ラベルセレクターを使用して、デスケジューリングの対象を特定のノードに限定できます。単一のノードプール ( |
|
| list of PodSelector | ラベルとセレクターをご参照ください | ラベルセレクターを使用して、デスケジューリングの対象を特定の Pod に限定できます。複数のセレクターグループがサポートされています。 |
|
よくある質問
ノードの使用率がしきい値を超えているのに Pod が退避されない
最も一般的な原因は、Descheduler の設定がアクティブになっていないことです。以下の順序で確認してください:
スコープが設定されていない:Descheduler は、明示的に含まれている (または除外されていない) 名前空間とノードのみを処理します。
evictableNamespacesとnodeSelectorを確認してください。設定変更後に Descheduler が再起動されていない:設定の変更には再起動が必要です。手順については、「ステップ 2」をご参照ください。
間隔がキャッシュタイムアウトより長い:
deschedulingInterval(デフォルト:2 分) はdetectorCacheTimeout(デフォルト:5 分) を超えてはなりません。超えている場合、ホットスポットの検出は失敗します。調整して再起動してください。ノードが一貫してしきい値を超えていない:Descheduler は平滑化された平均を使用します。ノードがホットスポットとして分類されるのは、
highThresholdsをconsecutiveAbnormalitiesの連続サイクル (デフォルト:5、約 10 分) にわたって超えた場合のみです。kubectl top nodeは直近 1 分間のみを反映するため、持続的な使用率を確認するにはより長い期間監視してください。クラスターの容量が不足している:Pod を退避させる前に、Descheduler は他のノードに十分な空き容量があることを確認します。どのノードにも空き容量がない場合、退避をスキップします。ノードを追加して容量を増やしてください。
単一レプリカのワークロード:単一レプリカの Pod はデフォルトでは退避しません。これを上書きするには、Pod またはワークロードの
spec.template.metadataにアノテーションdescheduler.alpha.kubernetes.io/evict: "true"を追加します。ack-koordinator v1.3.0-ack1.6 から v1.3.0-ack1.8 ではサポートされていません。この機能を使用するには、最新バージョンにアップグレードしてください。Pod が HostPath または emptyDir を使用している:デフォルトでデスケジューリングから除外します。退避を有効にするには、MigrationController で
evictLocalStoragePods: trueを設定してください。詳細については、「退避と移行の制御設定」をご参照ください。利用不可または移行中のレプリカが多すぎる:利用不可または移行中のレプリカが
maxUnavailablePerWorkloadまたはmaxMigratingPerWorkloadに達した場合、それ以上の退避をブロックします。進行中の退避が完了するのを待つか、これらの制限値を増やしてください。レプリカ数が移行制限以下:総レプリカ数が
maxMigratingPerWorkloadまたはmaxUnavailablePerWorkload以下の場合、そのワークロードをスキップします。これらの値を減らすか、パーセンテージを使用してください。
Descheduler が頻繁に再起動する
無効または欠落している ConfigMap は再起動ループを引き起こします。「高度な設定」を参考に ConfigMap の形式を確認し、「ステップ 2」の説明に従って再起動してください。
負荷感知スケジューリングとホットスポットデスケジューリングはどのように連携しますか
最適な負荷分散のために、両方の機能を有効にしてください。デスケジューリングは過負荷のノードから Pod を退避させ、負荷感知スケジューリングは再スケジュールされる Pod をより使用率の低いノードに配置します。
loadAwareThreshold を highThresholds と一致するように設定してください。詳細については、「負荷感知スケジューリングの使用」および「スケジューリングポリシー」をご参照ください。
Descheduler はどの使用率データを使用しますか
Descheduler は複数のサイクルにわたる平滑化された平均を計算します。退避がトリガーされるのは、平均使用率が設定された連続サイクル (デフォルト:約 10 分) にわたって highThresholds を超え続けた場合のみです。
Descheduler はメモリ計算からページキャッシュ (OS によって再利用可能) を除外します。kubectl top node はページキャッシュを含むため、実際のメトリクスを確認するには Managed Service for Prometheus を使用してください。