このトピックでは、Alibaba Cloud が提供する GPU 共有ソリューションを紹介し、GPU Sharing Professional Edition の利点を説明します。また、GPU Sharing Basic Edition と GPU Sharing Professional Edition の機能と利用シナリオを比較することで、GPU 共有をより深く理解し、活用しやすくなります。
背景情報
GPU 共有により、同一の GPU デバイス上で複数のコンテナを実行できます。Alibaba Cloud Container Service for Kubernetes (ACK) が GPU 共有をオープンソース化したことで、Alibaba Cloud 上およびオンプレミスデータセンター内のコンテナクラスターに GPU 共有フレームワークを実装できるようになりました。これにより、複数のコンテナで同一の GPU デバイスを共有し、利用コストを削減できます。
しかし、コスト効率を実現する一方で、GPU 上でコンテナを安定して動作させることも重要です。各コンテナに割り当てられた GPU リソースを隔離することで、同一 GPU 上の各コンテナのリソース使用量を制限し、リソースの過剰使用による相互干渉を防ぐことができます。この課題を解決するため、コンピューティング業界では NVIDIA vGPU、Multi-Process Service (MPS)、vCUDA などの多くのソリューションが提供されており、より細かい GPU 利用管理を実現しています。
これらの要件を満たすため、ACK は GPU 共有ソリューションを導入しました。このソリューションは、単一の GPU を複数のタスクで共有できるだけでなく、同一 GPU 上の異なるアプリケーションに対してメモリ隔離と GPU 計算能力のパーティショニングを実現します。
機能と利点
GPU 共有ソリューションは、Alibaba Cloud が開発したサーバーカーネルドライバーを使用し、NVIDIA GPU の基盤ドライバーをより効率的に活用します。GPU 共有は、以下の機能を提供します。
高い互換性: GPU 共有は、Kubernetes や NVIDIA Docker などの標準的なオープンソースソリューションと互換性があります。
使いやすさ: GPU 共有は優れたユーザーエクスペリエンスを提供します。AI アプリケーションの Compute Unified Device Architecture (CUDA) ライブラリを置き換える際、アプリケーションの再コンパイルや新しいコンテナイメージの作成は不要です。
安定性: GPU 共有は、NVIDIA GPU 上で安定した基盤操作を提供します。CUDA ライブラリの API 操作や、CUDA Deep Neural Network (cuDNN) の一部のプライベート API 操作は直接呼び出すことが困難ですが、これによりシステム全体の安定性が確保されています。
リソース隔離: GPU 共有は、割り当てられた GPU メモリと計算能力が相互に影響しないことを保証します。
GPU 共有は、GPU スケジューリングとメモリ隔離を実現する、費用対効果が高く、信頼性が高く、使いやすいソリューションを提供します。
利点 | 説明 |
GPU 共有、スケジューリング、メモリ隔離をサポート |
|
柔軟な GPU 共有およびメモリ隔離ポリシーをサポート |
|
GPU リソースの包括的な監視をサポート | 占有 GPU と共有 GPU の両方の監視をサポートします。 |
無料 | GPU 共有を利用する前に、クラウドネイティブ AI スイートをアクティブ化する必要があります。2024年6月6日 00:00:00 (UTC+8) 以降、クラウドネイティブ AI スイートは完全に無料で利用できます。 |
注意事項
GPU 共有は、ACK Pro クラスターでのみサポートされています。GPU 共有のインストールと利用方法の詳細については、以下のトピックをご参照ください。
GPU 共有が提供する以下の高度な機能も使用できます。
用語
共有モードと占有モード
共有モードでは、複数の Pod が 1 つの GPU を共有できます。次の図をご参照ください。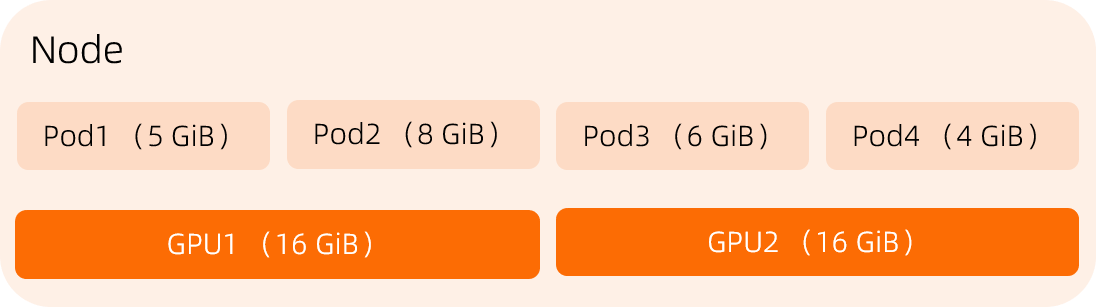
占有モードでは、1 つの Pod が 1 つ以上の GPU を占有します。次の図をご参照ください。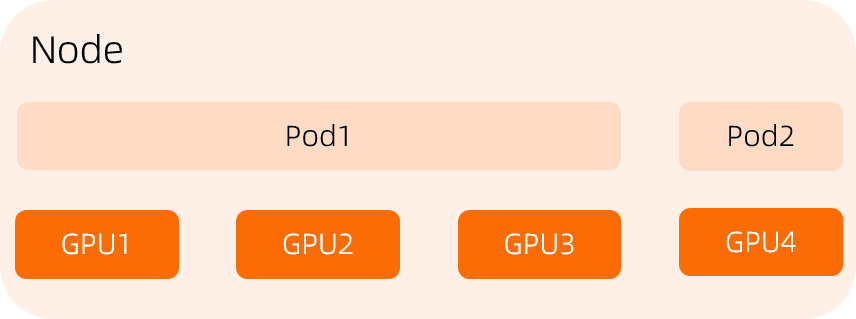
GPU メモリ隔離
GPU 共有は、1 つの GPU 上で複数の Pod を実行できることを保証しますが、GPU メモリ隔離が無効になっている場合、Pod 間のリソースの競合を防ぐことはできません。以下に例を示します。
Pod 1 は 5 GiB の GPU メモリを要求し、Pod 2 は 10 GiB の GPU メモリを要求します。GPU メモリ隔離が無効になっている場合、Pod 1 は自身が要求した 5 GiB を超えてメモリを使用してしまう可能性があり、Pod 2 が使用するはずのメモリを侵害します。その結果、Pod 2 は必要な 10 GiB のメモリを確保できず、GPU メモリ不足により起動に失敗します。GPU メモリ隔離を有効にすると、Pod 1 が要求した値を超える GPU メモリを使用しようとした場合、GPU メモリ隔離モジュールが Pod 1 を強制的に失敗させます。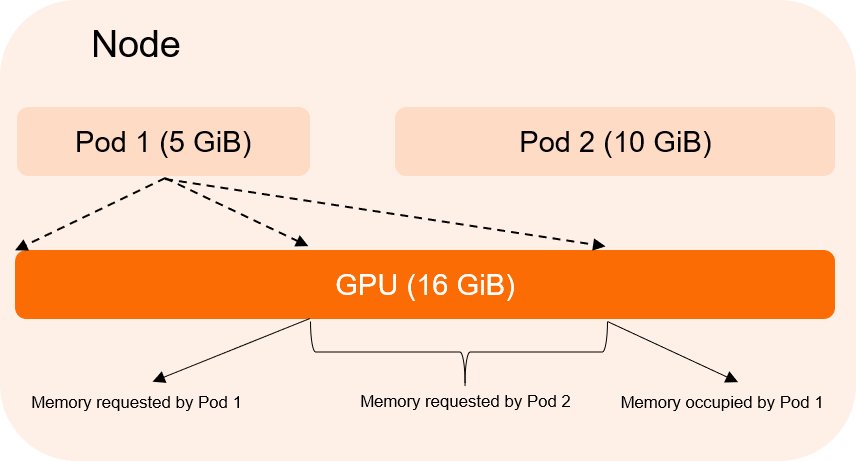
GPU スケジューリングポリシー:binpack と spread
GPU 共有機能が有効になっているノードに複数の GPU がある場合、以下の GPU 選択ポリシーのいずれかを選択できます。
binpack: デフォルトでは、binpack ポリシーが使用されます。スケジューラは、別の GPU に切り替える前に、1 つの GPU のすべてのリソースを Pod に割り当てます。これにより、GPU フラグメントの発生を防ぎます。spread: スケジューラは、GPU に障害が発生した際のビジネスの中断を防ぐため、ノード上の異なる GPU に Pod を分散させようとします。
この例では、ノードに 2 つの GPU があります。各 GPU は 15 GiB のメモリを提供します。Pod 1 は 2 GiB のメモリを要求し、Pod 2 は 3 GiB のメモリを要求します。

シングル GPU 共有とマルチ GPU 共有
シングル GPU 共有: 1 つの Pod は、1 つの GPU からのみ割り当てられる GPU リソースを要求できます。
マルチ GPU 共有: 1 つの Pod は、複数の GPU から均等に割り当てられる GPU リソースを要求できます。
