OSS PersistentVolume は複数のクライアントをサポートしますが、完全な書き込みサポートを有効にすると読み取りパフォーマンスが低下します。読み書き分離は、読み取りと書き込みを別々のマウントパスにルーティングすることでこの問題に対処し、モデルトレーニング、推論、データ分析などの読み取り負荷の高いワークロードのスループットを向上させます。
ossfs または OSS SDK を使用して OSS PersistentVolume の読み書き分離を実装します。本稿では、MNIST 手書き認識トレーニング Job を例に実装方法を説明します。
前提条件
以下の条件を満たしていることを確認してください。
最新のコンテナストレージインターフェイス (CSI) コンポーネントがインストールされています。クライアントによって必要な CSI バージョンは異なります。詳細については、「csi-plugin および csi-provisioner コンポーネントを管理する」をご参照ください。
クラスターと同じ Alibaba Cloud アカウントにOSS バケットがあること。
クロスアカウントでの OSS アクセスは推奨されません。
クライアントの選択
OSS PersistentVolume は 3 つのクライアント (ossfs 1.0、ossfs 2.0、strmvol) をサポートしています。各クライアントは読み取り専用アクセスをサポートしますが、書き込み機能は異なります。
クライアント | 読み取り専用 | 読み取り/書き込み | 最適な用途 |
ossfs 1.0 | 対応 | 完全な書き込み | 一般的な読み取り/書き込みワークロード。ダイレクト読み取りモードが利用可能 (v1.91 以降) |
ossfs 2.0 | 対応 | シーケンシャルな追記書き込みのみ | 読み取り負荷の高いワークロード。CSI 1.33.1 以降が必要 |
strmvol | 対応 | — | 多数の小さなファイル (データセット、時系列ログ、定量的バックテスト) |
詳細については、「クライアント選択リファレンス」をご参照ください。
ユースケース
読み取り専用アクセス
PersistentVolume のアクセスモードを ReadOnlyMany に設定することで、誤ったデータ変更を防ぎます。推論、データ分析、ログクエリに適しています。
読み取り中心のワークロードには、ossfs 2.0 (CSI >= 1.33.1) を使用します。詳細については、「ossfs 2.0 PV を使用する」をご参照ください。
多数の小さいファイルには strmvol を使用します。詳細については、「strmvol PV を使用する」をご参照ください。
読み取り専用シナリオ向けに ossfs 1.0 を調整するには、以下の otherOpts パラメーターを構成します。ほとんどのワークロードではデフォルト値を使用できます。
パラメーター | デフォルト値 | 説明 |
| 無効 | リアルタイムではない読み取りのためにカーネルバッファキャッシュを有効にします。空きメモリをキャッシュに使用します。 |
| 20 | 大きなファイルのアップロードおよびダウンロードの並列シャード数。 |
| 20 | 同時実行可能なメタデータリストリクエストの最大数。 |
| 1000 | キャッシュされるメタデータエントリの数です。無効にするには |
| 無効 | 読み取り専用シナリオ向けの直接読み取りモード (ossfs >= 1.91)。 詳細については、「新しい ossfs 1.0 バージョンの機能とパフォーマンス テスト」および「読み取り専用シナリオのパフォーマンスの最適化」をご参照ください。 |
読み取り/書き込みアクセス
データを書き込むワークロードの場合は、PersistentVolume のアクセスモードを ReadWriteMany に設定します。
ossfs は同時書き込みの一貫性を保証しません。複数のライターが同じオブジェクトに書き込むと、データの破損を引き起こす可能性があります。チェックポイントの書き込みには、パスごとに単一のライターを使用してください。
マウントされたパス内のファイルを削除または変更すると、OSS バケット内のオブジェクトも削除または変更されます。データ損失を防ぐために、バージョニングを有効にしてください。
読み取りパスと書き込みパスが分離されている読み取り負荷の高いワークロード (モデルトレーニングなど) の場合は、読み取りパスを ReadOnlyMany としてキャッシュを有効にしてマウントし、書き込みは ReadWriteMany PersistentVolume または OSS SDK 経由で処理します。
読み書き分離の仕組み
読み書き分離は、読み取りと書き込みを別々のマウントポイントにルーティングします。各マウントポイントは、同じ OSS バケットの異なるサブパスを参照します。これにより、読み取り I/O と書き込み I/O が分離されます。
読み取りパス — サブパス (例:
/tf-train/train/data) をReadOnlyManyとしてキャッシュを有効にしてマウントします。繰り返しの読み取りはメモリから読み込まれます。書き込みパス — 別のサブパス (例:
/tf-train/training_logs) をReadWriteManyとしてマウントするか、SDK を使用して直接書き込みます。
例:MNIST 手書き認識トレーニング
トレーニング Job は以下の処理を実行します。
読み取り専用 PersistentVolume を使用して、OSS バケットの
/tf-train/train/dataからトレーニングデータセットを読み取ります。読み取り/書き込み PersistentVolume または OSS SDK を使用して、トレーニングチェックポイントを
/tf-train/training_logsに書き込みます。
MNIST データセットをダウンロードし、OSS バケットの /tf-train/train/data にアップロードしてください。
OSS バケット内のファイル構成:

ossfs を使用した読み取り/書き込み操作の実装
チェックポイントの書き込みはシーケンシャルな追記処理であるため、書き込みパスには ossfs 1.0 と ossfs 2.0 のどちらも使用できます。
トレーニングアプリケーションをデプロイします。アプリケーションは、OSS バケットの
/tf-trainサブパスをポッドの/mntディレクトリにマウントします。ossfs 1.0 静的プロビジョニングボリュームの使用またはossfs 2.0 PV の使用をご参照ください。ossfs 1.0 PersistentVolume を作成します。
cat << EOF | kubectl apply -f -
apiVersion: v1
kind: Secret
metadata:
  name: oss-secret
  namespace: default
stringData:
  akId: "<your-accesskey-id>"
  akSecret: "<your-accesskey-secret>"
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: tf-train-pv
  labels:
    alicloud-pvname: tf-train-pv
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  csi:
    driver: ossplugin.csi.alibabacloud.com
    volumeHandle: tf-train-pv
    nodePublishSecretRef:
      name: oss-secret
      namespace: default
    volumeAttributes:
      bucket: "<your-bucket-name>"
      url: "oss-<region>.aliyuncs.com"
      otherOpts: "-o max_stat_cache_size=0 -o allow_other"
      path: "/tf-train"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: tf-train-pvc
spec:
  accessModes:
  - ReadWriteMany
  resources:
    requests:
      storage: 10Gi
  selector:
    matchLabels:
      alicloud-pvname: tf-train-pv
EOF
トレーニング Pod を作成します。
トレーニング中、ossfs は
/mnt/training_logs(Pod 内) から/tf-train/training_logs(OSS バケット) にファイルをアップロードします。cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
データの読み取りと書き込みを確認します。
Pod のステータスを確認します。
kubectl get pod tf-mnistステータスが
RunningからCompletedに変わるまで待ちます。NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m12sデータロード時間を確認します。
kubectl logs tf-mnist | grep dataload想定される出力:
dataload cost time: 1.54191803932OSS コンソールにログインし、バケットの
/tf-train/training_logs配下にファイルが存在することを確認します。
読み書き分離を使用した読み取りパフォーマンスの最適化
単一の読み取り/書き込み PersistentVolume を 2 つに分割します。1 つはデータセット用にキャッシュチューニングを施した読み取り専用 PersistentVolume、もう 1 つはチェックポイント用の書き込み PersistentVolume です。マウント構成のみが変更され、トレーニングコードは変更されません。
2 つの書き込みオプションがあります。
オプション 1:チェックポイント書き込み用に別の読み取り/書き込み ossfs PersistentVolume を使用します。
オプション 2:OSS SDK を使用してチェックポイントを直接書き込み、ossfs を完全にバイパスします。
オプション 1:読み取り/書き込み ossfs PersistentVolume を使用した書き込み
データセット用の読み取り専用 ossfs 1.0 PersistentVolume を作成します。主な構成変更は次のとおりです。
PersistentVolume と PersistentVolumeClaim の両方で
accessModesをReadOnlyManyに設定します。データセットサブパス/tf-train/train/dataをマウントします。otherOptsに-o kernel_cache -o max_stat_cache_size=10000 -o umask=022を追加します。kernel_cacheはメモリ内読み取りキャッシュを有効にします。max_stat_cache_size=10000は 10,000 個のメタデータエントリ (約 40 MB) をキャッシュします。インスタンスタイプとデータセットサイズに応じて調整してください。umask=022は非 root コンテナプロセスに読み取りアクセスを許可します。
cat << EOF | kubectl apply -f -
apiVersion: v1
kind: Secret
metadata:
  name: oss-secret
  namespace: default
stringData:
  akId: "<your-accesskey-id>"
  akSecret: "<your-accesskey-secret>"
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: tf-train-pv
  labels:
    alicloud-pvname: tf-train-pv
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadOnlyMany
  persistentVolumeReclaimPolicy: Retain
  csi:
    driver: ossplugin.csi.alibabacloud.com
    volumeHandle: tf-train-pv
    nodePublishSecretRef:
      name: oss-secret
      namespace: default
    volumeAttributes:
      bucket: "<your-bucket-name>"
      url: "oss-<region>.aliyuncs.com"
      otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other"
      path: "/tf-train/train/data"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: tf-train-pvc
spec:
  accessModes:
  - ReadOnlyMany
  resources:
    requests:
      storage: 10Gi
  selector:
    matchLabels:
      alicloud-pvname: tf-train-pv
EOF
チェックポイント用の読み取り/書き込み ossfs 1.0 PersistentVolume を作成し、サブパス
/tf-train/training_logsをマウントします。シーケンシャルなチェックポイント書き込みはキャッシュの恩恵を受けないため、メタデータキャッシュは無効 (max_stat_cache_size=0) にします。cat << EOF | kubectl apply -f - apiVersion: v1 kind: PersistentVolume metadata: name: tf-logging-pv labels: alicloud-pvname: tf-logging-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-logging-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train/training_logs" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-logging-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-logging-pv EOF両方の PersistentVolume をマウントしてトレーニング Pod をデプロイします。
コード変更は不要です。両方の PersistentVolume をマウントします。読み取り専用 PersistentVolume を
/mnt/train/dataに、読み取り/書き込み PersistentVolume を/mnt/training_logsにマウントします。cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" - name: logging mountPath: "/mnt/training_logs" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc - name: logging persistentVolumeClaim: claimName: tf-logging-pvc EOF
オプション 2:OSS SDK を使用した書き込み
SDK を使用してチェックポイントを OSS に直接書き込みます。この方法では読み取り/書き込み PersistentVolume は不要です。Pod は読み取り専用 PersistentVolume から読み取り、SDK 経由で書き込みます。
OSS Python SDK をコンテナイメージに追加します。
RUN pip install oss2詳細については、「インストール」をご参照ください。
SDK を使用してチェックポイントをアップロードするようにトレーニングコードを変更します。元のコードは、
log_dirに 100 イテレーションごとにチェックポイントを保存し、tf.train.Saverをmax_to_keep=0で使用して、1,000 イテレーション後に 10 個のチェックポイントセットを生成します。max_to_keep=1に設定して最新のチェックポイントのみを保持し、メモリ使用量を削減します。保存後、
put_object_from_fileで各チェックポイントを OSS にアップロードします。
読み取りパスと書き込みパスが分離されている場合、SDK で非同期 I/O を使用してスループットをさらに向上させることができます。
def train():
    ...
saver = tf.train.Saver(max_to_keep=0)

    for i in range(FLAGS.max_steps):
        if i % 10 == 0:  # 概要とテストセットの精度を記録
            summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
            print('Accuracy at step %s: %s' % (i, acc))
            if i % 100 == 0:
                print('Save checkpoint at step %s: %s' % (i, acc))
                saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
SDK ベースのアップロードに置き換えます。この変更によりメモリ使用量が削減され、読み取り/書き込み PersistentVolume が不要になります。AccessKey とバケット設定は環境変数から読み取ります。詳細については、「アクセス認証情報の構成」をご参照ください。
import oss2
from oss2.credentials import EnvironmentVariableCredentialsProvider

auth = oss2.ProviderAuth(EnvironmentVariableCredentialsProvider())
url = os.getenv('URL','<default-url>')
bucketname = os.getenv('BUCKET','<default-bucket-name>')
bucket = oss2.Bucket(auth, url, bucketname)

...
def train():
  ...
  saver = tf.train.Saver(max_to_keep=1)

 for i in range(FLAGS.max_steps):
    if i % 10 == 0:  # 概要とテストセットの精度を記録
      summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
      print('Accuracy at step %s: %s' % (i, acc))
      if i % 100 == 0:
        print('Save checkpoint at step %s: %s' % (i, acc))
        saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
        # FLAGS.log_dir = os.path.join(os.getenv('TEST_TMPDIR', '/mnt'),'training_logs')
        for path,_,file_list in os.walk(FLAGS.log_dir) :
          for file_name in file_list:
            bucket.put_object_from_file(os.path.join('tf-train/training_logs', file_name), os.path.join(path, file_name))
変更されたコンテナイメージは
registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:roです。読み取り専用 PersistentVolume と SDK 認証情報を使用して Pod をデプロイします。Pod では
accessModesをReadOnlyManyに設定し、OSS_ACCESS_KEY_IDとOSS_ACCESS_KEY_SECRETを渡すことで、SDK が PersistentVolume と同じ認証情報で認証されるようにします。cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv --- apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" - name: OSS_ACCESS_KEY_ID # AccessKey のソースは PersistentVolume と同じです。 valueFrom: secretKeyRef: name: oss-secret key: akId - name: OSS_ACCESS_KEY_SECRET # AccessKey のソースは PersistentVolume と同じです。 valueFrom: secretKeyRef: name: oss-secret key: akSecret - name: URL # デフォルトの URL が設定されている場合は省略可能です。 value: "https://oss-<region>.aliyuncs.com" - name: BUCKET # デフォルトの BUCKET が設定されている場合は省略可能です。 value: "<bucket-name>" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
読み書き分離の検証
いずれかの書き込みオプションでデプロイした後:
Pod のステータスを確認します。
kubectl get pod tf-mnistステータスが
Completedに変わるまで待ちます。NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m25sデータロード時間を確認します。
kubectl logs tf-mnist | grep dataload読み書き分離とカーネルキャッシュを有効にすると、データロード時間が短縮されます。
dataload cost time: 0.843528985977分離を行わない場合のベースラインは約 1.54 秒です。より大規模なトレーニング Job や繰り返しデータロードを行うワークロードでは、さらに大きな改善が見込めます。
OSS コンソールにログインし、バケットの
/tf-train/training_logs配下にチェックポイントファイルが存在することを確認します。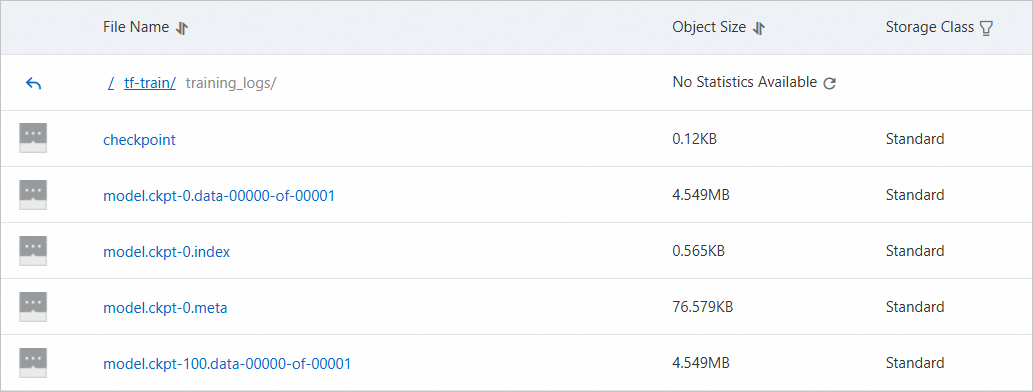
参考情報
OSS SDK リファレンス
本トピックでは Python SDK を使用しています。その他に利用可能な SDK は次のとおりです。
その他の SDK (PHP、Node.js、Browser.js、.NET、Android、iOS、Ruby) については、「SDK リファレンス」をご参照ください。
その他の書き込みツール
以下のツールも OSS への書き込みをサポートしています。
ツール | 参考情報 |
OpenAPI | |
ossutil コマンドラインインターフェイス | |
ossbrowser グラフィカル管理ツール |