Topik ini menjelaskan parameter dan antarmuka SDK Python untuk pengenalan ucapan non-real-time Qwen-Audio-ASR-Filetrans.
Untuk persyaratan input seperti format audio yang didukung, batas ukuran file, dan batas durasi, lihat Spesifikasi audio.
Prasyarat
-
Anda telah mengaktifkan layanan dan mendapatkan Kunci API. Harap konfigurasikan Kunci API sebagai Variabel lingkungan alih-alih melakukan hardcoding di kode Anda untuk mencegah risiko keamanan akibat kebocoran kode.
Mulai cepat
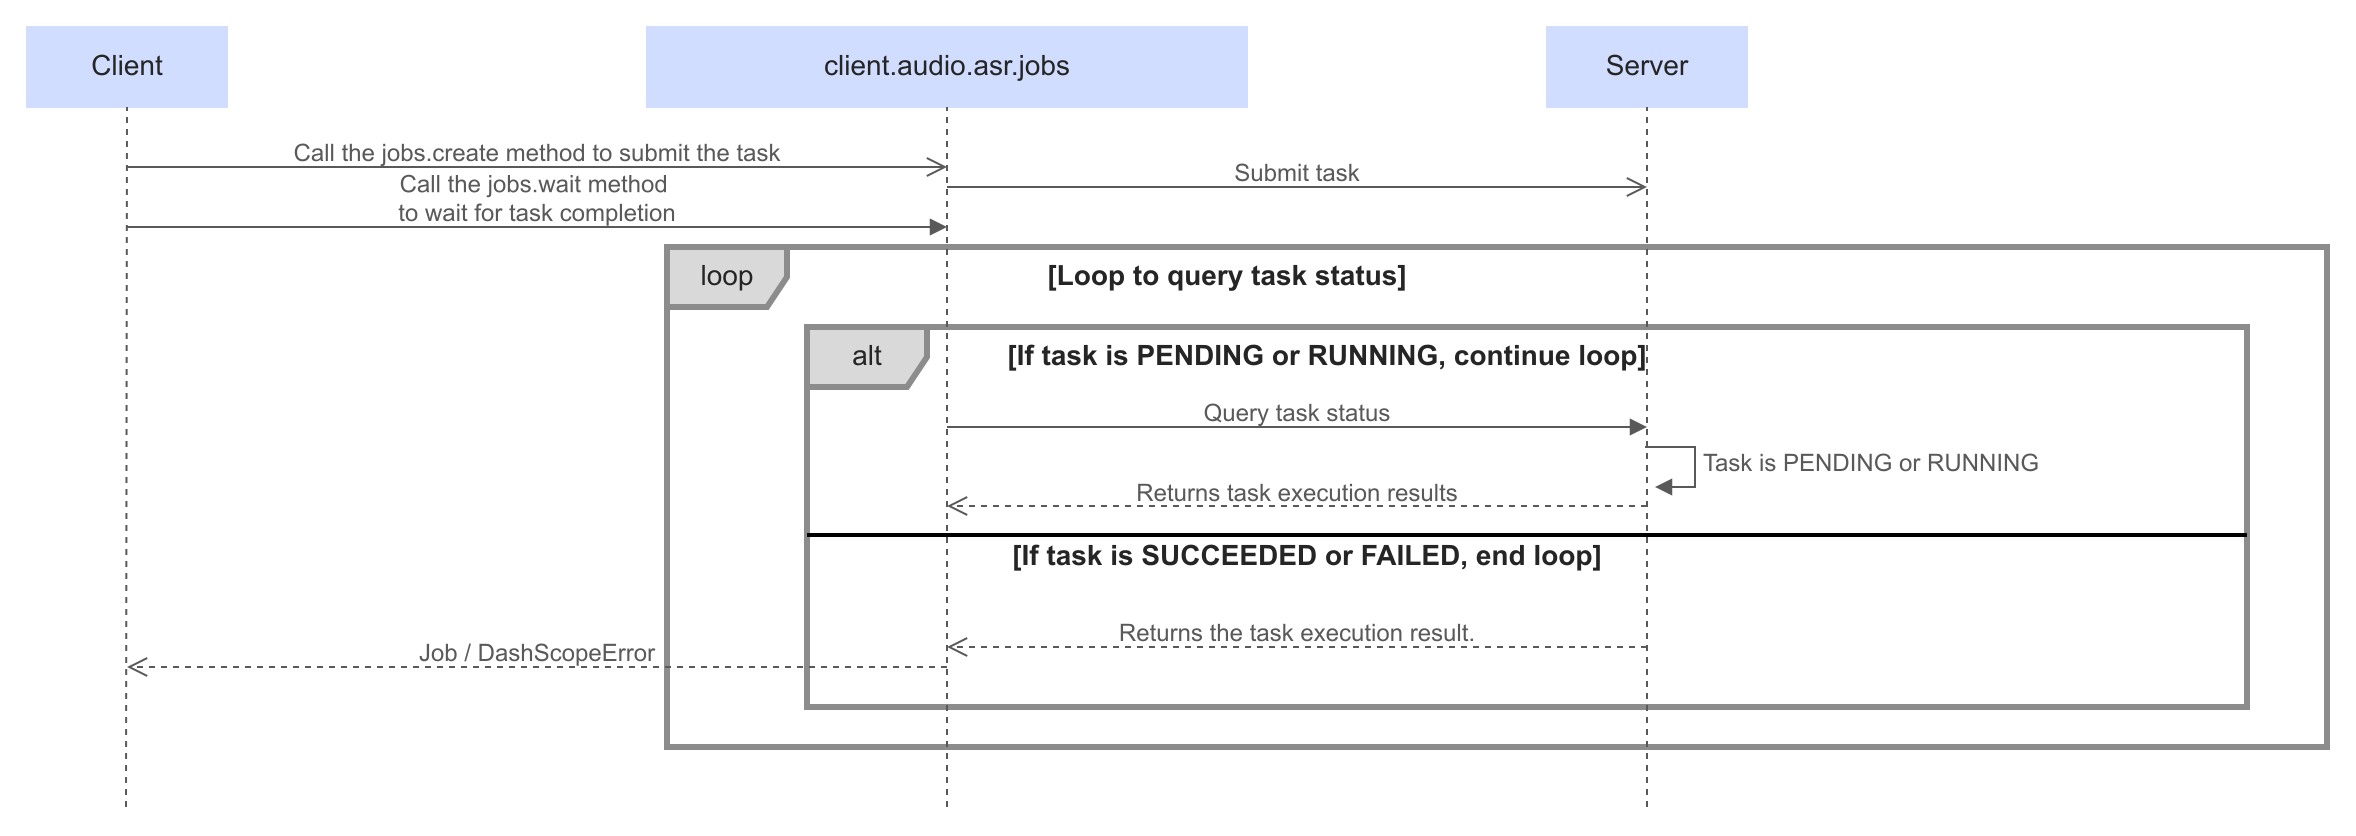
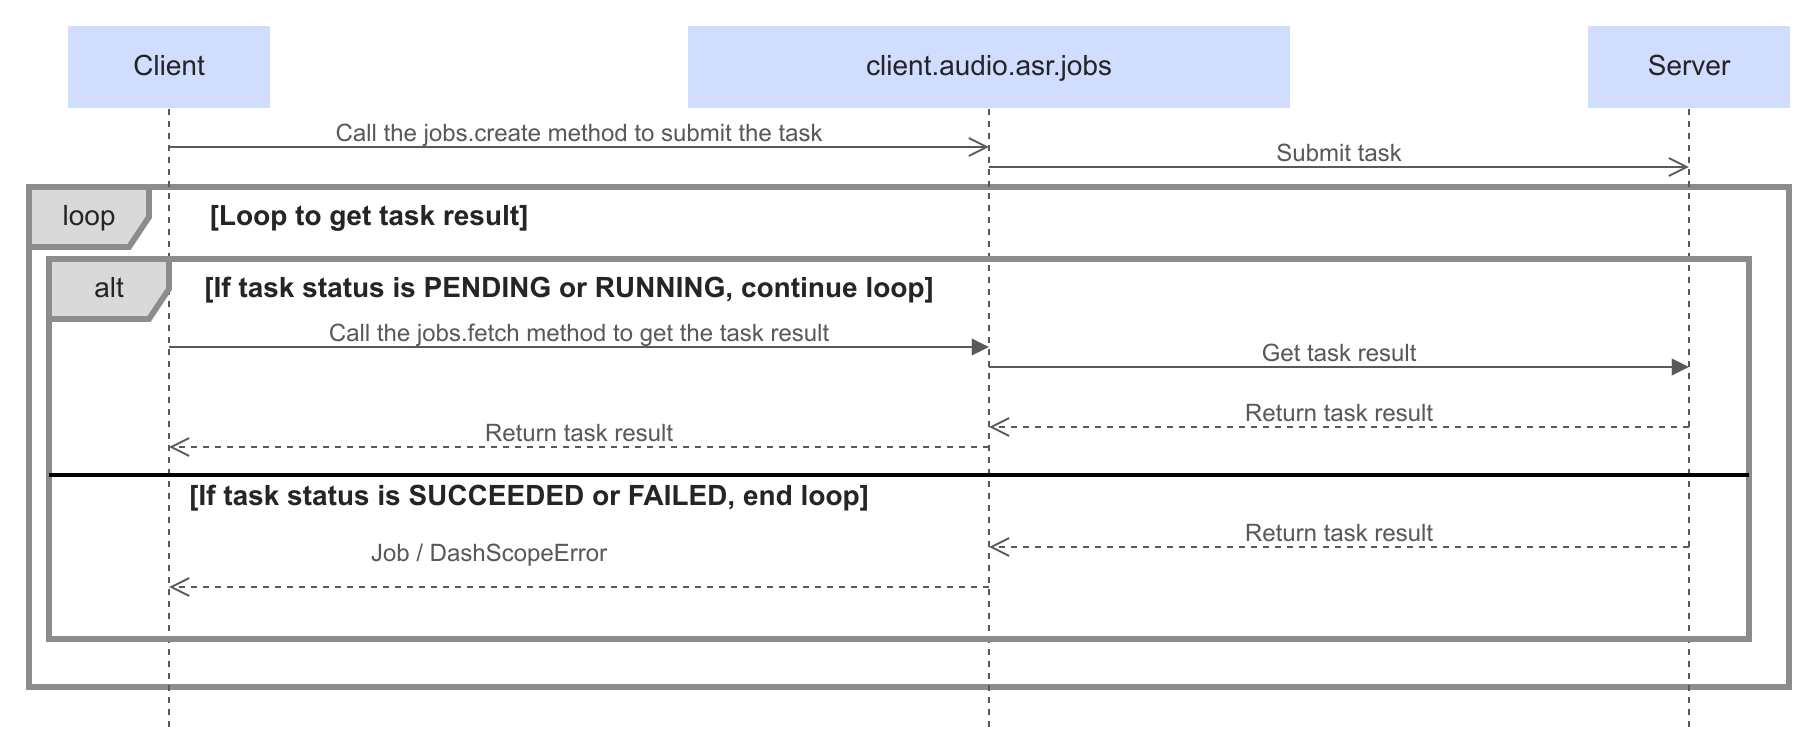
Contoh berikut menggunakan DashScope Python SDK 2.0. Resource inti (client.audio.asr) menyediakan metode untuk mengirim, menunggu, dan mengueri tugas dengan dua cara berikut:
- Kirim tugas secara asinkron dan tunggu secara sinkron: setelah mengirimkan tugas, blokir thread saat ini hingga tugas selesai dan kembalikan hasil pengenalan.
- Kirim tugas secara asinkron dan ambil hasil secara asinkron: setelah mengirimkan tugas, panggil antarmuka query untuk mengambil hasil kapan pun Anda membutuhkannya.
Kirim secara asinkron dan tunggu secara sinkron
-
Panggil
client.audio.asr.jobs.createuntuk mengirim tugas dengan parameter permintaan.Catatan
- Layanan transkripsi file memproses tugas yang dikirim melalui API berdasarkan prinsip best-effort. Setelah Anda mengirimkan tugas, tugas tersebut masuk ke status antrian (
PENDING). Waktu antrian bergantung pada panjang antrian dan durasi file, sehingga tidak dapat ditentukan secara pasti, tetapi biasanya dalam hitungan beberapa menit. Setelah pemrosesan dimulai, pengenalan ucapan selesai dengan kecepatan ratusan kali lipat dari kecepatan real-time. - Setelah setiap tugas selesai, hasil pengenalan dan URL unduhan berlaku selama 24 jam. Setelah masa berlaku habis, Anda tidak dapat lagi mengambil tugas atau mengunduh hasil melalui URL yang dikembalikan dalam query sebelumnya.
- Layanan transkripsi file memproses tugas yang dikirim melalui API berdasarkan prinsip best-effort. Setelah Anda mengirimkan tugas, tugas tersebut masuk ke status antrian (
-
Panggil
client.audio.asr.jobs.wait(job=job)untuk menunggu penyelesaian secara sinkron.Selama tugas berstatus
PENDINGatauRUNNING,jobs.waitterus menunggu. Metode ini mengembalikanJobsaat tugas berhasil.Metode mengembalikan
Job. Baca daftar hasil darijob.results; setiaptranscription_urlmengarah ke hasil transkripsi yang dapat diunduh.
import json
import os

import dashscope

# Ganti {WorkspaceId} dengan ID ruang kerja sebenarnya untuk wilayah tersebut.
client = dashscope.Client(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    workspace="{WorkspaceId}",
    region="ap-southeast-1",
)

job = client.audio.asr.jobs.create(
    model="qwen-audio-3.0-asr-flash-filetrans",
    file_urls=["{YOUR_AUDIO_URL}"],
)

job = client.audio.asr.jobs.wait(job=job)

print(json.dumps(job.model_dump(), indent=4, ensure_ascii=False))
Kirim secara asinkron dan ambil hasil secara asinkron
-
Panggil
client.audio.asr.jobs.createuntuk mengirim tugas dengan parameter permintaan.Catatan
- Layanan transkripsi file memproses tugas yang dikirim melalui API berdasarkan prinsip best-effort. Setelah Anda mengirimkan tugas, tugas tersebut masuk ke status antrian (
PENDING). Waktu antrian bergantung pada panjang antrian dan durasi file, sehingga tidak dapat ditentukan secara pasti, tetapi biasanya dalam hitungan beberapa menit. Setelah pemrosesan dimulai, pengenalan ucapan selesai dengan kecepatan ratusan kali lipat dari kecepatan real-time. - Setelah setiap tugas selesai, hasil pengenalan dan URL unduhan berlaku selama 24 jam. Setelah masa berlaku habis, Anda tidak dapat lagi mengambil tugas atau mengunduh hasil melalui URL yang dikembalikan dalam query sebelumnya.
- Layanan transkripsi file memproses tugas yang dikirim melalui API berdasarkan prinsip best-effort. Setelah Anda mengirimkan tugas, tugas tersebut masuk ke status antrian (
-
Panggil
client.audio.asr.jobs.fetch(task_id)dalam loop dan baca hasilnya setelah tugas berhasil.Baca status tugas dari
job.status. Contoh ini mengueri tugas sekali per detik.Metode mengembalikan
Job. Baca daftar hasil darijob.results; setiaptranscription_urlmengarah ke hasil transkripsi yang dapat diunduh.
import json
import os
import time

import dashscope

# Ganti {WorkspaceId} dengan ID ruang kerja sebenarnya untuk wilayah tersebut.
client = dashscope.Client(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    workspace="{WorkspaceId}",
    region="ap-southeast-1",
)

job = client.audio.asr.jobs.create(
    model="qwen-audio-3.0-asr-flash-filetrans",
    file_urls=["{YOUR_AUDIO_URL}"],
)

while job.status in ("PENDING", "RUNNING"):
    time.sleep(1)
    job = client.audio.asr.jobs.fetch(task_id=job.task_id)

print(json.dumps(job.model_dump(), indent=4, ensure_ascii=False))
Titik akhir layanan
SDK menggunakan wilayah Beijing secara default. Saat membuat dashscope.Client, tentukan wilayah melalui region dan ID ruang kerja melalui workspace. Pengaturan wilayah hanya berlaku untuk Client ini.
Singapura
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1
Ganti {WorkspaceId} dengan ID Ruang Kerja aktual Anda.
China (Beijing)
https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1
Ganti {WorkspaceId} dengan ID Ruang Kerja aktual Anda.
API Key berbeda untuk setiap wilayah. Gunakan API Key untuk wilayah yang sesuai.
Parameter permintaan
Atur parameter permintaan melalui client.audio.asr.transcribe atau client.audio.asr.jobs.create.
| Parameter | Tipe | Wajib | Deskripsi |
|---|---|---|---|
|
| Ya | Nama model. |
|
| Ya | Daftar URL file audio atau video yang akan ditranskripsi. HTTP dan HTTPS didukung. Satu permintaan hanya mendukung satu URL. Untuk persyaratan input seperti format audio yang didukung, batas ukuran file, dan batas durasi, lihat Spesifikasi audio. Jika rekaman disimpan di Alibaba Cloud OSS, RESTful API mendukung URL sementara dengan awalan Penting
|
|
| Tidak | Hanya didukung oleh |
|
| Tidak | ID daftar kata kunci panas yang telah dikompilasi sebelumnya. Hasilkan ID ini terlebih dahulu dengan memanggil API pembuatan daftar kata kunci panas. Masukkan ID ini selama pengenalan untuk menggunakan kata kunci dalam daftar tersebut. Cocok untuk skenario di mana kosakata diketahui dan relatif stabil, serta Anda perlu menggunakan kembali daftar kata yang sama di berbagai permintaan. Untuk detail penggunaan, lihat Kata kunci panas yang telah dikompilasi. |
|
| Tidak | Hotword instan. Diteruskan sebagai pasangan kunci-nilai, di mana kunci adalah teks kata kunci panas ( Cocok untuk optimasi kata kunci panas tingkat sesi yang bersifat sementara. Jika kata kunci instan dan prakompilasi dikonfigurasi bersama, kedua daftar digabungkan. Jika hasil gabungan melebihi 2000 kata kunci, 2000 kata kunci dipilih secara acak. Untuk detail penggunaan, lihat Kata kunci panas instan. Contoh: Contoh berikut menggunakan kembali |
|
| Tidak | Indeks track audio yang akan dikenali dalam file audio multi-track. Indeks dimulai dari 0. Misalnya, [0] mengenali track pertama, dan [0, 1] mengenali track pertama dan kedua secara bersamaan. Jika Anda mengabaikan parameter ini, hanya track pertama yang diproses. PentingSetiap track yang ditentukan ditagih secara independen. Misalnya, meminta [0, 1] untuk satu file dikenai dua biaya terpisah. Nilai default: [0]. |
|
| Tidak | Kata sensitif yang akan diproses selama pengenalan ucapan. Anda dapat mengatur metode penanganan berbeda untuk setiap kata sensitif. Untuk detailnya, lihat Penyaringan kata sensitif. |
|
| Tidak | Apakah akan mengaktifkan diarization pembicara. Secara default dinonaktifkan. Hanya berlaku untuk audio mono. Audio multi-channel tidak mendukung diarization pembicara. Saat diaktifkan, hasil pengenalan mencakup bidang CatatanSaat diarization pembicara diaktifkan, pastikan durasi audio tidak melebihi 2 jam. Jika tidak, pengenalan mungkin gagal atau timeout. Nilai default: False. Untuk contoh |
|
| Tidak | PentingHanya berlaku saat diarization pembicara diaktifkan ( Nilai referensi jumlah pembicara. Rentang valid adalah bilangan bulat dari 2 hingga 100 (inklusif). Secara default, jumlah pembicara dideteksi secara otomatis. Jika Anda mengatur nilai ini, nilai tersebut hanya membimbing algoritma untuk menghasilkan jumlah yang ditentukan jika memungkinkan dan tidak menjamin jumlah pasti tersebut. Tidak ada nilai default. |
|
| Tidak | Kode bahasa yang akan dikenali. Jika Anda tidak dapat menentukan bahasa sebelumnya, biarkan tidak diatur dan model akan mendeteksi bahasa secara otomatis. Anda dapat menetapkan hingga 4 nilai. Jika lebih, hanya 4 nilai pertama yang berlaku. Klik untuk melihat kode bahasa yang didukung
|
Tanggapan
Job
Job berisi informasi tugas, output mentah, dan penggunaan.
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "PENDING",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": null,
    "finished_at": null,
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "PENDING",
        "submit_time": "2026-10-29 10:00:00.000"
    },
    "usage": null
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "RUNNING",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": null,
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "RUNNING",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100"
    },
    "usage": null
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "SUCCEEDED",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": "2026-10-29 10:00:01.000",
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "SUCCEEDED",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100",
        "end_time": "2026-10-29 10:00:01.000",
        "results": [
            {
                "file_url": "{YOUR_AUDIO_URL}",
                "transcription_url": "{TRANSCRIPTION_URL}",
                "subtask_status": "SUCCEEDED"
            }
        ]
    },
    "usage": {
        "duration": 1,
        "total_tokens": 0,
        "output_tokens": 0,
        "input_tokens": 0
    }
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "FAILED",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": "2026-10-29 10:00:01.000",
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "FAILED",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100",
        "end_time": "2026-10-29 10:00:01.000",
        "code": "SERVER_ERROR",
        "file_url": "{YOUR_AUDIO_URL}",
        "subtask_status": "FAILED",
        "results": [
            {
                "file_url": "{YOUR_AUDIO_URL}",
                "subtask_status": "FAILED",
                "results": []
            }
        ]
    },
    "usage": null
}
Kolom | Deskripsi |
|---|---|
| ID tugas. |
| Status tugas: |
| Waktu pengiriman, sesuai dengan |
| Waktu mulai pemrosesan, sesuai dengan |
| Waktu selesai, sesuai dengan |
| Dictionary output tugas mentah. |
| Daftar hasil subtugas, dapat diakses melalui |
| Informasi penggunaan tugas. |
Job.output
job.output adalah dictionary output tugas mentah yang dikembalikan oleh layanan.
PENDING
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "PENDING",
    "submit_time": "2026-10-29 10:00:00.000"
}
RUNNING
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "RUNNING",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100"
}
SUCCEEDED
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "SUCCEEDED",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100",
    "end_time": "2026-10-29 10:00:01.000",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "transcription_url": "{TRANSCRIPTION_URL}",
            "subtask_status": "SUCCEEDED"
        }
    ]
}
FAILED (raise_on_error=False)
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "FAILED",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100",
    "end_time": "2026-10-29 10:00:01.000",
    "code": "SERVER_ERROR",
    "file_url": "{YOUR_AUDIO_URL}",
    "subtask_status": "FAILED",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "subtask_status": "FAILED",
            "results": []
        }
    ]
}
| Parameter | Deskripsi |
|---|---|
| Kode kesalahan. Gabungkan dengan bidang |
| Pesan kesalahan. Gabungkan dengan bidang |
| ID Tugas. |
| Status tugas. Salah satu dari empat status: Saat tugas berisi beberapa subtugas, status tugas keseluruhan ditandai sebagai |
| Hasil pengenalan subtugas. |
| Status subtugas. Salah satu dari empat status: |
| URL audio yang dikenali. |
| URL hasil pengenalan audio. Hasil pengenalan disimpan sebagai file JSON. Anda dapat mengunduh file tersebut dari tautan yang terkait dengan |
Deskripsi hasil pengenalan
Hasil pengenalan disimpan sebagai file JSON.
{
    "file_url":"{YOUR_AUDIO_URL}",
    "properties":{
        "audio_format":"pcm_s16le",
        "channels":[
            0
        ],
        "original_sampling_rate":16000,
        "original_duration_in_milliseconds":3834
    },
    "transcripts":[
        {
            "channel_id":0,
            "content_duration_in_milliseconds":3720,
            "text":"Hello world, this is Alibaba Speech Lab.",
            "sentences":[
                {
                    "begin_time":100,
                    "end_time":3820,
                    "text":"Hello world, this is Alibaba Speech Lab.",
                    "sentence_id":1,
                    "speaker_id":0, //Bidang ini ditampilkan hanya saat diarization pembicara otomatis diaktifkan
                    "words":[
                        {
                            "begin_time":100,
                            "end_time":596,
                            "text":"Hello ",
                            "punctuation":""
                        },
                        {
                            "begin_time":596,
                            "end_time":844,
                            "text":"world",
                            "punctuation":", "
                        }
                        // Konten lainnya dihilangkan di sini
                    ]
                }
            ]
        }
    ]
}
Parameter berikut perlu diperhatikan:
| Parameter | Tipe | Deskripsi |
|---|---|---|
|
| Format audio file sumber. |
| array[integer] | Indeks track audio dalam file sumber. Untuk audio single-track, [0] dikembalikan; untuk audio dual-track, [0, 1] dikembalikan; dan seterusnya. |
|
| Laju sampel (Hz) audio dalam file sumber. |
|
| Durasi audio asli (ms) dalam file sumber. |
|
| Indeks track hasil transkripsi, dimulai dari 0. |
|
| Durasi (ms) konten dalam track yang diidentifikasi sebagai ucapan. CatatanPenjelasan penagihan berikut berlaku untuk Layanan model pengenalan ucapan hanya mentranskripsi konten dalam track yang diidentifikasi sebagai ucapan, dan melakukan metering serta penagihan berdasarkan durasi tersebut. Konten non-ucapan tidak di-metering atau ditagih. Biasanya, durasi konten ucapan lebih pendek daripada durasi audio asli. Karena keberadaan konten ucapan ditentukan oleh model AI, hasilnya mungkin sedikit berbeda dari situasi aktual. |
|
| Hasil transkripsi tingkat paragraf. |
|
| Hasil transkripsi tingkat kalimat. |
|
| Hasil transkripsi tingkat kata. |
|
| Timestamp mulai (ms). |
|
| Timestamp akhir (ms). |
|
| Hasil transkripsi. |
|
| Indeks pembicara saat ini, dimulai dari 0, digunakan untuk membedakan pembicara berbeda. Bidang ini muncul dalam hasil pengenalan hanya saat diarization pembicara diaktifkan. |
|
| Tanda baca yang diprediksi setelah kata, jika ada. |
Antarmuka utama
Resource inti (client.audio.asr)
Buat klien dengan dashscope.Client, lalu gunakan resource client.audio.asr. Semua metode berikut mengembalikan Job.
Metode | Signature metode | Deskripsi |
|---|---|---|
| | Kirim tugas dan tunggu penyelesaiannya secara sinkron. Model default adalah |
| | Kirim tugas dan kembalikan |
| | Teruskan |
| | Kueri status dan hasil tugas sekali berdasarkan ID tugas, tanpa menunggu penyelesaian. |
Kode kesalahan
Secara default, tugas yang gagal memicu DashScopeError. Untuk menerima Job yang gagal, atur raise_on_error=False saat membuat Client, lalu periksa job.status.
Jika Anda mengalami kesalahan, lihat Kode kesalahan untuk memecahkan masalah.
Saat tugas berisi beberapa subtugas, status tugas keseluruhan ditandai sebagai SUCCEEDED selama setidaknya satu subtugas berhasil. Periksa bidang subtask_status untuk menentukan hasil setiap subtugas.
Contoh tanggapan kesalahan:
{
    "task_id": "7bac899c-06ec-4a79-8875-xxxxxxxxxxxx",
    "task_status": "SUCCEEDED",
    "submit_time": "2024-12-16 16:30:59.170",
    "scheduled_time": "2024-12-16 16:30:59.204",
    "end_time": "2024-12-16 16:31:02.375",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "code": "InvalidFile.DownloadFailed",
            "message": "The audio file cannot be downloaded.",
            "subtask_status": "FAILED"
        }
    ],
    "task_metrics": {
        "TOTAL": 1,
        "SUCCEEDED": 0,
        "FAILED": 1
    }
}
FAQ
Fitur
T: Apakah audio terenkode Base64 didukung?
Audio yang dienkripsi Base64 tidak didukung. Hanya audio di URL yang dapat diakses publik yang dapat dikenali. Aliran biner dan file lokal tidak dapat dikenali secara langsung.
T: Bagaimana cara membuat file audio tersedia di URL yang dapat diakses publik?
Langkah-langkah umum adalah sebagai berikut. Ini adalah salah satu pendekatan; proses sebenarnya bervariasi tergantung produk penyimpanan. Kami menyarankan Anda mengunggah audio ke Alibaba Cloud OSS:
1. Pilih metode penyimpanan dan hosting
Contohnya:
-
Layanan penyimpanan objek (direkomendasikan):
- Gunakan layanan penyimpanan objek penyedia cloud (seperti Alibaba Cloud OSS) untuk mengunggah file audio ke bucket dan mengaturnya ke akses publik.
- Keuntungan: Ketersediaan tinggi, dukungan akselerasi CDN, dan manajemen mudah.
-
Server web:
- Letakkan file audio di server web yang mendukung akses HTTP/HTTPS (seperti Nginx atau Apache).
- Keuntungan: Cocok untuk proyek kecil atau pengujian lokal.
-
Jaringan pengiriman konten (CDN):
- Host file audio di CDN dan akses melalui URL yang disediakan CDN.
- Keuntungan: Mempercepat pengiriman file dan cocok untuk skenario konkurensi tinggi.
2. Unggah file audio
Unggah audio sesuai metode penyimpanan atau hosting yang Anda pilih. Contohnya:
-
Layanan penyimpanan objek:
- Masuk ke konsol penyedia cloud dan buat bucket.
- Unggah file audio, dan atur izinnya ke baca publik atau hasilkan tautan akses sementara.
-
Server web:
- Letakkan file audio di direktori yang ditentukan di server (seperti
/var/www/html/audio/). - Pastikan file dapat diakses melalui HTTP/HTTPS.
- Letakkan file audio di direktori yang ditentukan di server (seperti
3. Hasilkan URL yang dapat diakses publik
Contohnya:
-
Layanan penyimpanan objek:
- Setelah file diunggah, sistem secara otomatis menghasilkan URL akses publik (biasanya dalam format
https://<bucket-name>.<region>.aliyuncs.com/<file-name>). - Untuk Nama domain yang lebih ramah, ikat domain kustom dan aktifkan HTTPS.
- Setelah file diunggah, sistem secara otomatis menghasilkan URL akses publik (biasanya dalam format
-
Server web:
- URL akses biasanya alamat server ditambah jalur file (seperti
https://your-domain.com/audio/file.mp3).
- URL akses biasanya alamat server ditambah jalur file (seperti
-
CDN:
- Setelah Anda mengonfigurasi akselerasi CDN, gunakan URL yang disediakan CDN (seperti
https://cdn.your-domain.com/audio/file.mp3).
- Setelah Anda mengonfigurasi akselerasi CDN, gunakan URL yang disediakan CDN (seperti
4. Verifikasi bahwa URL berfungsi
Pastikan URL yang dihasilkan dapat diakses melalui jaringan publik. Contohnya:
- Buka URL di browser dan periksa apakah file audio dapat diputar.
- Gunakan tool (seperti
curlatau Postman) untuk memverifikasi bahwa URL mengembalikan respons HTTP yang benar (kode status 200).
Saat menggunakan SDK, jika file audio disimpan di Alibaba Cloud OSS, URL sementara dengan awalan oss:// tidak didukung.
Saat menggunakan RESTful API, jika file audio disimpan di Alibaba Cloud OSS, URL sementara dengan awalan oss:// didukung:
- URL sementara berlaku selama 48 jam dan tidak dapat digunakan setelah masa berlaku habis. Jangan gunakan di lingkungan produksi.
- API untuk mendapatkan kredensial unggah dibatasi hingga 100 QPS dan tidak mendukung penskalaan. Jangan gunakan di lingkungan produksi, skenario konkurensi tinggi, atau skenario uji stres.
- Untuk lingkungan produksi, gunakan layanan penyimpanan stabil seperti OSS untuk memastikan ketersediaan file jangka panjang dan menghindari masalah Pembatasan laju.
T: Berapa lama waktu yang dibutuhkan untuk mendapatkan hasil pengenalan?
Setelah tugas dikirim, tugas tersebut masuk ke status antrian (PENDING). Waktu antrian bergantung pada panjang antrian dan durasi audio, sehingga tidak dapat ditentukan secara pasti, tetapi biasanya dalam hitungan beberapa menit. Secara umum, semakin panjang audio, semakin lama waktunya.
Pemecahan masalah
Jika Anda mengalami kesalahan kode, pecahkan masalah berdasarkan informasi di Kode kesalahan.
T: Polling tidak pernah mengembalikan hasil?
Hal ini mungkin disebabkan oleh Pembatasan kecepatan. Tunggu sebentar dan coba lagi.
T: Mengapa ucapan tidak dapat dikenali (tidak ada hasil pengenalan)?
Periksa apakah format audio dan laju sampel sudah benar dan memenuhi batasan parameter.
Gunakan tool ffprobe untuk mendapatkan container audio, kodek, laju sampel, channel, dan detail lainnya:
ffprobe -v error -show_entries format=format_name -show_entries stream=codec_name,sample_rate,channels -of default=noprint_wrappers=1 input.xxx