Topik ini menjelaskan cara menggunakan layanan model bahasa besar bawaan dalam pekerjaan Flink SQL untuk analisis sentimen dan vektorisasi aliran data tanpa perlu menyediakan Kunci API sendiri.
Informasi latar belakang
Layanan Flink AI menyediakan model bahasa besar (LLM) bawaan yang dikelola sehingga Anda tidak perlu menyediakan Kunci API. Cukup merujuk langsung ke model bawaan tersebut dalam pekerjaan Flink SQL untuk mengaktifkan inferensi AI dan vektorisasi berbasis aliran. Bagian berikut menjelaskan dua kasus penggunaan inti model:
-
Model chat/completions: Model chat/completions adalah LLM berbasis generasi dialog dan pemahaman teks, yang banyak digunakan dalam skenario seperti analisis sentimen, pengenalan maksud, dan sistem tanya-jawab.
-
Analisis sentimen: Melakukan klasifikasi sentimen secara real-time terhadap komentar media sosial bisnis Anda untuk mengidentifikasi sentimen pengguna sebagai positif, negatif, atau netral.
-
Layanan pelanggan cerdas: Menyediakan interaksi bahasa alami untuk sistem layanan pelanggan cerdas, didukung oleh kemampuan generasi dialog.
-
Moderasi konten: Secara otomatis mendeteksi konten sensitif atau pelanggaran kebijakan dalam teks guna mempercepat audit keamanan konten.
-
-
Model embedding: Model embedding mengonversi teks menjadi representasi vektor berdimensi tinggi. Aplikasi umumnya mencakup pencarian semantik, sistem rekomendasi, dan pembangunan graf pengetahuan.
-
Pencarian semantik: Memungkinkan pencarian semantik berbasis relevansi dengan melakukan vektorisasi pada deskripsi produk atau kueri pengguna.
-
Sistem rekomendasi: Menggunakan vektorisasi teks untuk menemukan keterkaitan antara minat pengguna dan fitur produk, sehingga meningkatkan akurasi rekomendasi.
-
Graf pengetahuan: Mengonversi teks tak terstruktur ke format vektor guna menyederhanakan ekstraksi pengetahuan dan pemodelan hubungan selanjutnya.
-
Prasyarat
-
Anda telah mengaktifkan ruang kerja Flink. Untuk informasi lebih lanjut, lihat Aktifkan Realtime Compute for Apache Flink.
-
Anda telah mengaktifkan layanan Flink AI. Untuk informasi lebih lanjut, lihat Layanan Flink AI (model bawaan).
Batasan
-
Memerlukan Ververica Runtime (VVR) versi 11.7 atau lebih baru.
-
Throughput operator ML_PREDICT dibatasi oleh kebijakan pembatasan laju platform layanan model. Saat batas trafik tercapai, pekerjaan Flink mungkin mengalami tekanan balik atau restart akibat timeout.
Langkah 1: Daftarkan model bawaan
Untuk informasi lebih lanjut, lihat Pengaturan model.
Model chat/completions
Kode SQL contoh berikut menunjukkan cara mendaftarkan model teks bawaan Flink:
CREATE MODEL ai_analyze_sentiment
INPUT (`input` STRING)
OUTPUT (`content` STRING)
WITH (
    'provider' = 'dashscope',
    'task' = 'chat/completions',
    'model' = 'qwen3.5-flash',
    'system-prompt' = 'Classify the text below into one of the following labels: [positive, negative, neutral, mixed]. Output only the label.'
);
Model embedding
Kode SQL contoh berikut menunjukkan cara mendaftarkan model embedding bawaan Flink:
CREATE MODEL embedding_model
INPUT (`input` STRING)
OUTPUT (`embeddings` ARRAY<FLOAT>)
WITH (
    'provider' = 'dashscope',
    'task' = 'embeddings',
    'model' = 'text-embedding-v4'
);
Langkah 2: Buat pekerjaan
Buat draf pekerjaan streaming SQL. Untuk informasi lebih lanjut, lihat Pekerjaan Flink SQL.
Langkah 3: Tulis pekerjaan SQL untuk analisis LLM
Model chat/completions
Gunakan fungsi AI ML_PREDICT untuk memanggil model ai_analyze_sentiment yang telah didaftarkan guna melakukan analisis sentimen terhadap ulasan film.
Salin kode SQL contoh berikut ke editor SQL.
-- Create a temporary sink table.
CREATE TEMPORARY TABLE print_sink(
  id BIGINT,
  movie_name VARCHAR,
  predict_label VARCHAR,
  actual_label VARCHAR
) WITH (
  'connector' = 'print',   -- Use the print connector.
  'logger' = 'true'        -- Display the results in the console.
);

-- Create a temporary data view to construct test data.
-- | id | movie_name | comment   | actual_label |
-- | 1  | Her Story     | My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving. | POSITIVE |
-- | 2  | The Dumpling Queen   | Unremarkable.  | NEGATIVE |
CREATE TEMPORARY VIEW movie_comment(id, movie_name, user_comment, actual_label)
AS VALUES (1, 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.', 'positive'), (2, 'The Dumpling Queen', 'Unremarkable.', 'negative');

INSERT INTO print_sink
SELECT id, movie_name, content as predict_label, actual_label
FROM ML_PREDICT(
  TABLE movie_comment,
  MODEL ai_analyze_sentiment,  -- The registered Flink built-in text model.
  DESCRIPTOR(user_comment));
Model embedding
Gunakan fungsi AI ML_PREDICT untuk memanggil model embedding_model yang telah didaftarkan, menghasilkan penyematan untuk ulasan film, lalu menuliskan hasilnya ke Milvus (pratinjau publik).
Salin kode SQL contoh berikut ke editor SQL.
-- Create a temporary sink table named milvus_sink.
CREATE TEMPORARY TABLE milvus_sink
(
    id STRING,
    movie_name STRING,
    user_comment STRING,
    embeddings ARRAY<FLOAT>,
    PRIMARY KEY (id) NOT ENFORCED
)
WITH (
    'connector' = 'milvus',
    'endpoint' = '<YOUR-ENDPOINT>',
    'port' = '<YOUR-PORT>',
    'userName' = '<YOUR-USERNAME>',
    'password' = '<YOUR-PASSWORD>',
    'databaseName' = 'default',
    'collectionName' = 'movie-comment-embeddings'
);

-- Create a temporary data view to construct test data.
-- | id | movie_name | comment |
-- | 1 | Her Story |My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.|
-- | 2 | The Dumpling Queen | Unremarkable. |
CREATE TEMPORARY VIEW movie_comment(id, movie_name,  user_comment)
AS VALUES ('1', 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.'), ('2', 'The Dumpling Queen', 'Unremarkable.');


INSERT INTO
    milvus_sink
SELECT
    id,
    movie_name,
    user_comment,
    embeddings
FROM
    ML_PREDICT (
        TABLE movie_comment,
        MODEL embedding_model,  -- The registered Flink built-in embedding model.
        DESCRIPTOR (user_comment)
    );
Langkah 4: Sebarkan dan mulai pekerjaan
Sebarkan dan mulai pekerjaan. Untuk informasi lebih lanjut, lihat Pekerjaan Flink SQL.
Langkah 5: Lihat hasil analisis
Model chat/completions
-
Verifikasi bahwa status pekerjaan adalah FINISHED.
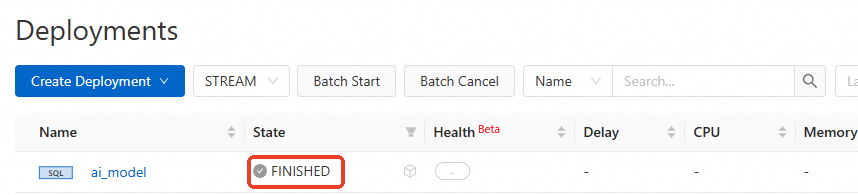
-
Di konsol , buka halaman Deployments lalu klik nama pekerjaan target.
-
Di tab Logs, klik subtab Task Managers dan pilih current TaskManager.
-
Klik Logs dan cari log yang terkait dengan PrintSinkOutputWriter.
Label prediksi model
predict_labelsesuai dengan label aktualactual_label.Di tab Task Managers, pilih Running Logs di sebelah kiri. Log menampilkan output PrintSinkOutputWriter, seperti
+I[1, Her Story, positive, positive]dan+I[2, The Dumpling Queen, negative, negative]. Hal ini menunjukkan bahwa predict_label sesuai dengan actual_label.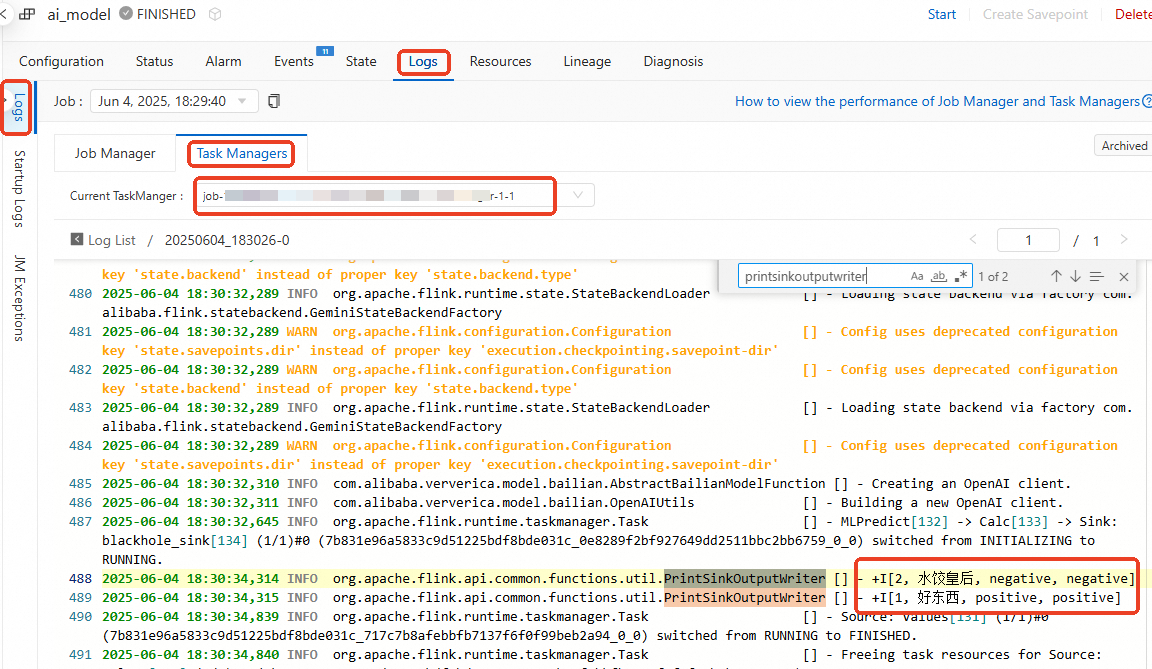
Dokumen terkait
-
Pernyataan Data Definition Language (DDL) untuk model AI: Konfigurasikan model
-
Fungsi AI: ML_PREDICT
-
Layanan pencarian vektor: Milvus (pratinjau publik)