Topik ini menjelaskan pertanyaan yang sering diajukan mengenai dependensi.
Hal yang perlu diketahui sebelum mengonfigurasi dependensi penjadwalan
FAQ tentang konfigurasi dependensi penjadwalan
Error: Output node induk yang menjadi dependensi node saat ini tidak ada
Mengapa nama dan ID node turunan kadang kosong dan tidak dapat diedit di bagian output node
Apa aturan untuk task turunan yang bergantung pada task hulu
Apakah beberapa node yang menulis ke tabel yang sama dapat memiliki nama output yang sama
Cara mengecualikan tabel antara saat menggunakan dependensi hasil parsing otomatis
Cara mengonfigurasi node induk untuk node paling hulu dalam alur kerja
FAQ tentang penghapusan dan modifikasi node
Skenario konfigurasi dependensi lintas siklus
Mengapa beberapa garis dependensi berupa garis putus-putus di Operation Center
Bagaimana self-dependency pada task per jam memengaruhi task tersebut dan node turunannya
Kapan task harian berjalan jika bergantung pada task per jam
Cara membuat task harian bergantung pada instans per jam tertentu, bukan semua instans per jam
Cara membuat task harian bergantung pada semua instans per jam kemarin, bukan hari ini
Kapan harus mengonfigurasi dependensi lintas siklus agar bergantung pada node itu sendiri
Cara mengonfigurasi dependensi ketika node turunan bergantung pada beberapa task hulu
Jika task per jam hulu berjalan melewati tengah malam, apakah task harian turunan tetap berjalan
Cara memicu task harian setelah instans task per jam pertama berhasil setiap hari
Skenario konfigurasi dependensi penjadwalan
FAQ lainnya
Konsep utama
Dependensi penjadwalan adalah dependensi hulu-turunan antar node. Di DataWorks, node task turunan hanya mulai berjalan setelah node task hulunya berhasil dijalankan.
Setelah dependensi dikonfigurasi, salah satu prasyarat agar node saat ini dapat berjalan adalah node induk yang menjadi dependensi node saat ini harus berhasil dijalankan. Untuk informasi lebih lanjut tentang dependensi penjadwalan, lihat Dependensi penjadwalan.
Mengapa saya perlu mengonfigurasi dependensi penjadwalan?
Setelah dependensi penjadwalan dikonfigurasi, sistem penjadwalan memastikan bahwa task terjadwal mengambil data yang benar pada waktu proses. Setelah node hulu yang menjadi dependensi node saat ini berhasil dijalankan, DataWorks mengidentifikasi bahwa data terbaru di tabel hulu telah diproduksi berdasarkan status eksekusi node tersebut. Kemudian, node turunan mengambil data tersebut. Hal ini mencegah masalah di mana node turunan mengambil data sebelum tabel hulu selesai memproduksi data.
Bagaimana cara mengonfigurasi dependensi penjadwalan di DataWorks?
Di DataWorks, output dari node hulu berfungsi sebagai input dari node turunan untuk membentuk dependensi antar node.
Task SQL secara otomatis mengonfigurasi input dan output node dengan cara berikut:
Ketika Anda
selectdari sebuah tabel, sistem secara otomatis melakukan parsing node yang memproduksi tabel tersebut sebagai dependensi hulu dari node saat ini.Ketika Anda
insertke ataucreatesebuah tabel, sistem secara otomatis melakukan parsing tabel tersebut sebagai output dari node saat ini.
Untuk task Data Integration, Anda harus menambahkan secara manual tabel output dalam format
projectname.tablenamesebagai output node. Hal ini memastikan fitur parsing otomatis dapat menyelesaikan dependensi ketika node turunan memproses tabel output hasil sinkronisasi.Karena diperlukan output unik untuk menemukan node unik dan membentuk dependensi antar node, output node (
projectname.tablename) harus unik.
Pada skenario apa dependensi penjadwalan tidak didukung?
Dependensi penjadwalan di DataWorks terutama dirancang untuk memastikan bahwa tabel yang diperbarui secara terjadwal oleh node terjadwal memiliki datanya dikonsumsi dengan benar oleh node turunan. Oleh karena itu, tabel yang tidak diperbarui oleh node terjadwal DataWorks tidak dapat dipantau oleh platform.
Jika sebuah tabel tidak diproduksi oleh penjadwalan periodik dan sebuah node menggunakan select untuk mengkueri data dari tabel tersebut, Anda harus menghapus secara manual dependensi node hulu yang dihasilkan secara otomatis dari pernyataan select. Tabel yang tidak diproduksi oleh penjadwalan periodik mencakup:
Tabel yang diunggah ke DataWorks dari sumber lokal
Tabel dimensi
Tabel yang tidak diproduksi oleh penjadwalan DataWorks
Tabel yang diproduksi oleh task manual
Bagaimana cara menghapus tabel yang tidak memerlukan dependensi?
Klik kanan nama tabel di kode dan pilih Delete Output, lalu jalankan parsing otomatis lagi. Tambahkan anotasi --@exclude_input=table_name di baris pertama editor kode untuk mengecualikan dependensi input tertentu (misalnya, --@exclude_input=xc_dw_user_info_all_d). Kemudian, klik kanan di editor dan pilih Delete Output untuk menghapus dependensi output yang tidak diperlukan. Klik tombol Parse Inputs and Outputs di panel pengaturan penjadwalan di sebelah kanan untuk melakukan parsing ulang dependensi penjadwalan. Di tabel dependensi penjadwalan, Anda dapat melihat nama output dari node induk saat ini, sumbernya (ditambahkan secara manual atau hasil parsing otomatis), dan informasi lainnya. Anda juga dapat mengklik Delete di kolom Actions untuk menghapus dependensi yang sesuai.
Error pengiriman: Output node induk yang menjadi dependensi node saat ini tidak ada
Saat Anda mengirimkan node, sistem menampilkan error yang menyatakan bahwa output node induk yang menjadi dependensi node saat ini tidak ada. Untuk kemungkinan penyebab dan solusinya, lihat Memecahkan masalah error output node induk tidak ada.
Prompt pengiriman: Input dan output tidak sesuai dengan analisis lineage kode
Saat Anda mengirimkan node, sistem menampilkan prompt yang menyatakan bahwa input dan output tidak sesuai dengan analisis lineage kode. Untuk kemungkinan penyebab dan solusinya, lihat Memecahkan ketidaksesuaian antara input/output dan analisis lineage kode.
Mengapa nama node induk hasil parsing otomatis melaporkan bahwa output (tabel) node induk yang menjadi dependensi tidak ada?
Saat Anda mengirimkan node di Data Studio, muncul error di bagian atas panel konfigurasi dependensi node: Output node induk yang menjadi dependensi workshop_yanshi.tb_2 tidak ada. Anda tidak dapat mengirimkan node ini. Kirimkan terlebih dahulu node induknya. Dependensi ini dihasilkan secara otomatis oleh sistem dari pernyataan FROM tb_2 dalam kode SQL.
Error ini bukan berarti tabel tersebut tidak ada. Artinya, sistem tidak dapat menemukan node yang memproduksi data tabel tersebut untuk membentuk dependensi antar node.
Masalah ini dapat terjadi karena dua alasan berikut:
Node hulu belum dikirimkan. Kirimkan node tersebut dan coba lagi.
Node hulu telah dikirimkan, tetapi nama outputnya bukan workshop_yanshi.tb_2.
Jika tb_2 adalah tabel yang diproduksi oleh task sinkronisasi, tambahkan secara manual sebagai output node dalam format
projectname.tablenamedi bagian output node task sinkronisasi yang memproduksi tabel tb_2. Untuk informasi lebih lanjut, lihat Mengonfigurasi dependensi penjadwalan.Jika tb_2 adalah tabel yang tidak diperbarui oleh node terjadwal setiap hari, klik kanan tabel tersebut di kode untuk menghapus inputnya, lalu jalankan parsing otomatis lagi.
Untuk tabel yang tidak diperbarui setiap hari oleh node terjadwal, lihat Pada skenario apa dependensi penjadwalan tidak didukung?
Mengapa beberapa node memiliki nama dan ID node turunan di bagian output node, sedangkan yang lain kosong dan tidak dapat diedit secara manual?
Dependensi node ditentukan oleh node hilir yang mereferensikan output node hulu. Jika node saat ini tidak memiliki node anak hilir, bagian ini akan kosong. Setelah node anak dikonfigurasi di hilir node ini, kontennya akan diurai dan ditampilkan secara otomatis.
Bagaimana cara menghapus dependensi yang tidak diperlukan?
Klik kanan tabel di kode dan hapus inputnya, lalu pilih parsing otomatis lagi untuk mengecualikan node dependensi hulu yang tidak diperlukan.
Konsep utama
Dalam sistem penjadwalan DataWorks, dependensi hulu-turunan antar node dikonfigurasi untuk memastikan produksi dan pengambilan data yang efektif. Penentuan apakah perlu mengonfigurasi dependensi dapat didasarkan pada seberapa kuat korelasi datanya. Untuk informasi lebih lanjut, lihat Mengonfigurasi dependensi penjadwalan.
Konsep utama
Nama output node digunakan untuk membentuk dependensi antar node. Misalnya, jika nama output node A adalah ABC dan node B menggunakan ABC sebagai inputnya, maka hubungan hulu-turunan terbentuk antara node A dan node B.
Apakah sebuah node dapat memiliki beberapa nama output?
Ya. Output node berfungsi sebagai pengenal node saat ini. Jika node turunan perlu bergantung pada node saat ini, node tersebut dapat mereferensikan nama output mana pun dari node ini sebagai nama output node induk untuk membentuk dependensi.
Jika beberapa node menulis data ke tabel yang sama, parsing otomatis melaporkan error bahwa nama output node-nya sama. Apakah node boleh memiliki nama output yang sama?
Tidak. Nama output node, seperti halnya node dan tabel, harus unik di tingkat penyewa. Hal ini memastikan bahwa parsing otomatis dapat menemukan node unik berdasarkan output unik untuk membentuk dependensi antar node. Jika dalam skenario Anda beberapa node memproduksi data untuk tabel yang sama, Anda perlu menentukan node mana yang harus menjadi dependensi node turunan saat melakukan parsing otomatis terhadap tabel ini (yaitu node yang menulis data ke tabel terakhir, sehingga memastikan pengambilan data yang benar oleh node turunan). Anda juga harus mengubah output node lainnya untuk memastikan keunikan.
Jika dua node terjadwal dalam ruang kerja yang sama melakukan insert data ke tabel yang sama, parsing otomatis menyebabkan salah satu node menghasilkan error berikut: Nama output node ${nodename1} di ruang kerja ${projectname} sama dengan node ${nodename2} di ruang kerja ${projectname}: ${node_outputname}. Beberapa node tidak dapat menggunakan nama output yang sama.
Bagaimana cara mencegah tabel antara diparsing saat menggunakan parsing otomatis?
Pilih nama tabel antara di kode SQL, klik kanan, lalu pilih Delete Input atau Delete Output, lalu jalankan parsing ulang untuk input dan output.
Bagaimana cara mengonfigurasi node induk untuk node paling hulu dalam alur kerja?
Jika node tersebut merupakan node awal dari alur kerja, Anda dapat menambahkan node virtual sebagai node awal alur kerja. Hulu dari node virtual dapat diatur ke node root ruang kerja. Untuk informasi lebih lanjut tentang penggunaan node virtual, lihat Menggunakan node virtual.
Mengapa node A menemukan nama output node B yang tidak ada saat mencari nama output node hulu?
Parsing dependensi didasarkan pada informasi node yang telah dikirimkan dan dideploy. Jika Anda menghapus nama output node B setelah dikirimkan tanpa mengirimkan perubahan tersebut ke sistem penjadwalan, nama output node B yang telah dihapus tersebut masih dapat ditemukan saat melakukan pencarian dari node A.
Mengapa sistem melaporkan bahwa node saat ini memiliki node anak dan tidak dapat di-undeploy, meskipun tidak ada dependensi yang ditampilkan di pengaturan penjadwalan?
Sebuah node hanya dapat di-undeploy jika tidak ada node lain yang bergantung padanya baik di lingkungan pengembangan maupun lingkungan produksi. Anda dapat memverifikasi hal ini dengan memeriksa di Operation Center lingkungan pengembangan dan Operation Center lingkungan produksi.
Mengapa beberapa garis dependensi berupa garis putus-putus di Operation Center?
Garis putus-putus menunjukkan dependensi lintas siklus. Untuk informasi lebih lanjut tentang dependensi lintas siklus, lihat Dependensi lintas siklus.
Konsep utama
Dampak pada node saat ini: Instans siklus berikutnya dari node hulu hanya mulai berjalan setelah instans siklus sebelumnya berhasil dijalankan.
Skenario: Asumsikan task per jam dijadwalkan mulai pukul 00:00. Instans pukul 01:00 harus menunggu instans pukul 00:00 berhasil dijalankan sebelum dapat dimulai.
Dampak pada node turunan: Asumsikan node turunan adalah task terjadwal harian. Node harian turunan berubah dari langsung bergantung pada beberapa instans per jam menjadi langsung bergantung pada instans per jam tertentu dari node hulu. Karena self-dependency dikonfigurasi untuk instans per jam, task harian turunan secara tidak langsung bergantung pada semua instans per jam hulu.
Bagaimana cara mengonfigurasi dependensi ketika task harian bergantung pada task per jam dalam berbagai skenario?
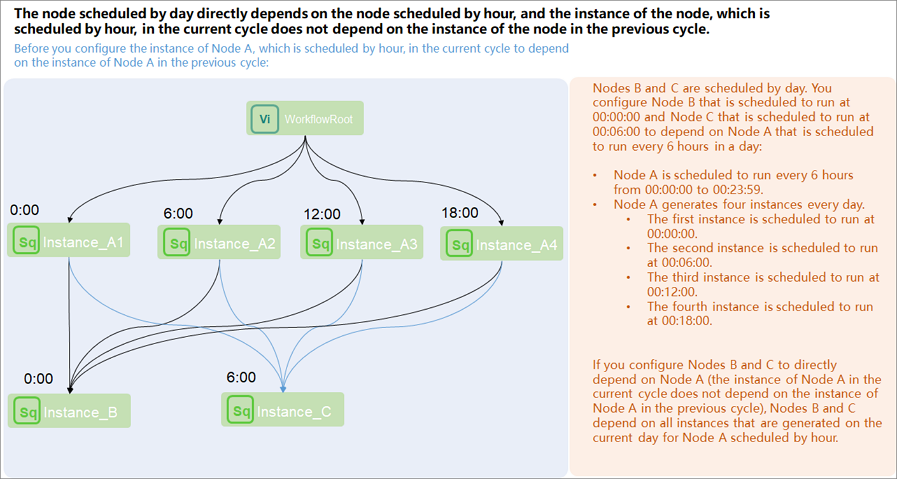
Skenario 1: Task harian bergantung pada semua instans per jam dari task per jam pada hari yang sama.
Saat task harian langsung bergantung pada task per jam, task tersebut bergantung pada semua instans task per jam pada hari yang sama.
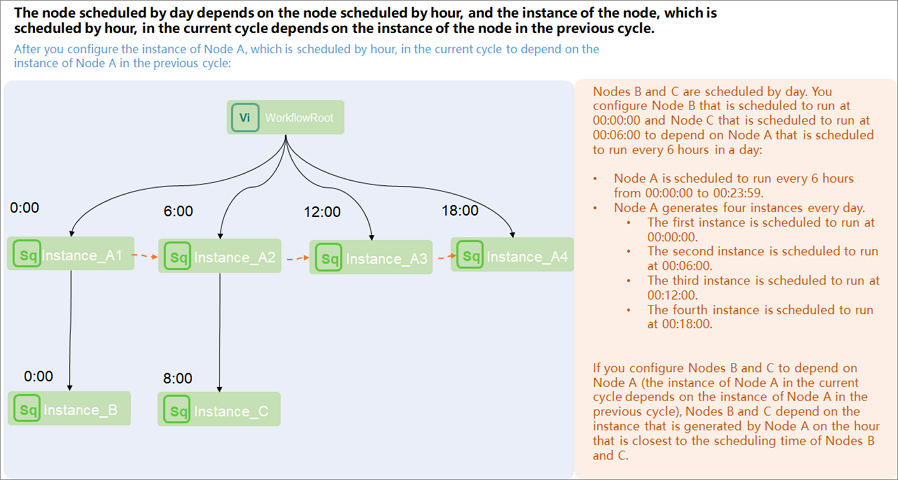
Skenario 2: Task harian bergantung pada instans per jam tertentu pada hari yang sama.
Konfigurasi task per jam: Konfigurasikan self-dependency untuk task per jam. Di pengaturan penjadwalan task per jam, pilih node saat ini sebagai dependensi siklus sebelumnya.
Konfigurasi task harian: Task harian langsung bergantung pada task per jam. Konfigurasikan task per jam sebagai input (node hulu yang menjadi dependensi) dari task harian.
Skenario 3: Task harian bergantung pada semua instans per jam dari task per jam pada hari sebelumnya.
Konfigurasikan dependensi lintas siklus dari task harian ke task per jam. Pada pengaturan penjadwalan task harian, pilih Previous-cycle Scheduling Dependency, lalu pilih Custom dan masukkan ID node task per jam.
Hapus dependensi siklus yang sama terhadap task per jam dari pengaturan penjadwalan task harian. Pada bagian dependensi siklus yang sama (Parent Nodes), hapus dependensi tersebut.
Jika Anda telah mengonfigurasi dependensi lintas siklus pada task per jam untuk task harian, pastikan dependensi siklus yang sama telah dihapus. Jika tidak, task harian akan bergantung pada semua instans per jam hari ini dan semua instans per jam hari sebelumnya.
Kapan task harian berjalan jika langsung bergantung pada task per jam?
Cara kerja: Saat task harian langsung bergantung pada task per jam, task harian tersebut bergantung pada semua instans task per jam pada hari yang sama. Task harian hanya mulai berjalan setelah instans per jam terakhir hari tersebut berhasil dijalankan.
Skenario:
Asumsikan task per jam dijadwalkan mulai pukul 00:00, berjalan sekali setiap jam. Task harian harus menunggu ke-24 instans per jam selesai sebelum dapat dimulai.
Menampilkan dependensi di Operation Center: Mengklik kanan task harian untuk melihat node induk menunjukkan bahwa task tersebut bergantung pada semua instans task per jam pada hari yang sama, artinya bergantung pada 24 instans per jam. (garis dependensi: solid)
Saat task harian bergantung pada task per jam, bagaimana cara membuat task harian bergantung pada instans per jam tertentu, bukan semua instans per jam?
Cara kerja: Untuk membuat task harian bergantung pada instans per jam tertentu pada hari yang sama, konfigurasikan self-dependency untuk task per jam dan atur waktu terjadwal task harian agar sesuai dengan instans per jam tertentu tersebut.
Skenario: Saat task harian perlu bergantung pada instans per jam yang dijadwalkan pukul 12:00 pada hari yang sama
Konfigurasi dependensi:
Konfigurasi task per jam hulu: Konfigurasikan self-dependency untuk task per jam. Di Scheduling Settings, di bagian Time attribute, pilih .
Konfigurasi task harian turunan: Atur waktu terjadwal task harian menjadi pukul 12:00.
Menampilkan dependensi di Operation Center:
Mengklik kanan instans harian untuk melihat node induk menunjukkan bahwa instans tersebut bergantung pada instans per jam yang dijadwalkan pukul 12:00 pada hari yang sama. (garis dependensi: solid)
Mengklik kanan instans per jam untuk melihat node induk menunjukkan bahwa node induk hulunya adalah instans per jam sebelumnya. Instans pukul 12:00 bergantung pada instans pukul 11:00. (garis dependensi: dashed, karena task per jam memiliki dependensi lintas siklus yang dikonfigurasi dengan item dependensi diatur ke node saat ini)
Saat task harian bergantung pada task per jam, bagaimana cara membuat task harian bergantung pada semua instans per jam dari hari sebelumnya, bukan hari ini?
Cara kerja: Untuk membuat task harian bergantung pada semua instans per jam dari hari sebelumnya, konfigurasikan dependensi lintas siklus pada task per jam untuk task harian.
Skenario: Task harian perlu bergantung pada semua instans per jam dari hari sebelumnya.
Konfigurasi dependensi:
Konfigurasi task harian turunan: Konfigurasikan dependensi lintas siklus pada task per jam. Di Scheduling Settings, di bagian Time attribute, pilih dan masukkan ID node.
Konfigurasi task per jam hulu: Tidak diperlukan konfigurasi.
Menampilkan dependensi di Operation Center:
Mengklik kanan instans harian turunan untuk melihat node induk menunjukkan bahwa instans tersebut bergantung pada semua instans per jam dari task per jam pada hari sebelumnya. (garis dependensi: dashed, karena task harian memiliki dependensi lintas siklus yang dikonfigurasi pada task per jam)
Kapan saya harus mengonfigurasi item dependensi siklus sebelumnya sebagai node saat ini?
Skenario bisnis: Jika node saat ini memerlukan data yang diproduksi oleh node yang sama pada siklus sebelumnya, Anda dapat mengonfigurasi self-dependency untuk node saat ini. Artinya, instans siklus berikutnya dari node saat ini hanya mulai berjalan setelah instans siklus sebelumnya selesai, sehingga mencegah pengambilan data saat instans siklus sebelumnya masih berjalan (data belum diproduksi).
Jika node saat ini bergantung pada data yang diproduksi oleh dirinya sendiri pada siklus sebelumnya dan Anda perlu memastikan waktu kapan siklus sebelumnya memproduksi data, buka task tersebut dan konfigurasikan .
Jika task per jam bergantung pada task harian, dan task per jam turunan memiliki beberapa siklus yang waktu terjadwalnya telah lewat saat task harian hulu selesai berjalan, task per jam tersebut mungkin berjalan secara konkuren untuk beberapa siklus. Dalam kasus ini, buka task tersebut dan konfigurasikan .
Bagaimana cara mengonfigurasi dependensi ketika node turunan bergantung pada beberapa task secara bersamaan?
Jika node turunan dikonfigurasi untuk bergantung pada beberapa task, Anda perlu membuat pertimbangan bisnis apakah semua dependensi tersebut diperlukan. Jika data tabel memiliki korelasi yang kuat, kami menyarankan Anda mengonfigurasi semua node sebagai dependensi. Untuk informasi tentang apakah perlu mengonfigurasi dependensi antar node, lihat Mengapa saya perlu mengonfigurasi dependensi penjadwalan.
Sebagai contoh, node turunan C bergantung pada task harian B dan task per jam A pada hari yang sama. Task per jam A menghasilkan tabel A, dan task harian B menghasilkan tabel B. Node turunan C memerlukan data dari kedua tabel tersebut.
Asumsikan node turunan C mengkueri data dari tabel A dan tabel B. Jika Anda hanya mengonfigurasi task per jam A sebagai Parent Nodes tanpa mengonfigurasi task harian B sebagai Parent Nodes, node turunan C mungkin mulai berjalan sebelum task harian hulu B selesai. Hal ini menyebabkan kegagalan saat mengambil data dari tabel output B task harian. Oleh karena itu, dalam contoh ini, Anda perlu mengonfigurasi baik task harian maupun task per jam sebagai Parent Nodes dari node turunan C.
Jika node turunan tidak memiliki dependensi yang kuat pada tabel hulu, artinya node turunan dapat mengambil data dari tabel hulu kapan saja tanpa masalah (bahkan jika node hulu belum memproduksi data terbaru), Anda tidak perlu mengonfigurasi dependensi antar node.
Jika task hulu A adalah task per jam dan task turunan B adalah task harian yang berjalan sekali setelah semua instans task A selesai, apakah task harian tetap berjalan jika task per jam berjalan hingga hari berikutnya? Apakah parameter penjadwalan terpengaruh?
Task harian B langsung bergantung pada semua instans task per jam A pada hari yang sama. Task harian B mengagregasi data task per jam untuk hari yang sama. Jika task per jam menyelesaikan instans terakhirnya setelah tengah malam (hari berikutnya), task harian turunan tetap berjalan. Hanya waktu eksekusi yang berbeda; substitusi parameter penjadwalan tidak terpengaruh.
Node A berjalan setiap jam tepat setiap hari, dan node B berjalan sekali sehari. Bagaimana cara membuat node B mulai berjalan setelah node A berhasil dijalankan untuk pertama kalinya setiap hari?
Saat mengonfigurasi node A, pilih Previous-cycle Scheduling Dependency dan pilih Current Node. Atur waktu terjadwal node B menjadi pukul 00:00. Dalam instans terjadwal otomatis harian, instans node B hanya bergantung pada instans node A yang dihasilkan pukul 00:00, yaitu instans pertama node A.
Terdapat tiga task A, B, dan C. Bagaimana cara menjalankan A->B->C setiap jam (B mulai setelah A selesai, dan C mulai setelah B selesai)?
Konfigurasi dependensi: Atur hubungan dependensi sehingga output A berfungsi sebagai input B, dan output B berfungsi sebagai input C.
Konfigurasi frekuensi penjadwalan: Karena penjadwalan dikonfigurasi di tingkat node, ketiga node A, B, dan C harus diatur penjadwalannya menjadi per jam.
Bagaimana cara mengonfigurasi dependensi lintas alur kerja dan lintas proyek dalam Wilayah yang sama?
Cara kerja: Output dari node hulu berfungsi sebagai input dari node turunan untuk membentuk dependensi antar node. Tambahkan output dari node yang ingin Anda jadikan dependensi (lintas proyek atau lintas alur kerja) ke bagian input dari node yang memerlukan dependensi tersebut.
Task yang dikonfigurasi dengan rerun saat gagal tidak dijalankan ulang setelah gagal, dan melaporkan error: Task Run Timed Out, Killed by System!!
Pesan error:
Saat Scheduling Settings > Time attribute > Rerun dari task target diatur ke Allow Regardless of Running Status atau Allow upon Failure Only, task tidak dijalankan ulang setelah gagal dan menghasilkan error
Task Run Timed Out, Killed by System!.Kemungkinan penyebab:
Scheduling Settings > Time attribute dari task ini memiliki konfigurasi Timeout. Saat durasi task melebihi periode timeout, task secara otomatis dihentikan. Task yang gagal karena timeout tidak memicu mekanisme rerun.
Solusi:
Saat task gagal karena timeout, mekanisme rerun saat gagal tidak berlaku. Anda harus menjalankan ulang task tersebut secara manual.