Ketika penggunaan CPU melonjak di lingkungan produksi, mengidentifikasi metode yang bertanggung jawab hanya berdasarkan metrik saja bisa jadi sulit. Application Real-Time Monitoring Service (ARMS) secara terus-menerus memprofilkan thread CPU aktif dengan mengambil snapshot stack tingkat metode pada interval reguler. Snapshot tersebut diagregasikan menjadi flame graph dan statistik tingkat metode, sehingga dapat menunjukkan secara tepat jalur kode mana yang paling banyak mengonsumsi siklus CPU.
Mengaktifkan diagnostik CPU menambahkan beban sekitar 5% pada CPU. Pastikan instans Anda memiliki ruang kapasitas yang cukup sebelum mengaktifkannya.
Cara kerja flame graph
ARMS mengagregasikan snapshot stack hasil sampling menjadi flame graph yang menyandikan dua dimensi:
| Dimension | Meaning | How to read it |
|---|---|---|
| Width (X-axis) | Proporsi waktu CPU total yang dikonsumsi oleh suatu metode | Kotak yang lebih lebar = lebih banyak waktu CPU |
| Depth (Y-axis) | Hierarki panggilan — bagian bawah adalah titik masuk, bagian atas adalah metode daun | Perhatikan bagian atas graf untuk menemukan metode tempat siklus CPU benar-benar dihabiskan |
Posisi horizontal tidak merepresentasikan progresi waktu. Dua metode yang ditempatkan bersebelahan belum tentu dijalankan secara berurutan.
Self time vs. total time
Dua metrik membantu Anda membedakan antara metode yang mahal secara individual dan metode yang berkontribusi terhadap penggunaan CPU tinggi melalui metode anaknya:
| Metric | Definition | When to use |
|---|---|---|
| Self | Waktu atau sumber daya yang dikonsumsi oleh suatu metode dalam stack, tidak termasuk waktu atau sumber daya yang dikonsumsi oleh metode anak | Temukan metode yang mahal secara individual |
| Total | Waktu atau sumber daya yang dikonsumsi oleh suatu metode, termasuk waktu atau sumber daya yang dikonsumsi oleh semua metode anak | Temukan jalur panggilan yang paling banyak berkontribusi terhadap waktu CPU secara keseluruhan |
Self time = Total time – jumlah Total time dari semua anak. Sebagai contoh, jika suatu metode menunjukkan Total 309 ms dan satu-satunya anaknya menunjukkan Total 112 ms, maka Self time metode induk tersebut adalah 197 ms (309 – 112).
Aktifkan diagnostik CPU
Login ke Konsol ARMS. Di panel navigasi kiri, pilih Application Monitoring > Application List.
Di halaman Application List, pilih wilayah di bilah navigasi atas lalu klik nama aplikasi.
Ikon di kolom Language menunjukkan bahasa aplikasi:
 Java
 Go
 Python Hyphen (-): aplikasi yang dipantau melalui Managed Service for OpenTelemetry.
Di panel navigasi kiri, klik Application Settings. Klik tab Custom Configuration.
Di bagian Continuous profiling, aktifkan Main switch dan CPU hotspot, lalu tentukan alamat IP instans aplikasi atau Blok CIDR untuk beberapa instans.
Klik Save.
Perubahan berlaku langsung — tidak perlu restart aplikasi.
Identifikasi metode penyebab utama
Contoh berikut menggunakan metode Java yang melakukan busy-wait selama 500 milidetik untuk mensimulasikan konsumsi CPU yang berkelanjutan:
public class CPUPressure {

    // Loop busy-wait yang mempertahankan CPU selama 500 ms per pemanggilan
    public void runBusiness() {
        long start = System.currentTimeMillis(), period = 0;
        while (period <= 500L) {
            period = System.currentTimeMillis() - start;
        }
    }
}
Langkah 1: Buka tampilan profil
Login ke Konsol ARMS. Di panel navigasi kiri, pilih Application Monitoring > Application List.
Di halaman Application List, pilih wilayah di bilah navigasi atas lalu klik nama aplikasi.
Ikon di kolom Language menunjukkan bahasa aplikasi:
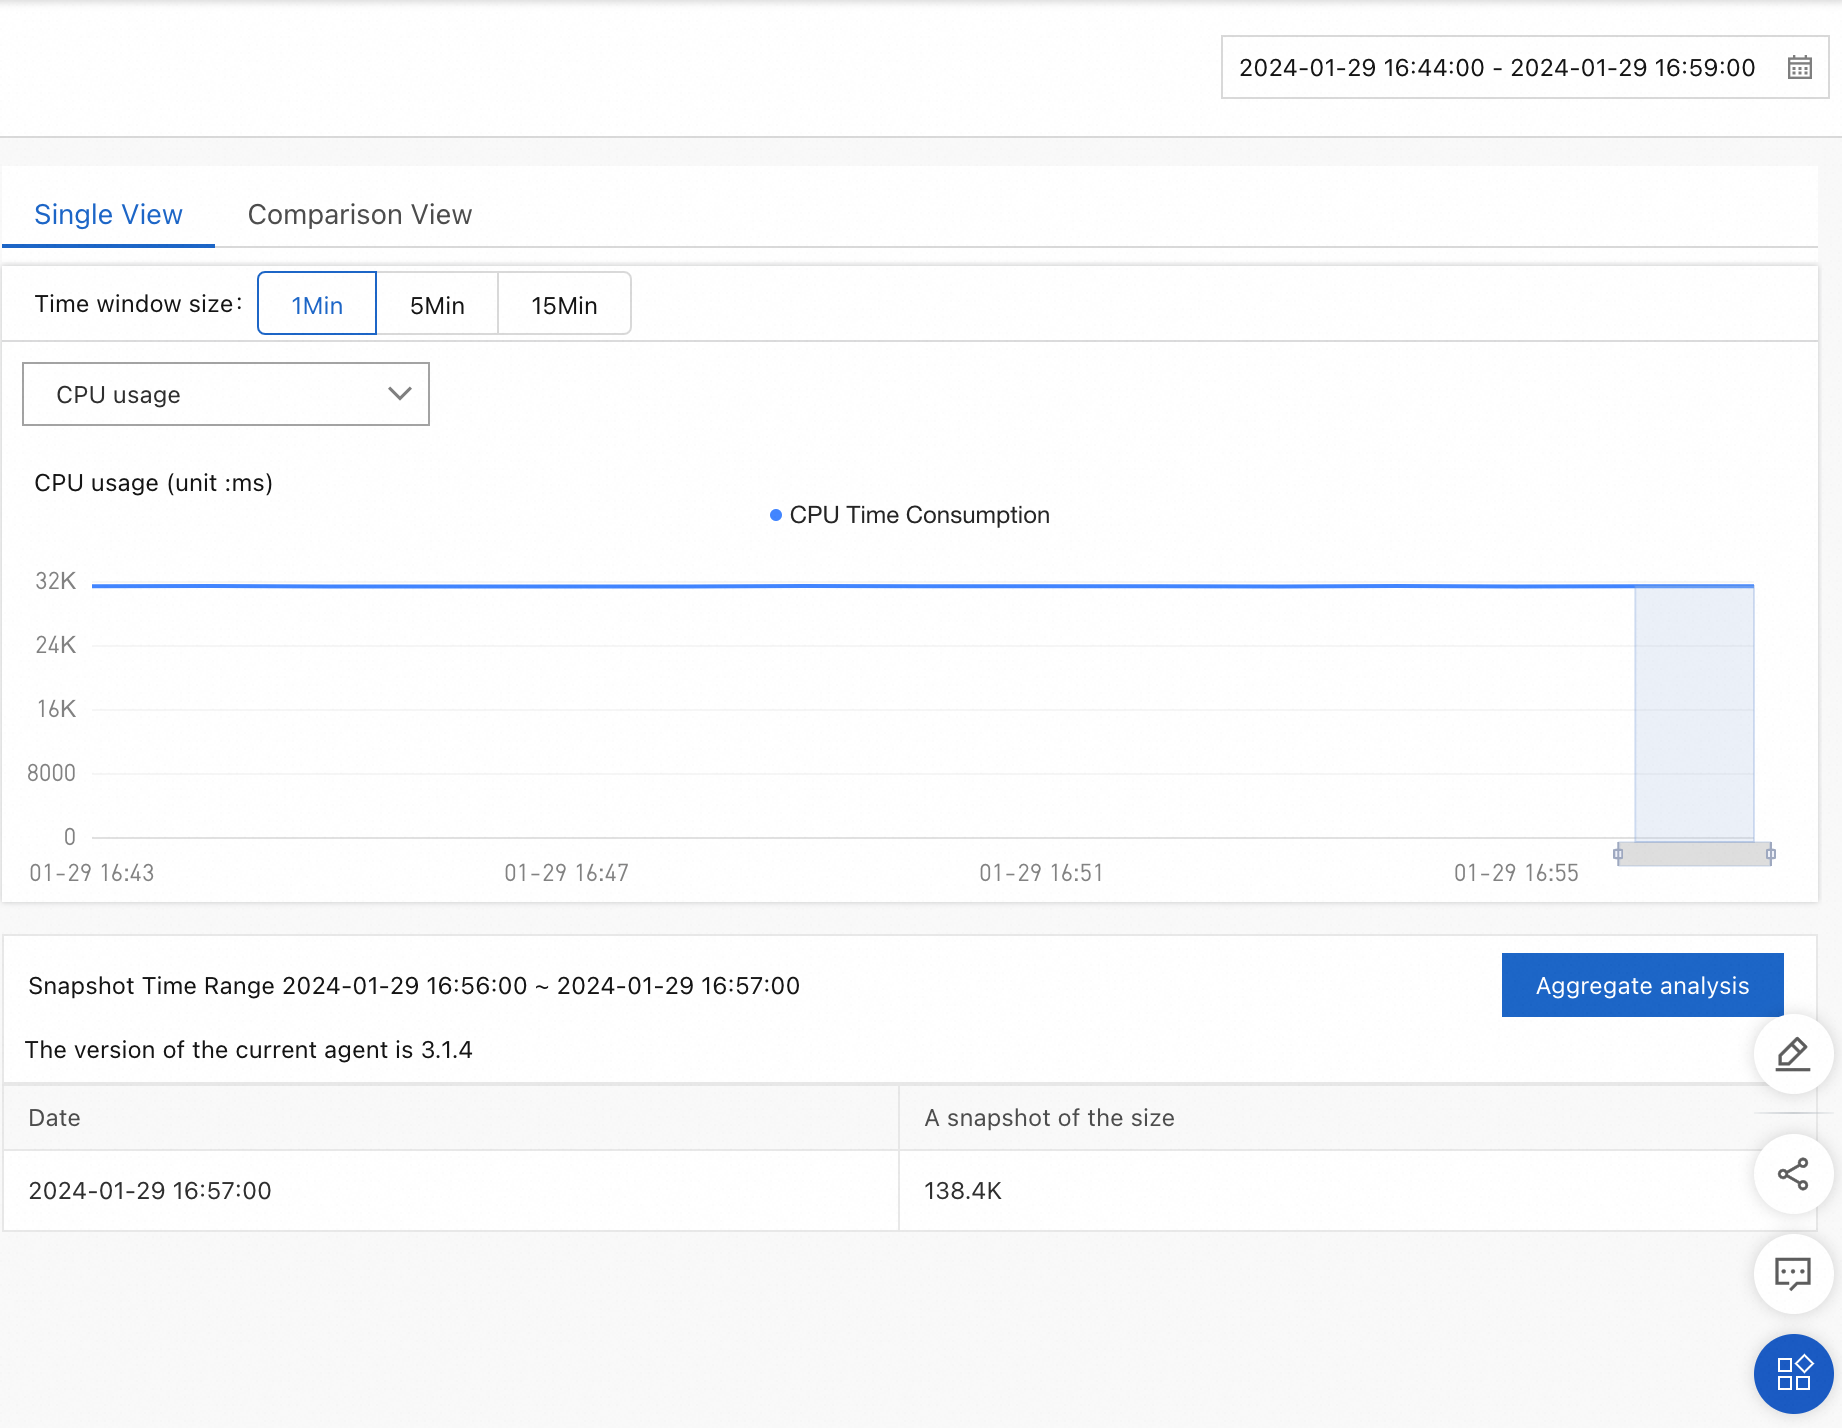
Java Go Python Hyphen (-): aplikasi yang dipantau melalui Managed Service for OpenTelemetry.Di panel navigasi kiri, klik Continuous profiling. Pilih instans target dan rentang waktu.
Di tab Single View, lakukan kueri data dan lihat hasil agregasi.
Terdapat tiga jenis profil yang tersedia:
CPU Time: Core CPU yang dikonsumsi oleh setiap metode.
Allocated Memory: Byte memori yang dialokasikan.
Allocations: Jumlah panggilan alokasi memori — berguna untuk mengidentifikasi metode yang sering melakukan alokasi.
Langkah 2: Temukan metode yang mahal
Klik Aggregation & Analysis. Atur Profiling Type ke CPU Time. Panel kiri menampilkan daftar semua metode yang terlibat dalam stack panggilan hasil sampling. Panel kanan menampilkan flame graph.
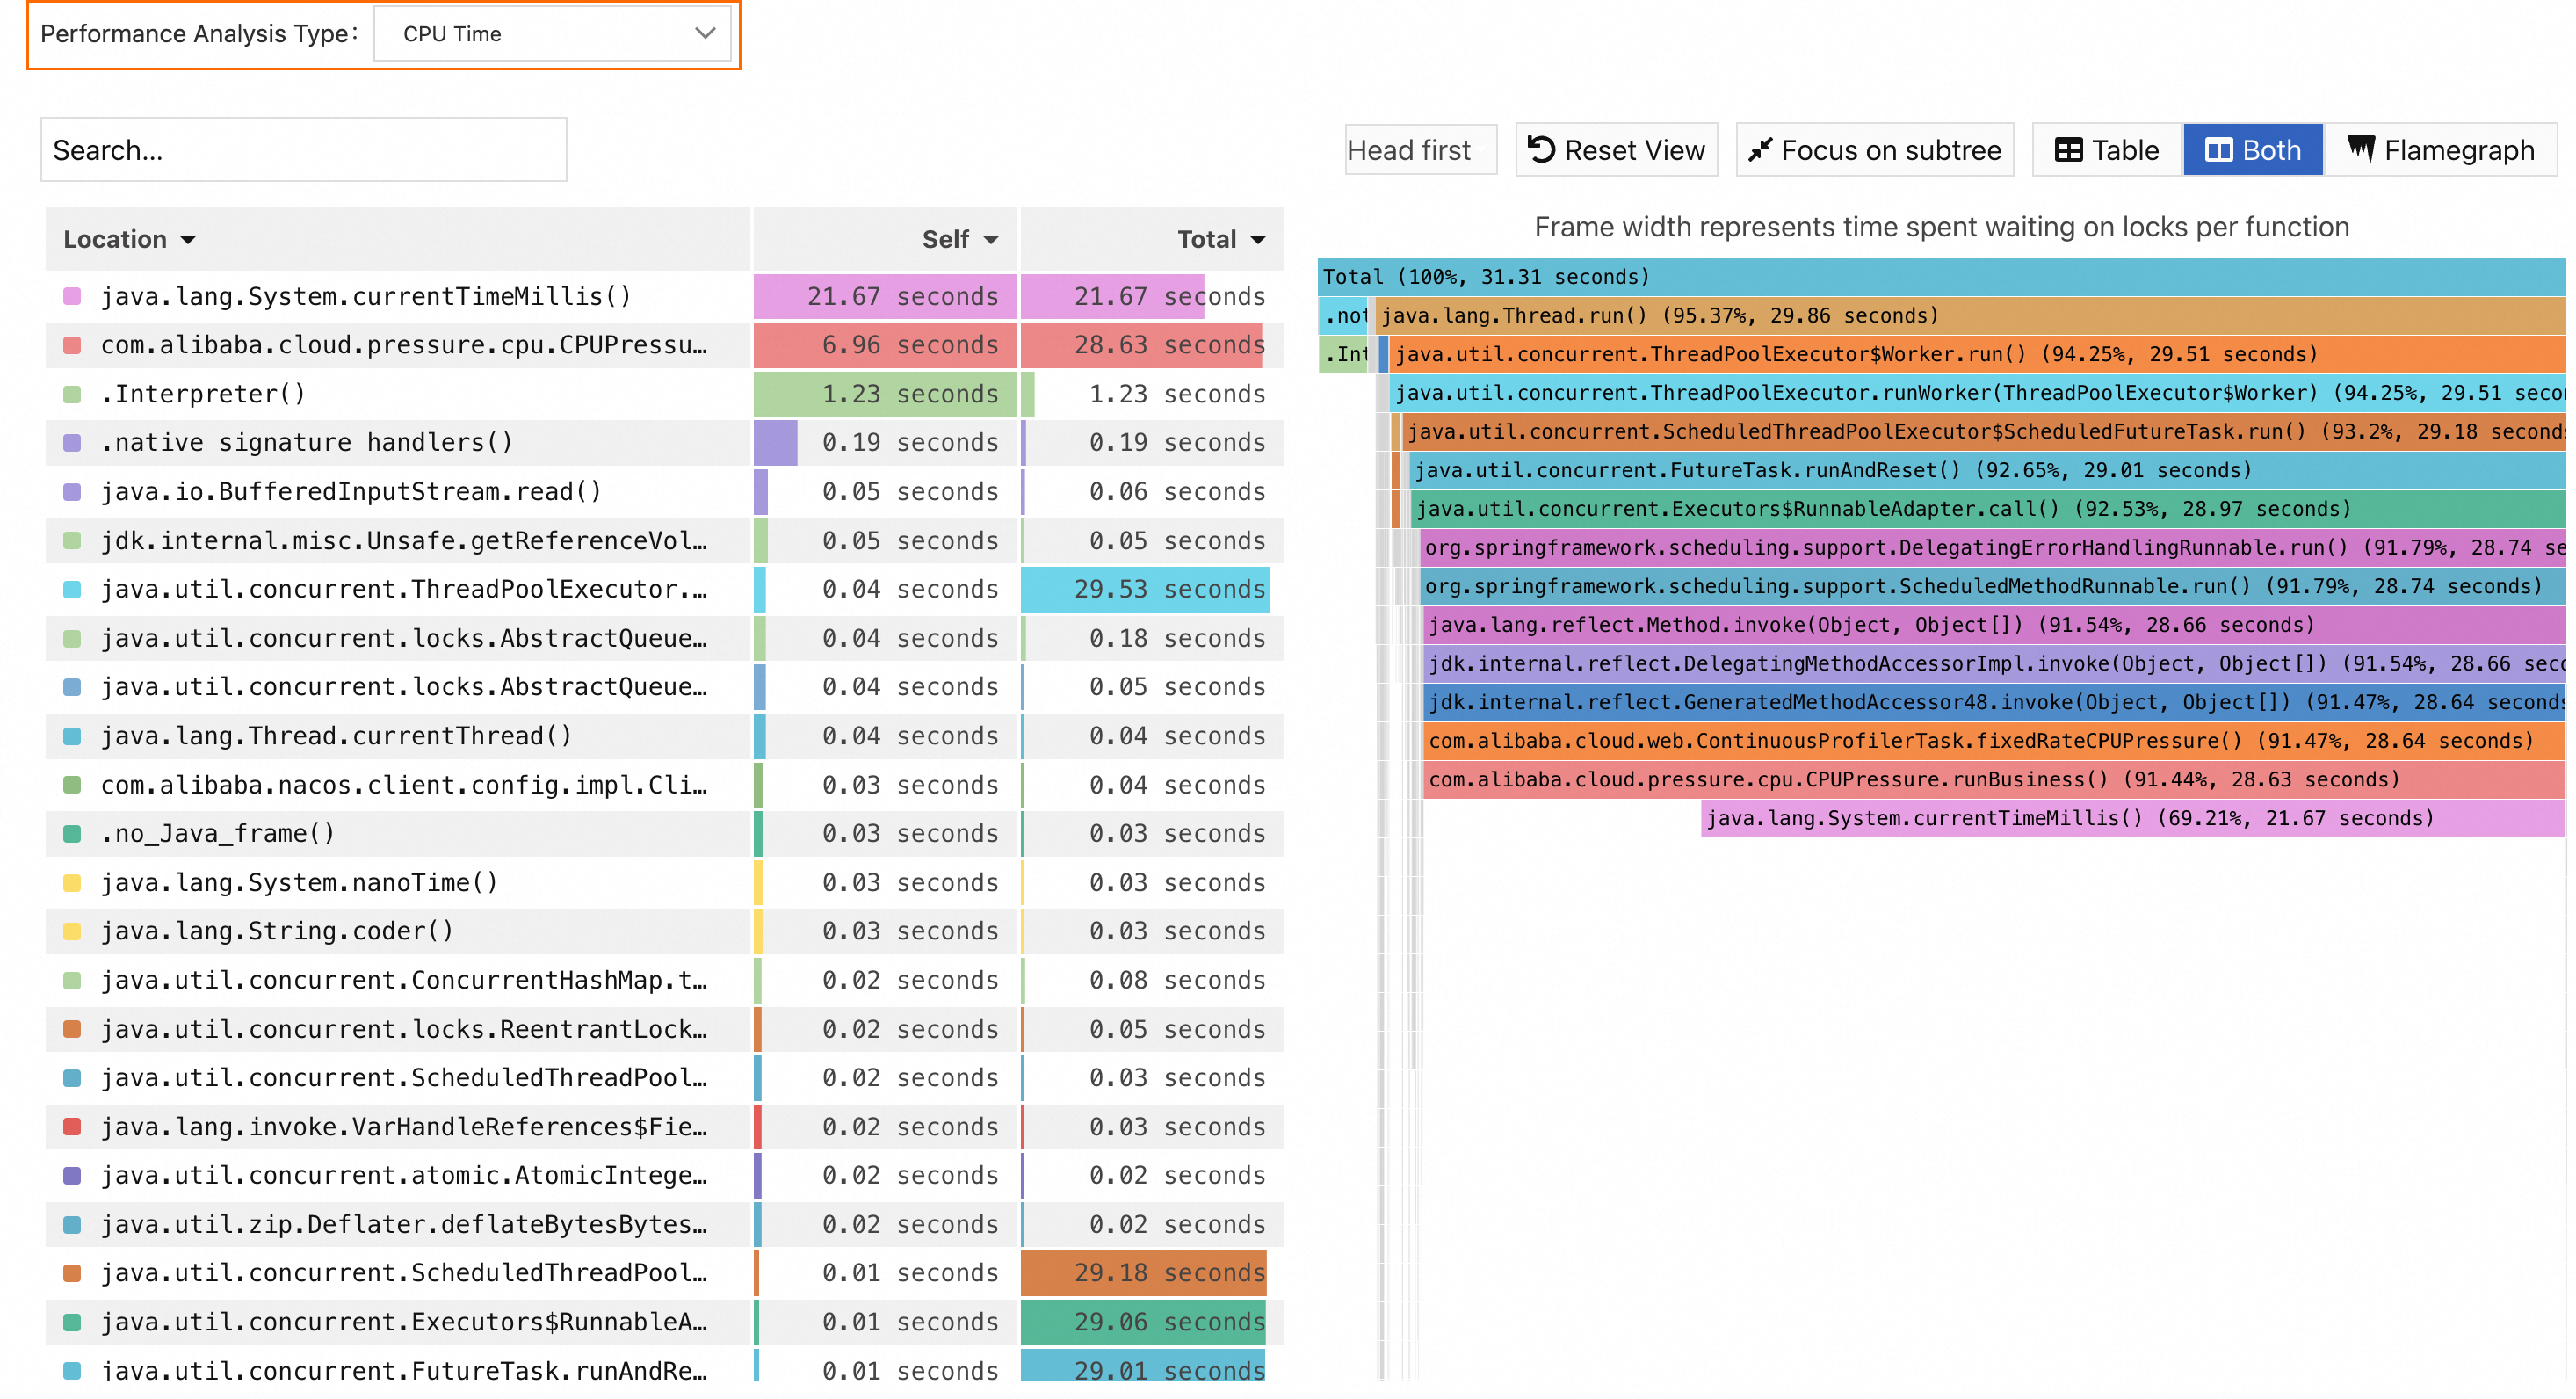
Urutkan kolom Self secara menaik. Cari dan klik metode dengan nilai Self terbesar. Dalam contoh ini,
java.lang.System.currentTimeMillis()muncul di posisi paling atas. Mengkliknya akan menyorot kotak yang sesuai pada graf flame.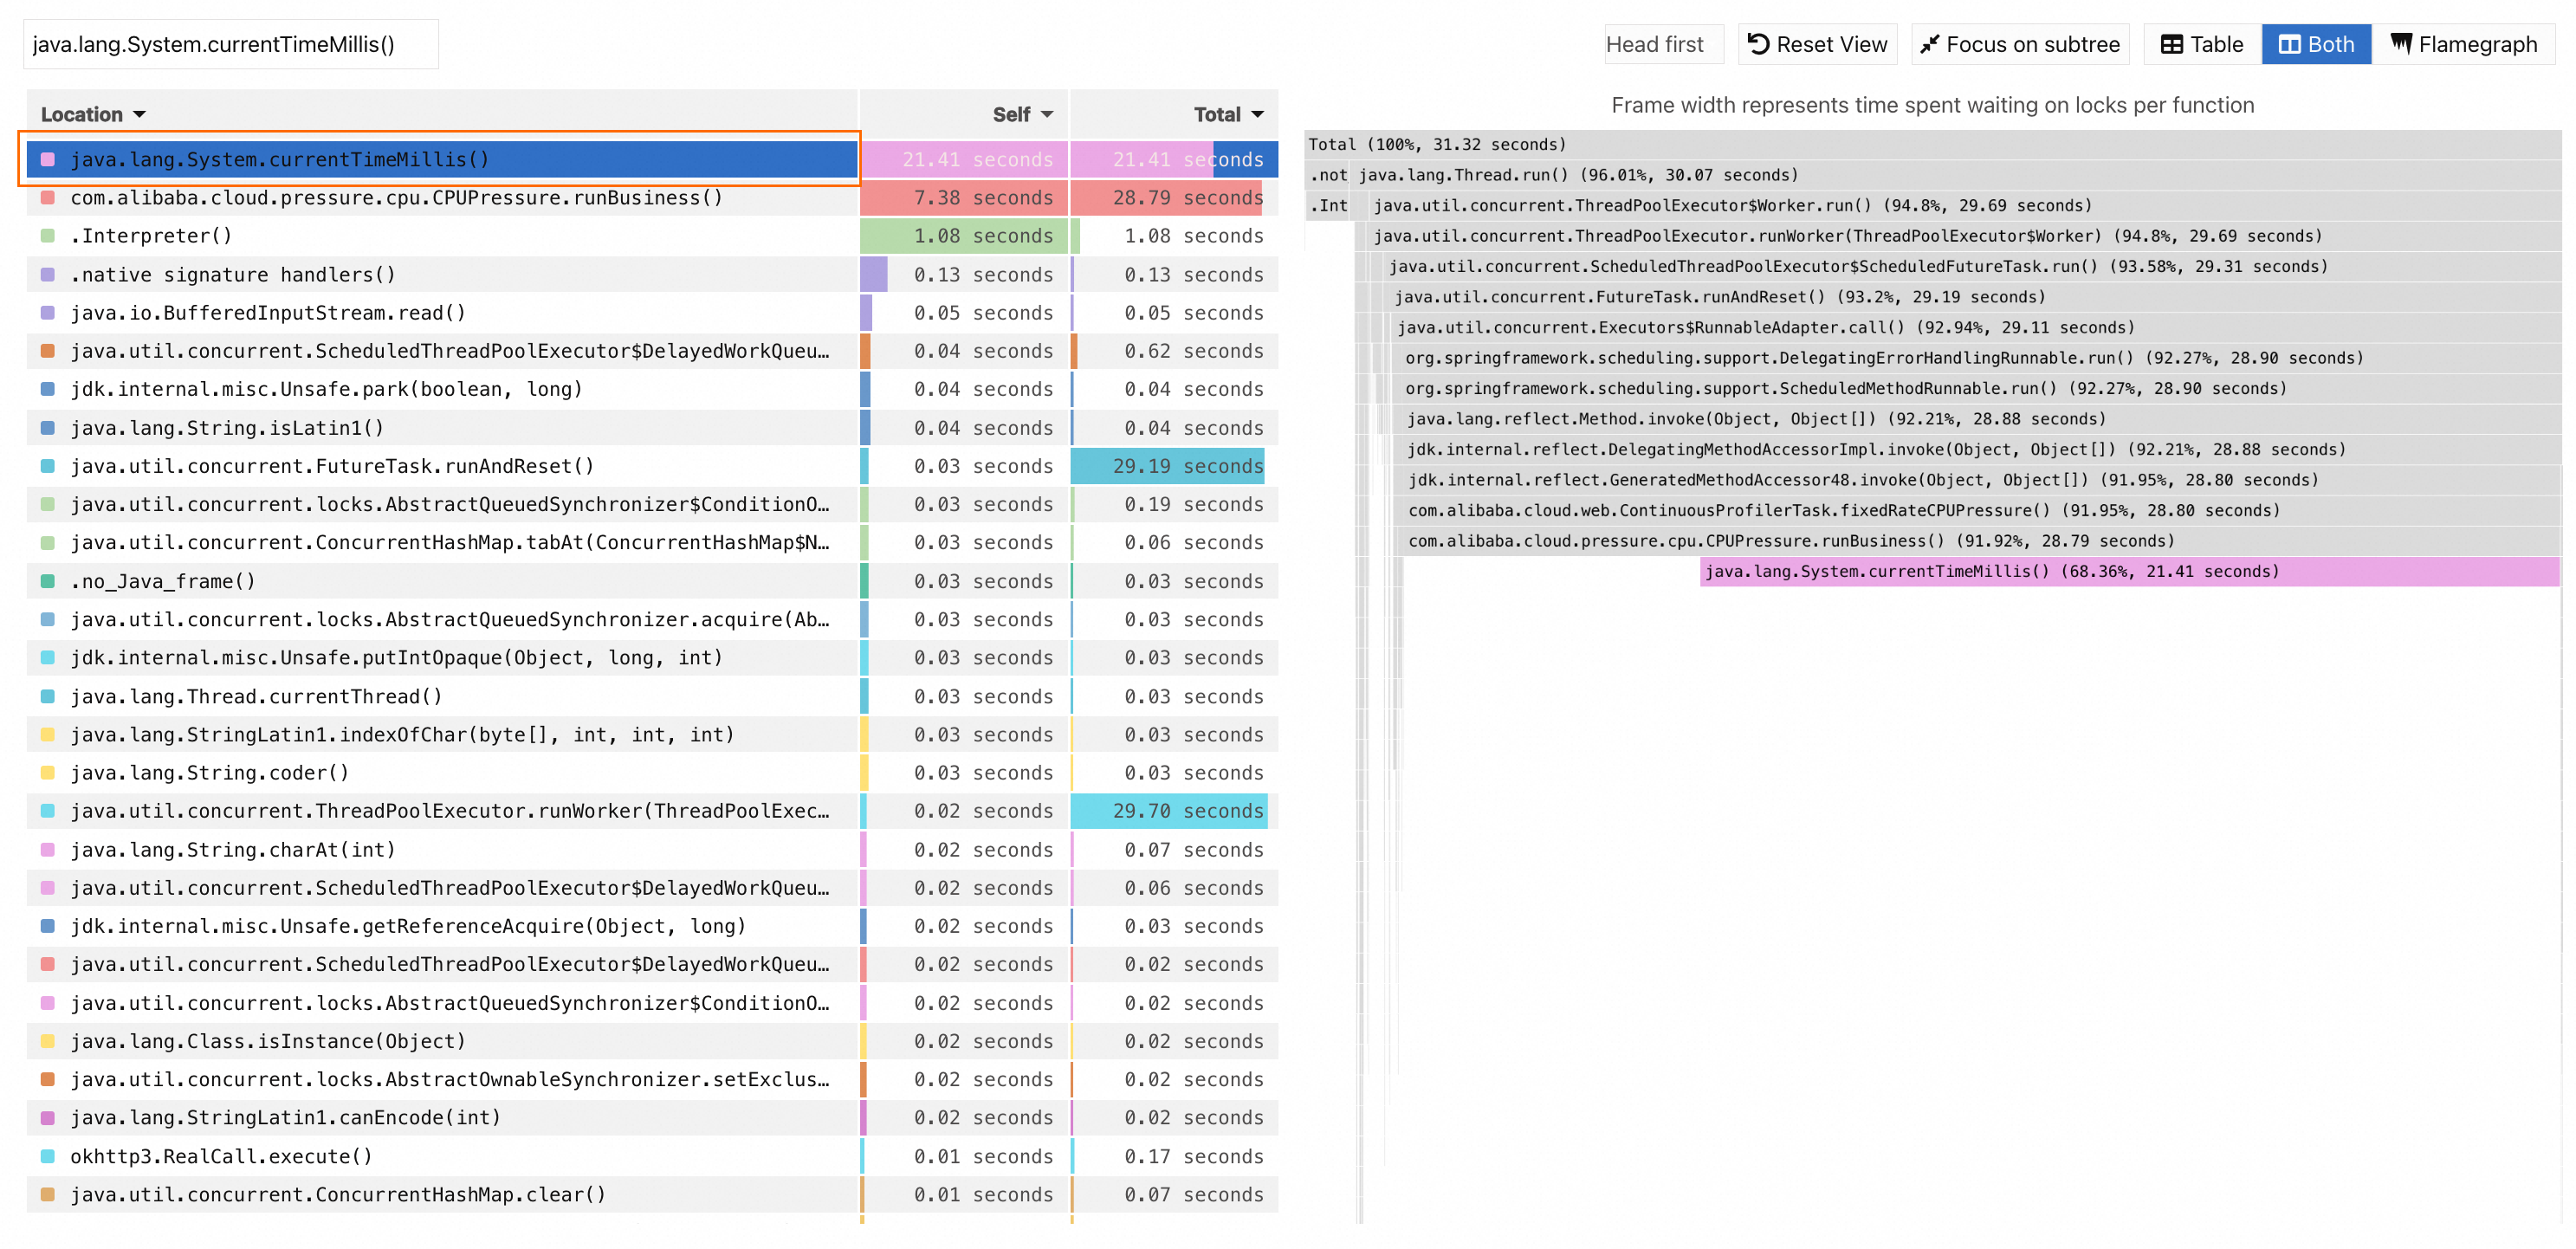
Konfirmasi di flame graph bahwa
currentTimeMillis()memiliki kotak paling lebar di bagian atas stack, artinya metode tersebut mengonsumsi Self time atau sumber daya paling banyak.
Langkah 3: Lacak kembali ke kode aplikasi
Karena currentTimeMillis() merupakan metode library JDK, lihat satu level di bawahnya dalam call stack untuk menemukan metode aplikasi yang memanggilnya: com.alibaba.cloud.pressure.memory.CPUPressure.runBusiness().
Metode ini mengonsumsi 28,63 detik dalam rentang waktu 1 menit, menyumbang 91,44% dari total waktu CPU. Hal ini sesuai dengan perilaku yang diharapkan — runBusiness() melakukan busy-wait selama 500 ms pada setiap pemanggilan, sehingga mendominasi penggunaan CPU saat beban tinggi.