Un index de recherche s'appuie sur des index inversés et des stockages en colonnes pour permettre des requêtes multidimensionnelles ainsi que des analyses statistiques sur les big data. Utilisez les index de recherche pour interroger des colonnes autres que la clé primaire, effectuer des requêtes booléennes ou floues, réaliser une recherche en texte intégral, exécuter une recherche vectorielle et appliquer des agrégations telles que max, min, count et group by.
Contexte
Les index de recherche s'appliquent uniquement aux modèles de table large .
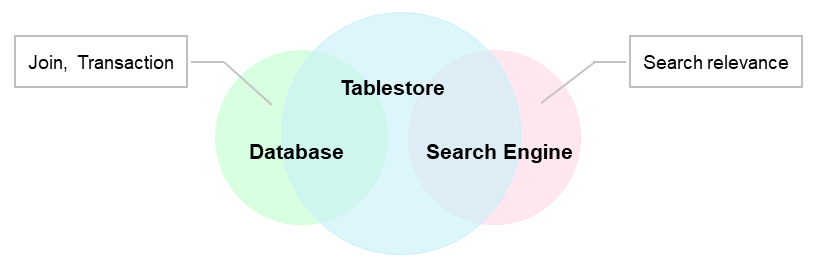
Les index de recherche, les bases de données et les moteurs de recherche répondent tous à des problématiques de requêtes complexes sur les big data, mais présentent les différences suivantes :
À l'exception des jointures, des transactions et de l'analyse de pertinence, Tablestore propose les fonctionnalités des bases de données et des systèmes de recherche. Il combine la fiabilité élevée des données d'une base de données avec les capacités de requête avancées d'un système de recherche, remplaçant ainsi l'architecture classique database + search engine.
Si votre scénario n'implique ni jointures, ni transactions, ni analyse complexe de pertinence, utilisez un index de recherche Tablestore.
Présentation des index
Un index de recherche utilise des index inversés et des stockages en colonnes pour résoudre les problèmes de requêtes multidimensionnelles et d'analyses statistiques sur les big data. Il prend en charge les requêtes sur les colonnes autres que la clé primaire, les requêtes par préfixe, les requêtes floues, les requêtes booléennes, les requêtes imbriquées, les requêtes géospatiales, la recherche en texte intégral, la recherche vectorielle et l'agrégation statistique (max, min, count, sum, avg, distinct_count, group_by, percentiles et histogram).
La figure suivante illustre les structures d'index inversé, de stockage en colonne et d'index spatial multidimensionnel utilisées par un index de recherche.
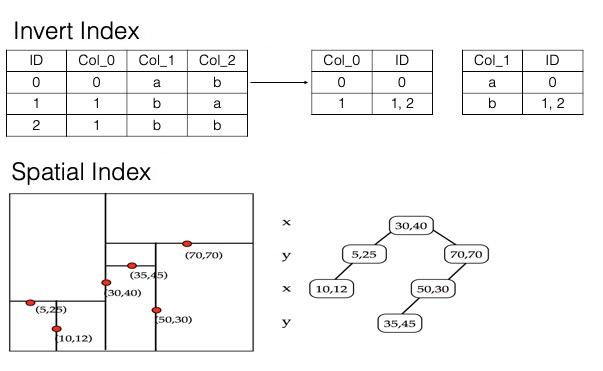
Contrairement aux index de base de données traditionnels (comme MySQL), un index de recherche n'est pas limité par la règle de correspondance du préfixe le plus à gauche. Dans la plupart des cas, un seul index de recherche par table suffit. Par exemple, une table d'étudiants comportant des colonnes telles que le nom, l'identifiant étudiant, le sexe, la note, la classe et l'adresse domicile ne nécessite qu'un seul index de recherche pour prendre en charge des requêtes combinées comme students named John Doe in the third grade, male students whose home address is within 1 km ou students in Class 2 of Grade 3 who live in a specific residential area.
Comparaison des index
Tablestore permet d'interroger les tables de données par clé primaire et propose deux types d'index pour accélérer les requêtes : l'index secondaire et l'index de recherche. Le tableau suivant compare ces trois méthodes de requête.
|
Méthode de requête |
Principe |
Scénario |
|
Clé primaire |
Une table de données fonctionne comme une grande carte. Vous ne pouvez interroger les données que par clé primaire. |
Convient aux scénarios où vous connaissez la clé primaire complète ou un préfixe de clé. |
|
Index secondaire |
Crée des tables d'index dont les colonnes de clé primaire étendent la capacité de requête de la table de données à différentes colonnes. |
Convient aux scénarios où les colonnes de requête sont prédéterminées, le nombre de colonnes est faible et vous connaissez la clé primaire complète ou un préfixe de clé. |
|
Index de recherche |
Utilise des structures telles que les index inversés, les arbres BKD et les stockages en colonnes pour offrir des capacités de requête riches. |
Convient à tous les scénarios de requête et d'analyse au-delà de la couverture de la clé primaire et de l'index secondaire : requêtes sur les colonnes autres que la clé primaire, requêtes booléennes sur n'importe quelle colonne, requêtes relationnelles, recherche en texte intégral, requêtes géospatiales, requêtes floues, requêtes imbriquées, requêtes sur les valeurs NULL et agrégation statistique. |
Scénarios
Les index de recherche sont largement utilisés pour l'interrogation et l'analyse des données dans les systèmes applicatifs. Le tableau suivant répertorie les scénarios courants.
|
Système applicatif |
Exemple de scénario |
|
Plateforme e-commerce |
Mettez en œuvre la catégorisation des produits et le filtrage par attributs pour aider les utilisateurs à rechercher et filtrer rapidement les produits. |
|
Application sociale |
Interrogez les relations de suivi et d'amitié entre utilisateurs, ou recommandez et associez des utilisateurs en fonction de tags d'intérêt. |
|
Analyse des journaux |
Effectuez des recherches par mot-clé et des requêtes par plage de temps pour localiser rapidement les problèmes et analyser les données de journal. |
|
Analytique des données IoT |
Interrogez et analysez les données des appareils. Par exemple, filtrez et comptez les données par type d'appareil ou par emplacement géographique. |
|
Surveillance des performances des applications |
Aggrégez et interrogez les données de métriques. Par exemple, filtrez et résumez les données par plage horaire ou par nom d'application. |
|
Service basé sur la localisation |
Effectuez des requêtes géospatiales et des recherches à proximité pour fournir des informations sur les commerces, attractions et services voisins. |
|
Moteur de recherche textuelle |
Effectuez une recherche en texte intégral et un tri par pertinence pour trouver rapidement des documents, articles et autres contenus. |
Fonctionnalités
Liste des fonctionnalités
Le tableau suivant répertorie les fonctionnalités des index de recherche.
|
Fonctionnalité |
Description |
Documentation |
|
Requête sur n'importe quelle colonne (y compris les colonnes de clé primaire et non-clé primaire) |
Interrogez les données par n'importe quelle colonne. Convient à la plupart des scénarios de requête. Si les requêtes par clé primaire ou par préfixe ne suffisent pas, créez un index de recherche avec les champs cibles et interrogez par valeurs de colonne. |
Toute requête d'index de recherche, telle qu'une requête de base |
|
Requête booléenne |
Combinez plusieurs champs pour un filtrage efficace. Convient aux systèmes de commande, à l'analyse des journaux et aux personas utilisateurs. Dans une base de données relationnelle, une table comportant des dizaines de champs peut nécessiter des centaines d'index pour couvrir toutes les combinaisons de champs. L'absence de certaines combinaisons entraîne des requêtes inefficaces. Avec Tablestore, un seul index de recherche couvre toutes les combinaisons de champs. Ajoutez les champs susceptibles d'être interrogés à l'index, puis combinez-les librement à l'aide de la logique And, Or et Not. |
|
|
Requête géospatiale |
Les appareils mobiles ont accru la valeur des données de localisation géographique. Les applications de réseautage social, de livraison de repas, de sport et l'Internet des véhicules (IoV) nécessitent tous des requêtes conscientes de la localisation. Les index de recherche prennent en charge les fonctionnalités de requête géospatiale suivantes :
Si votre application nécessite des requêtes basées sur la localisation, un index de recherche Tablestore offre une solution complète sans bases de données ou systèmes de recherche supplémentaires. |
|
|
Index en texte intégral |
Trouvez des données contenant une phrase spécifiée. Convient à l'analytique des big data, à la recherche de contenu, à la gestion des connaissances, à l'analyse des médias sociaux, à l'analyse des journaux, aux systèmes de chat IA, aux audits de conformité et aux recommandations personnalisées. Les index de recherche utilisent la tokenisation pour la recherche en texte intégral. Ils fournissent une pertinence BM25 de base mais pas de pertinence personnalisée. Pour des besoins complexes de recherche par pertinence, utilisez un système de recherche dédié ; sinon, un index de recherche suffit. Cinq types de tokenisation sont disponibles : mot unique, délimiteur, sémantique minimale, sémantique maximale et floue. Pour mettre en évidence les mots-clés dans les résultats, utilisez la fonctionnalité de résumé et de mise en surbrillance. |
|
|
Recherche vectorielle |
Les index de recherche prennent en charge la recherche vectorielle pour des requêtes efficaces de plus proches voisins approximatifs sur des ensembles de données à grande échelle. Convient à la génération augmentée par récupération (RAG), aux systèmes de recommandation, à la détection de similarité (images, vidéos et parole) et au traitement du langage naturel. |
|
|
Requête floue |
Les index de recherche proposent des requêtes avec caractères génériques, par préfixe et par suffixe pour la correspondance floue dans différents scénarios.
|
|
|
Requête d'existence de colonne (requête NULL) |
Vérifiez si une colonne a une valeur null. Convient aux contrôles d'intégrité des données et au nettoyage des données. |
|
|
Requête imbriquée |
Au-delà des structures plates, les données applicatives possèdent souvent des structures imbriquées à plusieurs niveaux. Par exemple, un système de balisage d'images stocke des images avec plusieurs entités (maisons, voitures, personnes), chacune ayant une position, une taille et un poids (score) différents. Chaque image correspond à plusieurs balises, et chaque balise possède un nom et un score de poids. Pour filtrer les images selon des conditions de balise, utilisez la requête de type imbriqué. Les balises d'image sont stockées au format JSON : Les requêtes de type imbriqué gèrent les données avec des relations logiques à plusieurs niveaux, offrant une flexibilité pour la modélisation complexe des données. Pour les structures de données imbriquées complexes (telles que JSON), utilisez la fonctionnalité de résumé et de mise en surbrillance pour localiser précisément les informations requises. |
|
|
Déduplication |
Les index de recherche dédupliquent les résultats de requête pour améliorer la diversité. La déduplication limite le nombre d'apparitions d'une valeur d'attribut spécifique dans un seul ensemble de résultats. Par exemple, lors de la recherche de |
|
|
Tri |
Par défaut, Tablestore trie les données par clé primaire dans l'ordre alphabétique. Pour trier par d'autres champs, utilisez la fonctionnalité de tri d'un index de recherche. Les index de recherche prennent en charge l'ordre croissant ou décroissant, le tri sur condition unique et le tri multicritères. Tous les tris sont globaux. Par défaut, les résultats des index de recherche sont triés par clé primaire dans l'ordre alphabétique. |
|
|
Nombre total de lignes |
Lors de l'interrogation des données avec un index de recherche, vous pouvez renvoyer le nombre de lignes correspondantes. Cela est utile pour la validation et les opérations sur les données.
|
|
|
Agrégation statistique |
Les index de recherche fournissent des fonctions d'agrégation courantes : Max, Min, Avg, Sum, Count, DistinctCount, GroupBy, Percentile et Histogram. Elles répondent aux besoins statistiques de base pour une analyse légère. |
Régions prises en charge
Actuellement, la fonctionnalité d'index de recherche est disponible dans les régions suivantes : Chine (Hangzhou), Chine (Shanghai), Chine (Qingdao), Chine (Beijing), Chine (Zhangjiakou), Chine (Ulanqab), Chine (Shenzhen), Chine (Guangzhou), Chine (Chengdu), Chine (Hong Kong), Japon (Tokyo), Singapour, Malaisie (Kuala Lumpur), Indonésie (Jakarta), Philippines (Manille), Thaïlande (Bangkok), Allemagne (Francfort), Royaume-Uni (Londres), États-Unis (Silicon Valley), États-Unis (Virginie), Arabie saoudite (Riyad - Région partenaire), et . La fonctionnalité de recherche vectorielle n'est pas encore prise en charge dans la région États-Unis (Silicon Valley).
Reprise après sinistre
Dans les régions dotées de capacités de reprise après sinistre inter-zones, les index de recherche offrent par défaut un stockage redondant inter-zones. Les données sont stockées sur plusieurs zones au sein de la région. En cas de panne d'une seule zone, les services de lecture et d'écriture se poursuivent sans interruption.
Actuellement, l'index de recherche prend en charge le stockage redondant inter-zones dans les régions suivantes : Chine (Hangzhou), Chine (Shanghai), Chine (Beijing), Chine (Zhangjiakou), Chine (Ulanqab), Chine (Shenzhen), Chine (Hong Kong), Japon (Tokyo), Singapour, Indonésie (Jakarta), Allemagne (Francfort), et .
Cycle de vie des données
Si votre table de données n'effectue aucune opération UpdateRow, vous pouvez utiliser le TTL de l'index de recherche. Gestion du cycle de vie.
Si vous devez uniquement conserver les données pendant une période spécifique et que le champ temporel ne nécessite pas de mises à jour, implémentez le TTL en partitionnant les tables par temps.
|
Dimension |
Partitionnement de table par temps |
|
Principe |
Partitionnez les tables par intervalle fixe (jour, semaine, mois ou année). Créez un index de recherche pour chaque table et conservez les tables de données pendant la durée requise. Par exemple, pour conserver les données pendant six mois, stockez les données de chaque mois dans une table séparée (table_1 à table_6) avec son propre index de recherche. Chaque mois, supprimez la table datant d'il y a six mois. Lors de l'interrogation, si la plage temporelle tient dans une seule table, interrogez uniquement cette table. Si elle s'étend sur plusieurs tables, interrogez chacune d'elles et fusionnez les résultats. |
|
Règle |
Une seule table (un seul index) ne doit pas dépasser 50 milliards de lignes. Les performances de requête sont optimales lorsque le nombre de lignes reste inférieur à 20 milliards. |
|
Avantages |
|
Versions des données
Les index de recherche ne prennent pas en charge plusieurs versions de données. Vous ne pouvez pas créer d'index de recherche pour une table de données avec plusieurs versions activées.
Dans une table à version unique, si vous personnalisez l'horodatage pour chaque écriture, l'écriture de données avec un numéro de version inférieur après un numéro supérieur peut écraser la version supérieure.
Les données renvoyées par les requêtes Search et ParallelScan n'incluent pas nécessairement la propriété d'horodatage.
Limites
Les index de recherche synchronisent les données de la table de données de manière asynchrone, donc les requêtes en temps réel ne sont pas possibles. La latence typique est inférieure à 3 secondes. Limites des index de recherche.
Facturation
Les index de recherche sont facturés pour l'espace de stockage occupé par les données d'index et les ressources de calcul consommées pour les requêtes et l'analyse. Présentation de la facturation.
Développement et intégration
Référence API
Les index de recherche proposent des opérations API pour la gestion des index et l'interrogation des données. L'interrogation des données inclut l'API Search polyvalente et l'API ParallelScan pour l'exportation de données. ParallelScan sacrifie certaines fonctionnalités (tri, agrégation) pour obtenir des performances et un débit plus élevés.
|
Catégorie |
API |
Description |
|
Gestion des index |
Crée un index de recherche. |
|
|
Met à jour la configuration d'un index de recherche, y compris sa durée de vie (TTL) et son schéma d'index. |
||
|
Obtient la description détaillée d'un index de recherche. |
||
|
Répertorie les index de recherche. |
||
|
Supprime un index de recherche. |
||
|
Interrogation des données |
API de requête complète. Prend en charge toutes les fonctionnalités des index de recherche, y compris les fonctions de requête, le tri et l'agrégation statistique. Les résultats sont renvoyés dans l'ordre spécifié.
|
|
|
API d'exportation de données avec prise en charge du scan parallèle. Inclut toutes les fonctions de requête mais omet le tri et l'agrégation statistique. Renvoie toutes les données correspondantes à plus haute vitesse. Avec une seule concurrence, le débit de ParallelScan est 5 fois supérieur à celui de l'API Search.
Lors de l'exportation de données avec plusieurs demandes concurrentes, utilisez l'API ComputeSplits pour obtenir la concurrence maximale pour une seule demande ParallelScan. |
Méthodes d'intégration
Vous pouvez utiliser les SDK ou outils CLI suivants pour travailler avec les index de recherche.
FAQ
Comment choisir entre un index secondaire et un index de recherche ?
Pourquoi ne puis-je pas récupérer de données à l'aide de l'API Search d'un index de recherche ?
Comment augmenter la 'limit' pour l'API Search d'un index de recherche à 1 000 ?
Pourquoi des UC de lecture réservées sont-elles générées lorsque j'utilise un index de recherche ?
La configuration des UC de lecture réservées pour un index de recherche peut-elle être ajustée ?
Comment afficher les données de comptabilité pour un index de recherche ?
Références
-
Pour interroger et analyser les données avec SQL, utilisez la fonctionnalité Requête SQL de Tablestore.
RemarqueVous pouvez également analyser les données dans Tablestore à l'aide de moteurs de calcul tels que MaxCompute, Spark, Hive, HadoopMR, Function Compute ou Flink. Présentation du calcul et de l'analyse.
Annexe : Mappage SQL
Certaines fonctionnalités des index de recherche correspondent à des fonctions SQL. Le tableau suivant répertorie les mappages.
|
SQL |
Index de recherche |
Documentation de l'index de recherche |
|
Show |
DescribeSearchIndex |
|
|
Select |
Paramètre ColumnsToGet dans n'importe quelle requête |
Toute requête d'index de recherche, telle qu'une requête de base |
|
From |
Paramètre IndexName dans n'importe quelle requête Important
Un seul index est pris en charge. Plusieurs index ne sont pas encore pris en charge. |
Toute requête d'index de recherche, telle qu'une requête de base |
|
Where |
Conditions dans n'importe quelle requête |
Toute requête d'index de recherche, telle qu'une requête de base |
|
Order by |
Paramètre sort dans n'importe quelle requête |
|
|
Limit |
Paramètre limit dans n'importe quelle requête |
|
|
Delete |
|
|
|
Like |
WildcardQuery |
|
|
And |
operator = and dans BoolQuery |
|
|
Or |
operator = or dans BoolQuery |
|
|
Not |
BoolQuery(mustNotQueries) |
|
|
Between |
RangeQuery |
|
|
Null |
ExistsQuery |
|
|
In |
TermsQuery |
|
|
Min |
Agrégation : min |
|
|
Max |
Agrégation : max |
|
|
Avg |
Agrégation : avg |
|
|
Count |
Agrégation : count |
|
|
Count(distinct) |
Agrégation : distinctCount |
|
|
Sum |
Agrégation : sum |
|
|
Group By |
GroupBy |