Le modèle Wide Column est compatible avec Bigtable et HBase. Il est conçu pour les métadonnées, le big data et d'autres scénarios. Chaque table prend en charge un stockage à l'échelle du pétaoctet, des dizaines de millions de QPS, des lignes larges sans schéma, des données multiversions et une gestion du cycle de vie basée sur le TTL.
Aperçu du modèle
Tablestore propose un modèle Wide Column compatible avec Bigtable et HBase. Il stocke les données dans des tables selon une structure tridimensionnelle (ligne, colonne et temps). Les tables sont sans schéma : chaque ligne peut comporter des colonnes différentes et vous pouvez ajouter ou supprimer des colonnes d'attributs sans définir de schéma au préalable.
Composants du modèle
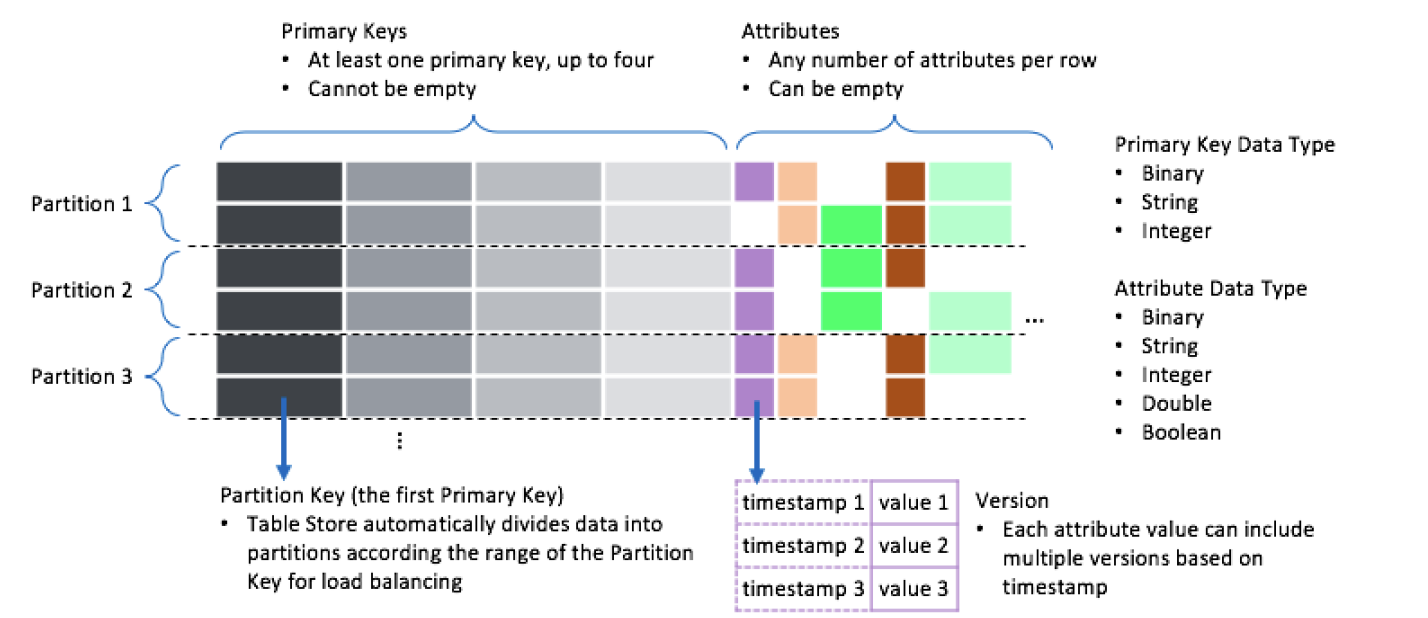
Le modèle Wide Column comprend les composants suivants.
|
Composant |
Description |
|
Clé primaire |
Identifie de manière unique chaque ligne d'une table. Une clé primaire se compose d'une à quatre colonnes de clé primaire. |
|
Clé de partition |
Première colonne de la clé primaire. Tablestore répartit les données entre les partitions en fonction des valeurs de la clé de partition afin d'assurer l'équilibrage de charge. |
|
Colonne d'attribut |
Colonnes autres que la clé primaire dans une ligne. Chaque colonne d'attribut peut stocker plusieurs versions de valeurs. Le nombre de colonnes d'attributs par ligne n'est pas limité. |
|
Version |
Chaque valeur possède un horodatage de version qui définit le cycle de vie des données. Consultez la section Numéro de version. |
|
Type de données |
Tablestore prend en charge les types de données String, Binary, Double, Integer et Boolean. Pour plus d'informations, consultez la section Types de données. |
|
Time To Live (TTL) |
Définit un cycle de vie des données au niveau de la table. Par exemple, avec un TTL d'un mois, Tablestore supprime automatiquement les données âgées de plus d'un mois. Consultez la section Time to live. |
|
Versions maximales |
Définit le nombre maximal de versions par colonne d'attribut. Lorsque ce seuil est dépassé, Tablestore supprime de manière asynchrone les anciennes versions. Consultez la section Versions maximales. |
Composants principaux
Les tables de données, les lignes, les clés primaires et les attributs constituent les composants centraux du modèle Wide Column de Tablestore. Une table est un ensemble de lignes, et chaque ligne se compose d'une clé primaire et d'attributs. La première colonne de la clé primaire sert de clé de partition.
Le tableau suivant décrit ces composants.
Les types de données des clés primaires et des colonnes d'attributs sont répertoriés dans la section Conventions de nommage et types de données.
Composant | Description |
Clé primaire | Identifie de manière unique chaque ligne. Une clé primaire se compose d'une à quatre colonnes. Lors de la création d'une table, vous devez spécifier la composition de la clé primaire, le nom et le type de données de chaque colonne, ainsi que l'ordre des colonnes. Tablestore indexe les données en fonction de la clé primaire de la table de données. Par défaut, les lignes d'une table de données sont triées par ordre croissant selon la clé primaire. |
Clé de partition | Première colonne de la clé primaire. Tablestore répartit les lignes entre les partitions et les machines en fonction des valeurs de la clé de partition afin d'assurer l'équilibrage de charge. Les lignes partageant la même valeur de clé de partition appartiennent à la même partition. Une partition peut contenir plusieurs valeurs de clé de partition. Tablestore fractionne et fusionne automatiquement les partitions selon les besoins. Remarque Une valeur de clé de partition constitue l'unité de partitionnement la plus petite et ne peut pas être fractionnée davantage. Pour éviter des partitions trop volumineuses, maintenez la taille totale de toutes les lignes associées à une seule valeur de clé de partition inférieure à 10 Go. Pour obtenir des recommandations sur le choix de la clé de partition, consultez la section Opérations sur les tables. |
Attribut | Se compose de plusieurs colonnes d'attributs, sans limite par ligne. Les colonnes peuvent différer d'une ligne à l'autre, les valeurs peuvent être vides et une même colonne peut stocker des valeurs de types de données différents. Les colonnes d'attributs prennent en charge plusieurs versions pour les requêtes et un délai de conservation (TTL) configurable. Consultez la section Versions des données et TTL. |
Différences par rapport au modèle relationnel
Le tableau suivant compare le modèle Wide Column au modèle relationnel.
|
Modèle |
Caractéristiques |
|
Modèle Wide Column |
Tridimensionnel (ligne, colonne, temps), sans schéma, lignes larges, données multiversions et gestion du cycle de vie. |
|
Modèle relationnel |
Bidimensionnel (ligne, colonne), schéma fixe. |
Limites
Les limites générales sont répertoriées dans la section Limites.
Si vous utilisez un index secondaire ou un index de recherche, vérifiez les limites applicables : Limites des index secondaires, Limites des index de recherche.
Si vous utilisez des requêtes SQL, vérifiez les limites applicables : Limites des requêtes SQL.
Fonctionnalités
Fonctionnalités | Description | Références |
Opérations sur les tables | Répertoriez, créez, mettez à jour et supprimez des tables de données dans une instance. | |
Opérations de base sur les données | Tablestore fournit des opérations sur une seule ligne (PutRow, GetRow, UpdateRow, DeleteRow) et des opérations sur plusieurs lignes (BatchWriteRow, BatchGetRow, GetRange) pour lire et écrire des données dans les tables. | |
Versions des données et TTL | Gérez la rétention des données grâce au versioning et au TTL afin de réduire l'espace de stockage et les coûts. | |
Colonne de clé primaire à incrémentation automatique | Lorsqu'une colonne de clé primaire autre que la clé de partition est configurée en incrémentation automatique, il n'est pas nécessaire de spécifier sa valeur lors de l'écriture des données. Tablestore génère une valeur unique et strictement croissante par clé de partition pour cette colonne. | |
Mise à jour conditionnelle | Met à jour les données uniquement lorsque les conditions spécifiées sont remplies. Dans le cas contraire, la mise à jour échoue. | |
Transaction locale | Crée une transaction locale au sein d'une seule valeur de clé de partition. Vous pouvez effectuer des opérations de lecture et d'écriture, puis valider ou annuler la transaction. | |
Compteur atomique | Utilise une colonne comme compteur atomique pour des statistiques en temps réel, telles que le comptage des pages vues (PV). | |
Filtre | Filtre les résultats de lecture côté serveur et renvoie uniquement les lignes correspondantes, réduisant ainsi le transfert réseau et le temps de réponse. | |
Index secondaire | Crée des tables d'index pour activer les requêtes sur des colonnes autres que la clé primaire. Comprend les index secondaires globaux et locaux.
| |
Index de recherche | S'appuie sur des index inversés et un stockage colonnaire pour des requêtes complexes sur le big data. Prend en charge les requêtes sur des colonnes autres que la clé primaire, la recherche en texte intégral, les requêtes par préfixe/floues, les conditions combinées, les requêtes imbriquées, les requêtes géospatiales, les agrégations (max, min, count, sum, avg, distinct_count, group_by) et l'analyse parallèle. | |
Requête SQL | Fournit une interface SQL unifiée entre les moteurs de données pour des requêtes et analyses complexes sur les données stockées dans Tablestore, avec une optimisation des requêtes basée sur les index. |
|
Tunnel Service | Tablestore fournit trois canaux de données distribués en temps réel (incrémentiel, complet et incrémentiel plus complet) pour consommer et traiter les données historiques et nouvelles d'une table. |
Facturation
Facturé en fonction du débit de lecture/écriture, du stockage des données et du trafic Internet sortant. Consultez la section Aperçu de la facturation.
FAQ
Références
Créez une instance redondante inter-zones pour la reprise après sinistre au niveau de la zone. Consultez la section Stockage redondant inter-zones.
Protégez les données et l'accès réseau grâce au chiffrement des tables et à l'accès VPC. Consultez les sections Chiffrement des données et Gestion de la sécurité réseau.
Sauvegardez régulièrement les données pour prévenir les suppressions accidentelles. Consultez la section Sauvegarde des données.
Consommez et traitez les données historiques et nouvelles des tables avec Tunnel Service.
Configurez des notifications d'alerte basées sur des métriques avec Cloud Monitor. Consultez la section Surveillance et alertes.
Visualisez les données avec DataV ou Grafana. Consultez la section Visualisation des données.