Lors de la création d'index, vous pouvez définir le type de données d'un champ sur text, long, double ou JSON. Cette rubrique décrit les types de données des champs et fournit des exemples de configuration.
Présentation des types de données
Nous vous recommandons d'utiliser la console pour créer des index. Simple Log Service (SLS) génère automatiquement un index de champ basé sur la première entrée des données d'aperçu lors de la collecte. Vous pouvez également créer des index de champ personnalisés.
-
Types text, long et double :
-
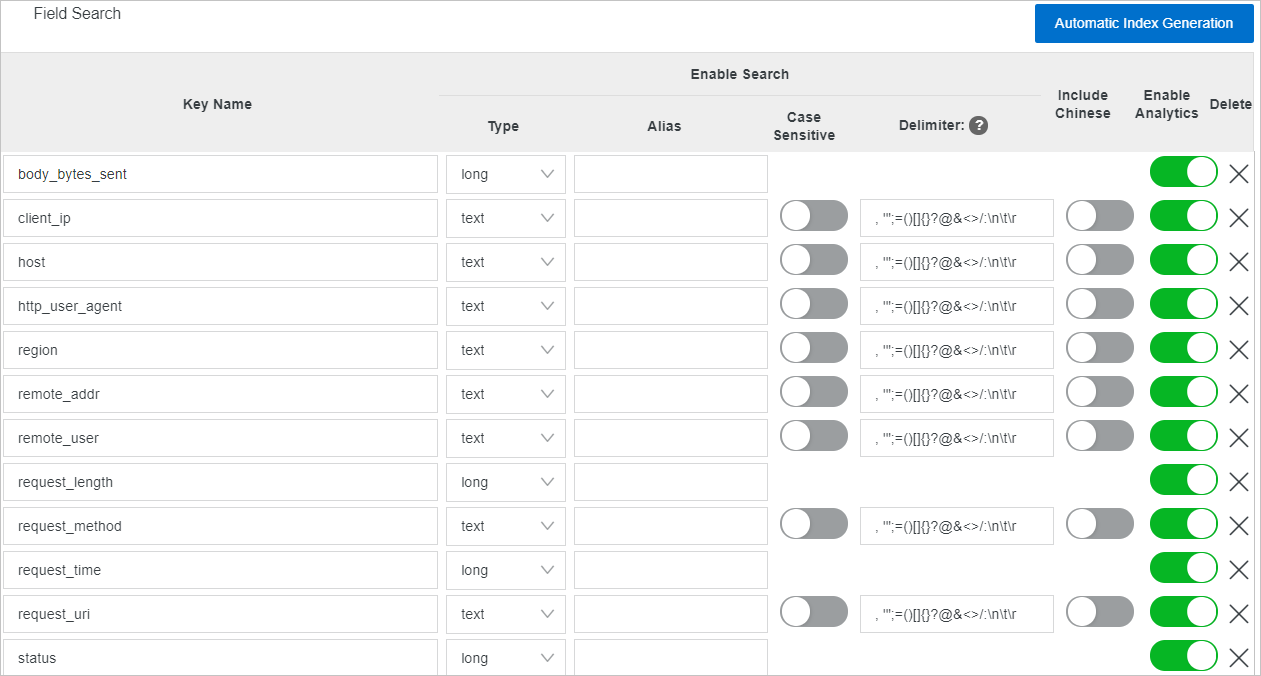
Pour interroger et analyser des champs de type chaîne, définissez le type de données des champs sur text lors de la création des index et activez l'option Enable Analytics pour ces champs.
RemarqueL'activation de l'analyse est indépendante pour les champs de type text, long et double. Un champ peut servir au filtrage dans la clause WHERE, à l'analyse agrégée (SELECT/GROUP BY) et à la visualisation dans les requêtes SQL uniquement après activation de l'option Enable Analytics pour ce champ. Si l'analyse n'est pas activée, le champ risque de ne pas être extractible ou de renvoyer une valeur null lors de l'analyse des requêtes SQL.
Dans l'interface de configuration des attributs d'index Clé/Valeur de la console, chaque ligne de champ dispose d'un commutateur Enable Analytics. Ce commutateur est disponible indépendamment pour les types de champ text, long et double et reste visible même en cas de changement de type de champ.
ImportantLa longueur maximale par défaut d'une valeur de champ dans Simple Log Service est de 2 Ko (2 048 octets). Le contenu dépassant cette limite est tronqué et n'est ni indexé ni analysé. Cela n'affecte pas la collecte ni la transmission des journaux bruts (Raw Logs).
Pour analyser intégralement des champs plus longs, augmentez la longueur maximale d'un champ texte analysé à 16 Ko. L'impact de cette augmentation sur les performances de l'analyse SQL n'est pas documenté. Évaluez l'impact selon votre scénario métier.
-
Interrogez la valeur d'un champ via une plage numérique uniquement si son type de données est long ou double. Si le type de données d'un champ est long ou double, vous ne pouvez pas l'interroger à l'aide d'un astérisque (*) ou d'un point d'interrogation (?). Les caractères génériques servent à effectuer une correspondance floue.
Si la valeur d'un champ est un entier, définissez son type de données sur long.
Si la valeur d'un champ est un nombre à virgule flottante, définissez son type de données sur double. Sinon, l'interrogation du champ échouera.
Si vous définissez le type de données d'un champ sur long ou double alors que sa valeur est une chaîne, l'interrogation du champ échouera.
ImportantSi la valeur d'un champ est une valeur numérique non valide, interrogez-le à l'aide de l'instruction de recherche not key > -1000000. Cette instruction renvoie les journaux dont la valeur de champ est une valeur numérique non valide. Remplacez -1000000 par une valeur numérique valide inférieure ou égale à la plus petite valeur numérique valide du champ dans vos journaux.
-
-
Type JSON : si la valeur d'un champ est de type JSON, définissez son type de données sur JSON lors de la création des index.
-
Définissez le type de données d'un champ dans les objets JSON sur long, double ou text selon la valeur du champ, puis activez l'option Enable Analytics pour ce champ. Une fois l'option Enable Analytics activée, SLS permet d'interroger et d'analyser le champ.
Si vous sélectionnez Automatically Index All Text Fields in JSON Field, des index sont automatiquement créés pour tous les champs de type text dans les objets JSON. La création des index génère du trafic d'indexation.

-
Pour les données partiellement valides au format JSON, SLS n'analyse que la partie valide des données.
L'exemple suivant montre un journal JSON incomplet. SLS peut analyser les champs content.remote_addr, content.request.request_length et content.request.request_method.
content: { remote_addr:"192.0.2.0" request: { request_length:"73" request_method:"GEImportantVous pouvez créer des index pour les nœuds feuilles dans les objets JSON. Vous ne pouvez pas créer d'index pour les nœuds enfants qui contiennent des nœuds feuilles.
Vous ne pouvez pas créer d'index pour les champs dont les valeurs sont des tableaux JSON, ni pour les champs contenus dans un tableau JSON.
Si la valeur d'un champ est de type booléen, définissez son type de données sur text lors de la création des index.
Une instruction de requête suit le format
Search statement|Analytic statement. Dans une instruction d'analyse, entourez le nom du champ de guillemets doubles ("") et la chaîne de guillemets simples ('').
-
Références
Pour plus d'informations sur les scénarios et la FAQ liés à l'interrogation et à l'analyse des journaux JSON, consultez la section FAQ sur l'interrogation et l'analyse des journaux JSON. La FAQ inclut des informations sur la création d'index, l'interrogation et l'analyse des champs JSON indexés, l'utilisation des fonctions JSON et l'analyse des tableaux JSON.
Pour plus d'informations sur les configurations et les procédures liées à l'interrogation et à l'analyse des journaux JSON, consultez la section Interroger et analyser les journaux JSON.
Si le volume de données des journaux JSON à interroger et analyser est faible, inutile de créer des index pour les nœuds feuilles JSON. Utilisez les fonctions JSON pour interroger et analyser les journaux. Dans certains cas d'utilisation spécifiques, seules les fonctions JSON permettent l'interrogation et l'analyse. Pour plus d'informations sur l'utilisation des fonctions JSON, consultez la section Quand utiliser les fonctions JSON. Pour plus d'informations sur les descriptions et les exemples de fonctions JSON, consultez la section Fonctions JSON.
-
Contrairement aux champs standards, les plages de dates et d'heures ne peuvent pas être configurées comme champs indexés. Pour interroger les journaux, spécifiez manuellement une plage horaire à l'aide de l'option Time Range dans la console.
Procédure
Créez des index dans la console SLS. Pour plus d'informations, consultez la section Créer un index.
-
Sélectionnez les types de données des champs lors de la création des index.
Types text, long et double
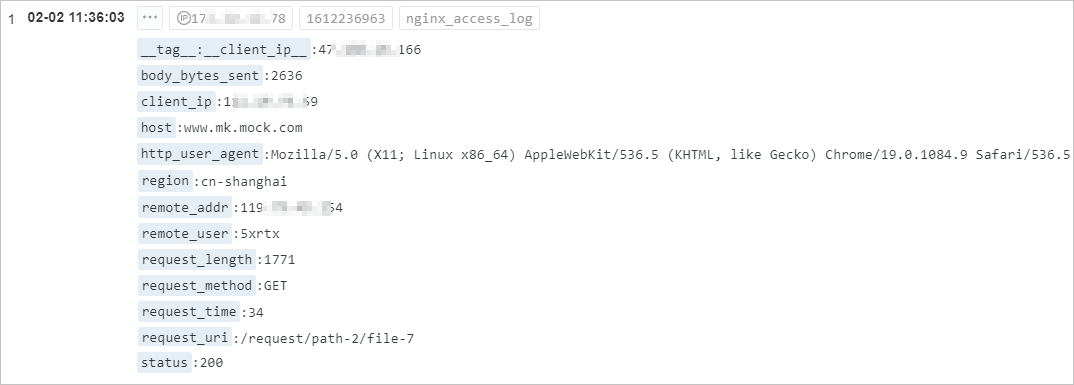
Exemple de journal
Configurations d'index
-
Exemples d'instructions de requête
Pour interroger les journaux dont la durée de la requête est supérieure à 60 secondes, exécutez l'instruction suivante :
request_time > 60Pour interroger les journaux dont la durée de la requête est supérieure ou égale à 60 secondes mais inférieure à 200 secondes, exécutez l'une des instructions suivantes :
request_time in [60 200)ourequest_time >= 60 and request_time < 200.Pour interroger les journaux dont le code d'état de la requête est 200, exécutez l'instruction suivante :
status = 200.Pour interroger les journaux qui n'enregistrent pas de requêtes GET, exécutez l'instruction suivante :
not request_method : GET.Pour interroger les journaux contenant des mots spécifiques commençant par cn, exécutez l'instruction suivante :
cn*.Pour collecter des statistiques sur la distribution des clients, exécutez l'instruction suivante :
* | SELECT ip_to_province(client_ip) as province, count(*) AS pv GROUP BY province ORDER BY pv.
Type JSON
-
Exemple de journal
La figure suivante présente un exemple de journal JSON. Le journal contient les champs class, latency, status et info, ainsi que les champs réservés de SLS. La valeur du champ info est un objet JSON contenant plusieurs niveaux.

-
Configurations d'index
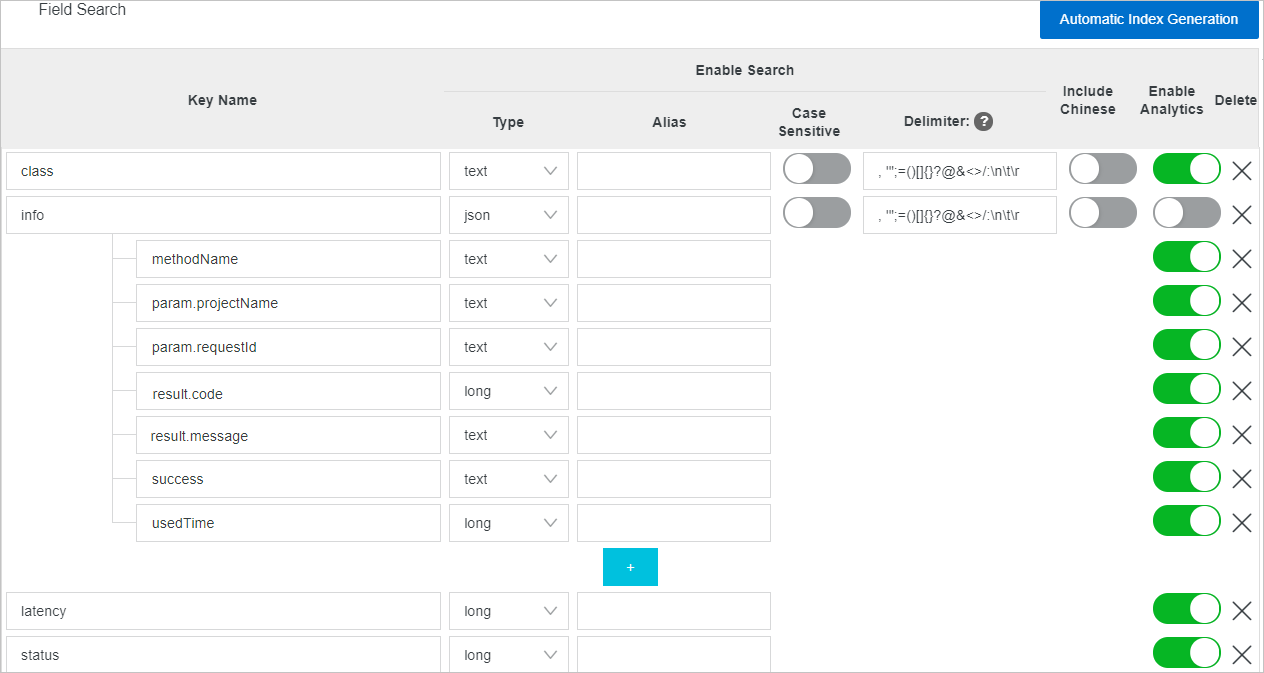
Détails supplémentaires :
Les valeurs des champs IP et data sont des tableaux JSON. Par conséquent, vous ne pouvez pas créer d'index pour les champs IP ou data, ni interroger ou analyser les données à l'aide de ces champs.
Les champs region et CreateTime se trouvent dans un tableau JSON. Par conséquent, vous ne pouvez pas créer d'index pour les champs region ou CreateTime, ni interroger ou analyser les données à l'aide de ces champs.
-
Exemples d'instructions de requête
Pour interroger les journaux dont la valeur du champ usedTime est supérieure à 60 secondes, exécutez l'instruction suivante :
info.usedTime > 60.Pour interroger les journaux dont la valeur du champ success est true, exécutez l'instruction suivante :
info.success : true.Pour interroger les journaux dont la valeur du champ usedTime est supérieure à 60 secondes et dont la valeur du champ projectName n'est pas project01, exécutez l'instruction suivante :
info.usedTime > 60 not info.param.projectName : project01.Pour calculer la durée moyenne nécessaire à l'obtention des informations du projet, exécutez l'instruction suivante :
methodName = getProjectInfo | SELECT avg("info.usedTime") AS avg_time.
Lors de la configuration des index, respectez les règles suivantes :
Vous devez activer au moins l'une des options FullText Index ou Key/Value Index attributes.
Les configurations d'index au niveau des champs remplacent les paramètres de champ homonymes dans l'index FullText. Par exemple, si un champ est configuré pour la recherche tokenisée en texte intégral dans l'index FullText, mais que vous configurez séparément un type et des propriétés pour ce champ dans l'index Key/Value, la configuration de l'index Key/Value prévaut.
Lorsque le type de champ est long ou double, les propriétés Case Sensitive et Token ne s'appliquent pas.
Vous ne pouvez que réduire la durée de rétention des index.
Les modifications de configuration des index (ajout de champs, modification des types, activation des commutateurs de statistiques/requête) prennent effet après environ 1 minute, mais s'appliquent uniquement aux nouvelles données écrites après la prise d'effet de l'index. Pour interroger les données historiques, vous devez réindexer les données. Pour plus d'informations, consultez la section Réindexer les données.
La réindexation prend uniquement en charge les données des 30 derniers jours et âgées d'au moins 15 minutes.