Interrogez et analysez les journaux de site web au format JSON en créant des index et en exécutant des instructions SQL.
Prérequis
Vous avez collecté des journaux textuels au format JSON. Collecter des journaux textuels au format JSON.
Étape 1 : Créer un index
Connectez-vous à la console Simple Log Service.
-
Dans la section Projects, cliquez sur le projet souhaité.
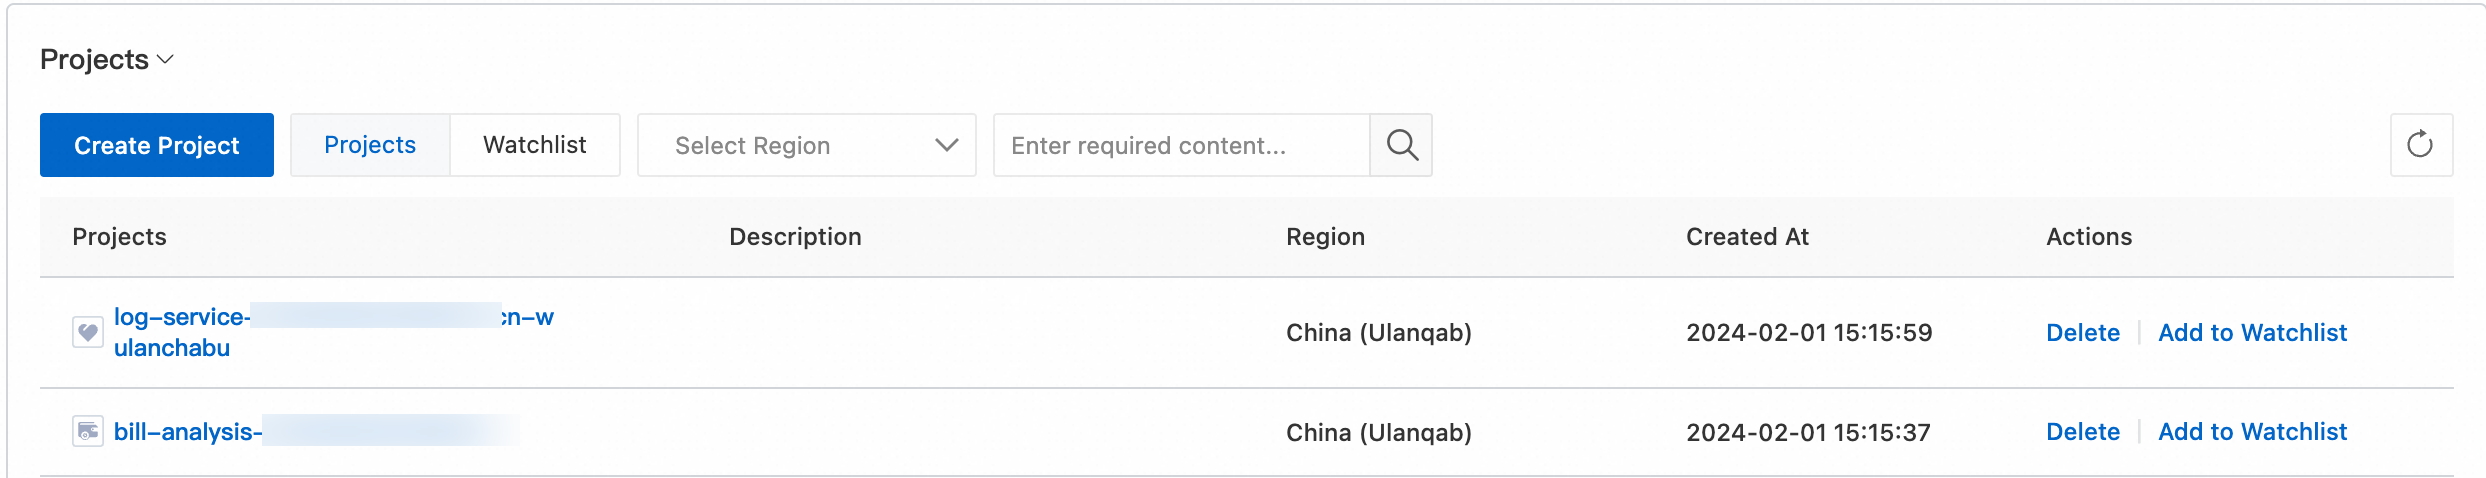
-
Sous l'onglet , cliquez sur le logstore souhaité.
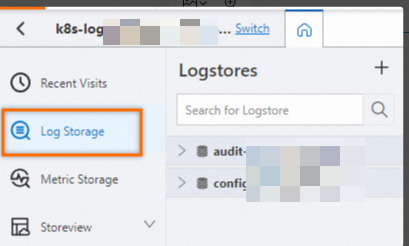
-
Dans le coin supérieur droit de la page Query and Analysis du logstore, choisissez . Si aucun index n'existe, cliquez sur Enable Indexing. Créer un index.
RemarquePour interroger tous les champs, créez un index full-text. Pour interroger des champs spécifiques et réduire le trafic d'indexation, utilisez un index de champ. L'analyse des champs avec des instructions SELECT nécessite un index de champ.
-
Configurez un index de champ. L'exemple de journal JSON suivant illustre la configuration des champs.
{
  "@timestamp": "2023-01-01T00:00:00+08:00",
  "remote_addr": "192.168.0.1",
  "remote_user": "-",
  "request": {
    "request_length": 123,
    "request_method": "GET",
    "request_uri": "/index.html"
  },
  "status": 200,
  "http_referer": "http://example.com",
  "http_user_agent": "Mozilla/5.0",
  "server_protocal": "HTTP/1.1",
  "http_x_forward_for": "192.168.0.1",
  "upstream_addr": "10.0.0.1:8080",
  "time": {
    "request_time": 0.006,
    "upstream_response_time": 0.004
  },
  "body_bytes_sent": [123, 456]
}
Définissez le type de données du champ content sur json. Les nœuds feuilles sous request incluent
request.request_length(long),request.request_method(text) etrequest.request_uri(text). Activez l'option Enable Statistics pour tous les champs.Les champs
__topic__,__source__et__tag__sont des champs réservés au niveau du système.Les champs
@timestamp,remote_addr,remote_user,http_referer,http_user_agent,status,server_protocal,http_x_forward_foretupstream_addrne possèdent pas de nœuds feuilles. Créez directement des index pour ces champs sous le champcontent.-
Les champs
requestettimecomportent des nœuds feuilles qui ne sont pas des tableaux JSON.Il est impossible de créer des index pour les champs parents
requestettime, ou de les interroger et de les analyser.Créez des index pour les nœuds feuilles sous
requestettimeen spécifiant le chemin complet du parent à la feuille. Le format est KEY1.KEY2.KEY3, par exempletime.request_timeettime.upstream_response_time. Une fois les index créés, vous pouvez interrogertime.request_timeettime.upstream_response_time.
Le champ
body_bytes_sentest un tableau JSON. Il est impossible de créer des index pour ce champ ou ses nœuds feuilles, ou d'interroger et d'analyserbody_bytes_sentou les nœuds feuilles debody_bytes_sent.
Étape 2 : Réindexer
Les index s'appliquent uniquement aux nouvelles données collectées. Pour interroger les données historiques, utilisez la fonctionnalité Reindex.
Étape 3 : Interroger et analyser les journaux
Sur la page Query and Analysis, saisissez une instruction et sélectionnez une plage horaire. Dans les instructions d'analyse (SELECT), encadrez les noms de champs par des guillemets doubles (") et les chaînes de caractères par des guillemets simples ('). Démarrage rapide pour l'interrogation et l'analyse des journaux. FAQ sur l'interrogation et l'analyse des journaux JSON.
-
Recherchez les journaux dont le statut de la requête est 200.
content.status:200 -
Recherchez les journaux dont la longueur de la requête est supérieure à 70.
content.request.request_length > 70 -
Recherchez les journaux correspondant aux requêtes GET.
content.request.request_method:GET -
Comptez les journaux par statut de requête.
* | SELECT "content.status", COUNT(*) AS PV GROUP BY "content.status"Le résultat liste chaque code de statut, tel que
200etnull, avec son nombre de pages vues (PV). -
Comptez les requêtes par durée de requête, triées par ordre croissant.
* | SELECT "content.time.request_time", COUNT(*) AS count GROUP BY "content.time.request_time" ORDER BY "content.time.request_time" -
Calculez la durée moyenne des requêtes par méthode de requête.
* | SELECT avg("content.time.request_time") AS avg_time,"content.request.request_method" GROUP BY "content.request.request_method"Le résultat affiche une valeur
avg_timede 45 pour GET et une valeuravg_timede 11 pour PUT.