Le graphique Change Trend of Instance Quantity With Scaling Metrics illustre comment SAE ajuste automatiquement le nombre d'instances selon votre politique de mise à l'échelle. Utilisez-le pour vérifier que vos règles Auto Scaling se déclenchent aux bons seuils et pour diagnostiquer tout comportement inattendu.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Une application déployée. Pour plus d'informations, consultez la rubrique Déploiement d'applications.
Une politique Auto Scaling créée et activée. Pour plus d'informations, consultez la rubrique Configuration d'une politique Auto Scaling.
Consulter le graphique de tendance de mise à l'échelle
Connectez-vous à la console SAE. Dans le volet de navigation de gauche, choisissez Applications > Applications. Dans la barre de navigation supérieure, sélectionnez une région et un namespace dans la liste déroulante Namespace, puis cliquez sur le nom de l'application.
Sur la page Basic Information, cliquez sur l'onglet Auto Scaling.
-
Dans la section Change Trend of Instance Quantity With Scaling Metrics Instance, définissez une plage de temps pour afficher l'activité de mise à l'échelle sur la période spécifiée.
Le graphique affiche les données des métriques suivantes. Sélectionnez la métrique correspondant à la règle de mise à l'échelle configurée dans votre politique Auto Scaling.
Utilisation du CPU
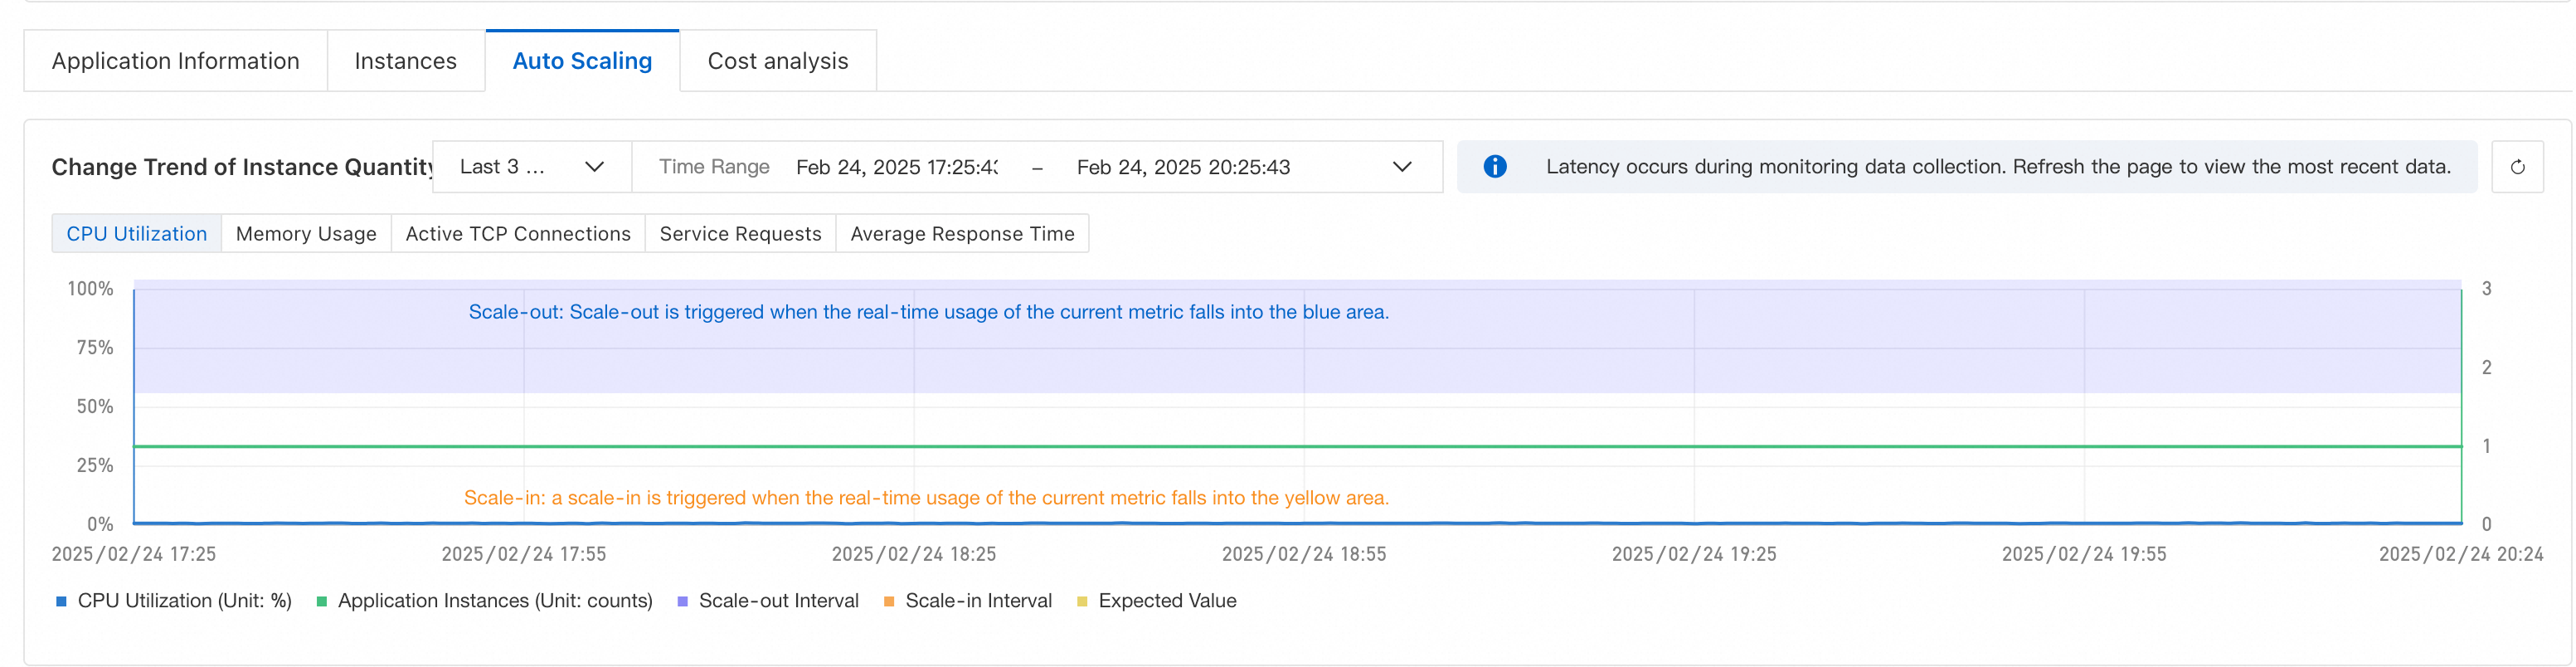
Le graphique d'utilisation du CPU affiche six paramètres :
| Paramètre | Description |
|---|---|
| CPU Utilization | Le pourcentage de ressources CPU utilisées — indicateur principal de la charge système. |
| Application Instances | Le nombre d'instances déployées pour l'exécution de l'application. |
| Scale-out Interval | L'augmentation maximale du nombre d'instances lorsque l'utilisation du CPU dépasse le seuil prédéfini. |
| Scale-in Interval | La réduction maximale du nombre d'instances lorsque l'utilisation du CPU revient au seuil prédéfini. |
| Expected Value | Les seuils de scale-out et de scale-in définis dans la configuration Horizontal Pod Autoscaler (HPA). |
| Scaling Description | La raison de chaque modification du nombre d'instances. |
Ces paramètres proviennent de votre configuration HPA. Si un paramètre n'est pas configuré, il n'apparaît pas dans le graphique. Il en va de même pour les autres métriques configurées avec HPA.
Utilisation de la mémoire
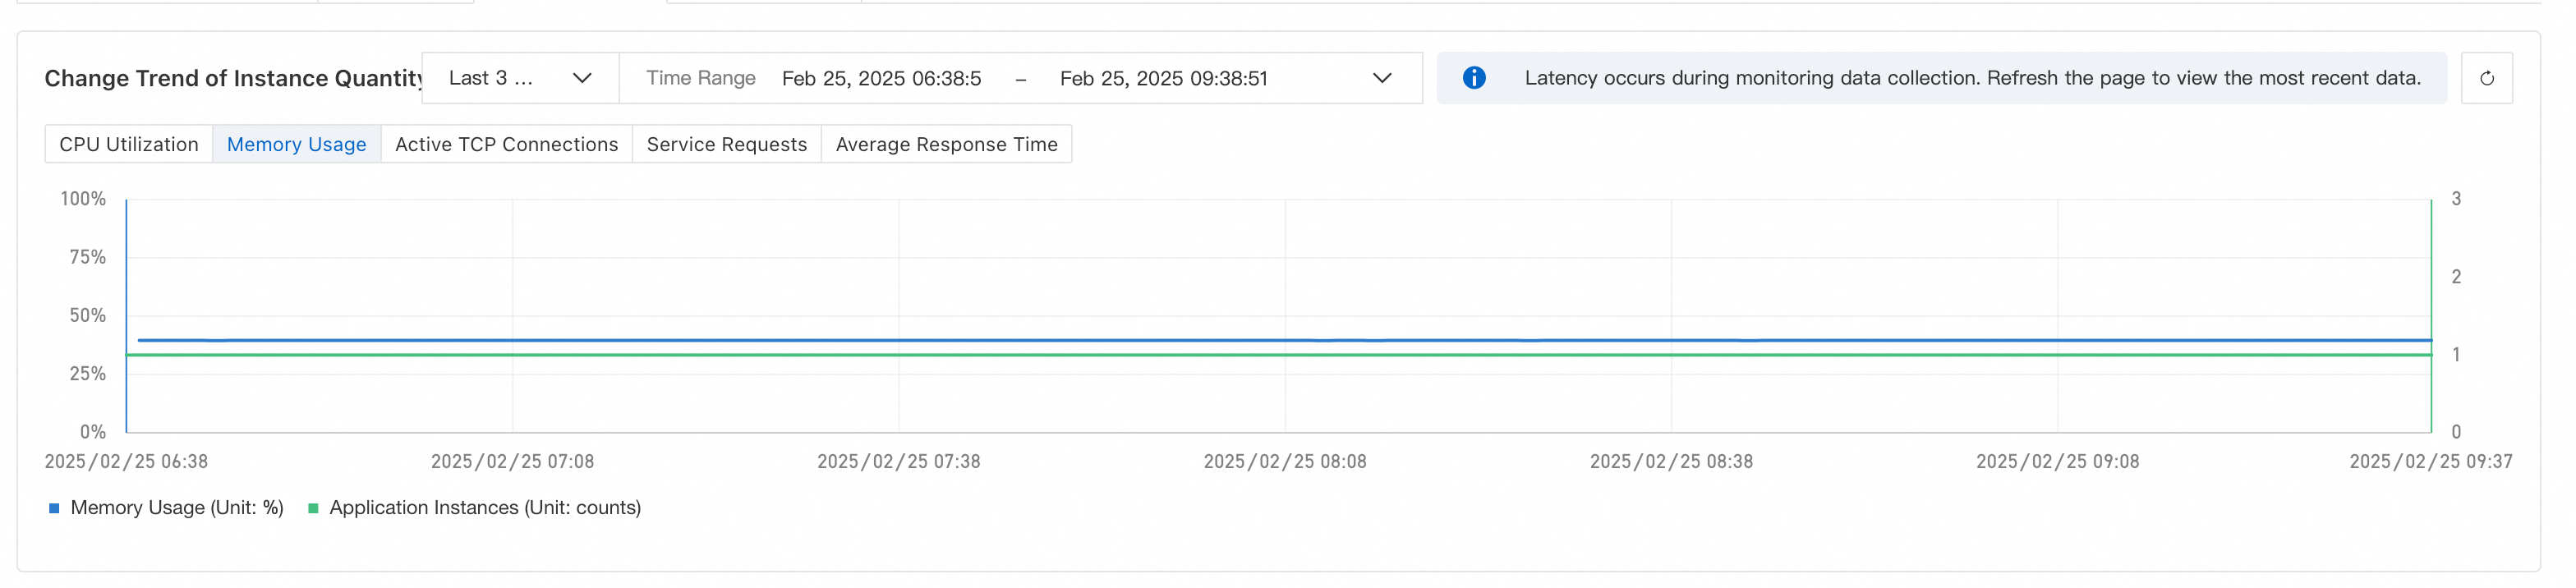
Affiche le ratio entre la mémoire utilisée et la mémoire totale disponible sur la période sélectionnée.
Connexions TCP actives
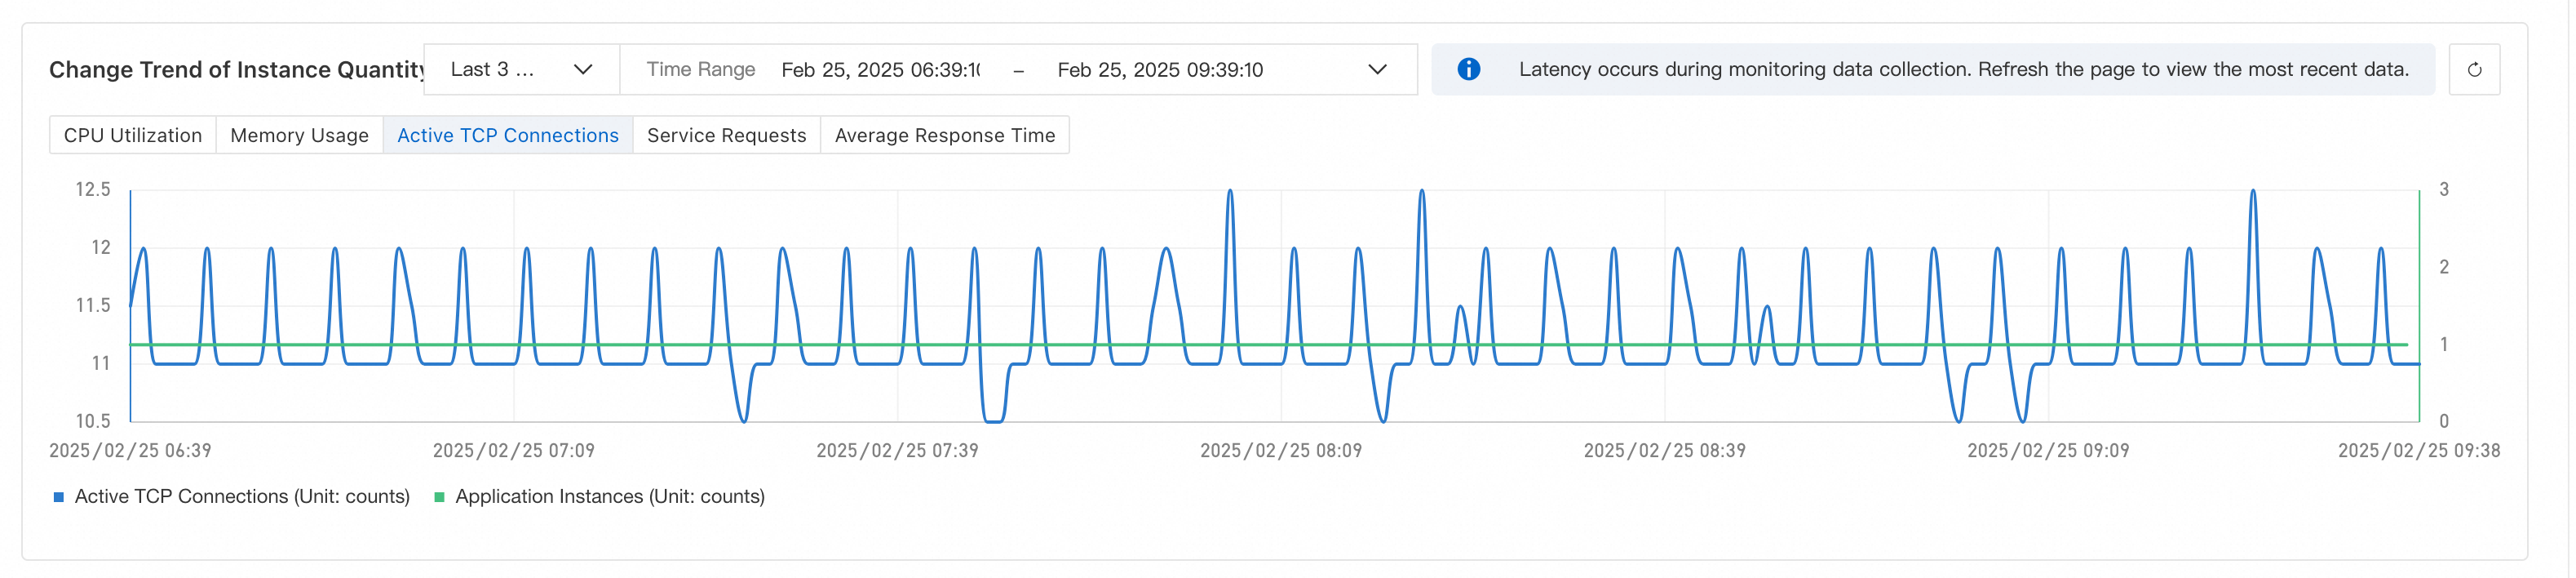
Indique le nombre de connexions TCP actives traitées par le serveur ou l'application sur la période sélectionnée.
Requêtes de service
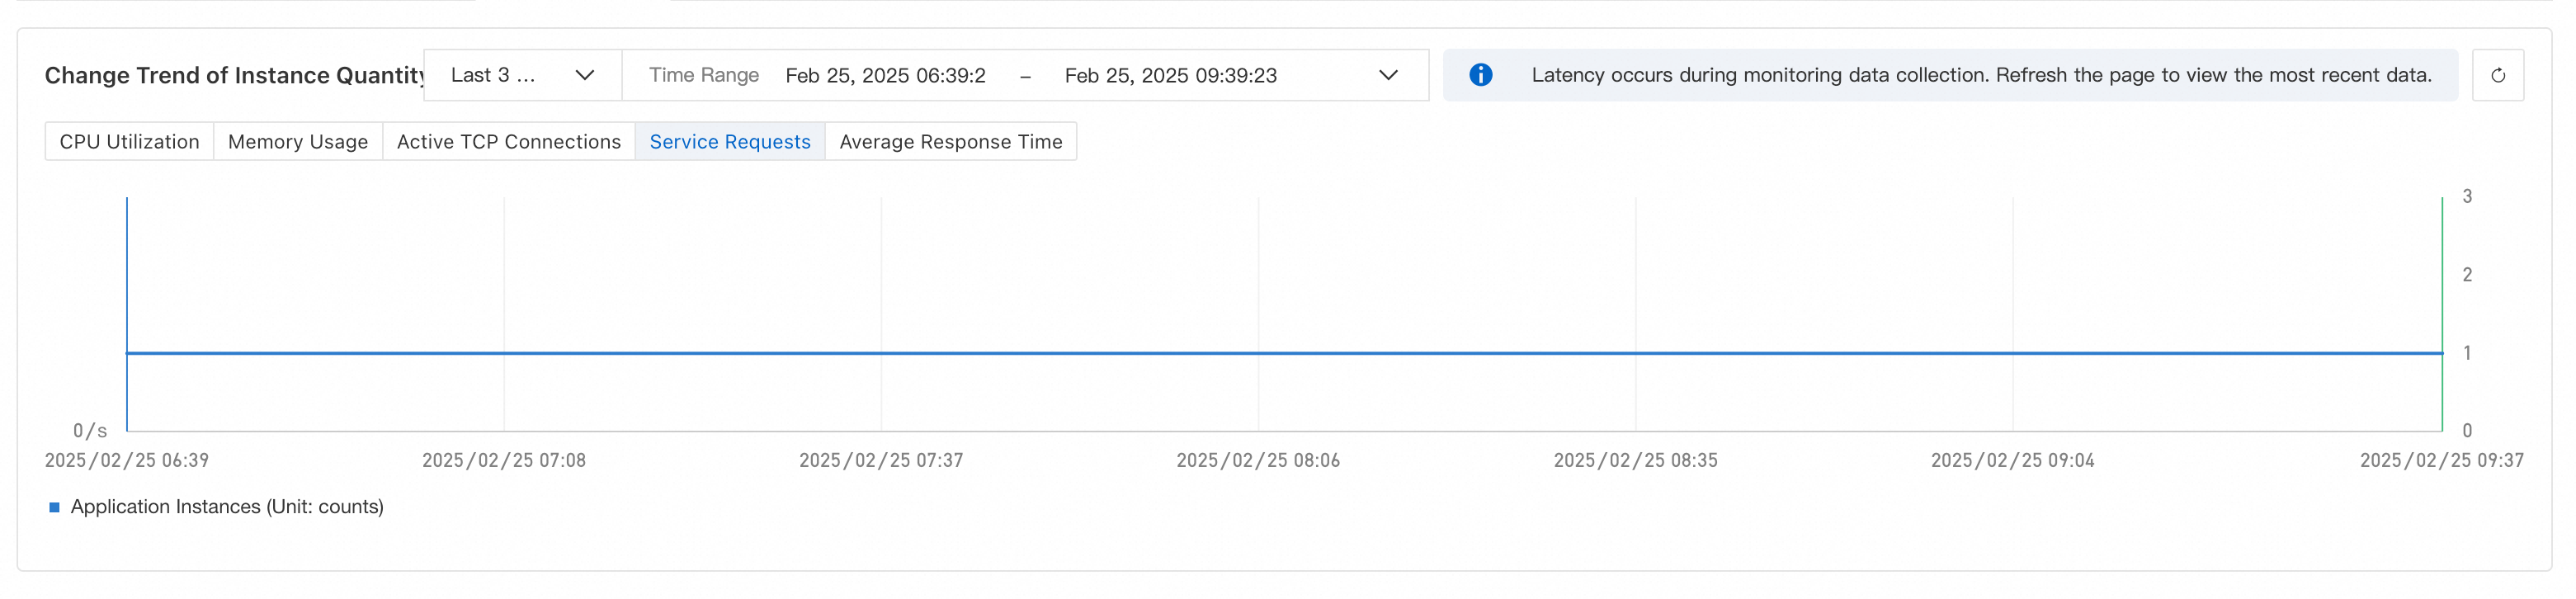
Présente le nombre de requêtes reçues par l'application sur la période sélectionnée.
Temps de réponse moyen
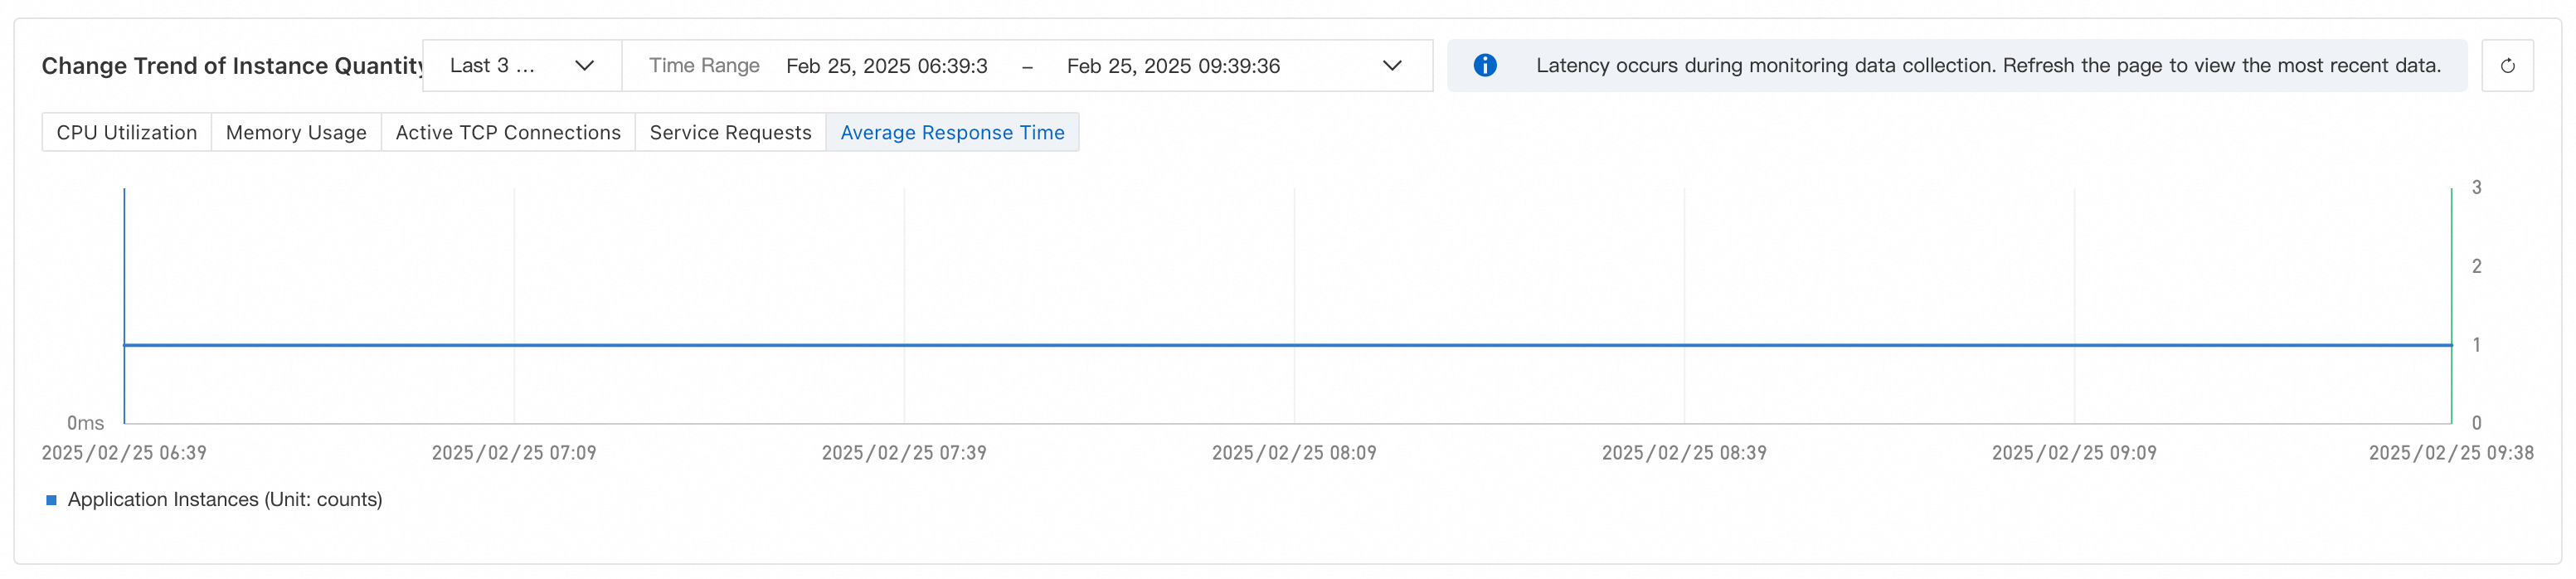
Indique le temps moyen nécessaire à l'application pour traiter une requête sur la période sélectionnée.