Cette rubrique explique comment effectuer une recherche vectorielle efficace dans RDS for PostgreSQL à l'aide de l'extension PASE, qui repose sur les algorithmes IVFFlat ou HNSW.
L'extension PASE n'est plus maintenue. Nous vous recommandons d'utiliser l'extension pgvector.
Prérequis
Votre instance exécute RDS for PostgreSQL versions 11 à 16.
Contexte
Ces dernières années, l'apprentissage de représentations, technologie clé du domaine de l'apprentissage profond, a connu des avancées significatives. Il est désormais largement utilisé dans des applications industrielles telles que la diffusion publicitaire, le paiement par reconnaissance faciale, ainsi que la reconnaissance d'images et vocale. Dans ces scénarios, les données sont intégrées sous forme de vecteurs haute dimension, et la recherche vectorielle permet de trouver des éléments similaires.
PASE (PostgreSQL ANN search extension) est une extension d'index de recherche vectorielle haute performance développée pour PostgreSQL. Elle utilise des algorithmes de recherche du plus proche voisin approximatif (ANN) matures, stables et efficaces, notamment les algorithmes IVFFlat et HNSW, pour permettre des requêtes vectorielles extrêmement rapides. PASE ne prend pas en charge l'extraction ni la génération de vecteurs de caractéristiques. Il vous incombe de générer les vecteurs de caractéristiques pour vos entités. PASE effectue ensuite des recherches de similarité sur le grand volume de vecteurs que vous avez générés.
Public cible
La lecture de cette rubrique suppose une connaissance de base de l'apprentissage automatique, des systèmes de recherche et de recommandation.
Notes d'utilisation
Un index peut devenir fragmenté. Vérifiez la taille d'un index en exécutant la commande
select pg_relation_size('index_name');. Reconstruisez l'index si sa taille devient nettement supérieure à celle des données et si les performances des requêtes se dégradent sensiblement.L'index peut perdre en précision après des mises à jour fréquentes des données. Pour garantir une précision absolue, reconstruisez l'index périodiquement.
Pour utiliser un index IVFFlat avec des centroïdes internes (
clustering_type=1), insérez des données dans la table avant de créer l'index.Utilisez un compte privilégié pour exécuter les exemples SQL de cette rubrique.
Algorithmes PASE
-
Algorithme IVFFlat
IVFFlat est une version simplifiée d'IVFADC, adaptée aux scénarios nécessitant un rappel élevé et pouvant tolérer une latence de requête modérée (de l'ordre de 100 ms). Par rapport à d'autres algorithmes, l'algorithme IVFFlat offre les avantages suivants :
Si le vecteur de requête fait partie de l'ensemble de données candidates, IVFFlat peut atteindre un rappel de 100 %.
La simplicité de l'algorithme permet une création d'index plus rapide et une empreinte de stockage réduite.
Vous pouvez spécifier les centroïdes et contrôler le rappel en ajustant des paramètres simples.
Les paramètres de l'algorithme sont hautement interprétables, ce qui vous donne un contrôle total sur la précision.
La figure suivante illustre le fonctionnement de l'algorithme IVFFlat.
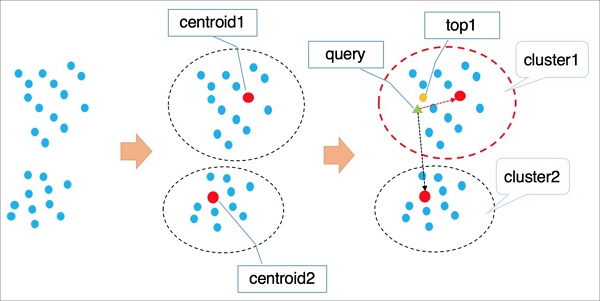
Le processus est le suivant :
Les vecteurs dans un espace haute dimension sont regroupés en clusters à l'aide d'un algorithme de clustering tel que k-means. Chaque cluster possède un centroïde.
Lors d'une recherche, l'algorithme parcourt d'abord les centroïdes de tous les clusters pour identifier les
nclusters dont les centroïdes sont les plus proches du vecteur cible.L'algorithme parcourt ensuite tous les éléments au sein de ces
nclusters et effectue un tri global pour trouver leskvecteurs les plus proches finaux.
RemarqueLors de la recherche des centroïdes, les clusters éloignés sont automatiquement exclus pour accélérer la requête. Cela signifie toutefois qu'il n'est pas garanti que les meilleurs vecteurs top-
kse trouvent tous dans lesnclusters sélectionnés, ce qui peut réduire la précision. Vous pouvez contrôler la précision de l'algorithme IVFFlat en ajustant le nombre de clusters à analyser,n. Une valeurnplus élevée augmente la précision, mais aussi la charge de calcul.La première étape d'IVFFlat et d'IVFADC est identique. La principale différence réside dans la deuxième étape du calcul. IVFADC utilise la quantification par produit pour éviter un calcul exhaustif, ce qui entraîne une certaine perte de précision. En revanche, IVFFlat utilise un calcul par force brute pour éviter cette perte tout en maintenant la charge de calcul gérable.
-
Algorithme HNSW
L'algorithme Hierarchical Navigable Small World (HNSW) convient aux ensembles de données vectorielles très volumineux (dizaines de millions ou plus) et aux scénarios ayant des exigences strictes en matière de latence de requête (de l'ordre de 10 ms).
HNSW est un algorithme basé sur un graphe qui parcourt rapidement un graphe de proximité pour trouver des voisins potentiels proches. L'amélioration des performances de l'algorithme HNSW est plus significative avec de grands ensembles de données par rapport à d'autres algorithmes. Toutefois, le stockage des points voisins consomme de l'espace de stockage supplémentaire, et l'ajustement des paramètres seuls offre des rendements décroissants pour améliorer le rappel.
La figure suivante illustre le fonctionnement de l'algorithme HNSW.
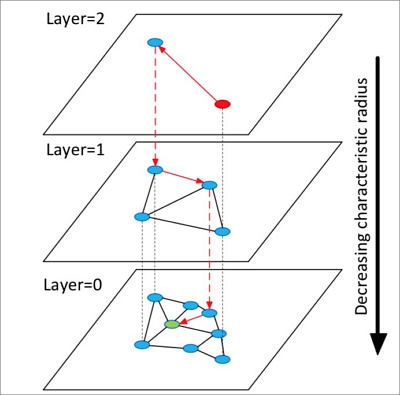
Le processus est le suivant :
L'algorithme construit un graphe multicouche, où chaque couche est une version plus clairsemée de celle située en dessous et agit comme une liste sautante, semblable à un système autoroutier, pour la couche inférieure.
La recherche commence à partir d'un point sélectionné aléatoirement dans la couche supérieure.
L'algorithme trouve les voisins du point de départ et les stocke dans une liste dynamique de taille fixe, ordonnée selon leur distance par rapport à la cible. Lors des étapes suivantes, il prend les points de la liste dynamique, trouve leurs voisins et insère ces voisins nouvellement découverts dans la liste. La liste est retriée après chaque insertion, en ne conservant que les
kpremiers points. Ce processus se poursuit de manière itérative jusqu'à ce que la liste se stabilise. Le premier point de la liste stabilisée est alors utilisé comme point d'entrée pour la couche suivante vers le bas.Ce processus est répété pour chaque couche jusqu'à ce que la recherche atteigne la couche inférieure.
RemarqueL'algorithme HNSW s'appuie sur le graphe monocouche de l'algorithme NSW en construisant un graphe multicouche. La recherche des plus proches voisins dans ce graphe peut atteindre un ratio d'accélération plus élevé que les algorithmes basés sur le clustering.
Chaque algorithme a des cas d'utilisation spécifiques. Par exemple, l'algorithme IVFFlat convient à la comparaison d'images haute précision, tandis que l'algorithme HNSW est idéal pour la récupération dans les scénarios de recherche et de recommandation.
Utiliser PASE
Procédure
-
Créez l'extension PASE. Exécutez la commande suivante :
CREATE EXTENSION pase; -
Calculez la similarité vectorielle. Utilisez l'une des deux méthodes de constructeur suivantes pour calculer la similarité vectorielle :
-
Utilisez le constructeur de type de données PASE
Exemples
SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[]) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0, 1) AS distance;RemarqueL'opérateur
<?>calcule la similarité entre un vecteur gauche (float4[]) et un vecteur droit (pase).Le type
paseest un type de données défini au sein de l'extension. Il dispose de trois méthodes de constructeur, comme illustré dans les exemples. Prenonspase(ARRAY[3, 1, 1]::float4[], 0, 1)comme exemple : le premier paramètre estfloat4[]et représente le vecteur droit. Le deuxième paramètre n'est pas utilisé dans ce contexte et peut être défini sur 0. Le troisième paramètre spécifie la méthode de calcul de la similarité :0pour la distance euclidienne et1pour le produit scalaire (produit interne).Les dimensions des vecteurs gauche et droit doivent être égales. Sinon, le calcul échoue.
-
Utilisez le constructeur de chaîne
Exemples
SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0:1'::pase AS distance;RemarqueLe constructeur de chaîne et le constructeur de type de données PASE calculent tous deux la similarité entre deux vecteurs. La différence réside dans le fait que le constructeur de chaîne utilise des deux-points (
:) comme délimiteurs. Prenons'3,1,1:0:1'comme exemple : la première partie représente le vecteur droit. La deuxième partie n'est pas utilisée dans ce contexte et peut être définie sur 0. La troisième partie spécifie la méthode de calcul de la similarité :0pour la distance euclidienne et1pour le produit scalaire (produit interne).
-
-
Créez un index. Utilisez l'un des deux algorithmes suivants :
RemarqueLors de l'utilisation d'un index vectoriel PASE avec la distance euclidienne comme métrique de similarité, vous n'avez pas besoin de traiter les vecteurs d'origine. Toutefois, pour utiliser le produit interne ou la similarité cosinus comme métrique, vous devez normaliser les vecteurs. Si le vecteur d'origine est
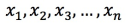 , il doit satisfaire
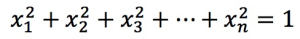 . Après normalisation, les valeurs du produit interne et de la similarité cosinus sont équivalentes en termes de classement.
-
Créez un index en utilisant l'algorithme IVFFlat
CREATE INDEX ivfflat_idx ON table_name
USING
  pase_ivfflat(column_name)
WITH
  (clustering_type = 1, distance_type = 0, dimension = 256, base64_encoded = 0, clustering_params = "10,100");
Le tableau suivant décrit les paramètres.
Paramètre
Description
clustering_type
La méthode de clustering pour l'algorithme IVFFlat. Ce paramètre est requis. Valeurs valides :
-
0: Clustering externe. Charge un fichier de centroïdes externe spécifié par le paramètre clustering_params. -
1: Clustering interne. Effectue une opération de clustering en interne lors de la création de l'index à l'aide de l'algorithme k-means. Ceci est contrôlé par le paramètre clustering_params.
Pour les nouveaux utilisateurs, nous vous recommandons d'utiliser le clustering interne.
distance_type
La méthode de calcul de la similarité. Par défaut :
0. Valeurs valides :-
0: Distance euclidienne. -
1: Produit scalaire (produit interne). Pour utiliser cette méthode, vous devez normaliser les vecteurs. Dans ce cas, le classement des valeurs du produit scalaire (produit interne) est l'inverse du classement des valeurs de la distance euclidienne.
Actuellement, seule la distance euclidienne est directement prise en charge pour l'indexation. Pour utiliser le produit scalaire (produit interne), vous devez normaliser les vecteurs et utiliser la méthode fournie dans l'Annexe.
dimension
La dimension du vecteur. Ce paramètre est requis. La dimension maximale prise en charge est 512.
base64_encoded
Indique si les données sont encodées en Base64. Par défaut :
0. Valeurs valides :-
0: Le type de vecteur estfloat4[]. -
1: Le type de vecteur est une chaîne encodée en Base64 d'un tableau de flottants.
clustering_params
Pour le clustering externe, ce paramètre spécifie le chemin d'accès au fichier de centroïdes. Pour le clustering interne, il spécifie les paramètres de clustering au format
"clustering_sample_ratio,k". Ce paramètre est requis.-
clustering_sample_ratio: Le ratio d'échantillonnage pour le clustering, avec 1000 comme dénominateur. La plage valide est un entier compris dans(0, 1000]. Par exemple, une valeur de1signifie que 1/1000e des données de la table est échantillonné pour le clustering k-means. Une valeur plus élevée améliore la précision de la requête mais augmente le temps de création de l'index. Nous vous recommandons de veiller à ce que le nombre total de points de données échantillonnés ne dépasse pas 100 000. -
k: Le nombre de centroïdes. Une valeur plus élevée améliore la précision de la requête mais augmente le temps de création de l'index. Nous vous recommandons une valeur comprise dans la plage[100, 1000].
-
-
Créez un index en utilisant l'algorithme HNSW
CREATE INDEX hnsw_idx ON table_name
USING
  pase_hnsw(column_name)
WITH
  (dim = 256, base_nb_num = 16, ef_build = 40, ef_search = 200, base64_encoded = 0);
Le tableau suivant décrit les paramètres.
Paramètre
Description
dim
Dimension du vecteur. Requis. La plage de valeurs est
[8 512].base_nb_num
Le nombre de voisins pour chaque nœud dans le graphe. Ce paramètre est requis. Une valeur plus élevée améliore la précision de la requête mais augmente le temps de création de l'index et la taille de l'index. La plage de valeurs recommandée est
[16-128].ef_build
La longueur du tas pour le processus de création de l'index. Ce paramètre est requis. Une valeur plus grande fournit de meilleurs résultats mais ralentit le processus de création. La plage de valeurs recommandée est
[40 400].ef_search
La longueur du tas pour la requête. Il s'agit d'un paramètre requis. Une valeur plus grande améliore la qualité des résultats mais dégrade les performances de la requête. La valeur doit être comprise dans la plage
[10 400].base64_encoded
Indique si les données sont encodées en Base64. Par défaut :
0. Valeurs valides :-
0: Le type de vecteur estfloat4[]. -
1: Le type de vecteur est une chaîne encodée en Base64 d'un tableau de flottants.
-
-
-
Exécutez une requête. Interrogez les données en utilisant l'un ou l'autre type d'index :
-
Requête en utilisant un index IVFFlat
SELECT id, vector <#> '1,1,1'::pase as distance FROM table_name ORDER BY vector <#> '1,1,1:10:0'::pase ASC LIMIT 10;RemarqueL'opérateur
<#>est utilisé pour interroger un index IVFFlat.L'index vectoriel est activé par la clause
ORDER BY. Il prend en charge l'ordre de tri croissant (ASC).Le type de données pase se compose de trois parties séparées par des deux-points (:). Par exemple, dans
1,1,1:10:0, la première partie est le vecteur de requête. La deuxième partie est un paramètre de requête pour IVFFlat avec une plage de valeurs de(0,1000]. Une valeur plus élevée entraîne une précision de requête plus élevée mais des performances de requête plus faibles. Il est recommandé de déterminer la valeur optimale en effectuant un débogage basé sur vos données réelles. La troisième partie spécifie la méthode de calcul de la similarité pour la requête, où 0 indique la distance euclidienne et 1 indique le produit scalaire (produit interne). Si vous utilisez la méthode du produit scalaire (produit interne), vous devez effectuer une normalisation vectorielle. Dans ce cas, l'ordre des valeurs du produit scalaire (produit interne) est l'inverse de l'ordre des valeurs de la distance euclidienne.
-
Requête en utilisant un index HNSW
SELECT id, vector <?> '1,1,1'::pase as distance FROM table_name ORDER BY vector <?> '1,1,1:100:0'::pase ASC LIMIT 10;RemarqueL'opérateur
<?>est utilisé pour interroger un index HNSW.L'index vectoriel est activé par la clause
ORDER BY. Il prend en charge l'ordre de tri croissant (ASC).Le type de données
pasea un format en trois parties, avec des parties séparées par des deux-points (:). Dans l'exemple1,1,1:100:0, la première partie est le vecteur de requête. La deuxième partie est le paramètre d'effet de requête HNSW, qui a une plage de valeurs de(0,∞). Une valeur plus élevée entraîne une précision de requête plus élevée mais des performances de requête plus faibles. Nous vous recommandons de déterminer cette valeur en effectuant un débogage avec vos données réelles et de commencer par une valeur initiale de 40. La troisième partie spécifie la méthode de calcul de la similarité pour la requête, où 0 indique la distance euclidienne et 1 indique le produit scalaire (produit interne). Lorsque vous utilisez la méthode du produit scalaire (produit interne), la normalisation vectorielle est requise. Dans ce cas, l'ordre des valeurs du produit scalaire (produit interne) est l'inverse de l'ordre des valeurs de la distance euclidienne.
-
Exemple
Cet exemple montre comment interroger des données en utilisant un index IVFFlat.
-
Créez l'extension PASE. Exécutez la commande suivante :
CREATE EXTENSION pase; -
Créez une table de test et insérez des données de test.
Créez une table de test.
CREATE TABLE vectors_table ( id SERIAL PRIMARY KEY, vector float4[] NOT NULL );Insérez des données de test.
INSERT INTO vectors_table (vector) VALUES ('{1.0, 0.0, 0.0}'), ('{0.0, 1.0, 0.0}'), ('{0.0, 0.0, 1.0}'), ('{0.0, 0.5, 0.0}'), ('{0.0, 0.5, 0.0}'), ('{0.0, 0.6, 0.0}'), ('{0.0, 0.7, 0.0}'), ('{0.0, 0.8, 0.0}'), ('{0.0, 0.0, 0.0}'); -
Créez un index en utilisant l'algorithme IVFFlat.
CREATE INDEX ivfflat_idx ON vectors_table USING pase_ivfflat(vector) WITH (clustering_type = 1, distance_type = 0, dimension = 3, base64_encoded = 0, clustering_params = "10,100"); -
Interrogez les données en utilisant l'index IVFFlat.
SELECT id, vector <#> '1,1,1'::pase as distance
FROM vectors_table
ORDER BY
vector <#> '1,1,1:10:0'::pase
ASC LIMIT 10;
Annexe
-
Exemple de calcul du produit scalaire (produit interne)
Cet exemple utilise un index d'algorithme HNSW. Le code suivant montre comment créer une fonction :
CREATE OR REPLACE FUNCTION inner_product_search(query_vector text, ef integer, k integer, table_name text) RETURNS TABLE (id integer, uid text, distance float4) AS $$ BEGIN RETURN QUERY EXECUTE format(' select a.id, a.vector <?> pase(ARRAY[%s], %s, 1) AS distance from (SELECT id, vector FROM %s ORDER BY vector <?> pase(ARRAY[%s], %s, 0) ASC LIMIT %s) a ORDER BY distance DESC;', query_vector, ef, table_name, query_vector, ef, k); END $$ LANGUAGE plpgsql;RemarquePour les vecteurs normalisés, le produit interne est égal à la similarité cosinus. Par conséquent, vous pouvez utiliser la même méthode pour calculer la similarité cosinus.
-
Fichier de centroïdes personnalisé pour un index IVFFlat
Il s'agit d'une fonctionnalité avancée. Pour utiliser cette fonctionnalité, téléchargez un fichier de centroïdes vers un chemin spécifié sur le serveur et utilisez-le comme paramètre d'index pour construire l'index. Pour plus d'informations sur les paramètres, consultez Paramètres de l'index IVFFlat. Le format du fichier est le suivant :
vector_dimension|number_of_centroids|set_of_centroid_vectorsExemple
3|2|1,1,1,2,2,2
Documents connexes
-
Product Quantization for Nearest Neighbor Search
Hervé Jégou, Matthijs Douze et Cordelia Schmid.
-
Yu. A. Malkov et D. A. Yashunin.