pgvector ajoute des fonctionnalités de stockage vectoriel et de recherche par similarité à ApsaraDB RDS for PostgreSQL. Utilisez cette extension pour stocker les embeddings générés par des modèles d'apprentissage automatique et interrogez-les en vous basant sur la distance cosinus, la distance euclidienne ou le produit scalaire.
Fonctionnement
Les embeddings sont des représentations numériques de données (texte, images, audio ou vidéo) exprimées sous forme de vecteurs dans un espace à haute dimensionnalité. Les objets sémantiquement similaires correspondent à des vecteurs proches les uns des autres.
Par exemple, si vous représentez une pomme par [1, 1], une banane par [1.2, 0.8] et un chat par [6, 0.4], une recherche vectorielle classera la banane comme l'élément le plus similaire à la pomme, car ces deux fruits partagent des propriétés communes.
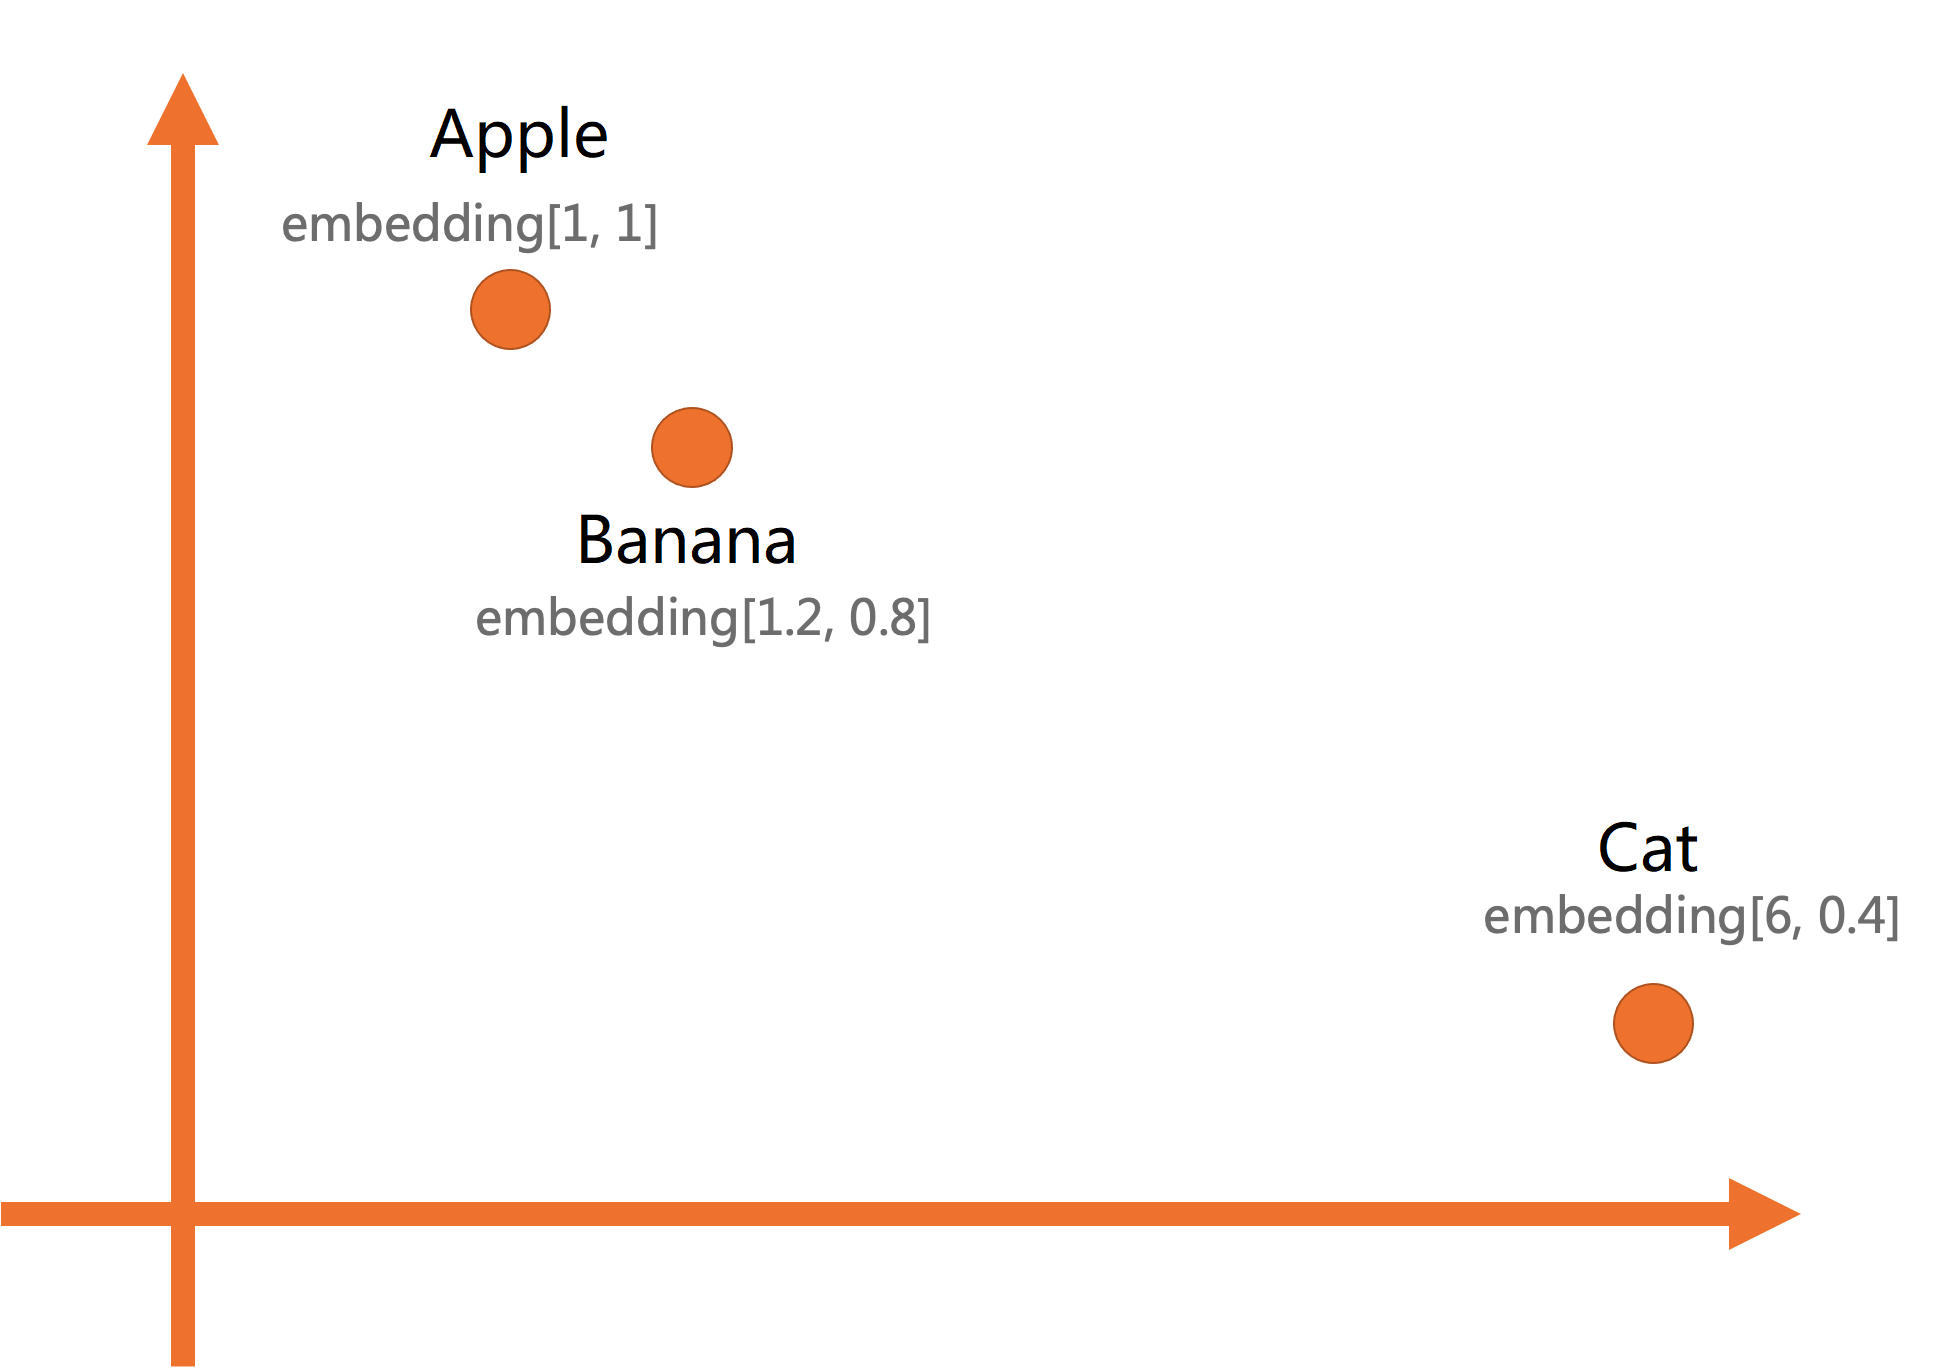
pgvector prend en charge :
Les recherches exactes du plus proche voisin et les recherches approximatives du plus proche voisin (ANN).
Les index HNSW (Hierarchical Navigable Small World) et les index parallèles IVFFLAT pour accélérer les recherches ANN.
Les vecteurs comportant jusqu'à 16 000 dimensions ; les index sur les vecteurs comportant jusqu'à 2 000 dimensions.
Les métriques de distance : distance euclidienne L2, similarité cosinus et produit scalaire.
Des opérations supplémentaires : distance L1, multiplication élément par élément et agrégation par somme.
Prérequis
Avant de commencer, assurez-vous que :
Votre instance RDS exécute PostgreSQL 14 ou une version ultérieure, avec une version mineure du moteur 20230430 ou supérieure. Pour PostgreSQL 17, la version mineure du moteur doit être 20241030 ou supérieure.
Un compte privilégié existe pour l'instance RDS.
Pour mettre à niveau la version majeure du moteur, consultez la rubrique Mettre à niveau la version majeure du moteur d'une instance ApsaraDB RDS for PostgreSQL . Pour mettre à jour la version mineure du moteur, consultez la rubrique Mettre à jour la version mineure du moteur d'une instance ApsaraDB RDS for PostgreSQL . Pour créer un compte privilégié, consultez la rubrique Créer un compte .
Installer l'extension
Installation depuis la console (recommandée)
Accédez à la page Instances. Dans la barre de navigation supérieure, sélectionnez la région où se trouve votre instance RDS. Cliquez sur l'ID de l'instance.
Dans le volet de navigation de gauche, cliquez sur Plug-ins.
-
Sous l'onglet Extension Marketplace, localisez l'extension vectorielle et cliquez sur Install. Vous pouvez également basculer vers l'onglet Extension Management, rechercher l'extension vectorielle, puis cliquer sur Install dans la colonne Actions.
Dans la boîte de dialogue, définissez les champs Database Name et Database Account, puis cliquez sur Install.
L'extension est installée lorsque l'état de l'instance passe de Maintaining Instance à Running.
Pour mettre à jour ou désinstaller l'extension :
Sous l'onglet Extension Management, accédez à la section Installed Extensions, localisez l'extension, puis cliquez sur Upgrade Version ou Uninstall dans la colonne Actions.
Si l'option Upgrade Version n'est pas affichée, cela signifie que l'extension est déjà à sa dernière version.
Installation avec SQL
Ces opérations nécessitent un compte privilégié. Pour en créer un, consultez la rubrique Créer un compte.
-- Create
CREATE EXTENSION IF NOT EXISTS vector;

-- Update
ALTER EXTENSION vector UPDATE [ TO new_version ];

-- Delete
DROP EXTENSION vector;
new_version correspond à la version cible de l'extension pgvector. Pour consulter l'historique des versions et les fonctionnalités associées, reportez-vous à la documentation pgvector .Stocker et interroger des vecteurs
Cette section décrit la procédure de stockage des embeddings et l'exécution de recherches par similarité. Pour obtenir la référence complète de l'API, consultez la documentation pgvector.
Créer une table
CREATE TABLE items (
  id        bigserial PRIMARY KEY,
  item      text,
  embedding vector(2)
);
Cet exemple utilise des vecteurs à 2 dimensions à titre illustratif. pgvector prend en charge jusqu'à 16 000 dimensions.
Insérer des vecteurs
INSERT INTO items (item, embedding)
VALUES
  ('Apple',  '[1,1]'),
  ('Banana', '[1.2,0.8]'),
  ('Cat',    '[6,0.4]');
Interroger par similarité
Utilisez un opérateur de distance pour classer les résultats par similarité. Plus la distance est courte, plus les éléments sont similaires.
Opérateurs de distance :
| Operator | Metric |
|---|---|
<-> |
Distance L2 (euclidienne) |
<=> |
Distance cosinus |
<#> |
Produit scalaire |
Requête de similarité de base :
-- Find items most similar to Banana, ranked by cosine distance
SELECT item,
       embedding <=> '[1.2, 0.8]' AS cosine_distance
FROM items
ORDER BY cosine_distance;
Exemple de sortie :
  item  |    cosine_distance
--------+------------------------
 Banana |                      0
 Apple  | 0.019419362524530137
 Cat    | 0.13289443670962842
Une distance de
0indique une correspondance exacte.Une distance de
0.019indique une forte similarité.Une distance de
0.133indique une faible similarité.
Vous pouvez spécifier un seuil de similarité adapté à vos besoins métier afin d'exclure les résultats présentant une faible similarité.
Créer des index
Sans index, pgvector effectue une recherche exacte sur l'intégralité de la table. Pour les grands ensembles de données, créez un index vectoriel afin d'accélérer les recherches ANN.
Créer un index HNSW
CREATE INDEX ON items USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
Paramètres :
| Parameter | Description |
|---|---|
m |
Nombre maximal de connexions par nœud à chaque niveau. Des valeurs plus élevées augmentent la densité du graphe, le taux de rappel ainsi que le temps nécessaire à la création et à l'interrogation de l'index. |
ef_construction |
Taille de l'ensemble de candidats lors de la construction de l'index. Des valeurs plus élevées améliorent le taux de rappel, au détriment du temps requis pour créer et interroger l'index. |
Méthodes d'accès (champ vector_cosine_ops) :
| Value | Distance metric |
|---|---|
vector_cosine_ops |
Distance cosinus |
vector_l2_ops |
Distance L2 (euclidienne) |
vector_ip_ops |
Produit scalaire |
Créer un index IVF
CREATE INDEX ON items USING ivfflat (embedding vector_cosine_ops)
WITH (lists = 100);
Paramètres :
| Parameter | Description |
|---|---|
lists |
Nombre de listes dans lesquelles l'ensemble de données est partitionné. Un nombre plus élevé de listes accélère la recherche, mais peut réduire le taux de rappel. Si lists > 2000, l'erreur suivante peut survenir : ERROR: memory required is xxx MB, maintenance_work_mem is xxx MB — augmentez la valeur de maintenance_work_mem pour résoudre ce problème. Consultez la rubrique Définir les paramètres de l'instance. |
ivfflat.probes |
Nombre de listes à parcourir lors d'une requête. Un nombre plus élevé de sondes améliore le taux de rappel, mais ralentit la recherche. |
Définissez ivfflat.probes au niveau de la session ou de la transaction :
-- Session level
SET ivfflat.probes = 10;

-- Transaction level
BEGIN;
SET LOCAL ivfflat.probes = 10;
SELECT ...;
COMMIT;Si la valeur de ivfflat.probes est égale à la valeur de lists utilisée lors de la création de l'index, l'index est ignoré et une analyse complète de la table est effectuée. Cela peut dégrader considérablement les performances de recherche.
Ajustez les paramètres ivfflat.probes et lists en fonction de votre ensemble de données et de vos exigences en matière de taux de rappel.
Données de performance
Pour consulter les données de benchmark relatives aux index HNSW et IVF, reportez-vous aux rubriques suivantes :
Étapes suivantes
Développez des applications d'IA de production en vous appuyant sur pgvector :