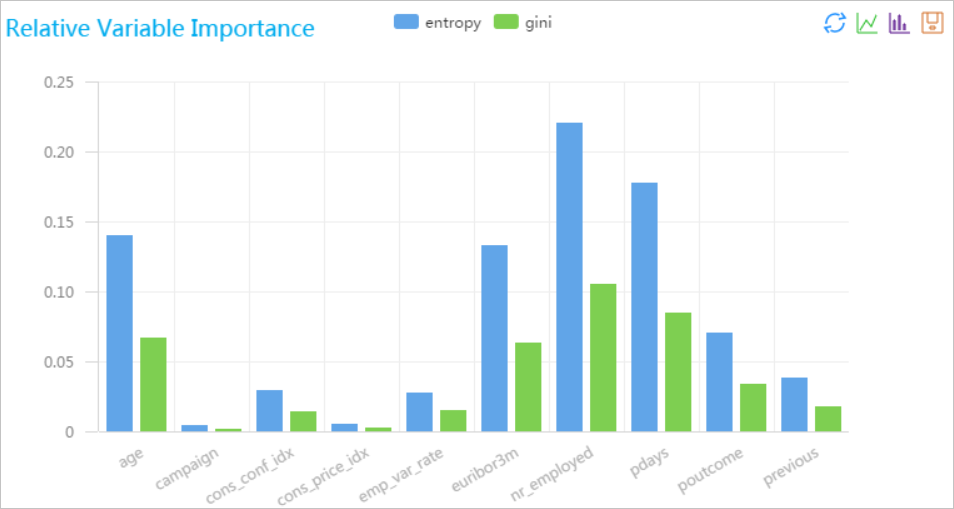
L'évaluation de l'importance des caractéristiques avec Random Forest analyse la contribution de chaque caractéristique aux résultats de prédiction d'un modèle de forêt aléatoire. Elle détermine l'importance des caractéristiques en calculant la diminution moyenne de l'impureté pour chaque caractéristique dans l'ensemble des arbres de décision, ou en utilisant l'importance par permutation. Ce processus identifie les caractéristiques ayant l'impact le plus significatif sur les performances du modèle.
Configuration du composant
Méthode 1 : Interface graphique
Dans Machine Learning Designer, ajoutez le composant Random Forest Feature Importance Evaluation à votre pipeline et configurez ses paramètres dans le volet de droite :
|
Onglet |
Paramètre |
Description |
|
Paramètres des champs |
Colonnes de caractéristiques |
Les colonnes de caractéristiques à utiliser depuis la table d'entrée. Ce paramètre est facultatif. Par défaut, toutes les colonnes sauf la colonne d'étiquette sont sélectionnées. |
|
Colonne cible |
Obligatoire. |
|
|
Paramètres |
Cœurs de calcul parallèle |
Le nombre de cœurs pour le calcul parallèle. |
|
Taille de la mémoire par cœur |
La taille de la mémoire par cœur, en Mo. |
Méthode 2 : Commande PAI
Configurez le composant Random Forest Feature Importance Evaluation en exécutant une commande PAI dans le composant SQL Script. Pour plus d'informations, consultez la rubrique Scénario 4 : Exécuter des commandes PAI dans le composant SQL Script.
pai -name feature_importance -project algo_public
    -DinputTableName=pai_dense_10_10
    -DmodelName=xlab_m_random_forests_1_20318_v0
    -DoutputTableName=erkang_test_dev.pai_temp_2252_20319_1
    -DlabelColName=y
    -DfeatureColNames="pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign,poutcome"
-Dlifecycle=28 ;|
Paramètre |
Obligatoire |
Valeur par défaut |
Description |
|
inputTableName |
Oui |
Aucune |
Le nom de la table d'entrée. |
|
outputTableName |
Oui |
Aucune |
Le nom de la table de sortie. |
|
labelColName |
Oui |
Aucune |
Le nom de la colonne d'étiquette dans la table d'entrée. |
|
modelName |
Oui |
Aucune |
Le nom du modèle d'entrée. |
|
featureColNames |
Non |
Toutes les colonnes sauf la colonne d'étiquette |
Les colonnes de caractéristiques à utiliser depuis la table d'entrée. |
|
inputTablePartitions |
Non |
La table entière |
Les partitions à utiliser depuis la table d'entrée. |
|
lifecycle |
Non |
Non spécifié |
Le cycle de vie de la table de sortie. |
|
coreNum |
Non |
Calculé automatiquement |
Le nombre de cœurs. |
|
memSizePerCore |
Non |
Calculé automatiquement |
La taille de la mémoire par cœur, en Mo. |
Exemple
-
Utilisez une instruction SQL pour générer des données d'entraînement.
Cet exemple crée une table nommée
pai_dense_10_10en sélectionnant des colonnes spécifiques et les 10 premières lignes de la tablebank_data. Vous pouvez créer une table en fonction de vos besoins métier réels.drop table if exists pai_dense_10_10; create table pai_dense_10_10 as select age,campaign,pdays, previous, poutcome, emp_var_rate, cons_price_idx, cons_conf_idx, euribor3m, nr_employed, y from bank_data limit 10; -
Construisez le pipeline. Pour plus d'informations, consultez la rubrique Pipelines personnalisés.
Définissez
ycomme colonne d'étiquette et toutes les autres colonnes comme colonnes de caractéristiques. Pour le paramètre Columns Forced to Convert, sélectionnezageetcampaignafin de les traiter comme des caractéristiques énumérées. Conservez les valeurs par défaut pour tous les autres paramètres.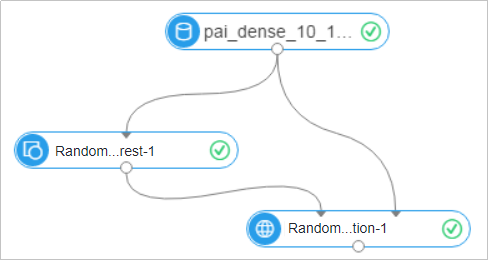
-
Exécutez le pipeline et consultez les résultats. La sortie suivante affiche les valeurs d'importance des caractéristiques générées par le composant Random Forest Feature Importance Evaluation.
colname                gini                        entropy
age                    0.06625000000000003          0.13978726292803723
campaign               0.00175000000000003          0.00434851554559677
cons_conf_idx          0.01399999999999999          0.0290840949701885
cons_price_idx         0.002                        0.00498044991346125
emp_var_rate           0.01470000000000003          0.0267863068026093
euribor3m              0.06300000000000003          0.132193634884603
nr_employed            0.10499999999999998          0.220322724807673
pdays                  0.0845                       0.177503292343975
poutcome               0.03360000000000001          0.070503271938455
previous               0.01770000000000004          0.038103810058015
Une fois l'exécution terminée, cliquez avec le bouton droit sur le composant Random Forest Feature Importance Evaluation et sélectionnez View Analytics Report.