LangStudio propose des nœuds de workflow prédéfinis pour le contrôle du flux, les LLM, les agents, la récupération de données, l'analyse de documents, la reconnaissance vocale et les scripts Python.
Contrôle du flux
Start
Un application flow ne peut comporter qu'un seul nœud Start.
Le nœud Start marque le début de l'exécution et déclare les paramètres d'entrée du application flow.
-
Pour les flux conversationnels, le système fournit deux champs par défaut : l'historique des conversations et l'entrée utilisateur. Ajoutez des variables personnalisées selon vos besoins. Pour accepter les fichiers téléchargés par l'utilisateur, définissez une variable d'entrée avec le type de fichier. Pour plus de détails, consultez Entrée et sortie de type fichier.
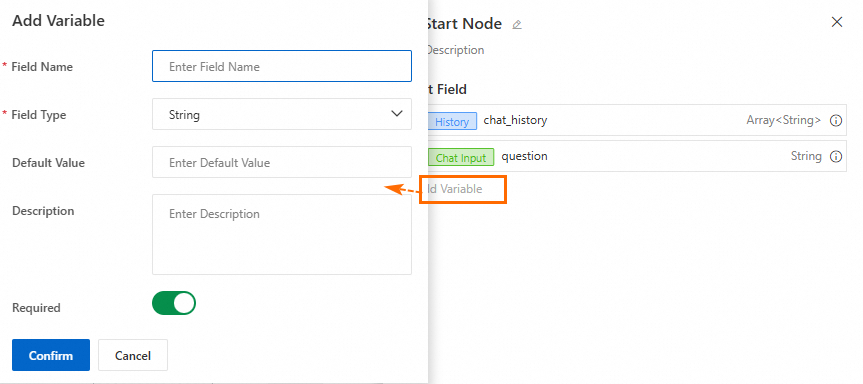
-
Lorsque vous exécutez le application flow, configurez les paramètres d'entrée pour la session en cours dans le panneau de conversation.
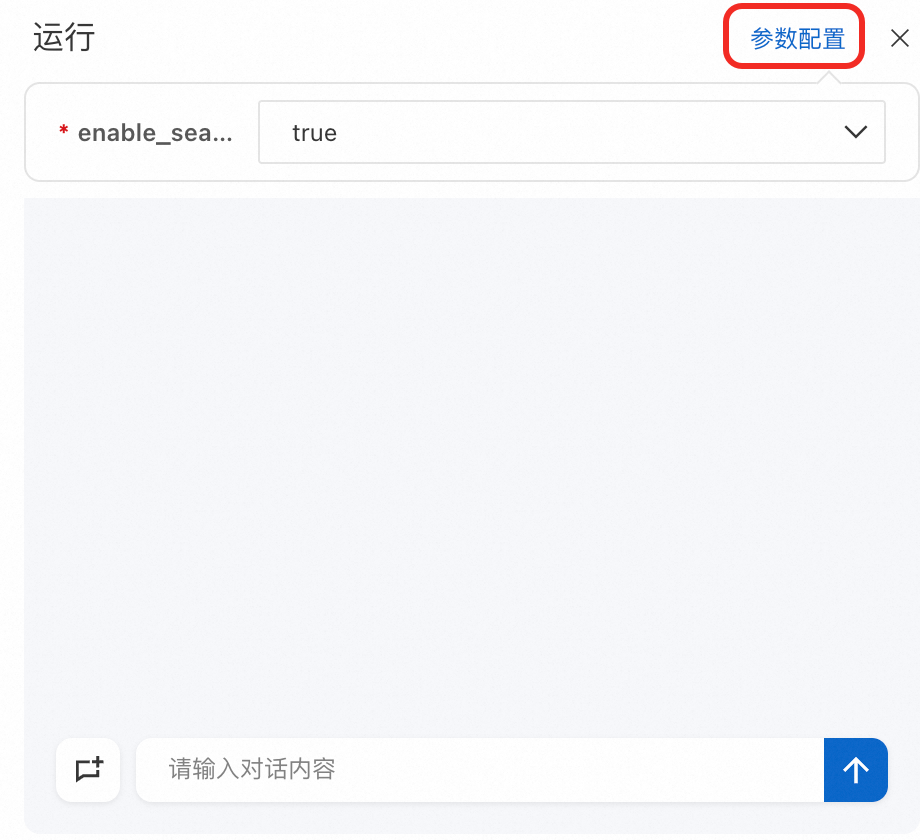
Conditional branch
Ce nœud implémente la logique if-else pour le contrôle du flux. Il évalue les conditions et dirige l'exécution vers la première branch correspondante. Si aucune condition n'est true, la else branch s'exécute. Associez ce nœud au nœud Variable aggregate pour fusionner les résultats provenant de différentes branches.
-
Configuration
-
Input
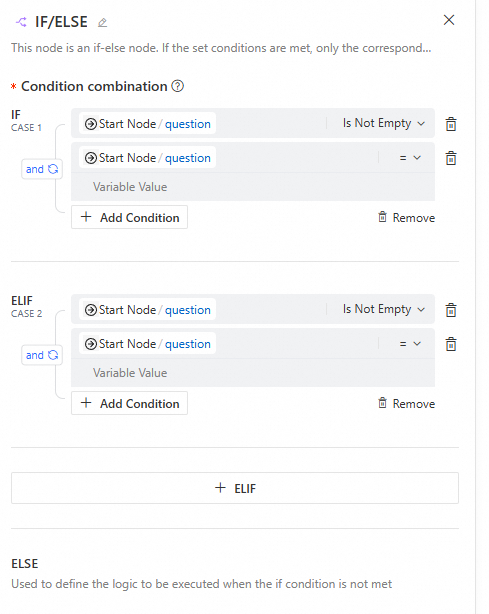
Lorsque vous configurez les conditions de branche, tenez compte des points suivants :
Chaque branche représente un chemin d'exécution. La dernière branche est la else branch, qui s'exécute lorsqu'aucune autre condition ne correspond et qui ne peut pas être modifiée.
Chaque branche peut contenir plusieurs conditions, combinables à l'aide de la logique ET/OU.
Vérifiez les sorties des nœuds en amont, les opérateurs (tels que
=,≠,is emptyetdoes not include), ainsi que les valeurs, afin de garantir des conditions précises et valides.
-
Output
Ce nœud ne produit aucune sortie.
-
Exemple d'utilisation
Lorsque vous connectez le nœud Conditional branch à des nœuds en aval, chaque branche dispose d'un port de connexion correspondant. Si une condition de branche est remplie, le système exécute les nœuds en aval de cette branche et ignore les autres branches. Utilisez un nœud Variable aggregate pour collecter les résultats d'exécution de la branche active.
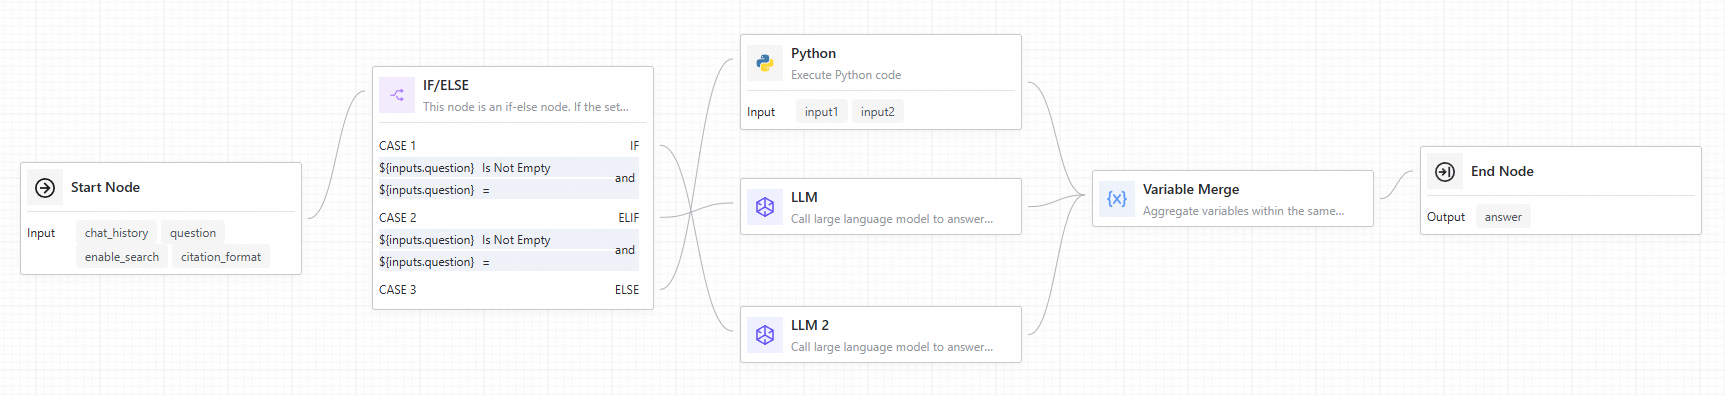
Variable aggregate
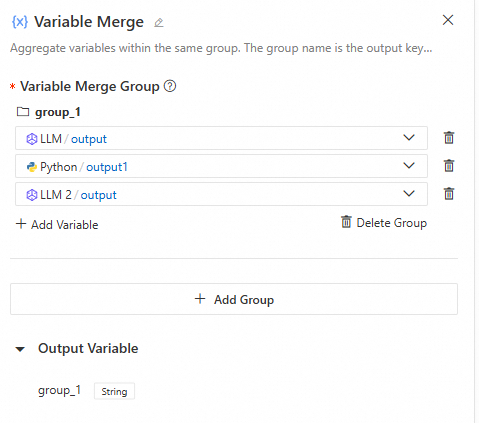
Ce nœud fusionne les résultats de sortie de différentes branches en variables unifiées. Lorsqu'un nœud Conditional branch ou Intent recognition s'exécute, une seule branche est activée. Ce nœud permet aux nœuds en aval de référencer une seule variable agrégée, quelle que soit la branche exécutée, évitant ainsi une logique redondante.
-
Configuration
-
Input
Lorsque vous configurez les groupes de variables, tenez compte des points suivants :
Les nœuds en amont sont généralement plusieurs branches d'exécution générées par un nœud Conditional branch ou Intent recognition.
Les variables au sein d'un même groupe doivent être du même type. La première valeur non vide devient la sortie pour ce groupe.
Étant donné qu'une seule branche en amont s'exécute, chaque groupe aura au maximum une valeur non vide. Le nœud Variable aggregate extrait cette valeur pour une utilisation par les nœuds en aval.
Si chaque branche possède plusieurs sorties à collecter, vous pouvez ajouter plusieurs groupes pour extraire chaque valeur de sortie correspondante.
-
Output
Les variables de sortie du nœud dépendent des groupes configurés. S'il existe plusieurs groupes, le nœud génère une paire clé-valeur pour chaque groupe, où la clé est le nom du groupe et la valeur est la première variable non vide de ce groupe.
-
Exemple d'utilisation
Consultez le cas d'utilisation du nœud Conditional branch.
Loop
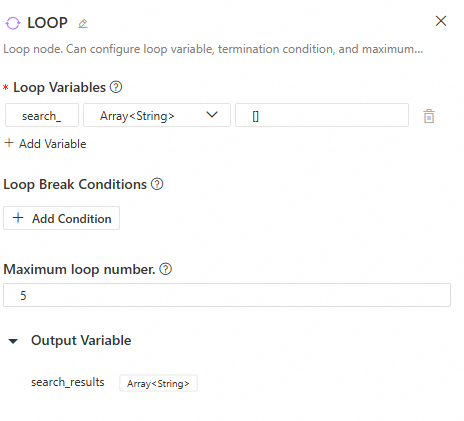
Le nœud Loop exécute des tâches répétitives où chaque itération dépend du résultat précédent. La boucle se poursuit jusqu'à ce qu'une exit condition soit remplie ou que le maximum iteration count soit atteint. À l'intérieur du nœud Loop, configurez un sous-flux que le système exécute de manière répétée en fonction de la loop variable.
-
Configuration
-
Input
Variables de boucle : transfèrent les données entre les itérations. Leurs valeurs finales restent disponibles pour les nœuds en aval une fois la boucle terminée. Configurez plusieurs variables de boucle dont les valeurs peuvent être saisies manuellement ou sélectionnées parmi les sorties des nœuds en amont.
Condition de sortie de boucle : vous pouvez configurer une condition de sortie basée sur les variables de boucle. La boucle se termine lorsqu'une variable de boucle spécifiée remplit la condition prédéfinie.
Nombre maximal d'itérations : limite le nombre maximal d'exécutions de la boucle pour éviter les boucles infinies.
-
Output
La sortie du nœud correspond à la valeur des variables de boucle après la dernière itération. Les variables de boucle ne peuvent être mises à jour que par un nœud Variable Assigner. Sans ce nœud, la sortie de la boucle restera identique à son entrée initiale, quel que soit le nombre d'itérations.
-
Nœuds associés
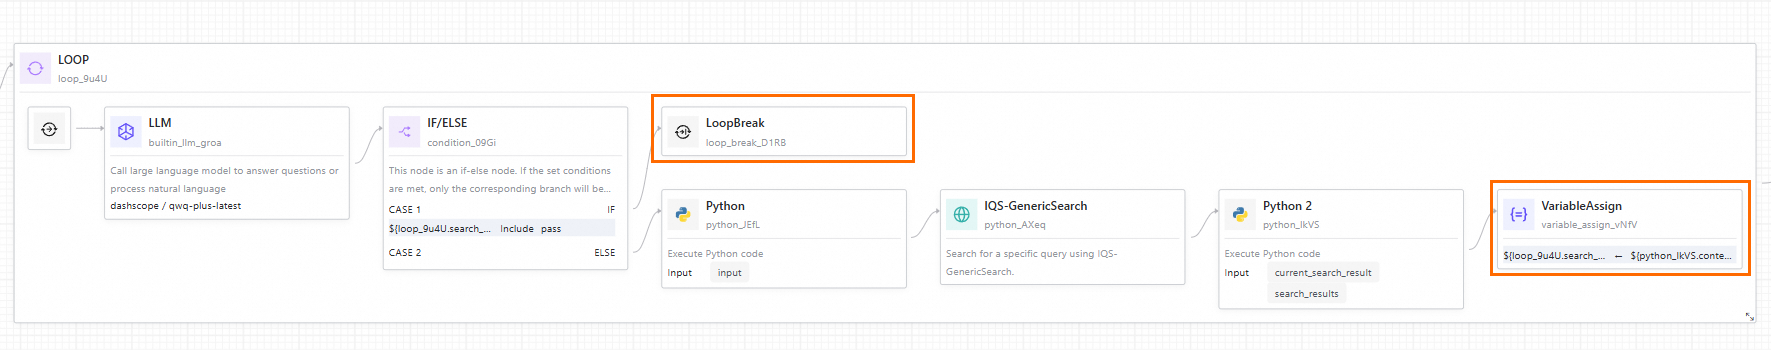
Les nœuds liés à la boucle ne peuvent être utilisés qu'à l'intérieur d'une boucle. Ajoutez les nœuds associés suivants en cliquant sur l'icône + à droite d'un nœud dans la boucle :
-
Break Loop
Quitte immédiatement la boucle. Ce nœud est généralement précédé d'un nœud Conditional branch.
-
Variable Assigner
Attribue la sortie des nœuds au sein de la boucle aux variables de boucle, faisant ainsi avancer l'état de la boucle.
-
Direct output
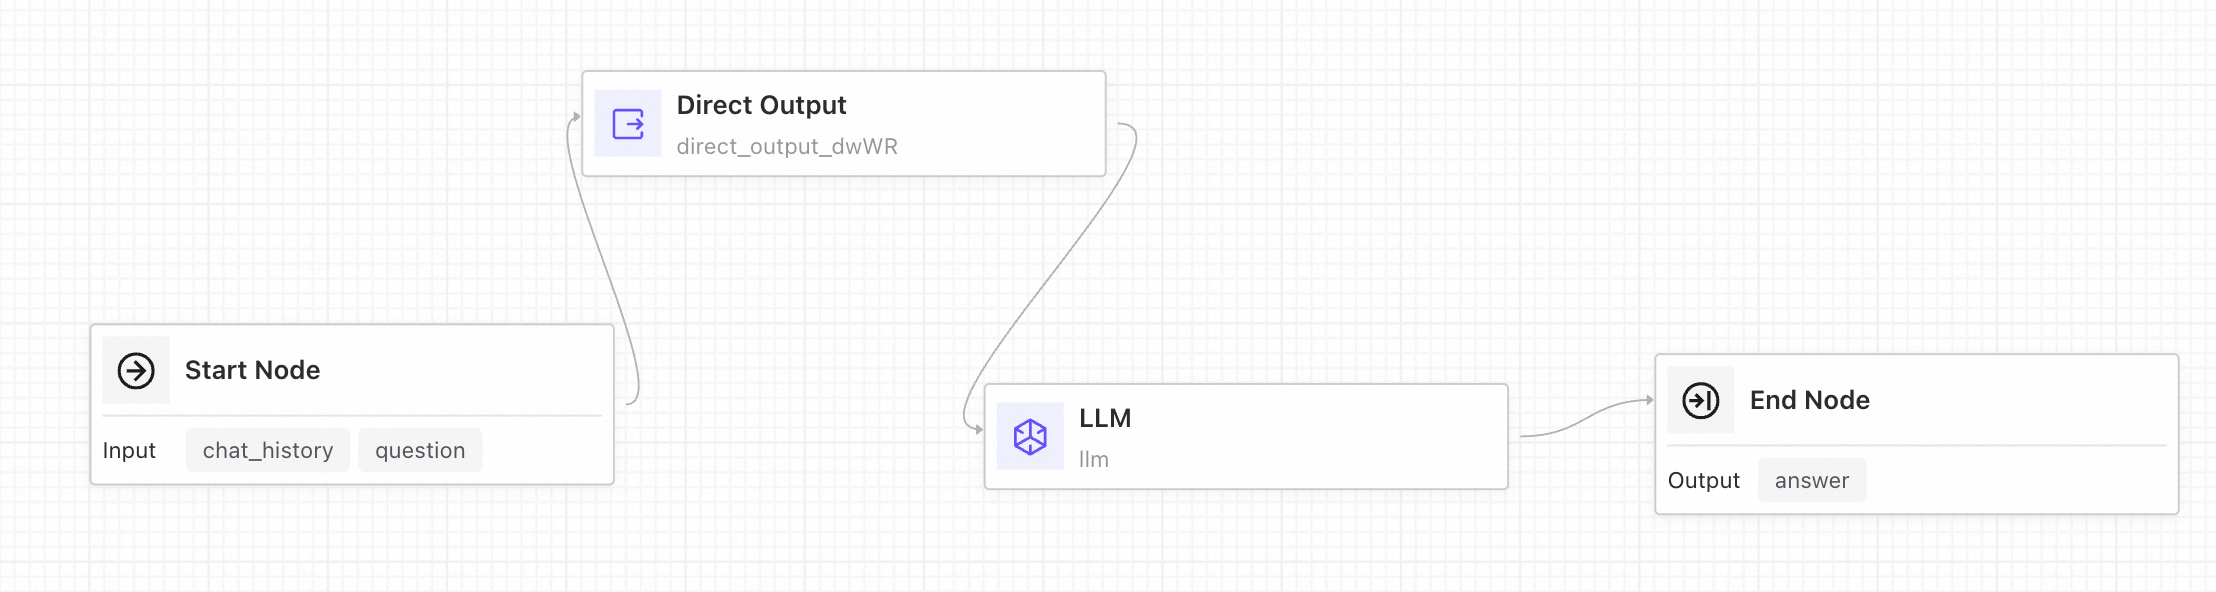
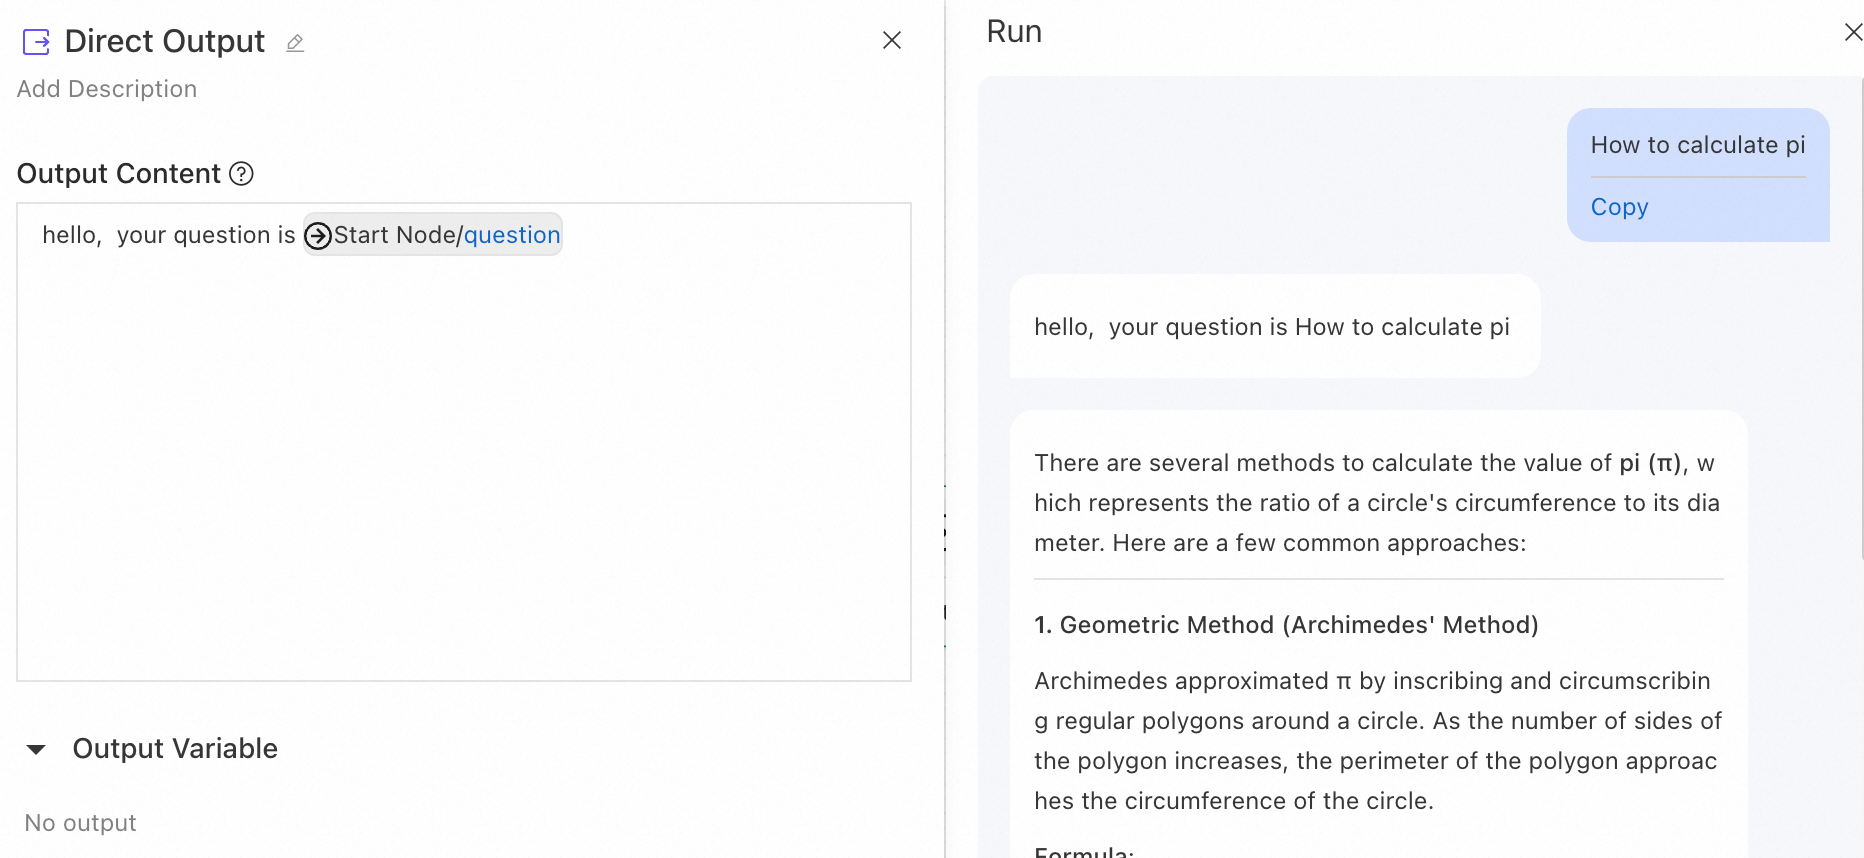
Le nœud Direct output configure le contenu de réponse directe à l'aide d'un modèle de sortie. Il prend en charge le référencement des sorties des nœuds en amont avec la syntaxe {{node.variable}} et la diffusion en continu (streaming).
Exemple : ajoutez un nœud Direct output avant un nœud LLM pour envoyer un message initial à l'utilisateur, tel que « Thinking... », pendant le traitement de la tâche principale.
Batch processing
Le nœud Batch processing traite les données de liste en parallèle. Il applique le même sous-flux à chaque élément de la liste, ce qui améliore considérablement l'efficacité. Pour les tâches itératives où chaque étape dépend de la précédente, utilisez plutôt le nœud Loop.
Input
Liste d'entrée : la liste des données à traiter. Le nœud envoie chaque élément au sous-flux pour exécution en tant qu'élément indépendant.
Champ de sortie : sélectionnez une variable de sortie d'un nœud au sein du sous-flux pour servir de résultat pour la tâche de chaque élément.
Nombre de traitements parallèles : facultatif. Contrôle le nombre de tâches exécutées simultanément. La valeur par défaut est 4, avec une plage valide de 1 à 10.
Output
result : une liste contenant les résultats de sortie de toutes les tâches par lot, dans le même ordre que la liste d'entrée. Elle agrège les valeurs de sortie réelles du « Champ de sortie » spécifié dans l'entrée.
Related nodes
Batch Start
Le nœud Batch Start est le point d'entrée du sous-flux de traitement par lot. Il fournit les variables de sortie suivantes pour référence par les nœuds suivants dans le sous-flux :
item : l'élément de données en cours de traitement, correspondant à un élément de la liste d'entrée.
index : l'index de l'élément de données actuel dans la liste d'entrée (à partir de 0).
Batch Break
Le nœud Batch Break est utilisé pour interrompre prématurément le traitement de l'élément de données actuel lorsqu'une condition spécifique est remplie.
Remarque : le nœud Batch Break termine uniquement l'itération actuelle et n'affecte pas le traitement des autres éléments de données.
Exemple d'utilisation
Analyse de documents par lot et traitement intelligent
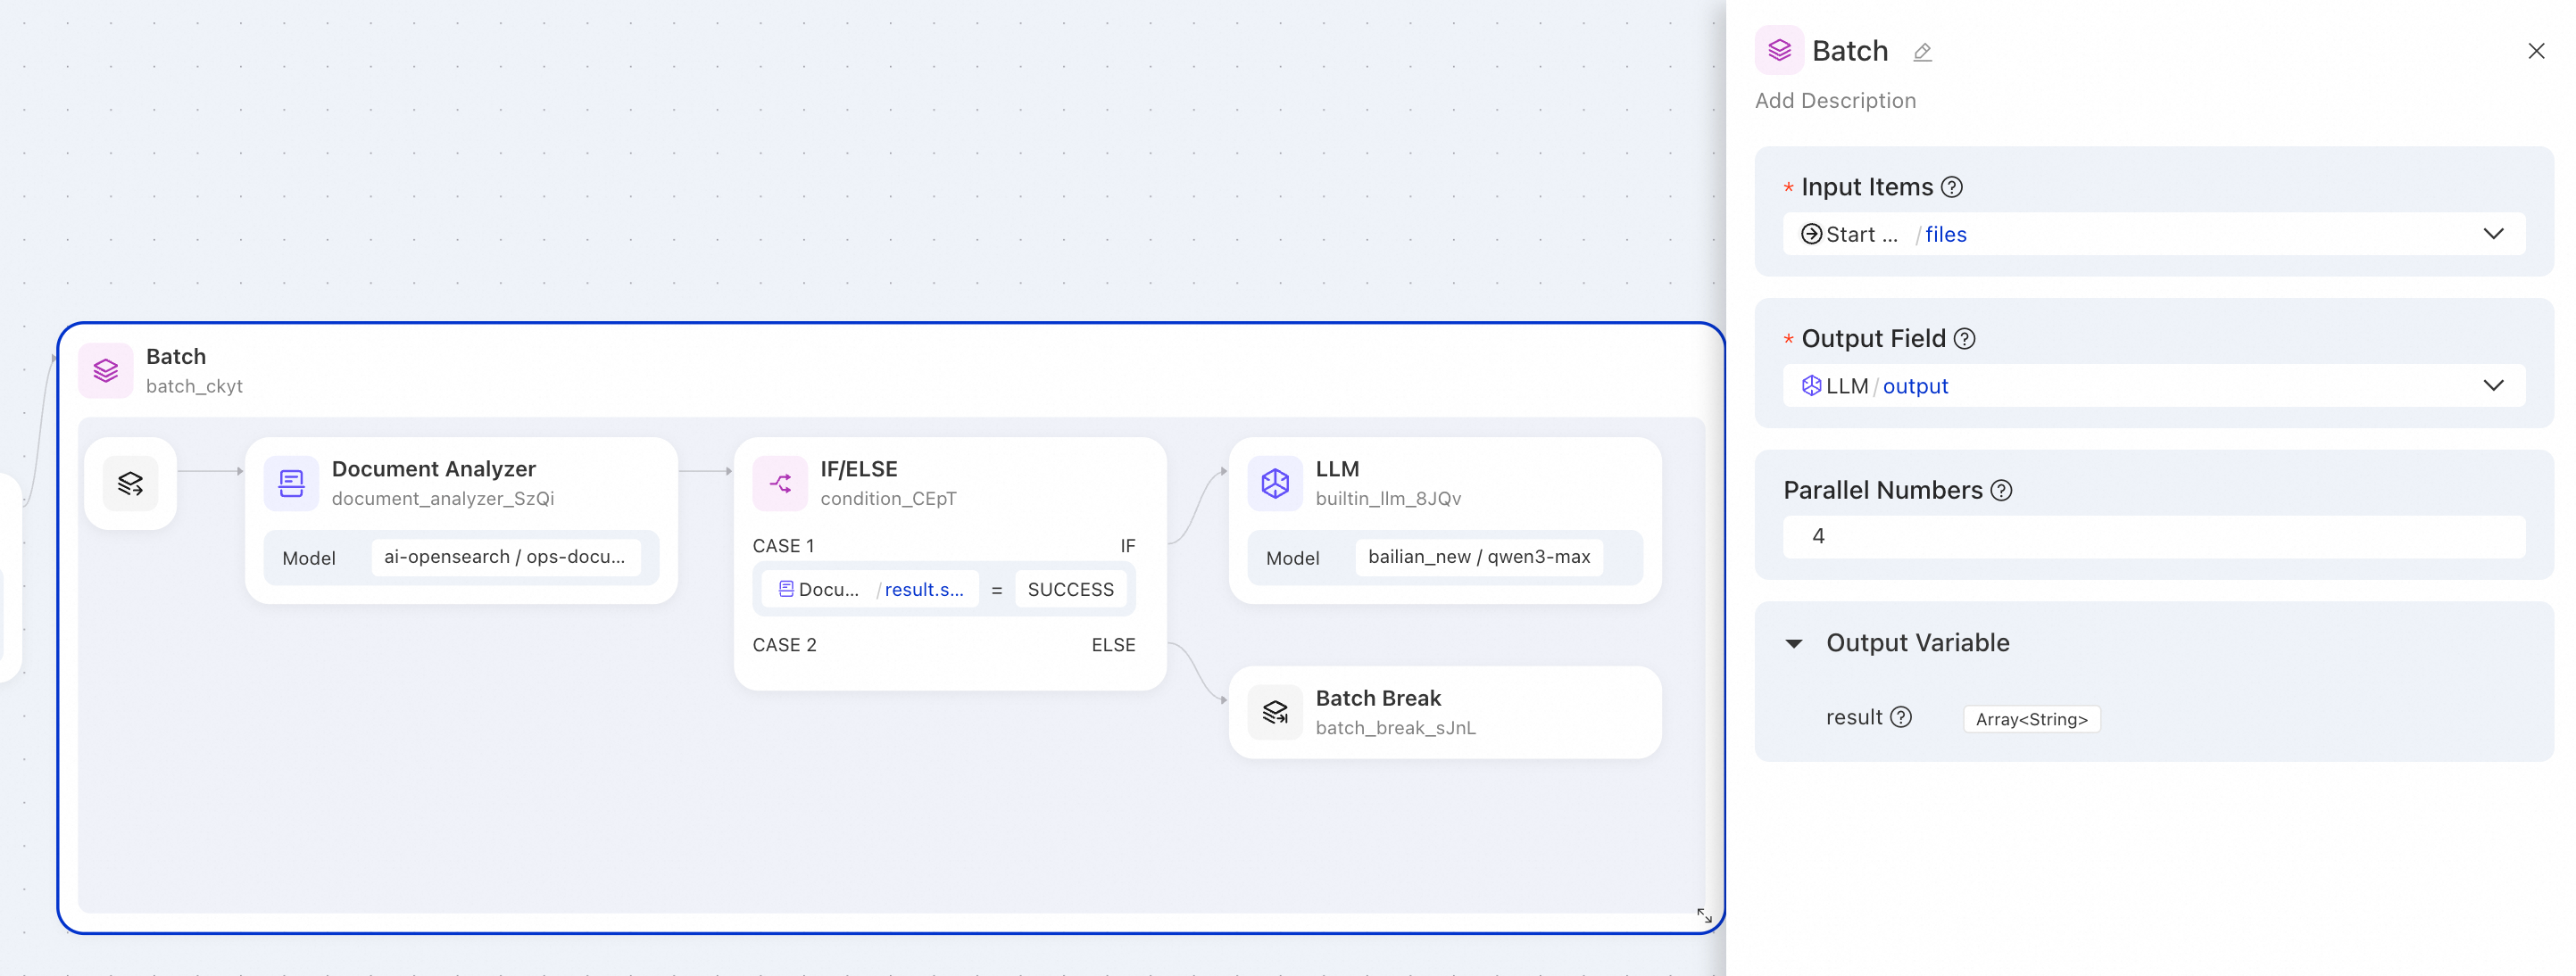
Scénario : une entreprise doit analyser plusieurs fichiers documentaires par lots, appeler un LLM pour le traitement du contenu sur les documents analysés avec succès et ignorer automatiquement ceux dont l'analyse a échoué.
Configuration du nœud Batch processing :
|
Paramètre |
Valeur |
Description |
|
Liste d'entrée |
|
Référencez la sortie de la liste de fichiers du nœud Start en amont. |
|
Champ de sortie |
|
Sélectionnez le champ de sortie du nœud LLM comme sortie pour le nœud Batch processing. |
|
Nombre de traitements parallèles |
|
Traitez 4 fichiers simultanément. |
Exemple de sortie :
{
  "result": [
    "This document is the user manual for product XX, which includes product feature introductions, installation steps...",
    "This is a software service procurement contract with a term of 12 months...",
    null,
    "Value-added tax ordinary invoice, dated January 15, 2026..."
  ]
}
Remarque : une valeur null dans la sortie indique que l'analyse du fichier a échoué et que le nœud Batch Break a ignoré le traitement ultérieur.
Notes
Ordre des résultats garanti : l'ordre de la liste de sortie est cohérent avec l'ordre de la liste d'entrée.
Flexibilité du sous-flux : au sein du sous-flux, différents éléments de données peuvent déclencher différents chemins d'exécution.
Gestion des valeurs nulles : si le flux d'exécution d'un élément se termine prématurément ou si sa sortie est vide, la position correspondante dans la liste de sortie sera nulle.
End
Le nœud End marque la fin d'un application flow et définit ses paramètres de sortie. Un application flow ne peut comporter qu'un seul nœud End.
-
Configuration des paramètres de sortie
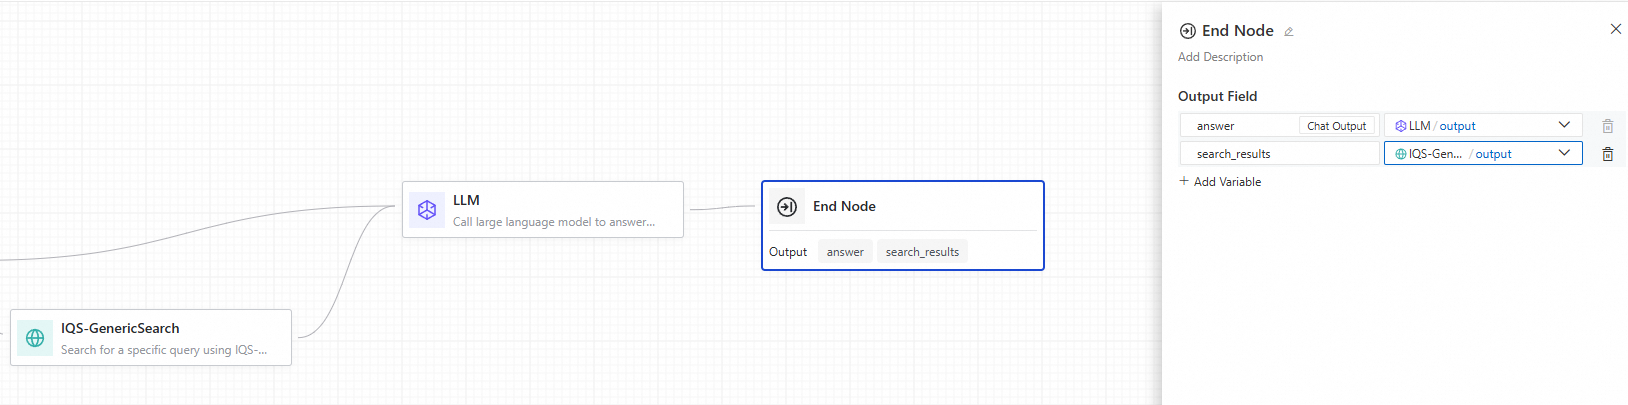
La sortie du application flow peut référencer les sorties de n'importe quel nœud en amont. Par exemple, dans l'échantillon ci-dessous, la sortie 'answer' du application flow utilise la sortie du nœud LLM, tandis que 'search_results' utilise la sortie du nœud de recherche.
 Remarque
Un flux conversationnel possède un champ de sortie 'Chat' par défaut, qui sert de sortie conversationnelle du application flow.
Un application flow doit inclure des nœuds Start et End. Seuls les nœuds connectés entre eux sont exécutés ; les nœuds isolés sont ignorés.
Fonctionnalités IA
LLM
Le nœud LLM est un composant central d'un application flow qui appelle un large language model pour des tâches de langage naturel telles que la génération de texte, la réponse aux questions et le traitement d'entrées complexes. Il offre des options de configuration pour ajuster les paramètres du modèle, gérer l'historique des conversations et personnaliser les invites.
-
Cas d'utilisation
Génération de texte : générez du contenu textuel basé sur des sujets et des mots-clés.
Classification de contenu : classez automatiquement les types d'e-mails (par exemple, demande, plainte ou spam).
Traduction de texte : traduisez du texte dans une langue spécifiée.
RAG : répondez aux questions des utilisateurs en combinant les connaissances récupérées avec le raisonnement du modèle.
-
Configuration
-
Input
-
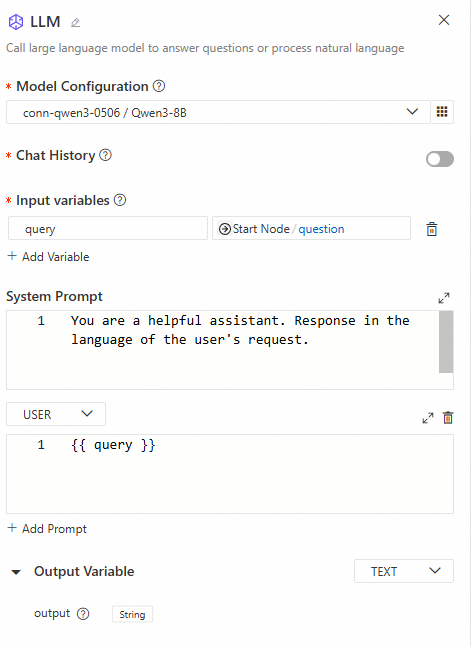
Paramètres du modèle : prend en charge les modèles déployés depuis ModelGallery, les services de modèles déployés personnalisés et les modèles de fournisseurs tels que Dashscope et DeepSeek. Pour des performances optimales, choisissez un modèle hautement performant. Configurez les paramètres de modèle suivants :
Temperature : une valeur généralement comprise entre 0 et 1 qui contrôle l'aléatoire de la sortie. Les valeurs proches de 0 produisent des sorties plus déterministes, tandis que les valeurs proches de 1 produisent des résultats plus diversifiés.
Top P : seuil d'échantillonnage par noyau. Le modèle échantillonne à partir du plus petit ensemble de jetons dont la probabilité cumulative dépasse le seuil P, influençant la diversité de la sortie.
Top K : limite les jetons candidats aux K jetons les plus probables. Cela réduit l'aléatoire et rend la sortie plus ciblée, contraignant la créativité plus directement que Top P.
Presence penalty : réduit la répétition des mêmes entités ou informations. Pénalise les jetons déjà présents dans le texte généré. Des valeurs plus élevées réduisent la répétition de manière plus agressive.
Frequency penalty : pénalise les jetons en fonction de leur fréquence dans le texte généré, réduisant les mots ou phrases trop fréquents. Des valeurs plus élevées encouragent une plus grande diversité lexicale.
Max tokens : longueur maximale de sortie (en jetons) par exécution. Des valeurs plus faibles peuvent tronquer la sortie, tandis que des valeurs plus élevées permettent des réponses plus longues.
Seed : lorsqu'il est spécifié, le modèle tente un échantillonnage déterministe. Les demandes répétées avec le même seed et les mêmes paramètres devraient produire le même résultat, mais le déterminisme complet n'est pas garanti. Reportez-vous au paramètre de réponse system_fingerprint pour surveiller les changements.
Stop sequences : jusqu'à quatre séquences qui indiquent au modèle d'arrêter la génération de sortie supplémentaire. Lorsque le modèle rencontre l'une de ces séquences, il arrête la génération de jetons. Le texte renvoyé n'inclut pas la séquence d'arrêt.
Historique des conversations : si activé, l'historique de chat du application flow est automatiquement inséré dans l'invite.
Variables d'entrée : les variables peuvent référencer les sorties de tous les nœuds précédents.
Prompt : une invite contient le contenu personnalisé pour le System (SYSTEM), l'User (USER) ou l'Assistant (ASSISTANT). L'invite est un modèle Jinja2 où vous pouvez référencer les variables d'entrée en utilisant des doubles accolades
{{}}.
-
-
Output
Le nœud utilise par défaut une sortie String, mais prend en charge JSON. Le type JSON prend en charge les variables de sortie personnalisées, et le modèle génère la sortie en fonction des noms de variables.
-
Cas d'utilisation
Intent recognition
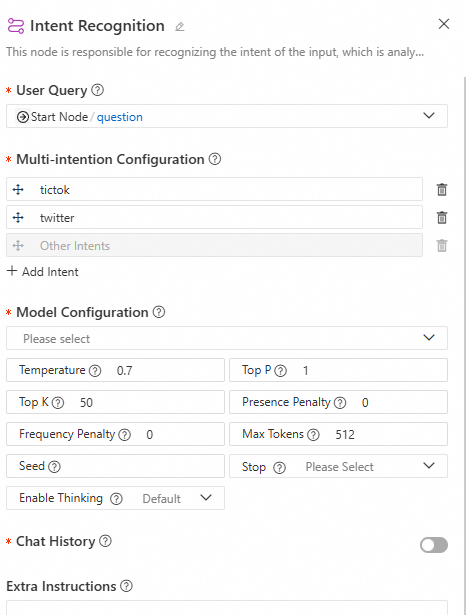
Le nœud Intent recognition est principalement destiné au contrôle du flux. Il utilise un large language model pour analyser l'intention de l'utilisateur et dirige l'exécution vers la branche correspondante en fonction du résultat. Il prend en charge la configuration multi-intentions et l'historique des conversations.
-
Configuration
-
Input
Entrée utilisateur : sélectionnez l'entrée utilisateur à utiliser pour la reconnaissance d'intention.
Configuration multi-intentions : configurez les intentions selon vos besoins, en veillant à ce que la description de chaque intention soit claire et qu'il n'y ait aucun chevauchement sémantique entre les différentes intentions. La dernière intention est par défaut « Other », qui est associée lorsqu'aucune autre intention ne s'applique et ne peut pas être modifiée.
Paramètres du modèle : configurez le large language model pour la reconnaissance d'intention. Pour de meilleures performances, choisissez un modèle plus performant, tel que qwen-max.
Historique des conversations : lorsqu'il est activé, le large language model insère automatiquement l'historique de chat du application flow dans l'invite lors du raisonnement.
Invite supplémentaire : ce contenu est ajouté à l'invite système pour aider le modèle à effectuer la reconnaissance d'intention avec plus de précision.
-
Output
Ce nœud ne produit aucune sortie.
-
Exemple d'utilisation
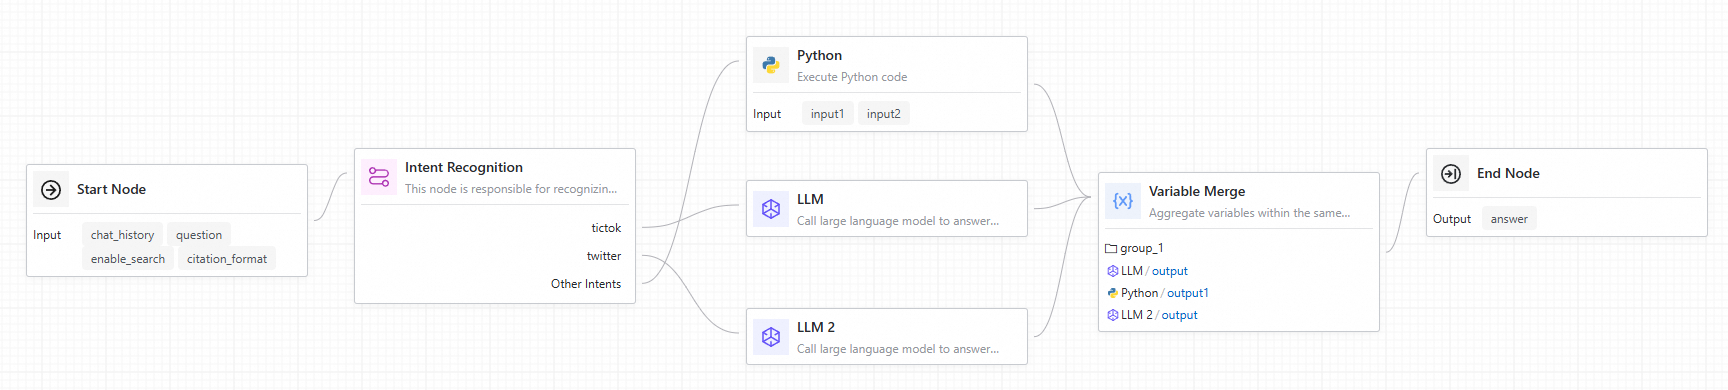
Lors de la connexion du nœud Intent recognition à des nœuds en aval, chaque branche d'intention dispose d'un port de connexion correspondant sur le nœud. Lorsqu'une intention est reconnue, les nœuds en aval connectés à cette branche sont exécutés, tandis que les nœuds des autres branches sont ignorés. Vous pouvez ensuite utiliser un nœud Variable aggregate pour collecter les résultats d'exécution de chaque branche.
Agent
Le nœud Agent permet à un large language model (LLM) de planifier, de sélectionner des outils et d'agir de manière autonome. Il prend en charge les stratégies de raisonnement et les capacités d'utilisation d'outils. En intégrant des stratégies telles que FunctionCalling et ReAct, il permet au LLM d'appeler de manière autonome des outils conformes au Model Context Protocol (MCP) au moment de l'exécution pour réaliser un raisonnement en plusieurs étapes.
Node parameters
-
Stratégie de l'agent : sélectionnez la stratégie de raisonnement de l'agent souhaitée. Actuellement, les stratégies FunctionCalling et ReAct sont prises en charge.
FunctionCalling
Cette fonctionnalité permet l'interaction entre un Large Language Model (LLM) et des outils externes basés sur la définition structurée
tool call(au format JSON) de l'API OpenAI Chat. Le LLM analyse les instructions en langage naturel de l'utilisateur pour identifier automatiquement l'intention, sélectionner l'outil approprié et extraire les paramètres. Le système appelle ensuite l'outil correspondant et renvoie le résultat au modèle pour effectuer un raisonnement supplémentaire et générer la réponse finale.Cas d'utilisation et avantages :
Appels structurés, forte compatibilité : utilise des données structurées pour définir clairement les noms des outils et les paramètres d'appel, ce qui le rend compatible avec tous les modèles prenant en charge l'appel d'outils.
Performances stables : adapté aux tâches ayant des objectifs clairs et des étapes bien définies, telles que la vérification de la météo, la recherche d'informations ou l'interrogation de données.
ReAct
ReAct (Reasoning + Acting) est une stratégie de raisonnement flexible qui utilise des invites pour guider un modèle à générer explicitement des Thoughts et des Actions, créant ainsi une boucle fermée pour le raisonnement en plusieurs étapes et les appels d'outils. Cette stratégie utilise généralement le langage naturel pour décrire le processus d'appel. Elle déclenche l'exécution de l'outil backend en produisant du texte tel que « Action=xxx, Action Input=xxx » et injecte les résultats dans la chaîne de raisonnement du modèle. Cette méthode ne nécessite pas d'API-level
tool_calls, ce qui la rend adaptée à des modèles et frameworks plus généraux.Cas d'utilisation et avantages :
Capacité de raisonnement améliorée : guide le modèle pour qu'il réfléchisse étape par étape, chaque étape exprimant explicitement la logique de raisonnement.
Stratégie transparente : idéale pour les applications d'agent nécessitant un débogage et une interprétabilité forts.
Aucun support d'appel d'outil requis : peut être utilisée même avec des modèles qui ne prennent pas en charge la sortie structurée.
Paramètres du modèle : la stratégie FunctionCalling nécessite un modèle qui prend nativement en charge l'appel d'outils. La stratégie ReAct n'a pas cette limitation, mais nous recommandons de choisir un modèle doté de fortes capacités de raisonnement.
Historique des conversations : l'activation de l'historique des conversations fournit à l'agent une mémoire contextuelle. Le système inclut automatiquement les messages de conversation passés dans l'invite, permettant à l'agent de comprendre et de référencer les parties précédentes de la conversation. Par exemple, un agent avec l'historique des conversations activé peut résoudre les pronoms (tels que « il » ou « cela ») sans que l'utilisateur ait besoin de répéter les informations.
Planification des tâches : lorsqu'elle est activée, le système ajoute automatiquement l'outil intégré
write_todosaux outils disponibles de l'agent. Pour les questions utilisateur complexes, l'agent appelle automatiquement l'outilwrite_todospour planifier la tâche et l'exécuter étape par étape, en mettant à jour dynamiquement le plan en fonction des dernières informations.Outils MCP et outils : prend en charge la configuration des outils MCP et non-MCP. Pour plus d'informations, consultez Configurer les outils pour un Agent.
-
Configuration de l'invite
Variables d'entrée : lorsque vous souhaitez référencer une variable d'un nœud en amont d'un application flow dans une invite, vous devez définir une variable d'entrée correspondante dans le nœud actuel et définir sa valeur comme référence à la variable du nœud en amont. Ensuite, dans la section Prompt ci-dessous, vous pouvez utiliser la syntaxe de modèle Jinja2, indiquée par des doubles accolades (
{{}}), pour référencer ces variables d'entrée définies et permettre le transfert dynamique de données.System prompt : utilisé pour spécifier les objectifs et le contexte de la tâche de l'agent, fournissant au modèle les informations nécessaires pour guider la génération de sa réponse. Ceci est facultatif pour la stratégie ReAct.
User prompt : reçoit l'entrée ou la requête de l'utilisateur, qui sert de base à la génération de la réponse du modèle.
-
Nombre de boucles : définit le nombre maximal de cycles d'exécution pour l'agent, allant de 1 à 99. L'agent répète la tâche pour générer une réponse jusqu'à ce que l'une des conditions suivantes soit remplie :
Le LLM détermine qu'il a rassemblé suffisamment d'informations en appelant des outils pour générer un résultat complet.
Le nombre maximal de boucles défini est atteint.
La définition d'un nombre de boucles raisonnable permet d'équilibrer l'exhaustivité de la réponse avec l'efficacité d'exécution. Si la planification des tâches est activée, nous recommandons d'utiliser le nombre maximal de boucles par défaut pour garantir que le modèle puisse exécuter pleinement toutes les étapes comme prévu.
-
Variables de sortie :
intermediate_steps : une chaîne contenant les étapes intermédiaires de l'exécution de l'agent.
text : une chaîne contenant la sortie finale de l'agent.
Traces and logs
Après avoir cliqué sur Run dans le coin supérieur droit de la page du application flow, vous pouvez afficher la trace ou le journal sous le résultat d'exécution dans la boîte de dialogue qui apparaît.
Afficher la sortie intermédiaire : cliquez sur l'icône d'état d'exécution dans le coin supérieur droit du nœud Agent dans le workflow. Dans le tiroir ci-dessous, trouvez
intermediate_stepsdans la sortie pour afficher le processus de raisonnement de l'agent.Afficher la trace : affichez les informations de trace de l'exécution actuelle pour comprendre l'entrée et la sortie de l'agent pour chaque requête de modèle (y compris les appels d'outils et les paramètres de requête), les coûts en jetons et la consommation de temps.
Afficher le journal : si un application flow rencontre une erreur, vous pouvez afficher le journal d'exécution actuel pour obtenir plus de détails sur le processus d'exécution du nœud.
De plus, vous pouvez cliquer sur l'icône à droite du bouton Run dans le coin supérieur droit de la page du application flow pour afficher l'historique d'exécution. Sélectionnez un enregistrement d'exécution spécifique pour afficher sa trace ou son journal.
Document parsing
Prend en charge l'utilisation de l'analyseur de documents intelligent intégré au système et des services d'analyse de documents de la plateforme ouverte AI Search.
Analyseur intégré : extrait le contenu structuré et les métadonnées des documents, prenant en charge divers formats de documents courants, y compris PDF, DOCX, PPTX, TXT, HTML, CSV, XLSX, XLS, JSONL et MD.
Plateforme ouverte AI Search : réalise une analyse structurée de documents de haute précision, prenant en charge l'extraction d'informations de hiérarchie logique telles que les titres et les paragraphes, ainsi que du contenu tel que le texte, les tableaux et les images. Cela améliore l'efficacité et la précision de l'extraction de documents. Vous devez d'abord configurer une connexion de service de modèle de plateforme ouverte AI Search. Les formats de fichiers pris en charge incluent PDF, DOCX, PPTX, TXT et HTML.
Cet outil prend en charge les scénarios RAG, de résumé et de questions-réponses. L'interface de configuration est la suivante : 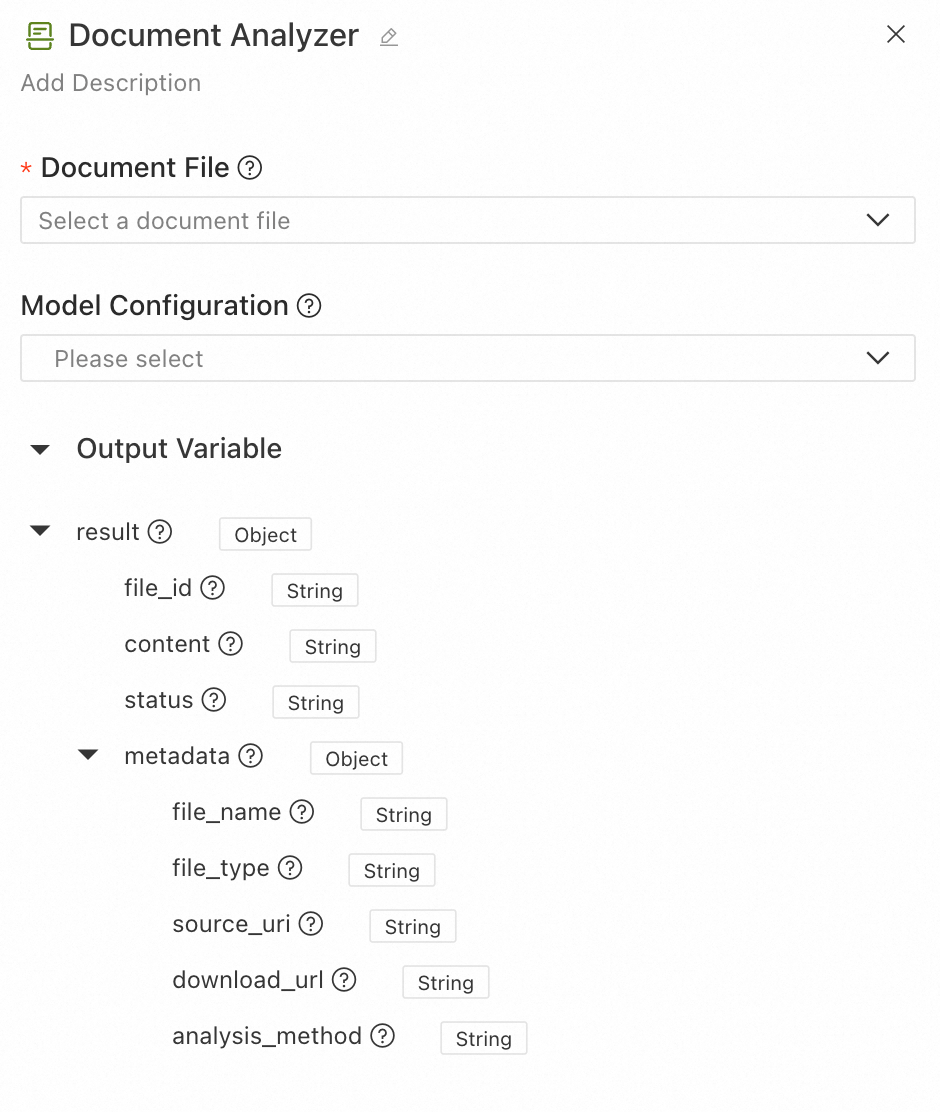
Fichier documentaire : le fichier documentaire à analyser. Sélectionnez un champ de type fichier d'un nœud en amont.
Paramètres du modèle : (facultatif) sélectionnez une connexion de service de modèle de plateforme ouverte AI Search créée sur LangStudio. Si elle n'est pas configurée, le système utilise par défaut la méthode d'analyse de base intégrée.
-
Sortie :
file_id : l'identifiant unique du fichier d'entrée.
content : le contenu textuel structuré analysé, incluant des informations hiérarchiques telles que les titres et les paragraphes.
status : le statut de l'analyse, qui peut être SUCCESS ou FAIL.
-
metadata : les métadonnées du document et les détails de l'analyse.
file_name : le nom du fichier.
file_type : le type du fichier.
source_uri : l'URI d'origine du fichier.
download_url : l'URL téléchargeable du fichier.
analysis_method : la méthode d'analyse utilisée. « opensearch » indique une analyse structurée utilisant la plateforme ouverte AI Search, tandis que « builtin » indique l'utilisation de la méthode d'analyse de base intégrée.
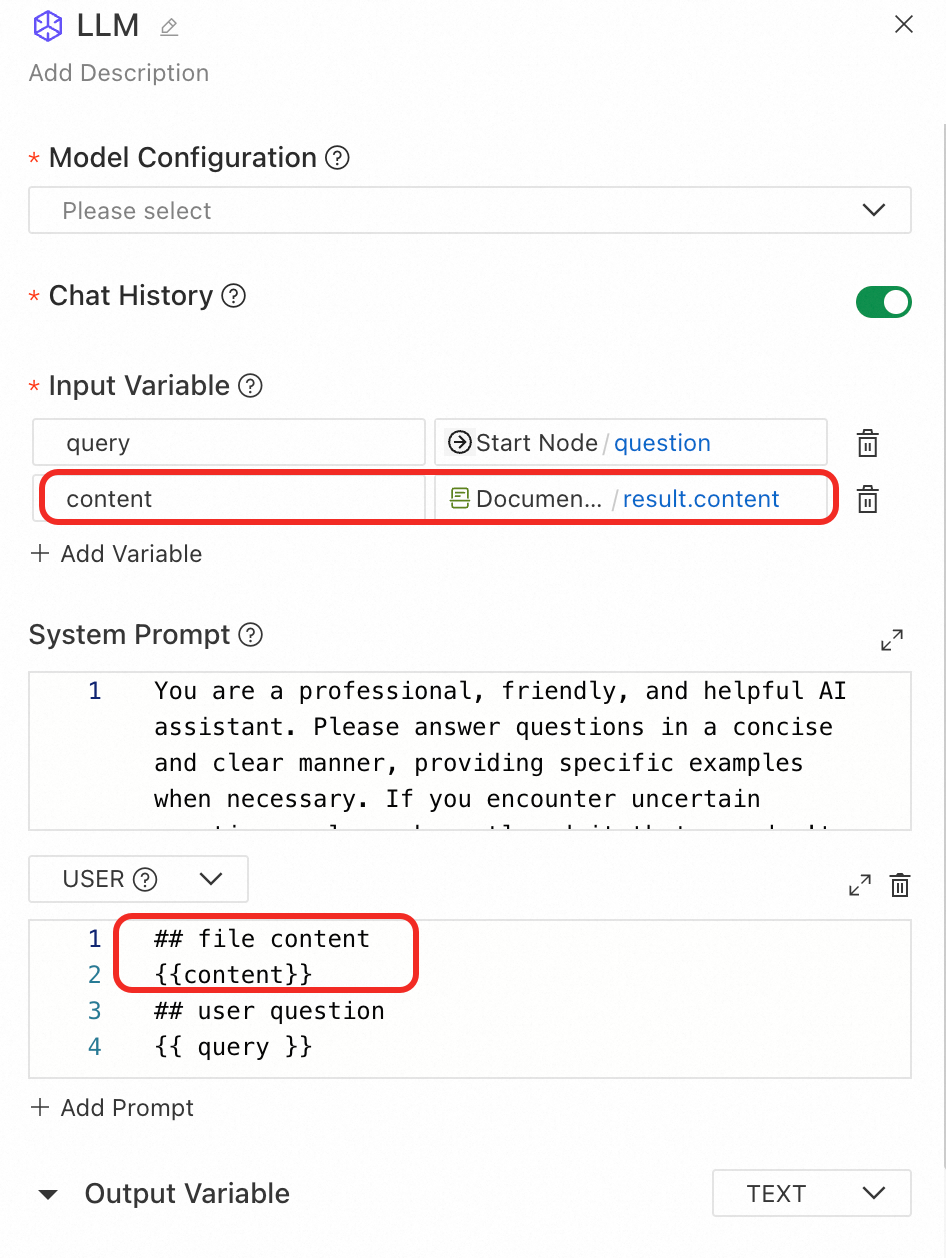
Exemple d'utilisation en aval : dans les nœuds en aval, référencez les champs de résultat du nœud d'analyse de documents selon vos besoins. Pour utiliser les résultats de l'analyse de documents dans un nœud LLM, vous pouvez inclure le contenu analysé dans l'invite utilisateur comme indiqué ci-dessous :
Speech recognition
Utilisez le nœud Speech recognition pour convertir des fichiers audio ou vidéo en texte. Il prend en charge plusieurs formats audio et la reconnaissance linguistique.
Input
Paramètres du modèle : configurez le modèle de reconnaissance vocale. Le service de reconnaissance vocale fourni par Alibaba Cloud Model Studio est actuellement pris en charge. Nous recommandons d'utiliser
paraformer-v2pour de meilleures performances de reconnaissance et une prise en charge multilingue.Fichier audio/vidéo : sélectionnez le fichier audio ou vidéo à reconnaître. Pour les formats pris en charge, consultez Entrée et sortie de type fichier.
Langue de reconnaissance : spécifie la langue pour la reconnaissance audio. Les langues prises en charge sont le chinois, l'anglais, le japonais, le cantonais, le coréen, l'allemand, le français, le russe ou la détection automatique. Remarque : cette fonctionnalité est prise en charge uniquement par le modèle
paraformer-v2. Les autres modèles utilisent la détection automatique de la langue par défaut.
Output
file_id : l'identifiant unique du fichier d'entrée.
status : le statut de la reconnaissance. Les valeurs possibles sont
SUCCESSouFAIL.content : le contenu textuel transcrit.
segments : une liste d'informations sur les fragments de phrase, incluant les horodatages, les fragments de texte et d'autres détails.
-
metadata : les métadonnées du fichier, incluant :
file_name : le nom du fichier.
file_type : le type du fichier.
source_uri : l'URI du fichier.
download_url : l'URL de téléchargement du fichier.
Récupération de données
Pour configurer les nœuds suivants, consultez la rubrique Nœud de récupération de données :
Récupération depuis la base de connaissances
Alibaba Cloud IQS - recherche web
SerpAPI - recherche générique
Requête HTTP
Traitement des données
Développement Python (Python)
Les flux d'application prennent en charge des nœuds avec du code Python personnalisé pour le traitement complexe des données. Ces nœuds gèrent les entrées et sorties en streaming. La page de configuration se présente comme suit :
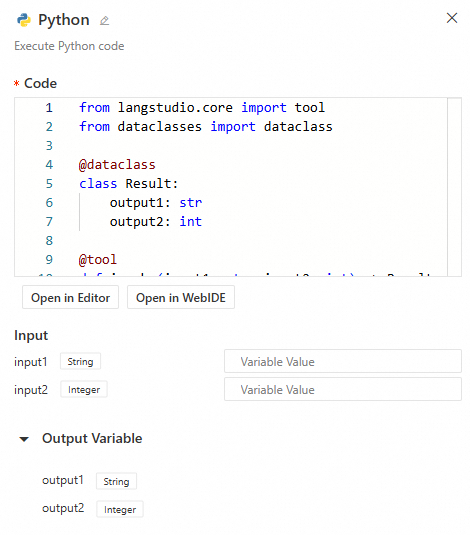
Il vous suffit de saisir le code Python. Les entrées et sorties sont analysées automatiquement à partir du code. Veuillez noter les points suivants :
-
La fonction d'entrée doit être décorée avec
@toolpour être chargée en tant que nœud.RemarquePour activer l'entrée en streaming pour un nœud Python, vous devez configurer
@tool(properties={"streaming_pass_through": True}). Sinon, les entrées du nœud Python, par exemple celles provenant d'un LLM, seront constituées du texte de sortie complet au lieu d'un flux. La fonction prend en charge les types d'entrée/sortie suivants : int, float, bool, str, dict, TypedDict, dataclass (sortie uniquement), list et File.
-
Les paramètres de la fonction d'entrée sont analysés dynamiquement en tant qu'entrées du nœud. La sortie est placée dans un dictionnaire
outputet peut être référencée par d'autres nœuds.ImportantL'analyse automatique des paramètres d'entrée et de sortie d'un nœud Python dépend de l'environnement d'exécution. Si l'environnement d'exécution n'est pas lancé, vous ne pouvez pas configurer les informations d'entrée et de sortie du nœud.
-
Si votre code Python nécessite des dépendances, sélectionnez Install Dependencies dans le coin supérieur droit du canevas et saisissez les packages requis. Le fichier
requirements.txtest enregistré avec le flux d'application. Les dépendances sont installées lorsque vous lancez l'environnement d'exécution ou déployez le service.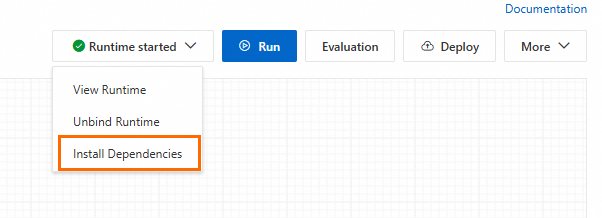
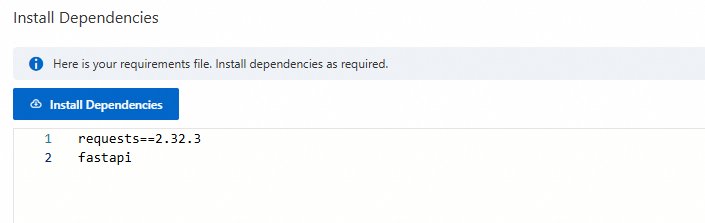
Cas d'utilisation 1 : Saisissez le code suivant dans la zone de code. Le code est mappé aux entrées et sorties du nœud :
from langstudio.core import tool
from dataclasses import dataclass

@dataclass
class Result:
    output1: str
    output2: int

@tool
def invoke(foo: str, bar: int) -> Result:
    return Result(
        output1="hello" + foo,
        output2=bar + 10
    )
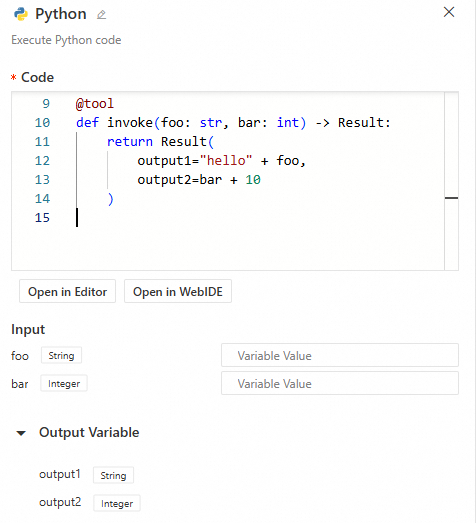
Cas d'utilisation 2 : Entrée et sortie en streaming. Utilisez un nœud Python pour tronquer un flux de texte provenant d'un nœud LLM ou agent qui inclut des processus de réflexion. En ignorant le contenu situé dans la section <think>\n\n</think>, vous obtenez un flux de texte final correspondant au résultat. Voici un exemple :
import re
from typing import Iterator
from langstudio.core import tool

@tool(properties={"streaming_pass_through": True})
def strip_think(
    stream: Iterator[str],
) -> Iterator[str]:  # The input is a streaming string iterator, and the output is a filtered streaming string iterator.
    # Match the <think>\n...\n</think> structure and capture the text after the closing tag.
    pattern = re.compile(r"<think>\n[\s\S]*\n</think>(.*)")
    in_thinking = True  # Flag to indicate if the current position is inside a <think> block.
    think_buf = ""      # Buffer to store unprocessed content.

    for chunk in stream:
        if in_thinking:
            think_buf += chunk
            m = pattern.search(think_buf)  # Check if the buffer contains a complete thought block.
            if m:
                in_thinking = False
                result_part = m.groups()[0]
                if result_part:
                    yield result_part  # If the result text exists, yield it immediately.
        else:
            yield chunk  # After exiting the thought block, directly yield all subsequent chunks.
Transformation de modèle
L'outil de transformation de modèle utilise la syntaxe de modèle Jinja2 pour permettre un formatage flexible du texte et une transformation des données.
Input
Le mode de transformation prend en charge le mode Jinja2 et le mode de référence de nœud.
-
Mode Jinja2 : Utilise la syntaxe complète du modèle Jinja2 pour personnaliser le format de sortie. Ce mode convient aux sorties structurées complexes, à la logique conditionnelle et au rendu de boucles.
-
Variables de modèle : Définissez les variables utilisées dans le modèle.
ImportantLes noms de variables ne peuvent pas correspondre aux noms de méthodes intégrées de Python, tels que
items,keysouvalues. Utilisez des noms de champs spécifiques, tels queitem_listouproduct_list. -
Contenu du modèle : Une chaîne de modèle écrite en syntaxe Jinja2. Elle prend en charge la syntaxe complète, y compris la substitution de variables
{{ variable }}, les boucles{% for %}, les instructions conditionnelles{% if %}et les filtres{{ value | filter }}.ImportantToutes les variables référencées dans le modèle doivent être définies dans la liste des variables. Sinon, une erreur se produira.
-
-
Mode de référence de nœud : Référence directement la sortie des nœuds en amont et la concatène automatiquement en une chaîne. Ce mode convient aux scénarios simples de combinaison de texte.
Contenu du modèle : Sélectionnez les champs de sortie des nœuds en amont. Le système les concatène automatiquement dans l'ordre.
Output
output : Le résultat textuel après le rendu du modèle. Remarque : La longueur du contenu du modèle d'entrée et de sortie est limitée à 100 000 caractères. Tout contenu dépassant cette limite sera tronqué.
Usage examples
Exemple 1 : Générer un e-mail de confirmation de commande
Configuration des variables :
|
Nom de la variable |
Valeur de la variable |
|
customer_name |
|
|
order_id |
|
|
products |
|
|
total |
|
Contenu du modèle :
Dear {{ customer_name }}:

Your order {{ order_id }} has been confirmed. The details are as follows:

{% for product in products %}
- {{ product.name }}: ¥{{ product.price }}
{% endfor %}

Total: ¥{{ total }}

Thank you for your purchase!
Résultat de sortie :
Dear John Doe:

Your order ORD-2025-001 has been confirmed. The details are as follows:

- Laptop: ¥8999
- Wireless Mouse: ¥199

Total: ¥9198

Thank you for your purchase!
Exemple 2 : Formater les résultats de récupération de la base de connaissances
Configuration des variables :
|
Nom de la variable |
Valeur de la variable |
|
chunks |
|
Contenu du modèle :
{% for chunk in chunks %}
### Relevance: {{ "%.2f" % chunk.score }}
#### {{ chunk.title }}
{{ chunk.content }}
---
{% endfor %}
Résultat de sortie :
### Relevance: 0.95
#### Product Introduction
This is a detailed introduction to the product...
---
Opérations sur les listes
L'outil Opérations sur les listes vous permet d'effectuer un filtrage et un tri flexibles sur divers types de données de liste pour un traitement et une sélection granulaires des données.
Input
Liste d'entrée : Les données de liste à traiter. Il prend en charge tout sous-type, tel que les chaînes, les nombres, les booléens, les objets fichier et les dictionnaires.
-
Opérations : Une séquence d'opérations chaînées qui sont exécutées dans l'ordre. Il prend en charge deux types d'opérations : le filtrage et le tri.
-
Opération de filtrage (filter) : L'opération de filtrage fournit dynamiquement différentes méthodes de filtrage en fonction du type de la liste d'entrée. Remarque : Toutes les opérations de filtrage sont sensibles à la casse.
Clé de filtre
Description
Portée
Index
Filtre en fonction de la position de l'élément dans la liste.
S'applique à tous les types de liste.
Valeur de l'élément
Filtre en fonction de la valeur de l'élément lui-même.
S'applique à tous les types de liste.
Attribut personnalisé
Filtre en fonction d'un attribut personnalisé.
S'applique uniquement aux listes de dictionnaires.
Attribut de fichier
Filtre en fonction des attributs d'un fichier.
S'applique uniquement aux listes de fichiers.
-
Opération de tri (sort) : L'opération de tri fournit différentes méthodes de tri en fonction du type de la liste d'entrée.
Clé de tri
Description
Portée
Valeur de l'élément
Trie en fonction de la valeur de l'élément lui-même.
S'applique uniquement aux listes de chaînes, de nombres ou de booléens.
Attribut personnalisé
Trie en fonction d'un attribut personnalisé.
S'applique uniquement aux listes de dictionnaires.
Attribut de fichier
Trie en fonction des attributs d'un fichier.
S'applique uniquement aux listes de fichiers. Les attributs disponibles sont les mêmes que pour l'opération de filtrage.
-
Output
result : Le résultat de la liste traitée.
first_item : Le premier élément de la liste de résultats. Si la liste est vide, la valeur est
None.last_item : Le dernier élément de la liste de résultats. Si la liste est vide, la valeur est
None.
Usage examples
Exemple 1 : Classification de fichiers - Filtrer les fichiers image, trier par longueur du nom de fichier et prendre les 3 premiers
Scénario : Un utilisateur télécharge une liste mixte de divers types de fichiers. Vous devez filtrer les fichiers image, les trier par longueur du nom de fichier et ne conserver que les 3 premiers pour le traitement ultérieur de reconnaissance d'image.
Configuration des opérations :
Operation 1 - Filter (by file category):
  Filter key: item.category
  Filter operator: equals
  Filter value: image

Operation 2 - Sort (by file name length):
  Sort key: item.file_name
  Sort direction: asc

Operation 3 - Filter (take top 3):
  Filter key: index
  Filter operator: less than
  Filter value: 3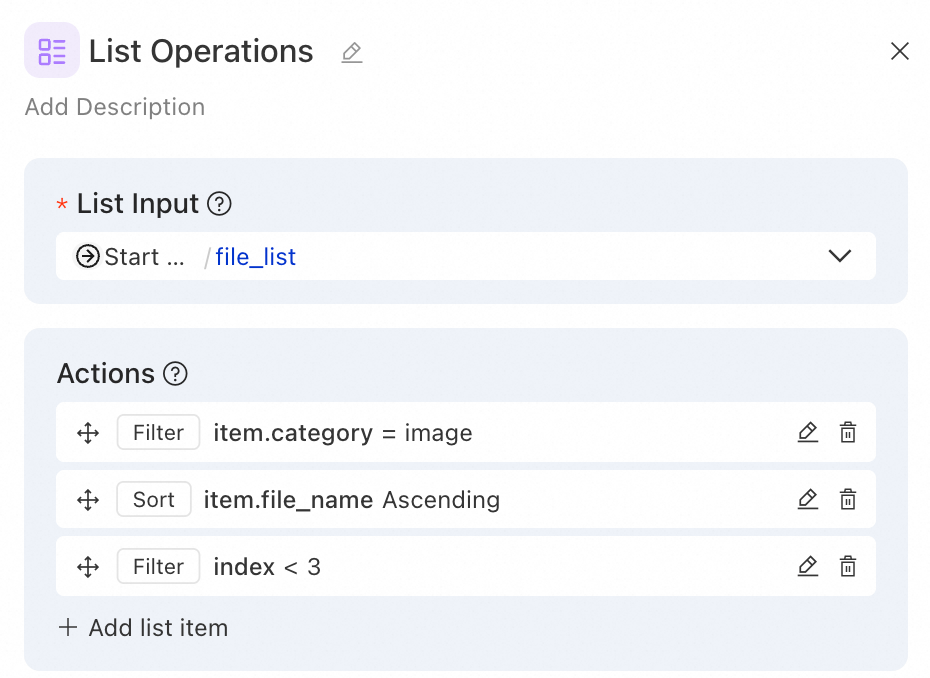
Exemple 2 : Analyse de données - Filtrer les utilisateurs ayant un score élevé et obtenir les 5 premiers
Scénario : À partir d'une liste de notes d'utilisateurs, filtrez les utilisateurs ayant un score supérieur ou égal à 80, triez-les par score décroissant et prenez les 5 premiers.
Liste d'entrée :
[
  {"name": "Zhang San", "score": 95, "department": "Tech Dept"},
  {"name": "Li Si", "score": 72, "department": "Marketing Dept"},
  {"name": "Wang Wu", "score": 88, "department": "Tech Dept"},
  {"name": "Zhao Liu", "score": 91, "department": "Product Dept"},
  {"name": "Qian Qi", "score": 65, "department": "Marketing Dept"},
  {"name": "Sun Ba", "score": 98, "department": "Tech Dept"}
]
Configuration des opérations :
Operation 1 - Filter (high-scoring users):
  Filter key: item.score
  Filter operator: greater than or equal to
  Filter value: 80

Operation 2 - Sort (by score descending):
  Sort key: item.score
  Sort direction: desc

Operation 3 - Filter (take top 5):
  Filter key: index
  Filter operator: less than
  Filter value: 5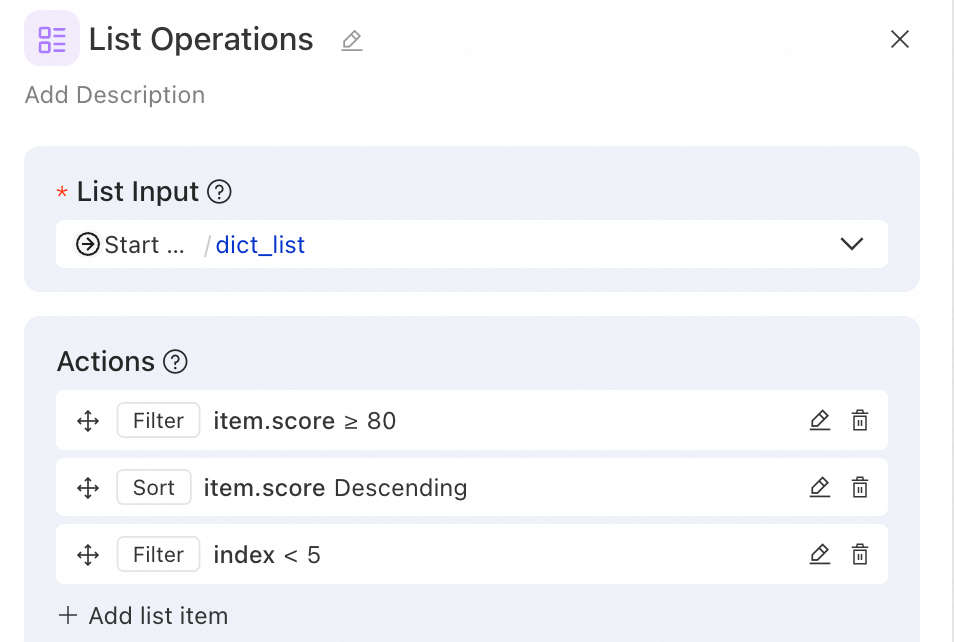
Résultat de sortie :
[
  {"name": "Sun Ba", "score": 98, "department": "Tech Dept"},
  {"name": "Zhang San", "score": 95, "department": "Tech Dept"},
  {"name": "Zhao Liu", "score": 91, "department": "Product Dept"},
  {"name": "Wang Wu", "score": 88, "department": "Tech Dept"}
]
Remarques :
Si l'entrée de l'outil référence une variable de sortie de type
listpersonnalisée dans un nœud Python, définissez un type d'élément clair pour la liste dans le nœud Python, tel quelist[str]. Cela garantit une correspondance plus précise des opérateurs dans le nœud Opérations sur les listes.