Les bases de connaissances LangStudio transforment les documents OSS en index vectoriels pour la génération augmentée par récupération (RAG). Créez une base de connaissances une fois et réutilisez-la dans plusieurs flux d'applications.
Fonctionnement
Une base de connaissances convertit les fichiers OSS en contenu récupérable par un LLM en trois étapes :
-
Lecture des données et découpage : Le système lit les fichiers sources depuis OSS et les divise en unités traitables.
Les documents non structurés sont analysés et divisés en blocs de texte plus petits et sémantiquement complets (chunks).
Les données structurées sont découpées par ligne.
Les images sont traitées dans leur intégralité sans être découpées.
Vectorisation : Le système appelle un modèle d'embedding pour convertir chaque chunk ou image en un vecteur numérique représentant sa signification sémantique.
Stockage et indexation : Le système stocke les données vectorielles dans une base de données vectorielle et crée un index pour la récupération.
Prise en main
Créez une base de connaissances de type Document et utilisez-la dans un flux d'application :
-
Créer une base de connaissances. Accédez à LangStudio et sélectionnez un espace de travail. Dans l'onglet Knowledge Base, cliquez sur Create Knowledge Base. Configurez les paramètres suivants et cliquez sur OK.
Paramètre
Description
Basic Configuration
Name
Saisissez un nom personnalisé pour la base de connaissances, par exemple
test_kg.Data Source OSS Path
Emplacement de stockage des fichiers sources. Par exemple :
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/original/.Output OSS Path
Stocke les résultats d'analyse intermédiaires et les données d'index. La sortie finale dépend du type de base de données vectorielle sélectionné. Par exemple :
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/output/.ImportantSi le Instance RAM Role pour l'exécution est le rôle par défaut PAI, définissez ce paramètre sur un répertoire situé dans le bucket OSS du chemin de stockage par défaut de l'espace de travail actuel.
Type
Sélectionnez Document.
Embedding Model and Database
Embedding Type
Sélectionnez Alibaba Cloud Model Studio Service (créez d'abord une connexion, voir Connection Configuration), puis sélectionnez la connexion et le modèle.
Vector Database Type
Sélectionnez FAISS pour des tests rapides.
-
Télécharger des fichiers.
Dans l'onglet Knowledge Base, cliquez sur la base de connaissances. Sur la page Overview, basculez vers l'onglet Documents. Cet onglet affiche les documents provenant de la source de données OSS configurée.
-
Ajoutez ou mettez à jour des fichiers à l'aide du bouton Upload, ou téléchargez des fichiers directement dans la source de données OSS. Par exemple, téléchargez rag_test_doc.txt via la page. Pour connaître les formats de fichiers pris en charge, consultez Types de bases de connaissances.

-
Mettre à jour l'index. Après avoir téléchargé des fichiers, cliquez sur Update Index dans le coin supérieur droit. Dans la boîte de dialogue, configurez les ressources de calcul et le réseau. Lorsque la tâche réussit, l'état du fichier passe à Indexed. Cliquez sur un fichier pour prévisualiser ses chunks. Pour les bases de connaissances d'images, le système renvoie des listes d'images.
RemarquePour les chunks de documents stockés dans Milvus, définissez leur statut individuellement sur Enabled ou Disabled. Les chunks désactivés ne sont pas récupérés lors des recherches.

-
Exécuter un test de récupération. Après la mise à jour de l'index, basculez vers l'onglet Recall Test. Saisissez une requête et ajustez les paramètres de récupération pour tester les performances.

-
Utiliser la base de connaissances dans un flux d'application. Après les tests, récupérez les informations de la base de connaissances dans un flux d'application. Dans le nœud de la base de connaissances, activez les fonctionnalités de réécriture de requête et de reclassement des résultats, et consultez la requête réécrite dans la trace d'exécution.

Le résultat est un
List[Dict]. ChaqueDictcontient les cléscontentetscore, représentant le chunk récupéré et son score de similarité avec la requête.[ { "score": 0.8057173490524292, "content": "Due to the uncertainty caused by the pandemic, XX Bank proactively increased provisions for impairment losses on loans, advances, and non-credit assets based on economic trends and forecasts for China or the Chinese mainland. The bank also increased the write-off and disposal of non-performing assets to improve the provision coverage ratio. In 2020, the net profit reached 28.928 billion CNY, a year-on-year increase of 2.6%, and profitability gradually improved.\n(CNY in millions) 2020 2019 Change (%)\nOperating Results and Profitability\nOperating Income 153,542 137,958 11.3\nOperating Profit Before Impairment Losses 107,327 95,816 12.0\nNet Profit 28,928 28,195 2.6\nCost-to-Income Ratio(1)(%) 29.11 29.61 down 0.50 percentage points\nAverage Return on Total Assets (%) 0.69 0.77 down 0.08 percentage points\nWeighted Average Return on Equity (%) 9.58 11.30 down 1.72 percentage points\nNet Interest Margin(2)(%) 2.53 2.62 down 0.09 percentage points\nNote: (1) Cost-to-Income Ratio = Business and management fees / Operating income.", "id": "49f04c4cb1d48cbad130647bd0d75f***1cf07c4aeb7a5d9a1f3bda950a6b86e", "metadata": { "page_label": "40", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } }, { "score": 0.7708036303520203, "content": "7.2 billion CNY, a year-on-year increase of 5.2%.\n2020\n(CNY in millions) Life and Health Insurance Business, Property and Casualty Insurance Business, Banking Business, Trust Business, Securities Business, Other Asset Management Business, Technology Business, Other Business and Consolidation Elimination, Group Consolidated\nNet profit attributable to shareholders of the parent company 95,018 16,083 16,766 2,476 2,959 5,737 7,936 (3,876) 143,099\nMinority interest 1,054 76 12,162 3 143 974 1,567 281 16,260\nNet profit (A) 96,072 16,159 28,928 2,479 3,102 6,711 9,503 (3,595) 159,359\nItems excluded:\n Short-term investment fluctuation(1)(B) 10,308 – – – – – – – 10,308\n Impact of discount rate change (C) (7,902) – – – – – – – (7,902)\n One-time significant items and others excluded by management as not part of daily operating income and expenditure (D) – – – – – – 1,282 – 1,282\nOperating profit (E=A-B-C-D) 93,666 16,159 28,928 2,479 3,102 6,711 8,221 (3,595) 155,670\nOperating profit attributable to shareholders of the parent company 92,672 16,", "id": "8066c16048bd722d030a85ee8b1***36d5f31624b28f1c0c15943855c5ae5c9f", "metadata": { "page_label": "19", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XXX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } } ]
Fonctionnalités
Type de base de connaissances
Sélectionnez le type de base de connaissances correspondant à vos fichiers :
Documents : Prend en charge
.html,.htm,.pdf,.txt,.docx,.mdet.pptx.Données structurées : Prend en charge
.jsonl,.csv,.xlsxet.xls.Images : Prend en charge
.jpg,.jpeg,.pnget.bmp.
Configurations spéciales :
-
Pour les bases de connaissances de type Document, configurez Chunk Configuration. Ces champs sont obligatoires. Pour obtenir des conseils sur la définition des paramètres de découpage, consultez Réglage des paramètres de découpagetuning.
Chunk Size : Nombre maximal de caractères par chunk de texte. Valeur par défaut : 1024 caractères.
Chunk Overlap : Nombre de caractères qui se chevauchent entre les chunks adjacents pour assurer la continuité contextuelle. Valeur par défaut : 200 caractères.
Pour les bases de connaissances de type Données structurées, configurez Field Settings. Téléchargez un fichier (tel que animal.csv) ou ajoutez des champs manuellement pour spécifier quels champs de données participent à l'indexation et à la récupération.
Choisir une base de données vectorielle
Environnements de production : Utilisez Milvus ou Elasticsearch, qui prennent en charge le traitement de volumes importants de données vectorielles.
-
Environnement de test : Utilisez FAISS, qui ne nécessite aucune base de données supplémentaire. Les fichiers de la base de connaissances et les fichiers d'index générés sont stockés dans le Output OSS Path. FAISS convient aux tests fonctionnels ou aux petits jeux de données, mais les performances peuvent se dégrader avec de grands volumes de données.
RemarqueLes bases de connaissances de type Image ne prennent pas en charge FAISS.
Stratégie de mise à jour de l'index
|
Méthode de mise à jour |
Description |
Notes |
|
Mise à jour manuelle |
Cliquez sur Update Index dans la console. Idéal lorsque les fichiers changent rarement. |
Traite les fichiers entièrement ou de manière incrémentielle. |
|
Mise à jour automatique |
Crée une règle EventBridge qui déclenche l'indexation lorsque les fichiers OSS changent. |
Important
Des frais de messagerie sont engagés lors des mises à jour automatiques.
|
|
Mise à jour planifiée |
Utilise une tâche récurrente DataWorks pour mettre à jour l'index selon un calendrier (par exemple, quotidiennement). |
Dépend de DataWorks. Les tâches récurrentes prennent effet sur une base T+1 (les configurations effectuées aujourd'hui s'exécutent demain). |
Méthodes de configuration :
Mise à jour manuelle
Cliquez sur Update Index. Le système soumet une tâche de workflow PAI pour prétraiter, découper, vectoriser et indexer les fichiers. Paramètres de la tâche :
|
Paramètre |
Description |
|
Ressource de calcul |
Ressources de calcul pour les nœuds de workflow. Utilisez les ressources publiques, ou utilisez les ressources Lingjun et les ressources de calcul générales via les quotas de ressources.
|
|
Configuration VPC |
Si vous accédez à la base de données vectorielle ou au service d'embedding via le réseau interne, assurez-vous que le VPC sélectionné est identique ou peut communiquer avec les VPC de ces services. |
|
Configuration d'embedding |
|
Mise à jour automatique
Accédez à la console EventBridge et activez EventBridge.
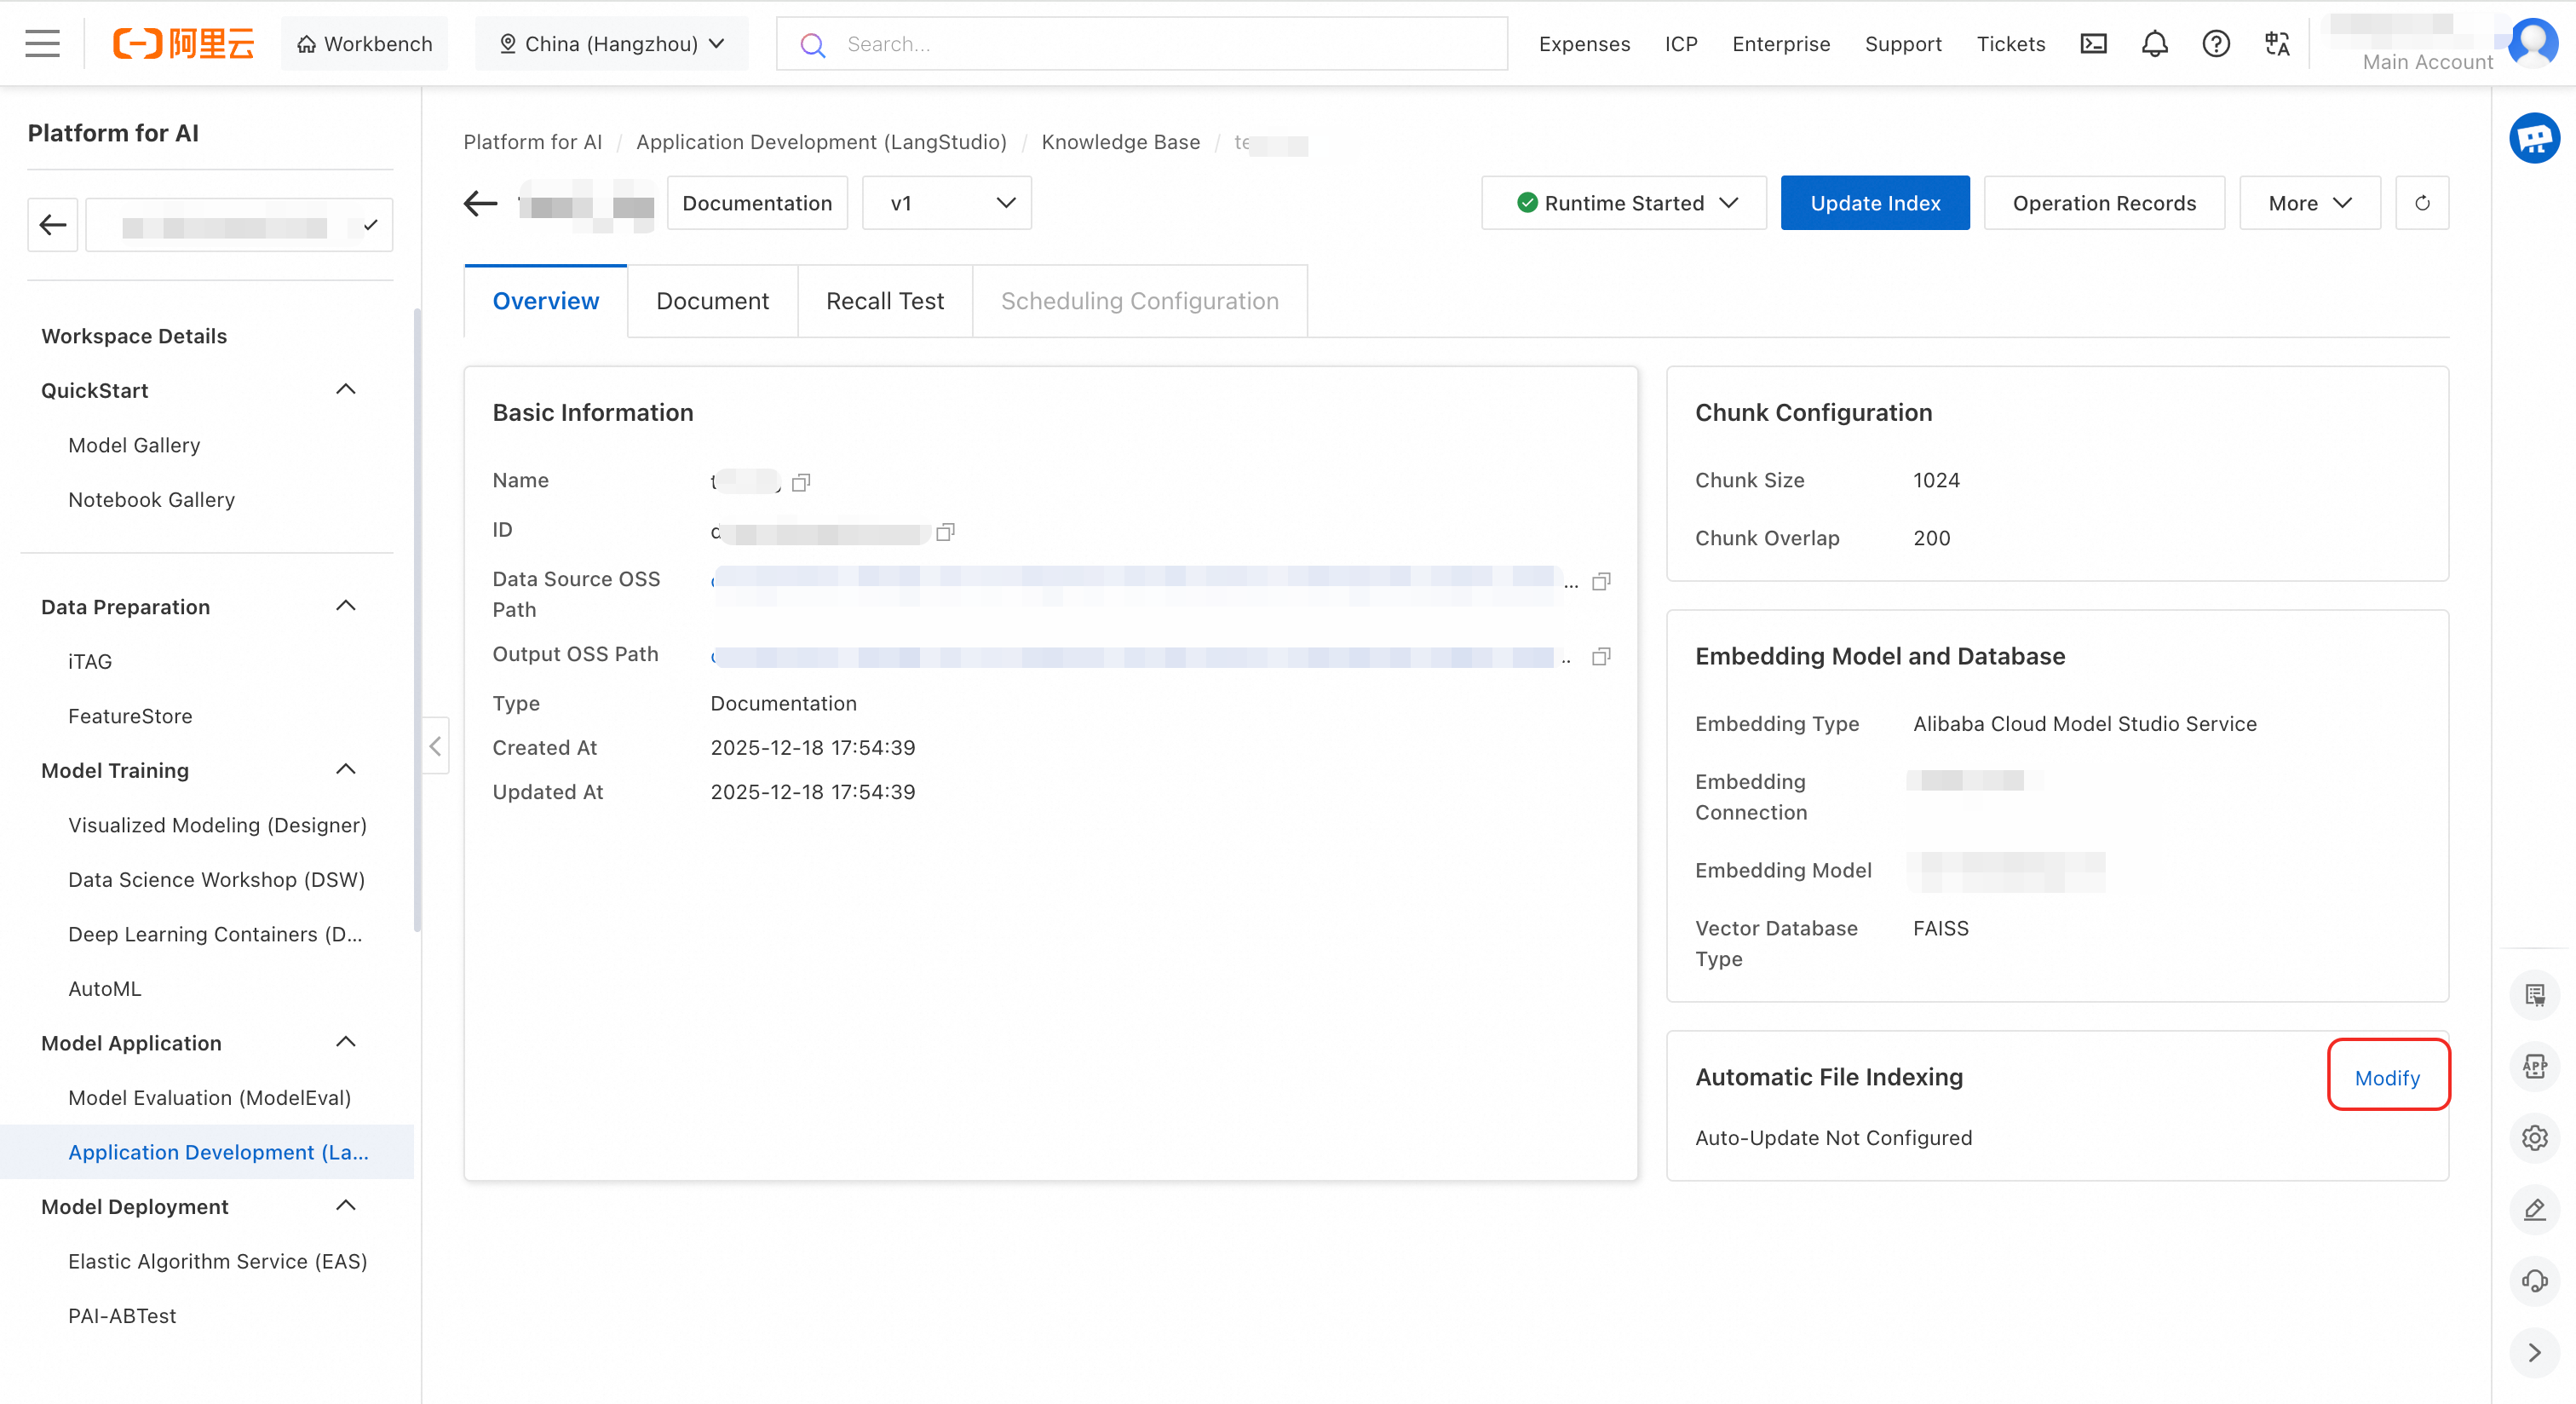
Configurez les mises à jour automatiques de l'index. Accédez à la page des détails de la base de connaissances. Dans l'onglet Overview, dans la section Automatic File Indexing en bas à droite, cliquez sur Modify.
-
Configurez les ressources de calcul et le VPC, puis cliquez sur OK. Par la suite, les modifications de fichiers déclenchent automatiquement les tâches d'indexation sans intervention manuelle.
ImportantLes ressources de calcul configurées ici ne sont utilisées que lorsque les fichiers sont mis à jour. Aucun frais de ressource n'est engagé si les fichiers ne changent pas.
-
Apportez des modifications aux fichiers OSS.
Après avoir configuré les mises à jour automatiques des fichiers, il y a un délai de quelques minutes avant que les règles ne prennent effet. Attendez au moins 3 minutes avant d'opérer sur les fichiers.
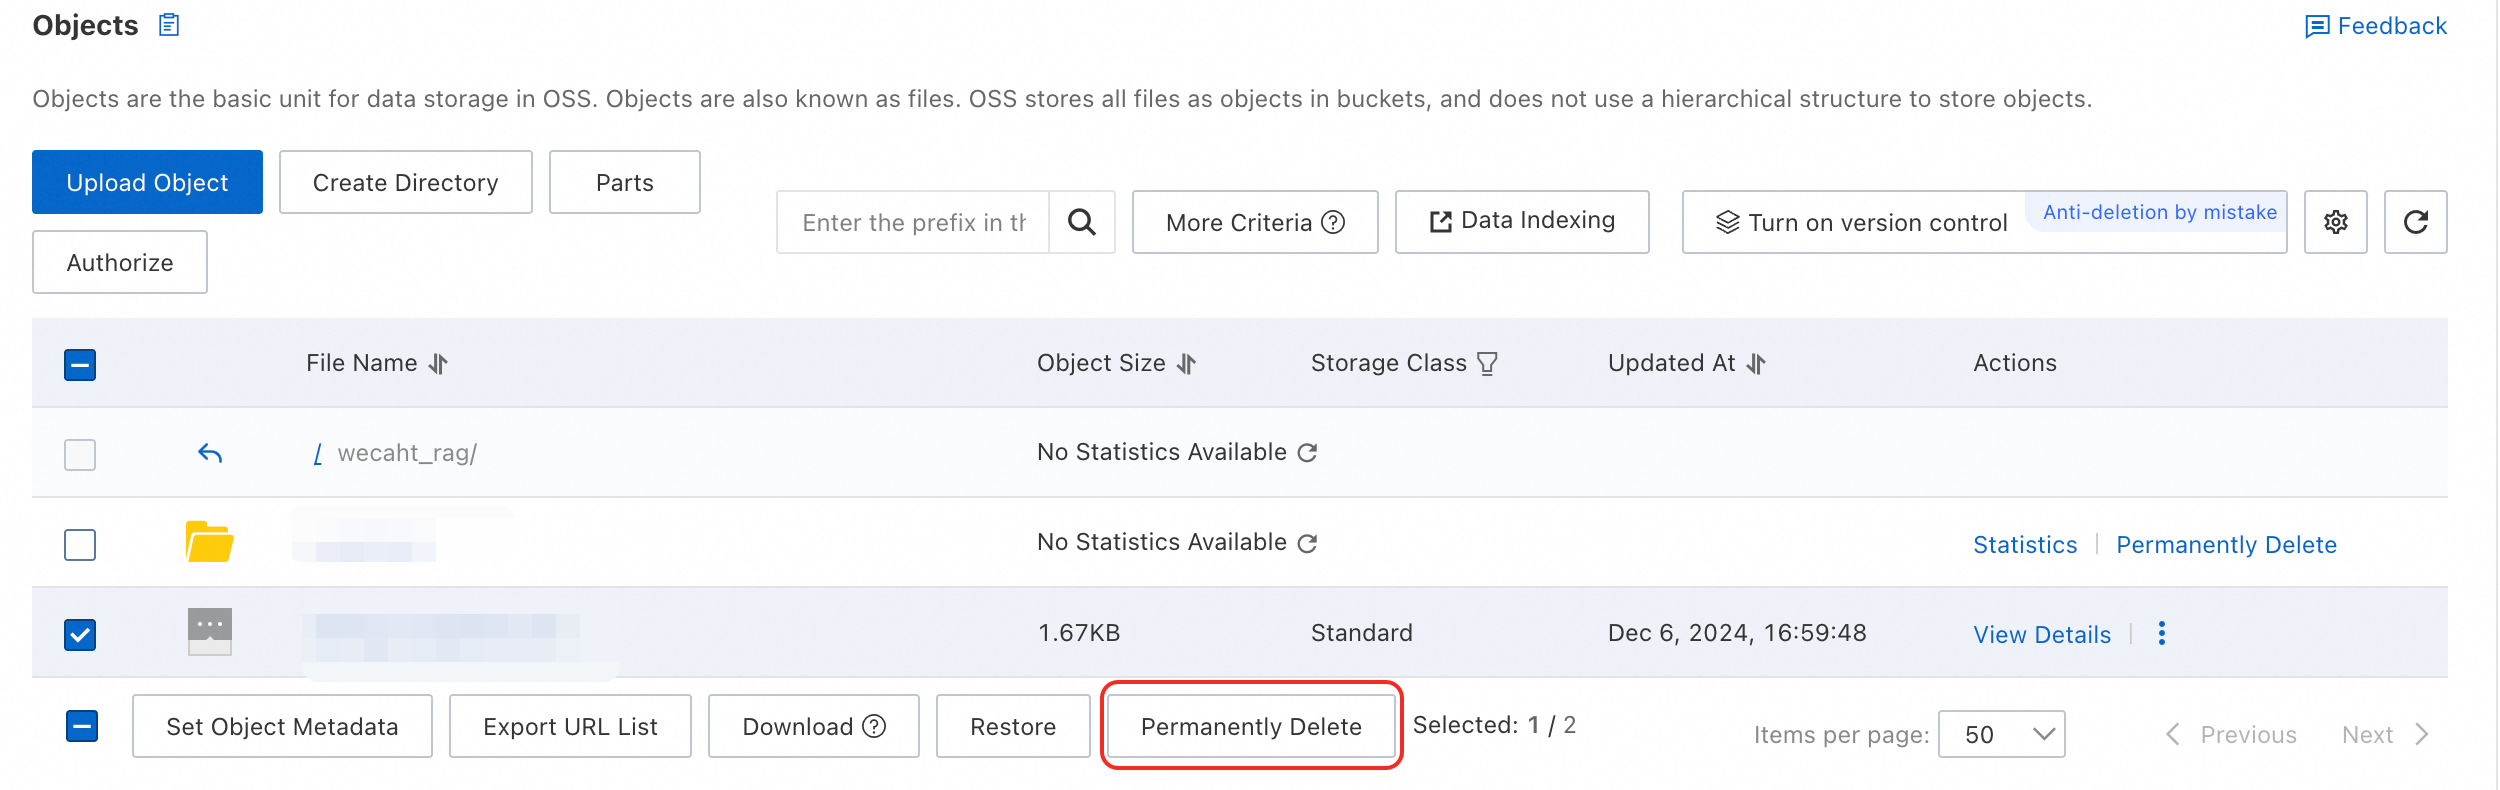
Pour supprimer un fichier à l'aide de l'API OSS, spécifiez une version pour déclencher l'événement de modification.
-
Pour supprimer un fichier dans la console, sélectionnez le fichier et cliquez sur Permanently Delete en bas.
Consultez les tâches d'indexation. Après la modification d'un fichier, attendez environ 3 minutes. La tâche de construction d'index déclenchée automatiquement apparaît dans la liste des enregistrements d'opérations.
Mise à jour planifiée
La fonctionnalité de mise à jour planifiée repose sur DataWorks. Assurez-vous d'avoir activé ce service. Si ce n'est pas le cas, consultez le Guide d'achat.
Sur la page des détails de la base de connaissances, cliquez sur dans le coin supérieur droit, complétez les configurations et soumettez.

-
Afficher les configurations de planification et les tâches récurrentes
Le système crée un workflow dans DataWorks DataStudio et le publie en tant que tâche récurrente dans DataWorks Operation Center. Les tâches récurrentes prennent effet sur une base T+1. Consultez la configuration de planification sur la page de configuration de planification de la base de connaissances.

-
Descriptions des paramètres de configuration planifiée :
Cycle de planification : Fréquence d'exécution du nœud en production (nombre d'instances de cycle générées et moment de leur exécution).
Heure planifiée : Heure spécifique à laquelle le nœud s'exécute.
Définition du délai d'expiration : Durée après laquelle un nœud en cours d'exécution échoue et se termine.
Date d'effet : Plage de temps pendant laquelle le nœud s'exécute selon son calendrier automatique. En dehors de cette plage, le nœud n'est plus planifié automatiquement.
-
Groupe de ressources de planification : Utilisé pour les mises à jour planifiées DataWorks. Si vous n'avez pas encore créé de groupe de ressources DataWorks, cliquez sur Create Now dans la liste déroulante pour accéder à la page de création. Après la création, liez le groupe de ressources à l'espace de travail actuel.

Les paramètres de planification sont décrits dans Description de la configuration des propriétés temporelles.
Afficher le jeu de données
Après une mise à jour d'index réussie, le système enregistre le Output OSS Path en tant que jeu de données. Consultez-le dans AI Asset Management - Datasets. Le jeu de données partage le nom de la base de connaissances et enregistre la sortie de la construction d'index.

Configurer l'environnement d'exécution
Sélectionnez un environnement d'exécution pour prévisualiser les chunks et exécuter des tests de récupération. Ces opérations accèdent à la base de données vectorielle et au service d'embedding.
Exigences de l'environnement d'exécution :
Si vous accédez à la base de données vectorielle ou au service d'embedding via une adresse de réseau interne, assurez-vous que le VPC de l'environnement d'exécution est identique ou peut communiquer avec ceux de ces services.
Si vous sélectionnez un rôle personnalisé pour Instance RAM Role, accordez à ce rôle des autorisations d'accès OSS (nous recommandons
AliyunOSSFullAccess). Octroi d'autorisations à un rôle RAM.
Si la version de l'environnement d'exécution est obsolète (antérieure à 2.1.4), elle peut ne pas apparaître dans la liste déroulante. Créez un nouvel environnement d'exécution.
Gérer plusieurs versions
Clonez une version testée de la base de connaissances en tant que nouvelle version officielle pour isoler les environnements de développement et de production.
Basculez entre les versions à l'aide de la liste déroulante à côté du type sur la page des détails de la base de connaissances. Sélectionnez la version souhaitée dans le nœud de la base de connaissances d'un flux d'application.

Le clonage soumet une tâche de workflow visible dans les enregistrements d'opérations.

Configurer les paramètres de récupération
Top K : Nombre maximal de chunks pertinents à récupérer. Plage : 1 à 100.
Seuil de score : Seuil de score de similarité (0 à 1). Seuls les chunks dont le score est supérieur à cette valeur sont renvoyés.
Mode de récupération : La valeur par défaut est Dense (vectoriel). La récupération hybride (vectorielle + mot-clé) nécessite Milvus 2.4.x+ ou Elasticsearch. Sélectionner un mode de récupération.
Condition de filtre de métadonnées : Réduit la portée de la recherche à l'aide des métadonnées. Utiliser les métadonnées.
Réécriture de requête : Utilise un LLM pour clarifier les requêtes vagues ou dépendantes du contexte, améliorant ainsi la précision de la récupération. Réécriture de requête.
-
Reclassement des résultats : Utilise un modèle de reclassement pour réorganiser les résultats, plaçant les plus pertinents en haut. Reclassement des résultats.
RemarqueNécessite un modèle de reclassement. Types de connexion pris en charge : Model Studio, AI Search Open Platform Model Service et General Reranker Model Service.
Optimiser les performances de récupération
Ajuster les paramètres de découpage
Principes directeurs
Limite de contexte du modèle : La taille du chunk ne doit pas dépasser la limite de jetons du modèle d'embedding.
Intégrité de l'information : Les chunks doivent contenir une signification sémantique complète sans bruit excessif. Envisagez un découpage par paragraphe pour les textes structurés.
Maintenir la continuité : Définissez le chevauchement à 10 %-20 % de la taille du chunk pour éviter la perte de contexte aux limites.
Éviter les interférences répétitives : Un chevauchement excessif introduit de la redondance et réduit l'efficacité de la récupération.
Suggestions de débogage
Optimisation itérative : Commencez par une valeur initiale (par exemple, taille de chunk de 300 et chevauchement de 50) et itérez en fonction des résultats de récupération et de questions-réponses pour trouver les paramètres optimaux pour vos données.
Limites du langage naturel : Si votre texte a une structure claire (par exemple, divisé par chapitres ou paragraphes), envisagez de le diviser selon ses limites naturelles pour préserver l'intégrité sémantique.
Guide d'optimisation rapide
|
Problème |
Suggestion d'optimisation |
|
Les résultats de récupération ne sont pas pertinents |
Augmentez la taille du chunk, diminuez le chevauchement des chunks. |
|
Le contexte du résultat n'est pas cohérent |
Augmentez le chevauchement des chunks. |
|
Impossible de trouver une correspondance appropriée (faible rappel) |
Augmentez modérément la taille du chunk. |
|
Coûts de calcul ou de stockage élevés |
Diminuez la taille du chunk, diminuez le chevauchement des chunks. |
Le tableau suivant fournit les tailles de chunk et de chevauchement recommandées pour différents types de texte, basées sur l'expérience passée :
|
Type de texte |
Taille de chunk recommandée (chunk_size) |
Taille de chevauchement recommandée (chunk_overlap) |
|
Texte court (FAQ, résumé) |
100 à 300 |
20 à 50 |
|
Texte régulier (actualités, blog) |
300 à 600 |
50 à 100 |
|
Documents techniques (API, article) |
600 à 1024 |
100 à 200 |
|
Documents longs (juridique, livre) |
1024 à 2048 |
200 à 400 |
Choisir un mode de récupération
Chaque mode de récupération présente des forces adaptées à différents scénarios :
Récupération dense (vectorielle) : Excellente pour comprendre la sémantique. Convertit à la fois la requête et les documents en vecteurs et détermine la pertinence sémantique en calculant la similarité vectorielle.
Récupération sparse (par mot-clé) : Excellente pour la correspondance exacte. Basée sur des modèles traditionnels de fréquence de termes (comme BM25), elle calcule la pertinence en fonction de la fréquence et de la position des mots-clés dans un document.
Récupération hybride : Combine le meilleur des deux mondes. Fusionne les résultats de la recherche vectorielle et de la recherche par mots-clés et les reclasse à l'aide d'algorithmes tels que Reciprocal Rank Fusion (RRF) ou la fusion pondérée.
|
Mode de récupération |
Avantages et inconvénients |
Scénarios |
|
Récupération dense (vectorielle) |
|
|
|
Récupération sparse (par mot-clé) |
|
|
|
Récupération hybride |
|
|
Utiliser les métadonnées pour filtrer la récupération
Valeur du filtrage par métadonnées
Récupération précise, moins de bruit : Les métadonnées peuvent servir de filtre lors de la récupération. Le filtrage avec les métadonnées vous permet d'exclure les documents non pertinents et empêche le modèle de génération de recevoir du contenu non lié. Par exemple, lorsqu'un utilisateur demande « Trouvez des romans de science-fiction écrits par Liu Cixin », le système peut utiliser les conditions de métadonnées
author=Liu Cixinetcategory=science fictionpour localiser directement les documents les plus pertinents.-
Expérience utilisateur améliorée
Recommandations personnalisées : Utilisez les métadonnées pour fournir des recommandations personnalisées en fonction des préférences historiques de l'utilisateur (telles que la préférence pour les documents de « science-fiction »).
Interprétabilité améliorée : Inclure les métadonnées d'un document (telles que l'auteur, la source, la date) dans les résultats aide les utilisateurs à juger de sa crédibilité et de sa pertinence.
Prend en charge l'expansion multilingue ou multimodale : Les métadonnées telles que « langue » ou « type de média » simplifient la gestion des bases de connaissances avec plusieurs langues ou médias mixtes tels que le texte et les images.
Comment utiliser
Limitations de la fonctionnalité :
Version de l'image de l'environnement d'exécution : Doit être 2.1.8 ou ultérieure.
Base de données vectorielle : Seuls Milvus et Elasticsearch sont pris en charge.
Type de base de connaissances : Prend en charge les documents ou les données structurées. Les images ne sont pas prises en charge.
-
Configurer les variables de métadonnées. Pour les bases de connaissances utilisant Milvus, trouvez la section Metadata dans l'onglet Overview. Cliquez sur Edit pour configurer les variables (par exemple, une variable nommée
author). N'utilisez pas de champs réservés.
-
Taguer les documents. Accédez à la page des détails des chunks de documents, cliquez sur Edit Metadata, et ajoutez la variable de métadonnées et sa valeur (par exemple,
author=Alex). Sur la page Overview, consultez l'utilisation des métadonnées et le nombre de valeurs.
-
Tester l'effet du filtrage. Dans l'onglet Recall Test, ajoutez une condition de filtre de métadonnées et exécutez un test.

Remarque : Les documents récupérés dans l'image ont été tagués à l'étape 2.
-
Utiliser dans un flux d'application. Configurez la condition de filtre de métadonnées dans le nœud de la base de connaissances.

Réécriture de requête et reclassement des résultats
Réécriture de requête
Réécrit les requêtes vagues, colloquiales ou dépendantes du contexte en questions claires et autonomes pour une meilleure récupération.
-
Scénarios recommandés :
La requête de l'utilisateur est vague ou incomplète (par exemple, « Quand est-il né ? » sans contexte).
Dans une conversation multi-tours, la requête dépend du contexte (par exemple, « Qu'a-t-il fait ensuite ? »).
Le récupérateur ou le LLM offre de mauvaises performances et ne comprend pas précisément la requête.
Utilisation d'une méthode de récupération par index inversé traditionnel (comme BM25) au lieu de la récupération sémantique.
-
Non recommandé pour :
La requête de l'utilisateur est déjà très claire et spécifique.
Le LLM offre d'excellentes performances et possède une forte compréhension de la requête.
Le système nécessite une faible latence et ne peut pas supporter le délai supplémentaire dû à la réécriture.
Reclassement des résultats
Réorganise les résultats de récupération pour prioriser les documents les plus pertinents.
-
Scénarios recommandés :
Le récupérateur initial fournit des résultats instables (tels que BM25 ou DPR).
Le classement des résultats de récupération est crucial (tel que nécessitant une grande précision Top-1 dans les systèmes de recherche ou de questions-réponses).
-
Non recommandé pour :
Le système dispose de ressources limitées et ne peut pas supporter la surcharge d'inférence supplémentaire.
Les performances du récupérateur initial sont déjà suffisamment fortes et le reclassement apporte une amélioration limitée.
Le temps de réponse est critique, comme dans les scénarios de recherche en temps réel.
FAQ
Comment résoudre les échecs de tâches de mise à jour d'index ou de clonage de version ?
Suivez ces étapes lorsqu'une tâche échoue :
-
Consulter les enregistrements d'opérations : Sur la page des détails de la base de connaissances, trouvez la tâche échouée dans le Operation Records et cliquez sur View Task.

-
Vérifier les journaux de la tâche : Le système vous redirige vers la page de workflow PAI. Vérifiez les journaux du nœud ayant échoué.

Par exemple, la tâche de workflow pour la mise à jour de l'index d'une base de connaissances de type Document comprend les trois nœuds suivants. À l'exception du nœud read-oss-file, chaque nœud crée une tâche PAI-DLC. Vous pouvez également consulter les détails de la tâche DLC via l'URL du job dans les journaux.
read-oss-file : Lit les fichiers OSS.
rag-parse-chunk : Responsable du prétraitement et du découpage des documents.
rag-sync-index : Responsable de l'embedding des chunks de texte et de leur synchronisation avec la base de données vectorielle.
Pourquoi des fichiers système (comme requirements.txt) apparaissent-ils dans la base de connaissances ?
Cause : La base de connaissances indexe tous les fichiers dans le Input OSS Path configuré. Le définir sur la racine d'un projet peut indexer involontairement des fichiers système comme requirements.txt, .DS_Store, .git/, __pycache__/ ou *.pyc.
Solution :
Créez un répertoire dédié (par exemple,
knowledge-base-docs/) dans OSS contenant uniquement les fichiers que vous souhaitez indexer.Mettez à jour le Input OSS Path de la base de connaissances pour pointer vers ce répertoire.
Fichiers courants à exclure :
requirements.txt,.DS_Store,.git/,__pycache__/,*.pyc,*.log.
Comment supprimer des fichiers incorrectement indexés de la base de connaissances ?
Pour supprimer un fichier déjà indexé des résultats de récupération :
-
Supprimer d'OSS : Supprimez le fichier à l'aide de l'une de ces méthodes :
Console : Sélectionnez le fichier et cliquez sur Permanently Delete.
API : Spécifiez un paramètre de version pour déclencher l'événement de modification.
-
Attendre la ré-indexation automatique : Si vous avez configuré Automatic Update (voir Mise à jour automatique) :
Attendez au moins 3 minutes pour que la règle prenne effet.
Vérifiez l'onglet Operation Records pour confirmer que la tâche de ré-indexation est terminée.
Mise à jour manuelle (si la mise à jour automatique n'est pas configurée) : Cliquez sur Update Index dans le coin supérieur droit pour déclencher une ré-indexation complète.
Vérifier la suppression : Consultez l'onglet Documents pour confirmer que l'état du fichier est passé de Indexed à supprimé.
Les enregistrements d'index peuvent prendre quelques minutes pour se propager complètement à la base de données vectorielle. Si le fichier affecte toujours la récupération après la ré-indexation, essayez de déclencher une autre mise à jour d'index manuelle.