Machine Learning Designer prend en charge la prédiction par lots pour les scénarios ne nécessitant pas de génération de résultats en temps réel, tels que l'exécution nocturne de tâches de scoring sur de grands volumes de données, le prétraitement des jeux de données avant l'entraînement ou la génération hebdomadaire de listes de recommandations. Cette rubrique explique comment exécuter des prédictions par lots dans Designer et comment les planifier de manière périodique.
Quand utiliser la prédiction par lots
La prédiction par lots est particulièrement adaptée lorsque vous devez :
Évaluer de grands jeux de données sans attendre de réponses synchrones
Exécuter l'inférence selon un calendrier (quotidien, hebdomadaire ou déclenché par des mises à jour de données)
Générer des prédictions sans avoir besoin d'un endpoint en ligne persistant
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un espace de travail Machine Learning Designer
Un modèle entraîné (OfflineModel ou un modèle entraîné à l'aide de composants appariés)
(Pour la planification périodique) Un espace de travail DataWorks avec les autorisations appropriées
Exécuter la prédiction par lots dans l'environnement de développement
Designer propose des composants de prédiction couvrant divers algorithmes et scénarios. Faites glisser ces composants directement sur le canevas.
Choisir une approche de prédiction
| Approche | Cas d'utilisation | Limitation |
|---|---|---|
| Composants d'entraînement et de prédiction appariés | Un composant de prédiction dédié existe pour votre algorithme (par exemple, l'algorithme FM) | — |
| Composant de prédiction polyvalent | Aucun composant de prédiction dédié n'est disponible pour votre algorithme | Prend uniquement en charge les modèles OfflineModel. Ne prend pas en charge les modèles PMML (Predictive Model Markup Language). |
| Importer un modèle existant | Un modèle pré-entraîné est déjà disponible | — |
Composants d'entraînement et de prédiction appariés
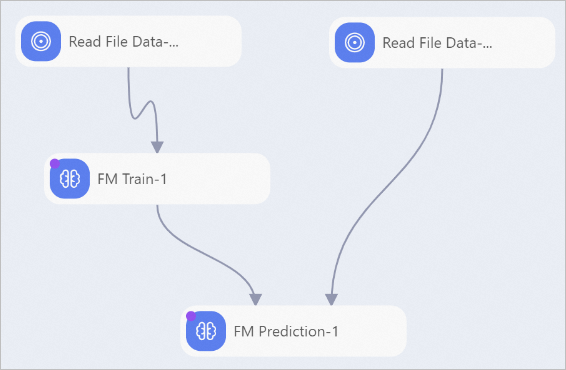
Pour les algorithmes disposant de composants appariés (tels que l'algorithme FM), les composants d'entraînement et de prédiction apparaissent côte à côte dans le volet des composants de gauche. Entraînez d'abord le modèle, puis connectez le composant de prédiction en tant que nœud aval.
Composant de prédiction polyvalent
Si aucun composant de prédiction dédié n'existe pour votre algorithme, utilisez le composant de prédiction polyvalent après l'entraînement du modèle.
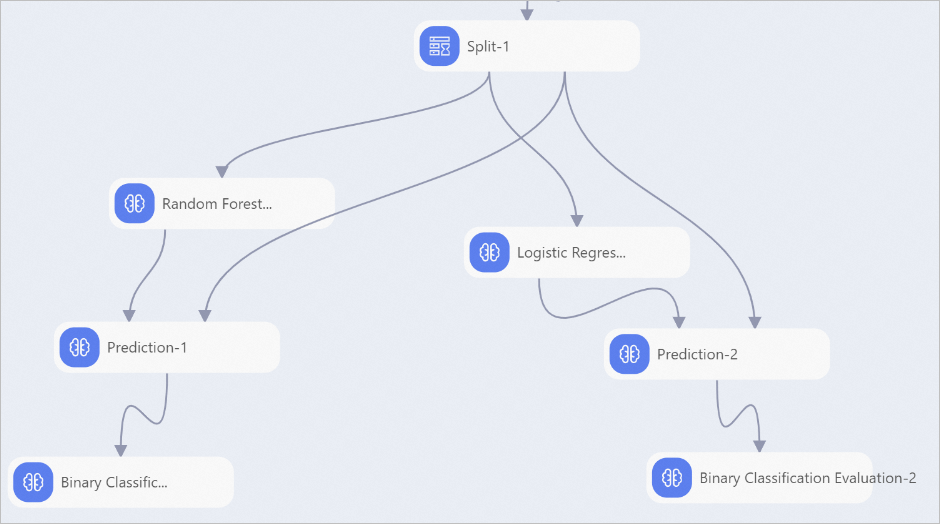
Le composant de prédiction polyvalent prend uniquement en charge les modèles OfflineModel. Il ne prend pas en charge les modèles PMML (Predictive Model Markup Language).
Importer un modèle existant
Pour utiliser un modèle pré-entraîné, importez-le à l'aide d'un composant d'importation de modèle et connectez un composant de prédiction en tant que nœud aval. Cette approche prend également en charge les workflows de prédiction et de déploiement.
Planifier un pipeline de prédiction par lots
Une fois que le pipeline de prédiction par lots a passé les tests, soumettez-le à DataWorks pour une planification périodique.
Étape 1 : Synchroniser le modèle avec l'environnement de production (mode standard uniquement)
Cette étape est requise uniquement si votre espace de travail est en mode standard DataWorks. En mode standard, les environnements de développement et de production maintiennent les données MaxCompute séparément ; vous devez donc synchroniser le modèle OfflineModel entraîné vers l'environnement de production avant la planification.
Deux méthodes sont disponibles :
Méthode 1 : Composants Model Export et Import MaxCompute Offline Model (recommandée)
Utilisez le composant Model Export pour exporter le modèle OfflineModel entraîné vers Object Storage Service (OSS).
Dans le pipeline planifié périodiquement, utilisez le composant Import MaxCompute Offline Model pour importer le modèle depuis OSS.
Méthode 2 : Composants Copy MaxCompute Offline Model et Read MaxCompute Offline Model
-
Utilisez le composant Copy MaxCompute Offline Model pour répliquer le modèle OfflineModel entraîné vers l'environnement de production.
RemarqueVous devez effectuer l'opération de réplication à l'aide d'un compte administrateur d'espace de travail ou d'un compte de production. Pour plus d'informations, consultez Permissions.
Dans le pipeline planifié périodiquement, utilisez le composant Read MaxCompute Offline Model pour lire le modèle depuis l'environnement de production.
Étape 2 : Planifier le pipeline avec DataWorks
Utiliser les tâches DataWorks pour planifier les pipelines dans Machine Learning Designer.
Étapes suivantes
Si les résultats de la prédiction hors ligne répondent à vos attentes, déployez le modèle ou le pipeline en tant que service en ligne :