Cette rubrique décrit les modèles de vecteurs pris en charge par OpenSearch Vector Search Edition.
Recherche vectorielle
À l'ère de l'information, les données peuvent revêtir plusieurs modalités, telles que le texte, l'image, la vidéo et l'audio. Les informations multimodales transmettent davantage d'éléments contextuels que le simple texte, notamment la couleur, la forme, l'état de mouvement, le son et les relations spatiales.
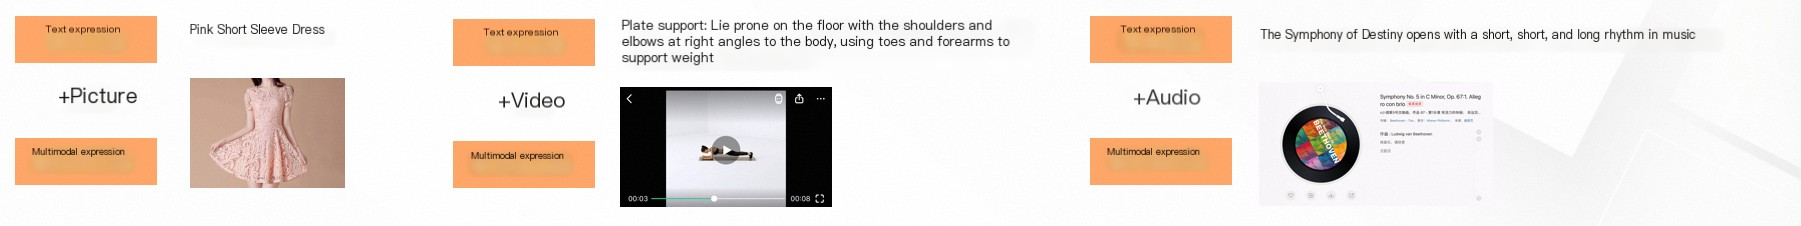
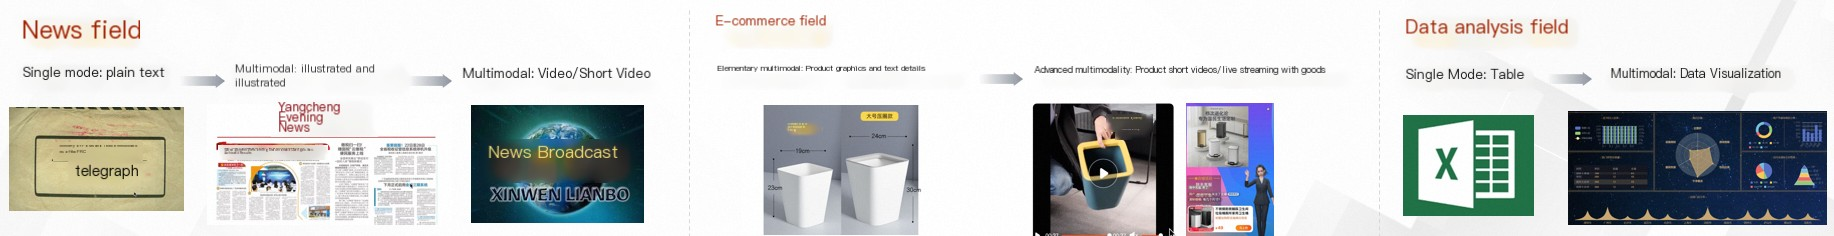
Les modalités de l'information ont considérablement évolué dans divers domaines.
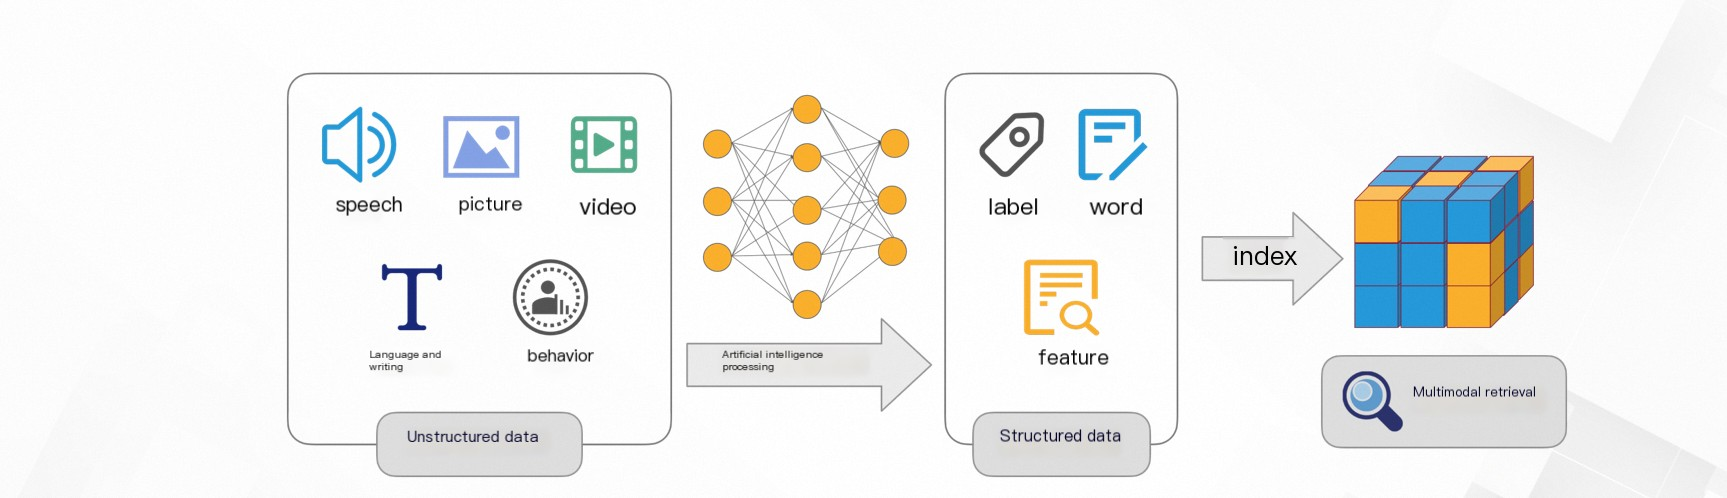
Les informations multimodales se divisent en deux catégories : les données structurées et les données non structurées.
Les ordinateurs peinent à interpréter les données non structurées. Les méthodes de requête traditionnelles, fondées sur l'analyse de termes textuels, ne satisfont plus aux exigences de recherche des différents secteurs. Pour résoudre ce problème, OpenSearch Vector Search Edition propose la recherche vectorielle.
Cette rubrique explique ce qu'est un vecteur et comment effectuer une recherche vectorielle.
Les données non structurées générées dans le monde physique peuvent être transformées en vecteurs multidimensionnels structurés qui identifient les relations entre les entités.
Le système calcule ensuite la distance entre ces vecteurs. En règle générale, plus la distance est faible, plus la similarité vectorielle est élevée. Le système récupère alors les N premiers résultats présentant la similarité vectorielle la plus forte. C'est ainsi que fonctionne la recherche vectorielle.
Algorithmes de recherche vectorielle
Algorithme linéaire
L'algorithme linéaire traite toutes les données vectorielles de manière séquentielle.
Scénario : Utilisez cet algorithme si vous exigez un taux de rappel de 100 %.
Inconvénient : Cet algorithme offre une efficacité limitée et entraîne une forte utilisation du CPU et de la mémoire lors du traitement de grands volumes de données.
Algorithmes de clustering
Clustering quantifié
Présentation
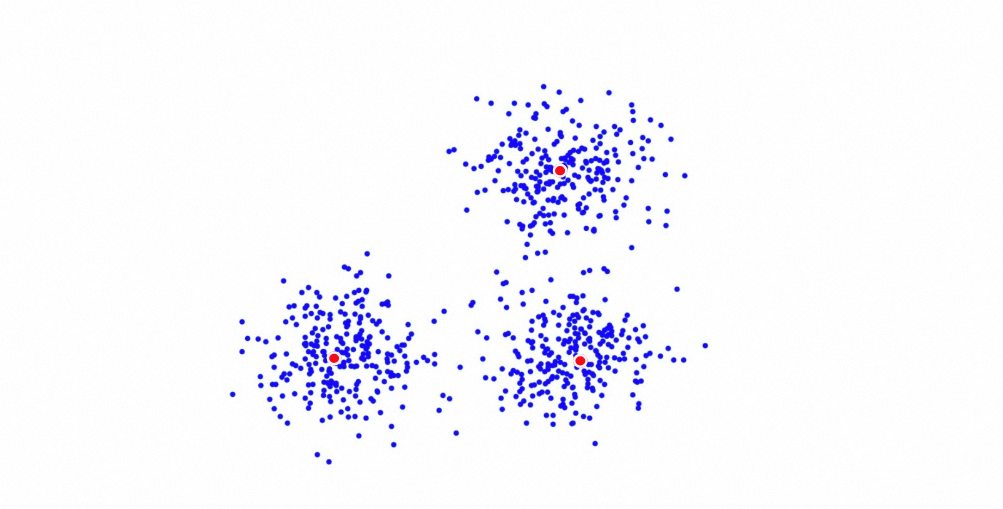
Le clustering quantifié est un algorithme de recherche vectorielle développé par Alibaba Cloud, basé sur le clustering K-means. Cet algorithme identifie n centroïdes pour les documents vectoriels et associe chaque document au centroïde le plus proche. Il construit ainsi n listes de posting. Les n centroïdes et leurs listes de posting associées constituent l'essentiel de l'indexation par clustering quantifié. Lors de la recherche, OpenSearch calcule la distance entre plusieurs centroïdes et le vecteur de requête, puis sélectionne les centroïdes les plus proches. Ensuite, OpenSearch calcule la distance vectorielle pour les documents figurant dans les listes de posting correspondant aux centroïdes sélectionnés et renvoie les K documents les plus proches du vecteur de requête.
Le clustering quantifié prend en charge la quantification FP16 et INT8, ce qui permet de réduire la taille de l'index et d'améliorer les performances de recherche. Toutefois, cette fonctionnalité peut affecter la qualité des résultats récupérés. Activez ou désactivez la quantification FP16 et INT8 selon vos besoins métier.
L'algorithme de clustering quantifié convient aux scénarios de données en temps réel ou aux environnements utilisant des ressources GPU nécessitant une faible latence.
Ajustement des paramètres :
Pour plus d'informations, consultez la section Configurations du clustering quantifié.
La figure suivante illustre les performances des différents algorithmes vectoriels selon le volume de données traité.
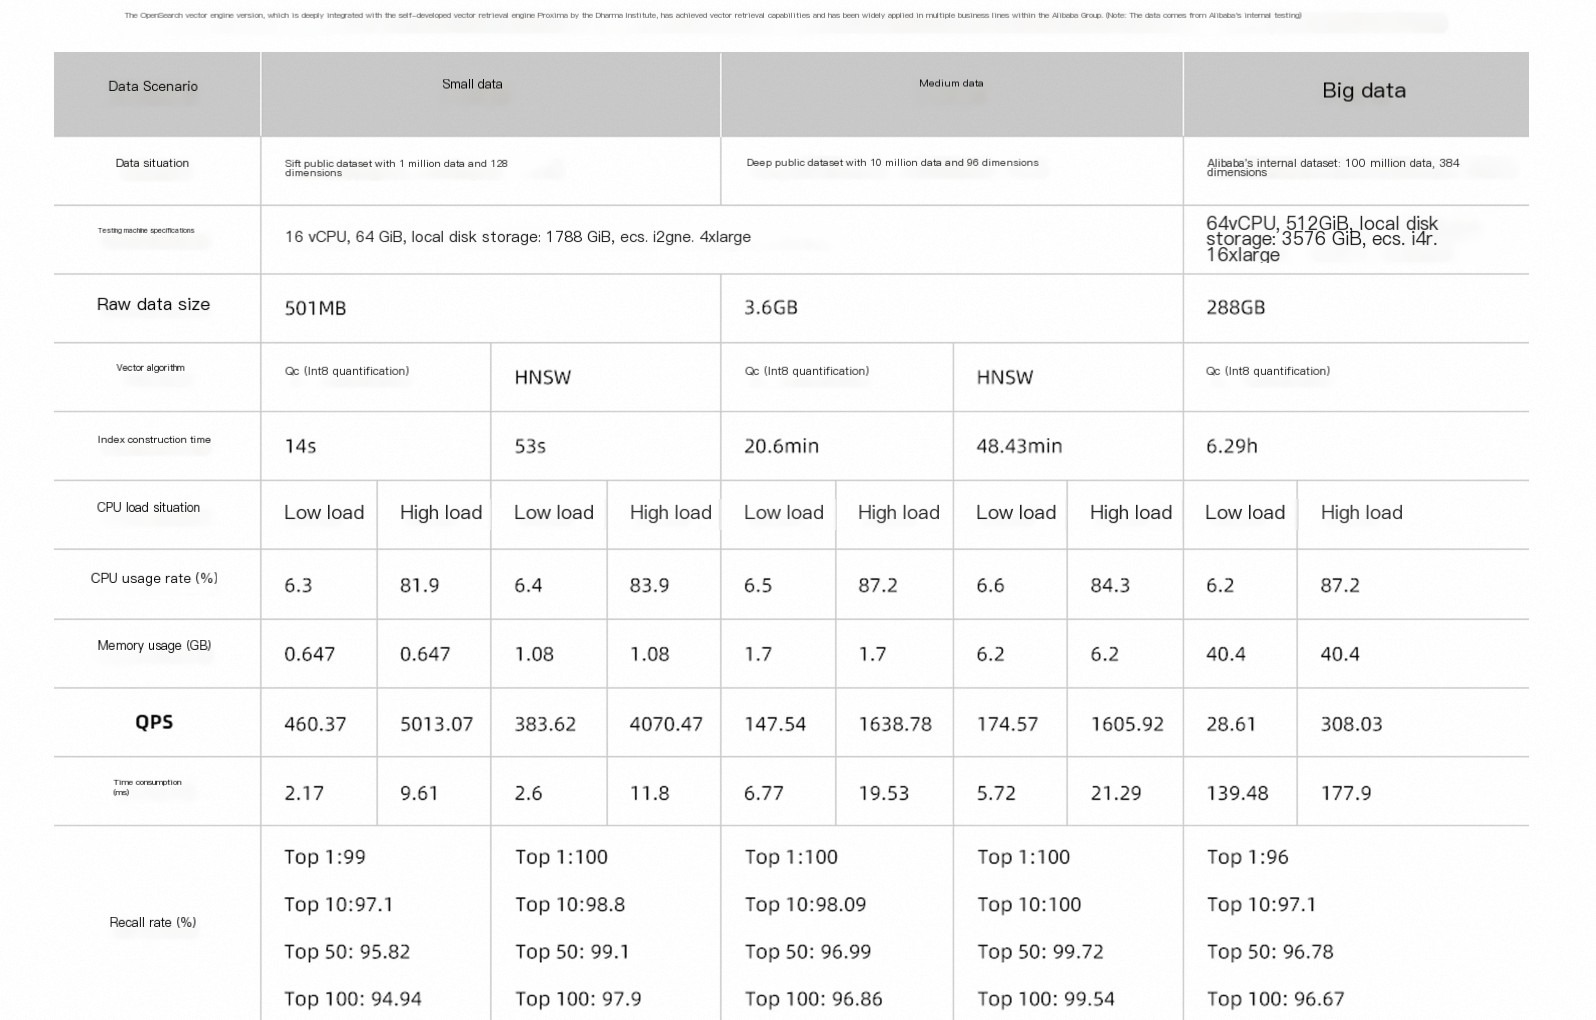
HNSW
Présentation
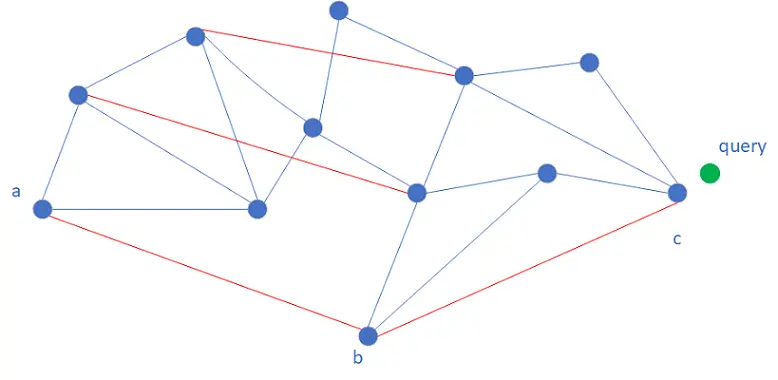
Hierarchical Navigable Small World (HNSW) est un algorithme de recherche vectorielle basé sur des graphes de proximité. Il nécessite la création d'un graphe de proximité et l'établissement de liens entre les vecteurs voisins. Les vecteurs et les arêtes constituent l'essentiel de l'indexation HNSW. Lors de la recherche, OpenSearch démarre la traversée depuis le vecteur d'entrée, calcule la distance entre le vecteur de requête et chaque vecteur adjacent du vecteur d'entrée, puis sélectionne le vecteur adjacent le plus proche comme prochain point de traversée. OpenSearch poursuit la traversée des vecteurs selon cette règle jusqu'à atteindre la convergence. La convergence signifie qu'OpenSearch a trouvé un vecteur adjacent au vecteur actuel qui est plus proche du vecteur de requête que tous les autres vecteurs adjacents déjà explorés.
Pour accélérer la convergence, HNSW construit une structure de graphe de proximité multicouche basée sur la logique des listes à saut (skip list). La recherche s'effectue de haut en bas. La logique de recherche est similaire pour chaque couche, à l'exception de la couche 0. Si OpenSearch atteint un vecteur de la couche K lors de la convergence, ce vecteur devient le vecteur d'entrée de la couche K-1, et OpenSearch continue la traversée de cette dernière. Par rapport à la couche K-1, la couche K contient des nœuds plus espacés, avec des distances plus grandes. Dans ce cas, OpenSearch traverse les vecteurs de la couche K avec un pas plus large et une vitesse d'itération plus élevée que dans la couche K-1.
Ajustement des paramètres :
Pour plus d'informations, consultez la section Configuration HNSW (Hierarchical Navigable Small World).
QGraph
Présentation
Quantized Graph (QGraph) est un algorithme amélioré basé sur HNSW, développé par OpenSearch. QGraph quantifie automatiquement les données brutes des utilisateurs lors de la construction de l'index, puis génère un index de graphe. Comparé à l'algorithme HNSW, QGraph réduit efficacement la taille de l'index et l'empreinte mémoire, pouvant diviser la taille de l'index par huit. De plus, grâce à l'optimisation des instructions CPU pour le calcul entier, les performances de QGraph sont multipliées par rapport à HNSW. Après quantification, la discrimination des vecteurs diminue, ce qui entraîne un taux de rappel inférieur à celui de HNSW. Dans les scénarios réels, il est possible d'augmenter le nombre de rappels pour atténuer cet impact.
QGraph prend en charge la quantification des données aux niveaux int4, int8 ou int16. Les différents niveaux de quantification ont des effets variés sur la consommation mémoire des index vectoriels, les performances des requêtes et le taux de rappel. En général, lorsque la largeur de bit entière diminue, la mémoire occupée par l'index vectoriel devient plus petite, les performances s'améliorent et le taux de rappel baisse. La quantification int16, en raison de problèmes liés au jeu d'instructions CPU sous-jacent, offre des performances et un taux de rappel presque identiques à ceux des données non quantifiées.
Ajustement des paramètres :
Configuration QGraph (Quantized Graph)
CAGRA
Présentation
CAGRA (CUDA ANN GRAph-based) est un algorithme de recherche vectorielle basé sur des graphes de proximité. CAGRA est optimisé pour les GPU NVIDIA et convient aux scénarios à forte concurrence avec des requêtes par lots.
Contrairement à HNSW, CAGRA construit un graphe de proximité à une seule couche pour le calcul parallèle. Lors de la recherche, l'algorithme maintient un ensemble ordonné de vecteurs candidats au fil des itérations. À chaque itération, l'algorithme sélectionne les K meilleurs vecteurs les plus appropriés de l'ensemble candidat comme points de départ de la recherche et tente de mettre à jour l'ensemble candidat avec les vecteurs adjacents. Ce processus se répète jusqu'à ce que tous les K meilleurs vecteurs de l'ensemble candidat aient été utilisés comme points de départ de recherche. L'algorithme est alors considéré comme convergé.
L'algorithme CAGRA est implémenté selon deux stratégies : single-CTA et multi-CTA. Single-CTA utilise un seul bloc de threads pour effectuer la recherche d'un seul vecteur, ce qui s'avère plus efficace lorsque la taille du lot est importante. Multi-CTA utilise plusieurs blocs de threads pour la recherche d'un seul vecteur, ce qui permet d'exploiter la capacité de calcul parallèle des GPU et d'obtenir un taux de rappel plus élevé lorsque la taille du lot est faible. Toutefois, le débit de multi-CTA est inférieur à celui de single-CTA lorsque la taille du lot est importante. La stratégie optimale est automatiquement sélectionnée en fonction de la charge de travail lors des appels réels.
Ajustement des paramètres :
Types de distance vectorielle
La recherche vectorielle consiste à calculer la similarité entre les vecteurs et à renvoyer les K premiers vecteurs en fonction de cette similarité. La similarité entre les vecteurs est obtenue en calculant la distance qui les sépare. En règle générale, plus le score est faible, plus la distance vectorielle est courte. Plus le score est élevé, plus la distance vectorielle est grande.
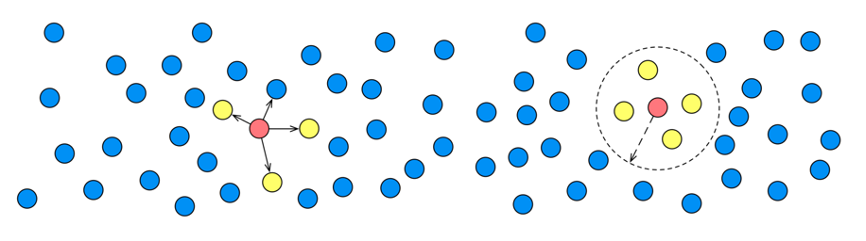
Différentes métriques de distance sont définies dans les espaces vectoriels pour calculer la distance entre les vecteurs. OpenSearch prend en charge les métriques suivantes : distance euclidienne au carré et produit scalaire.
Distance euclidienne au carré
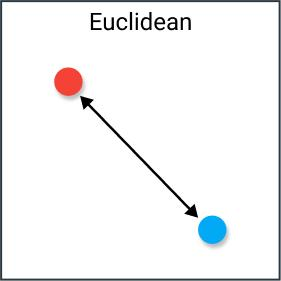
La distance euclidienne au carré représente la distance entre deux vecteurs dans un plan. Parmi les métriques de distance les plus courantes, elle s'obtient en calculant la racine carrée de la somme des carrés des différences de coordonnées entre deux vecteurs. Plus la distance euclidienne au carré est faible, plus la similarité vectorielle est élevée. La distance euclidienne au carré se calcule selon la formule suivante :
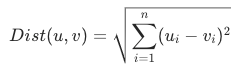
Produit scalaire
Le produit scalaire correspond au produit interne ou scalaire entre deux vecteurs. Plus le produit scalaire est élevé, plus la similarité vectorielle est forte. Il se calcule en multipliant les éléments correspondants des deux vecteurs et en additionnant les produits. Cette métrique de distance est couramment utilisée dans les scénarios de recommandation de recherche. En général, le calcul du produit scalaire dépend de la présence d'un modèle de produit scalaire dans l'algorithme. Le produit scalaire se calcule selon la formule suivante :
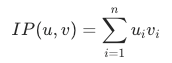
Comparaison des algorithmes de recherche vectorielle
Algorithme de recherche vectorielle | Avantage | Inconvénient | Scénario |
Clustering quantifié | Faible utilisation du CPU et de la mémoire. |
| L'algorithme de clustering quantifié convient aux scénarios nécessitant le traitement de centaines de millions d'enregistrements de données, lorsque la précision élevée des données et une faible latence de requête ne sont pas exigées. |
HNSW | Taux de rappel élevé et vitesse de requête rapide. | Forte utilisation du CPU et de la mémoire. | L'algorithme HNSW convient aux scénarios nécessitant le traitement de dizaines de millions d'enregistrements de données, lorsque la précision élevée des données et une faible latence de requête sont exigées. |
linéaire | Taux de rappel de 100 %. |
| L'algorithme linéaire convient aux scénarios nécessitant le traitement de dizaines de milliers d'enregistrements de données. |
QGraph | Faible utilisation du CPU et de la mémoire. Vitesse et performances élevées. | Taux de rappel inférieur à celui de HNSW. | L'algorithme QGraph convient aux scénarios nécessitant le traitement de milliards d'enregistrements de données. Une vitesse de requête et des performances élevées sont requises, mais une précision élevée des données ne l'est pas. |
CAGRA | Algorithme basé sur GPU. Performances plusieurs fois, voire des dizaines de fois, supérieures à celles des algorithmes basés sur CPU. | Coûts GPU élevés et rentabilité faible dans les scénarios à faible nombre de requêtes par seconde (QPS). | L'algorithme CAGRA convient aux scénarios nécessitant un QPS élevé et un temps de réponse faible. |