OpenSearch Vector Search Edition prend en charge plusieurs algorithmes d'indexation vectorielle et métriques de distance pour divers scénarios de recherche.
Présentation de la recherche vectorielle
Les données existent sous plusieurs modalités au-delà du texte, notamment les images, les vidéos et l'audio. Les données multimodales transmettent des détails que le texte ne peut pas exprimer, tels que la couleur, la forme, le mouvement, le son et les relations spatiales.
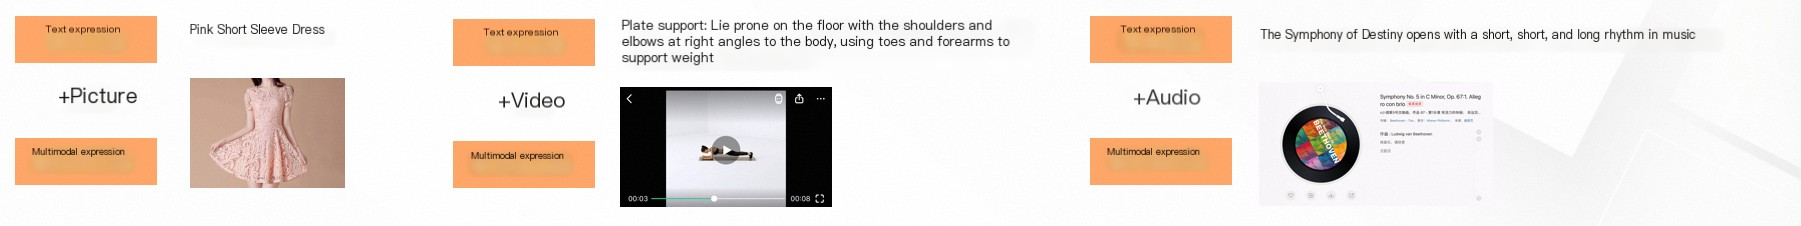
Les modalités d'information continuent de se diversifier dans tous les domaines.
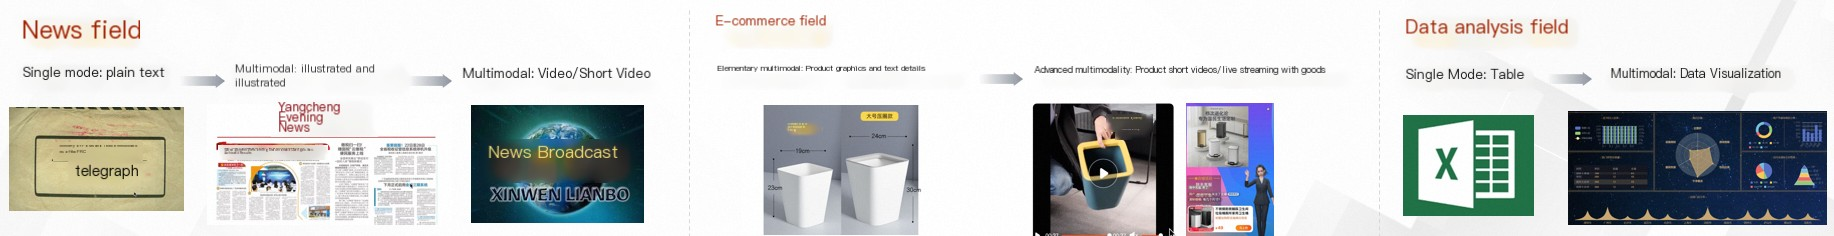
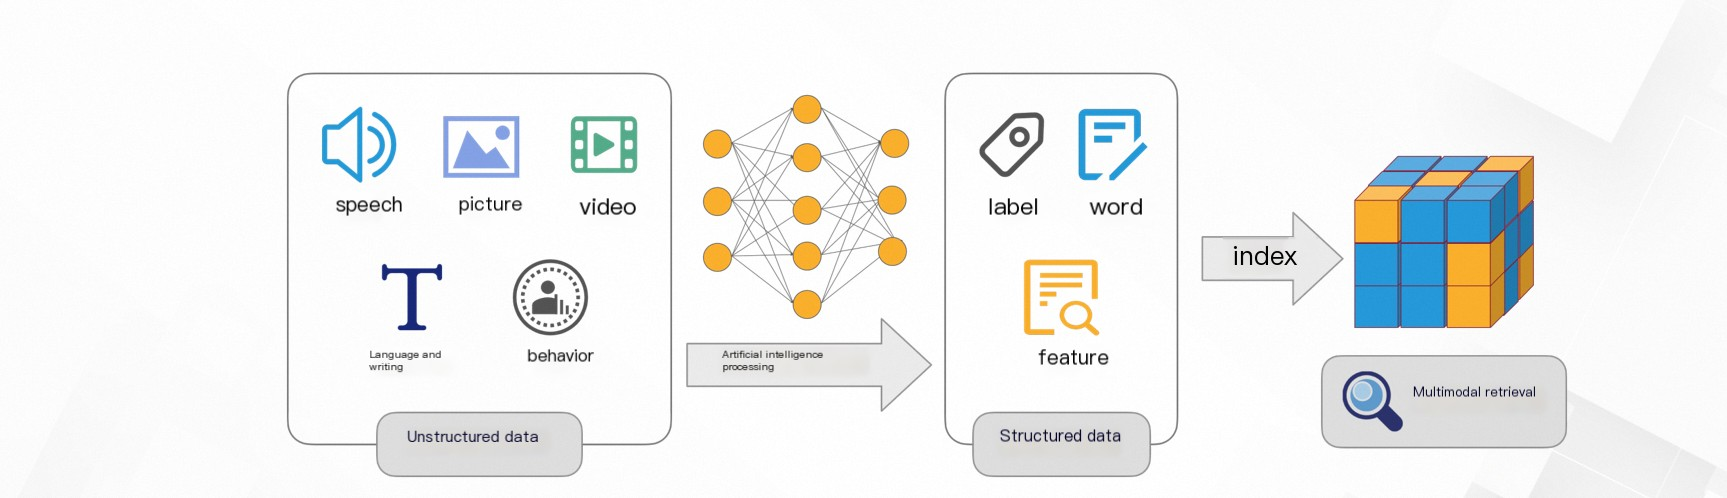
Dans les scénarios multimodaux, les informations sont classées en deux catégories : structurées et non structurées.
Les ordinateurs peinent à comprendre les données non structurées et les méthodes traditionnelles de tokenisation de texte ne suffisent pas aux exigences de recherche transversale. La recherche vectorielle résout ce problème.
Que sont les vecteurs et comment fonctionne la recherche vectorielle ?
Le système transforme les données non structurées du monde physique en vecteurs multidimensionnels représentant les entités et leurs relations.
Il calcule ensuite les distances entre les vecteurs : plus la distance est faible, plus la similarité est élevée. Le système renvoie alors les résultats les plus similaires.
Algorithmes
linear
L'algorithme linear calcule la distance entre le vecteur de requête et chaque vecteur de l'ensemble de données.
Scénario : Utilisez cet algorithme si vous avez besoin d'un taux de rappel de 100 %.
Inconvénients : Cet algorithme manque d'efficacité sur les grands ensembles de données en raison d'une consommation élevée de CPU et de mémoire.
Clustering
Quantized Clustering
Présentation :
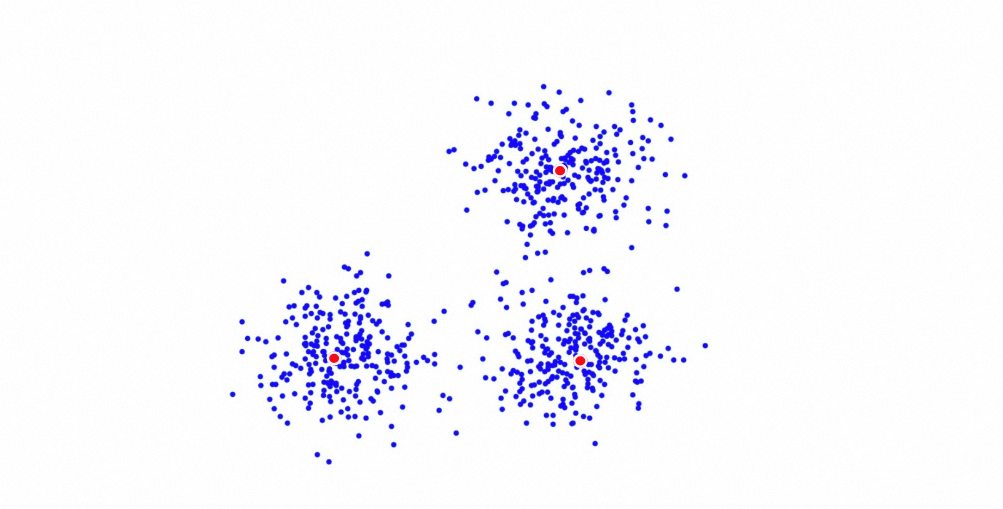
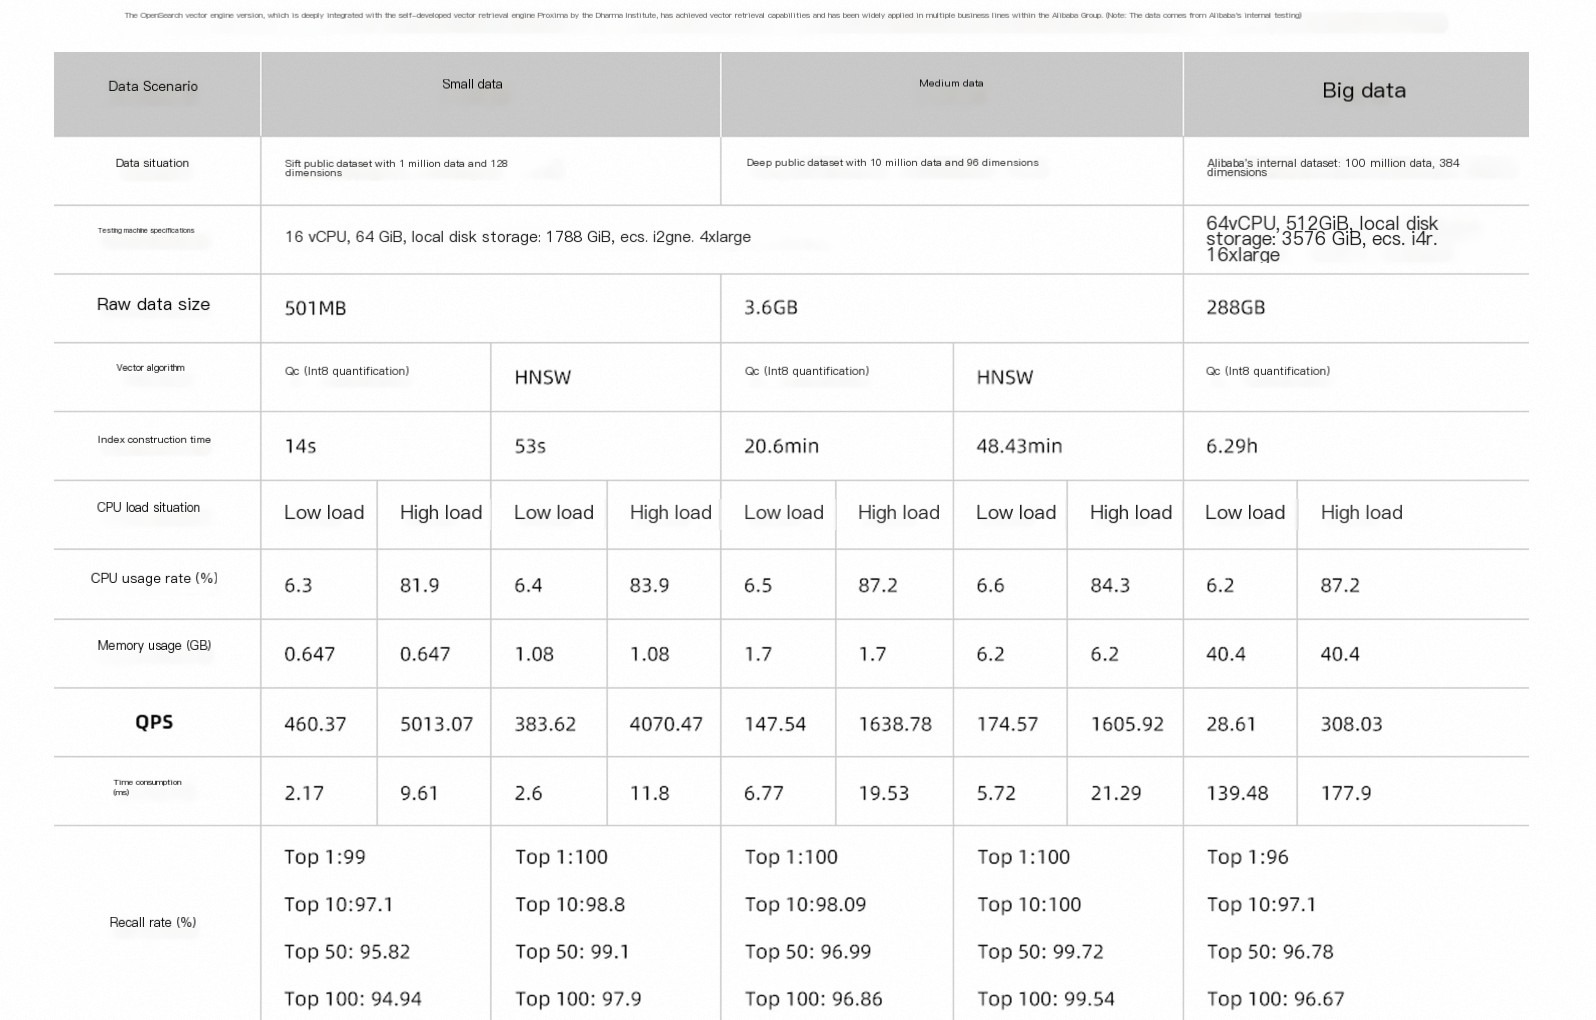
Quantized Clustering (QC) est un algorithme de recherche vectorielle développé par Alibaba, basé sur le clustering k-means. Il regroupe les vecteurs en n centroïdes et assigne chaque document à son centroïde le plus proche, formant ainsi n listes inversées. Lors de la recherche, la requête sélectionne les centroïdes les plus proches, parcourt leurs listes inversées et renvoie les k documents les plus proches.
QC prend en charge la quantification fp16 et int8 pour réduire la taille de l'index et améliorer les performances, au prix d'une légère réduction du taux de rappel.
QC convient aux scénarios de données en temps réel ou aux cas d'utilisation à faible latence accélérés par GPU.
Réglage des paramètres :
Comparaison des performances :
HNSW
Présentation :
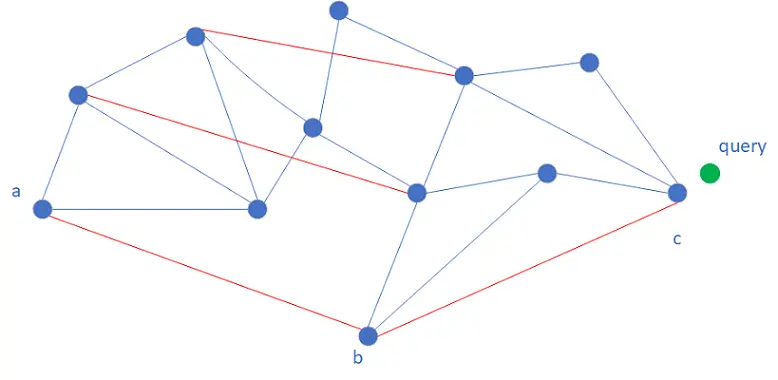
Hierarchical Navigable Small World (HNSW) est un algorithme de recherche vectorielle basé sur un graphe de proximité. Il construit un graphe reliant les vecteurs voisins par des arêtes. Lors de la recherche, le parcours commence à partir d'un nœud d'entrée, se dirige vers le voisin le plus proche à chaque étape et itère jusqu'à convergence, c'est-à-dire lorsque aucun voisin du nœud actuel n'est plus proche de la requête que la meilleure correspondance déjà trouvée.
Pour accélérer la convergence, HNSW utilise un graphe multicouche similaire à une liste à sauts. La recherche commence à la couche supérieure et descend. Lorsque le parcours converge vers un nœud de la couche k, ce nœud devient le point d'entrée pour la couche k-1. Les couches supérieures contiennent moins de nœuds, ce qui permet des sauts plus grands et une itération plus rapide.
Réglage des paramètres :
QGraph
Présentation :
Quantized Graph (QGraph) est un algorithme amélioré développé par OpenSearch, basé sur HNSW. Il quantifie les données brutes avant de construire l'index de graphe, réduisant la taille de l'index jusqu'à un huitième de celle de HNSW. Grâce à l'optimisation des instructions CPU pour les calculs entiers, il offre des performances plusieurs fois supérieures. Ce gain s'accompagne d'un taux de rappel plus faible dû à une distinctivité vectorielle réduite, mais il est possible d'atténuer ce phénomène en récupérant davantage de résultats.
QGraph prend en charge la quantification int4, int8 et int16. Des largeurs de bits plus petites réduisent l'utilisation de la mémoire et augmentent les performances, mais diminuent le taux de rappel. La quantification int16 offre des performances et un taux de rappel quasi identiques à ceux des données non quantifiées.
Réglage des paramètres :
CAGRA
Présentation :
CUDA ANN GRAph-based (CAGRA) est un algorithme de graphe de proximité optimisé pour les GPU NVIDIA, conçu pour les scénarios de recherche par lots et à haute concurrence.
Contrairement à HNSW, CAGRA construit un graphe de proximité à une seule couche, optimisé pour le calcul parallèle. Lors d'une requête, il sélectionne de manière itérative les nœuds top-k d'un ensemble de candidats comme points de départ et met à jour l'ensemble avec leurs voisins jusqu'à convergence.
CAGRA prend en charge deux politiques d'exécution : single-CTA associe une requête à un bloc de threads pour un débit élevé avec de grands lots, tandis que multi-CTA utilise plusieurs blocs de threads par requête pour un meilleur rappel avec de petits lots, au détriment du débit pour les grands lots. Le système sélectionne automatiquement la politique optimale au moment de l'exécution.
Réglage des paramètres :
DiskANN
Présentation :
DiskANN est un algorithme de recherche de voisins approximatifs les plus proches (ANN) basé sur le disque, destiné aux ensembles de données dépassant la mémoire disponible. Il utilise l'algorithme de graphe Vamana pour maintenir une indexation et une recherche performantes tout en stockant les données sur le disque.
L'algorithme DiskANN est pris en charge uniquement lorsque la famille de nœuds de données est SSD.
Réglage des paramètres :
CagraHnsw
Présentation :
CagraHnsw est un algorithme de recherche vectorielle développé par OpenSearch qui combine CAGRA et HNSW pour une construction rapide d'index sur des ensembles de données massifs.
CagraHnsw utilise des GPU pour construire les index (comme CAGRA) puis les convertit au format compatible HNSW pour la recherche basée sur le CPU. Cette approche combine la rapidité de construction d'index par GPU avec le coût réduit des requêtes CPU, ce qui la rend plus rentable que CAGRA pour les charges de travail sans haute concurrence soutenue.
Types de distance vectorielle
La recherche vectorielle calcule les distances entre les vecteurs et renvoie les k résultats les plus similaires. Plus la distance est faible, plus la similarité est élevée.
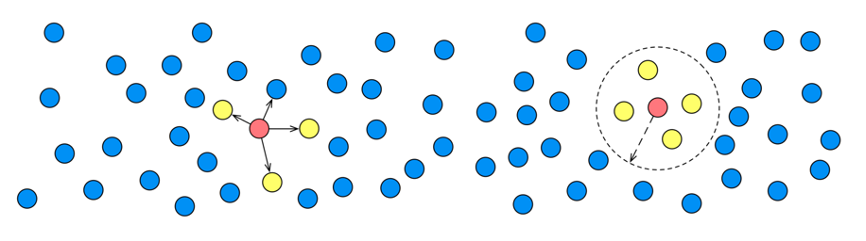
OpenSearch Vector Search Edition prend en charge trois métriques de distance : la distance euclidienne au carré, le produit scalaire et la distance cosinus.
Distance euclidienne au carré (SquareEuclidean)
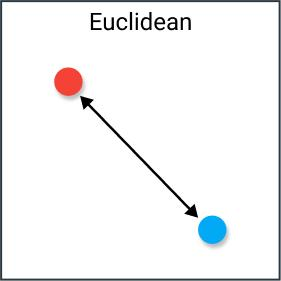
La distance euclidienne mesure la distance en ligne droite entre deux vecteurs en calculant la racine carrée de la somme des carrés des différences de coordonnées. Plus la valeur est faible, plus la similarité est élevée.
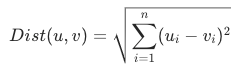
Distance de produit scalaire (InnerProduct)
Le produit scalaire multiplie les éléments correspondants de deux vecteurs et additionne les résultats. Plus la valeur est élevée, plus la similarité est grande. Cette métrique est courante dans les scénarios de recherche et de recommandation où le modèle sous-jacent utilise un scoring par produit scalaire.
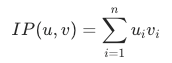
Distance cosinus
La distance cosinus mesure le cosinus de l'angle entre deux vecteurs. Les valeurs vont de -1 à 1 : 1 indique une direction identique (similarité maximale), 0 indique la perpendicularité et -1 indique des directions opposées. Cette métrique est couramment utilisée pour la recherche de similarité textuelle.
