Les API Model Studio limitent le volume de requêtes, l'utilisation des tokens et le taux de croissance. Appliquez ces stratégies pour maximiser le débit et maintenir la disponibilité.
Les API Model Studio restreignent les requêtes, l'utilisation des tokens et le taux de croissance au fil du temps : c'est la limitation de débit. Les grands modèles de langage présentent une latence élevée et sont contraints sur deux dimensions (nombre de requêtes et volume de tokens). Les simples stratégies de « nouvelle tentative en cas d'erreur » échouent ici ; un contrôle de trafic dédié est indispensable.
Trois types de solutions sont disponibles, classés par coût de mise en œuvre croissant :
- Solutions de configuration de la plateforme (modifications minimes du code) : Mise en file d'attente côté serveur, PTU et Batch API.
- Stratégies de contrôle du trafic côté client (modifications du code client) : Quatre stratégies de complexité technique croissante, allant de la nouvelle tentative de base au contrôle de congestion adaptatif.
- Solutions de repli architecturales (modifications de l'architecture système) : Repli de modèle et Lissage des pics de charge via files d'attente de messages (MQ).
Si vous dépannez actuellement une erreur 429, accédez à la section Diagnostic des erreurs et recommandations de stratégies pour en identifier la cause. Pour les erreurs liées aux pics de trafic, essayez d'abord la mise en file d'attente côté serveur : elle ne nécessite qu'un seul en-tête de requête.
Mécanisme de limitation de débit de la plateforme
La plateforme applique des limites de débit à chaque modèle indépendamment, au niveau du compte racine. Après le déclenchement d'une limite, le service reprend généralement son fonctionnement dans un délai d'une minute. Pour connaître les conditions de limitation et l'utilisation actuelle par modèle, consultez les rubriques Limitation de débit et Surveillance des modèles. Trois types de règles s'appliquent :
- Limites de quota à la minute (RPM / TPM) : Nombre maximal de requêtes par minute (RPM) et utilisation maximale des tokens par minute (TPM).
- Limites de fréquence instantanée (RPS / TPS) : Nombre maximal de requêtes par seconde (RPS) et utilisation maximale des tokens par seconde (TPS). Des appels API denses ou une consommation élevée de tokens en une seule seconde peuvent déclencher la limitation.
- Limites du taux de croissance (Traffic Burst) : Une augmentation soudaine du volume de requêtes ou de l'utilisation des tokens déclenche la limitation. Le seuil s'ajuste dynamiquement. Augmentez progressivement le volume de requêtes pour éviter d'atteindre cette limite.
Les sections suivantes détaillent les solutions à trois niveaux : configuration de la plateforme, contrôle du trafic côté client et repli architectural.
Diagnostic des erreurs et recommandations de stratégies
Un même code d'erreur peut provenir de différentes dimensions de limitation. Une concurrence élevée peut également saturer le serveur et provoquer des délais d'attente. La stratégie de contrôle de congestion adaptatif permet d'atténuer ce phénomène.
Code d'erreur (DashScope / OpenAI) | Dimension déclenchante | Diagnostic fonctionnel | Stratégie recommandée |
|---|---|---|---|
Throttling.RateQuota / limit_requests | Taux de requêtes dépassé | Erreurs intermittentes. Le taux de réussite diminue avec le temps. | Seau à jetons : Contrôlez le quota de requêtes par unité de temps. |
Taux de requêtes dépassé | Erreurs concentrées au démarrage ou lors de pics de concurrence. | Sémaphore de concurrence ou limiteur de débit lissant : Augmentez l'intervalle entre les requêtes. | |
Throttling.AllocationQuota / insufficient_quota | Utilisation des tokens dépassée | Erreurs intermittentes lors du traitement de textes longs. | Double seau à jetons : Limitez simultanément les quotas RPM et TPM. |
Utilisation des tokens dépassée | La consommation instantanée de tokens est trop élevée lors du traitement simultané de textes longs. | ||
Throttling.BurstRate / limit_burst_rate | Taux de croissance du trafic dépassé | Volume important et soudain de requêtes après le démarrage ou la sortie d'un état inactif. | Essayez d'abord la mise en file d'attente côté serveur. Vous pouvez aussi utiliser un seau à jetons avec une valeur initiale faible, telle que |
Solutions de configuration de la plateforme
Ces solutions reposent sur les capacités de la plateforme et nécessitent peu ou pas de modifications du code client.
Mise en file d'attente côté serveur (recommandé)
Pour la limitation liée aux pics de trafic, Model Studio accepte un temps d'attente maximal dans l'en-tête de la requête. Le serveur met alors la requête en file d'attente et la retente pendant cette durée, jusqu'à ce que le traitement commence ou que le délai expire. Cela améliore considérablement les taux de réussite lors des pics de trafic par rapport à une réponse 429 immédiate.
RemarqueCette fonctionnalité s'applique uniquement à la limitation du taux de croissance et des pics de trafic (Throttling.BurstRate). Elle ne concerne pas les limitations de quota absolu (RPM/TPM).
Ajoutez le champ X-DashScope-Wait-Timeout à l'en-tête de la requête :
| Champ d'en-tête | Exemple | Description |
|---|---|---|
X-DashScope-Wait-Timeout | 30 | Temps d'attente maximal en file d'attente pour les requêtes en rafale, en secondes.
|
Après avoir activé la mise en file d'attente, ajustez le délai d'expiration du client pour tenir compte du temps d'attente ajouté :
- Requêtes non streaming (stream: false) : Délai d'expiration = délai de base initial + valeur Wait-Timeout.
- Requêtes streaming (stream: true) : Délai d'expiration > valeur Wait-Timeout. Le chronométrage des requêtes streaming démarre après le premier fragment ; le délai d'attente de la réponse initiale doit donc simplement excéder le temps de mise en file d'attente.
Exemple : Si le délai de base initial est de 120 secondes et que Wait-Timeout est défini sur 30 secondes, fixez le délai d'expiration pour une requête non streaming à 150 secondes.
Exemple de code
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    timeout=150.0,  # Original timeout 120s + queuing wait 30s
)

response = client.chat.completions.create(
    model="qwen-plus",
    messages=[{"role": "user", "content": "Hello"}],
    extra_headers={
        "X-DashScope-Wait-Timeout": "30"  # Maximum queuing wait: 30 seconds
    }
)
print(response.choices[0].message.content)
curl -X POST "https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -H "X-DashScope-Wait-Timeout: 30" \
  -d '{
    "model": "qwen-plus",
    "messages": [{"role": "user", "content": "Hello"}]
  }'
Unité de débit provisionnée (PTU)
Le service PTU fournit une puissance de calcul dédiée et réservée. Il évite la contention dans le pool de ressources public et constitue la solution privilégiée pour les exigences temps réel à haut débit.
Utilisez les PTU lorsque votre activité impose des exigences de débit déterministes (comme des engagements SLA) ou lorsque vous souhaitez un débit élevé et stable sans contrôle du trafic côté client.
Les PTU sont des ressources réservées facturées en continu, même si elles ne sont pas pleinement utilisées. Évaluez les spécifications requises en fonction de la charge réelle de pointe pour éviter le gaspillage.
Traitement par lots asynchrone (Batch API)
Pour les tâches sans exigences strictes de temps réel (nettoyage de données, analyses par lots), utilisez la Batch API afin de les soumettre pour un traitement différé. Ces tâches s'exécutent pendant les heures creuses, renvoient les résultats de manière asynchrone et ne sont pas soumises aux limites de débit en ligne.
Cette approche convient aux tâches hors ligne tolérant des délais de réponse allant de quelques heures à plusieurs jours : annotation de données, analyse de journaux, résumés par lots. Les coûts de la Batch API sont généralement inférieurs à ceux des appels API en temps réel.
Le délai de retour n'est pas garanti. Cette méthode ne convient pas aux services nécessitant des réponses immédiates. Récupérez les résultats par interrogation (polling) ou par rappel (callback) après la soumission.
Stratégies de contrôle du trafic côté client
Lorsque les solutions de la plateforme (telles que la mise en file d'attente côté serveur) ne suffisent pas, ajoutez un contrôle du trafic côté client. Le principe fondamental consiste à répartir uniformément les requêtes dans une fenêtre temporelle pour éviter les rafales. Après le démarrage du système ou une longue période d'inactivité, augmentez progressivement la concurrence.
Quatre stratégies sont présentées par ordre de complexité croissante. Chacune inclut la précédente et y ajoute des fonctionnalités :
- La nouvelle tentative de base offre uniquement une défense passive.
- La limitation du taux de requêtes ajoute une mise en file d'attente active.
- La mise en forme du trafic introduit en outre un contrôle au niveau des tokens et un envoi lissé.
- Le contrôle de congestion adaptatif ajuste dynamiquement le taux d'envoi en fonction des retours en temps réel.
Choisissez la stratégie la moins coûteuse qui répond à vos besoins.
Comparaison des performances de débit de chaque stratégie
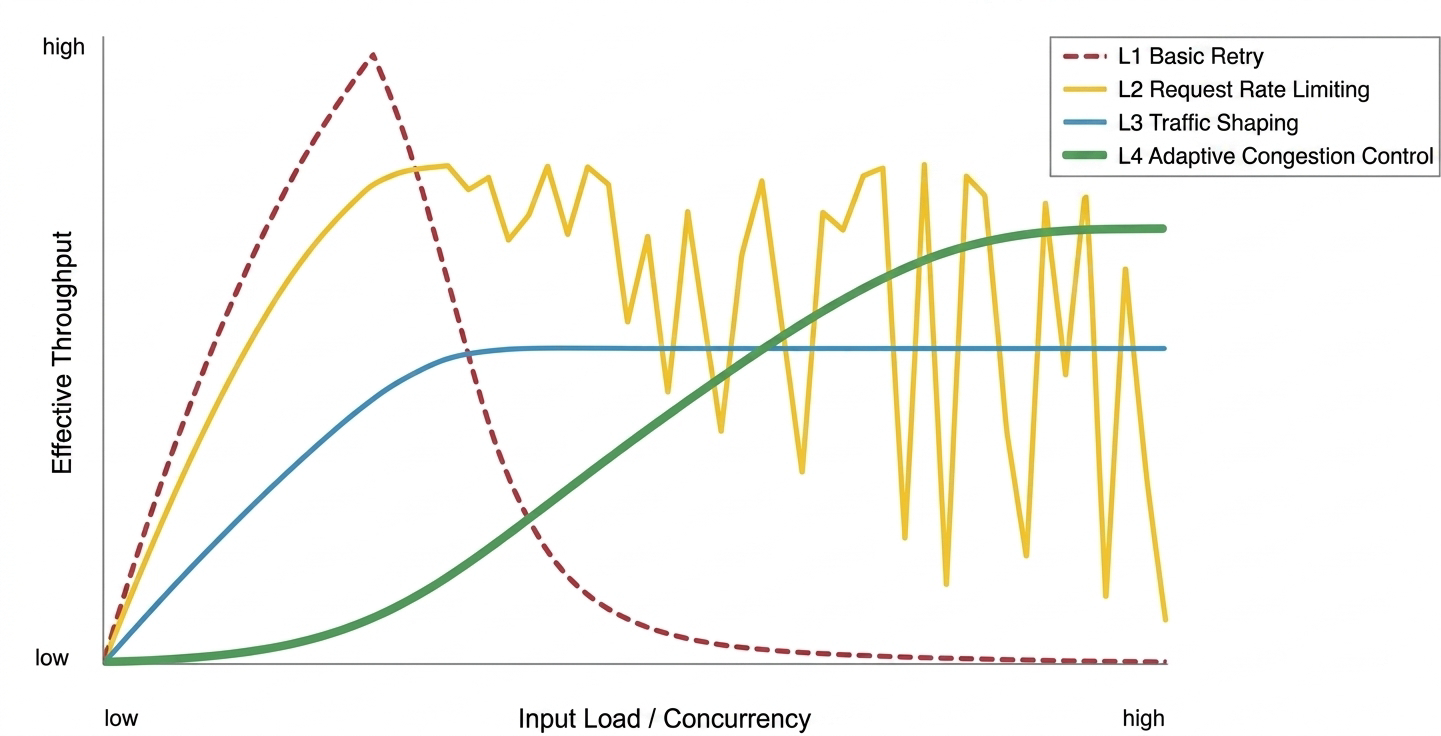
Comparaison du débit sous différentes charges :
- Stratégie de nouvelle tentative de base : Efficace sous faible charge. Sujette à l'effondrement congestif sous forte concurrence, entraînant une chute brutale du débit.
- Stratégie de limitation du taux de requêtes : Protection robuste contre l'effondrement. Cependant, sous des charges mixtes avec des textes longs, le débit présente des fluctuations en dents de scie en raison de l'absence de contrôle des tokens.
- Stratégie de mise en forme du trafic : Haute stabilité. Permet d'obtenir un flux régulier en sacrifiant une partie du débit de pointe.
- Stratégie de contrôle de congestion adaptatif : Capable de converger dynamiquement vers un débit élevé et stable sous forte charge, mais implique une surcharge liée à la phase de test au démarrage.
Stratégie de nouvelle tentative de base
Conçue pour les tests personnels, les scripts locaux et les tâches d'arrière-plan peu fréquentes. Aucune limitation de débit n'est appliquée aux requêtes sortantes. Déclenche uniquement une nouvelle tentative avec backoff exponentiel et gigue aléatoire en cas d'erreurs 429 ou 5xx.
Aucun contrôle proactif du trafic n'est exercé. En cas de concurrence multithread, cette approche déclenche facilement la limitation de débit et provoque l'accumulation de requêtes en attente.
Exemple de code
import openai
from openai import OpenAI
from tenacity import (
    retry,
    stop_after_attempt,
    wait_random_exponential,
    retry_if_exception_type
)

RETRYABLE_ERRORS = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APIConnectionError,
)

@retry(
    wait=wait_random_exponential(min=1, max=60),
    stop=stop_after_attempt(6),
    retry=retry_if_exception_type(RETRYABLE_ERRORS)
)
def chat_with_retry(client, model, messages, max_tokens):
    return client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=messages
    )

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key="YOUR_DASHSCOPE_API_KEY"
)

try:
    response = chat_with_retry(
        client=client,
        model="qwen-plus",
        messages=[{"role": "user", "content": "What is exponential backoff retry?"}],
        max_tokens=1024
    )
    print(response.choices[0].message.content)
except Exception as e:
    print(f"Request failed: {e}")
import time
import random
import openai
from openai import OpenAI

RETRYABLE_ERRORS = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APIConnectionError,
)

def chat_with_retry(client, model, messages, max_tokens):
    attempt = 0
    max_retries = 5
    base_delay = 1
    max_delay = 60

    while attempt <= max_retries:
        try:
            return client.chat.completions.create(
                model=model,
                max_tokens=max_tokens,
                messages=messages
            )
        except RETRYABLE_ERRORS as e:
            attempt += 1
            if attempt > max_retries:
                raise e
            backoff = min(max_delay, base_delay * (2 ** (attempt - 1)))
            sleep_time = backoff + random.uniform(0, 1)
            print(f"Triggered {type(e).__name__}, retrying after {sleep_time:.2f}s...")
            time.sleep(sleep_time)

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key="YOUR_DASHSCOPE_API_KEY"
)

try:
    response = chat_with_retry(
        client=client,
        model="qwen-plus",
        messages=[{"role": "user", "content": "What is exponential backoff retry?"}],
        max_tokens=1024
    )
    print(response.choices[0].message.content)
except Exception as e:
    print(f"Request failed: {e}")
Le code utilise un backoff exponentiel plutôt qu'une nouvelle tentative à intervalle fixe. Une nouvelle tentative à intervalle fixe entraîne le renvoi simultané de toutes les requêtes ayant échoué, ce qui déclenche à nouveau la limitation de débit. Le backoff exponentiel avec gigue aléatoire étale les tentatives :
- Le temps d'attente double progressivement : Par exemple,
1s, 2s, 4s.... Cela évite les requêtes répétées sur une courte période. - Ajout d'une gigue aléatoire : Une valeur aléatoire (telle que
2s +/- 0.5s) répartit le trafic des nouvelles tentatives, empêchant ainsi un afflux secondaire (effet de troupeau).
Le système récupère progressivement au lieu de rester bloqué dans une boucle « échec — nouvelle tentative simultanée — nouvel échec ».
Stratégie de limitation du taux de requêtes
Les nouvelles tentatives passives seules ne suffisent pas pour gérer le trafic réel. Des tentatives fréquentes augmentent la latence. Cette stratégie introduit un contrôle actif du trafic : vérifiez et régulez les requêtes avant leur envoi, organisant ainsi un trafic désordonné en une file d'attente respectant la limite RPM. Un lissage actif ajoute un léger délai de mise en file d'attente prévisible, bien inférieur au coût d'une boucle « erreur — attente — nouvelle tentative ». Un faible coût connu vaut mieux qu'un coût élevé inconnu.
Idéale pour les chatbots et autres services légers de type requête-réponse sensibles au délai du premier token.
La mise en file d'attente active côté client utilise deux niveaux de contrôle :
- Seau à jetons RPM : Limite le nombre total de requêtes par minute. La capacité du seau correspond au quota RPM ; les jetons se rechargent à un taux constant. Prend en charge l'emprunt : si les jetons sont insuffisants, une requête emprunte sur le quota futur, en respectant strictement l'ordre FIFO.
- Sémaphore de concurrence : Limite les requêtes simultanées pour empêcher une concurrence instantanée élevée de déclencher les limites RPS.
Exécutez ces deux niveaux dans un ordre strict : acquérir d'abord le jeton RPM, puis acquérir le sémaphore. Les emplacements de concurrence sont rares ; allouez-les uniquement aux requêtes prêtes à s'exécuter. Inverser l'ordre provoque un blocage en tête de file sous forte charge : les requêtes occupent des emplacements mais n'ont pas de jetons, tous les emplacements se remplissent et rien n'est envoyé. Principe : ne détenez pas une ressource rare pendant l'attente.
Le code ci-dessous initialise le seau à jetons à pleine capacité (initial_tokens=rpm_limit), ce qui convient aux services en ligne devant traiter des requêtes immédiatement au démarrage. Si un seau plein déclenche la limitation de débit, réduisez la valeur initiale (par exemple, initial_tokens=0 pour un « démarrage à seau vide ») afin d'augmenter la charge plus progressivement.
Cette stratégie ne suit pas l'utilisation des tokens. Les tâches impliquant des textes longs peuvent tout de même épuiser le quota TPM.
Exemple de code
import time

class TokenBucket:
    """
    Token bucket implementation to control requests per minute (RPM).
    Supports a debt mechanism to ensure first-in, first-out (FIFO) order under high concurrency.
    """
    def __init__(self, quota_per_minute: float, initial_tokens: float = 0.0):
        self.capacity = quota_per_minute
        self.tokens = initial_tokens
        self.refill_rate = quota_per_minute / 60.0
        self.last_refill = time.monotonic()

    def reserve(self, cost: float = 1.0) -> float:
        """
        Acquires a token.
        If tokens are insufficient, returns the number of seconds to wait (supports debt).
        """
        self._refill()

        # 1. Sufficient tokens: Deduct directly
        if self.tokens >= cost:
            self.tokens -= cost
            return 0.0

        # 2. Insufficient tokens: Calculate wait time and incur debt
        # "Reserves" future tokens for the current request to ensure FIFO order
        deficit = cost - self.tokens
        wait_seconds = deficit / self.refill_rate
        self.tokens -= cost
        return wait_seconds

    def _refill(self):
        """Refills tokens based on elapsed time."""
        now = time.monotonic()
        elapsed = now - self.last_refill
        if elapsed > 0:
            self.tokens = min(self.capacity, self.tokens + elapsed * self.refill_rate)
            self.last_refill = now
import asyncio
import openai
from openai import AsyncOpenAI
from tenacity import retry, wait_random_exponential, stop_after_attempt, retry_if_exception_type

class RateLimitedClient:
    def __init__(
        self,
        api_key: str,
        base_url: str = "https://dashscope.aliyuncs.com/compatible-mode/v1",
        rpm_limit: float = 600.0,
        max_concurrency: int = 20
    ):
        self.client = AsyncOpenAI(api_key=api_key, base_url=base_url)
        # Component 1: RPM token bucket (controls total volume)
        self.rpm_bucket = TokenBucket(
            quota_per_minute=rpm_limit,
            initial_tokens=rpm_limit  # Start with a full bucket, suitable for lightweight online services
        )
        # Component 2: Concurrency semaphore (controls instantaneous concurrency)
        self.semaphore = asyncio.Semaphore(max_concurrency)

    async def _execute_request(self, model, messages, max_tokens):
        """Executes a single request, passing through RPM check and concurrency limit in order."""
        # 1. RPM check (acquire token first)
        wait_seconds = self.rpm_bucket.reserve(1.0)
        if wait_seconds > 0:
            await asyncio.sleep(wait_seconds)
        # 2. Concurrency check (acquire semaphore next)
        async with self.semaphore:
            # 3. Make the API call
            return await self.client.chat.completions.create(
                model=model,
                messages=messages,
                max_tokens=max_tokens
            )

    @retry(
        wait=wait_random_exponential(min=1, max=60),
        stop=stop_after_attempt(5),
        retry=retry_if_exception_type((
            openai.RateLimitError,
            openai.InternalServerError,
            openai.APIConnectionError
        ))
    )
    async def chat_with_limit(self, model, messages, max_tokens=1024):
        # Design consideration: Why do retries also need to re-acquire a token?
        # Ans: For safety. Without re-acquisition, the traffic pulse from retries
        # could instantly exceed the RPM limit.
        return await self._execute_request(model, messages, max_tokens)
Stratégie de mise en forme du trafic
Dans les scénarios par lots nécessitant un débit élevé et stable (ingestion RAG en temps réel, analyse massive de documents longs), la limitation du taux de requêtes présente un angle mort TPM. La mise en forme du trafic ajoute une double conscience des ressources (RPM & TPM) ainsi qu'un mécanisme de lissage convertissant un trafic irrégulier en un flux régulier.
Améliorations par rapport à la limitation du taux de requêtes :
- Double contrôle des ressources (RPM & TPM) : Maintient des seaux à jetons pour le RPM et le TPM. Toutes les requêtes doivent passer les vérifications de quota pour les deux dimensions avant d'être envoyées.
- Pré-déduction pour l'entrée, règlement différé pour la sortie : La longueur de la sortie est inconnue avant la requête. Le seau TPM pré-déduit les tokens d'entrée lors de l'envoi et règle les tokens de sortie réels après l'achèvement. Même si le solde devient négatif, les requêtes suivantes attendent que le compteur redevienne positif, ce qui lisse naturellement le flux.
- Montée en charge continue : Lors d'un démarrage à froid, le taux d'émission des jetons augmente linéairement avec le temps, éliminant le risque de rafales initiales.
- Limiteur de débit lissant (Pacing) : Lisse le taux d'envoi en imposant un intervalle minimal entre les requêtes (pacing), réduisant ainsi le risque de déclencher les limites de débit.
Alternative : Si un léger délai de mise en file d'attente au démarrage est acceptable, réutilisez le seau à jetons standard (définissez initial_tokens=0) pour un démarrage sûr avec une complexité réduite. Le seau à jetons Python présenté ici sert d'illustration. En production, utilisez des bibliothèques de limitation de débit éprouvées telles que SmoothRateLimiter de Guava en Java.
Dans l'exemple de code, l'attente de lissage est placée à l'intérieur du verrou de concurrence. Plusieurs requêtes pourraient entrer en compétition pour le sémaphore simultanément après la fin de leur attente, regroupant à nouveau le trafic en sortie. Placer le lissage à l'intérieur du verrou réduit légèrement l'efficacité de la concurrence, mais garantit des intervalles d'envoi précis.
Le pipeline complet de mise en forme du trafic est le suivant : Estimation des tokens d'entrée → Double admission (RPM & TPM) → Verrou de concurrence → Mise en forme du trafic → Envoi → Règlement des tokens de sortie.
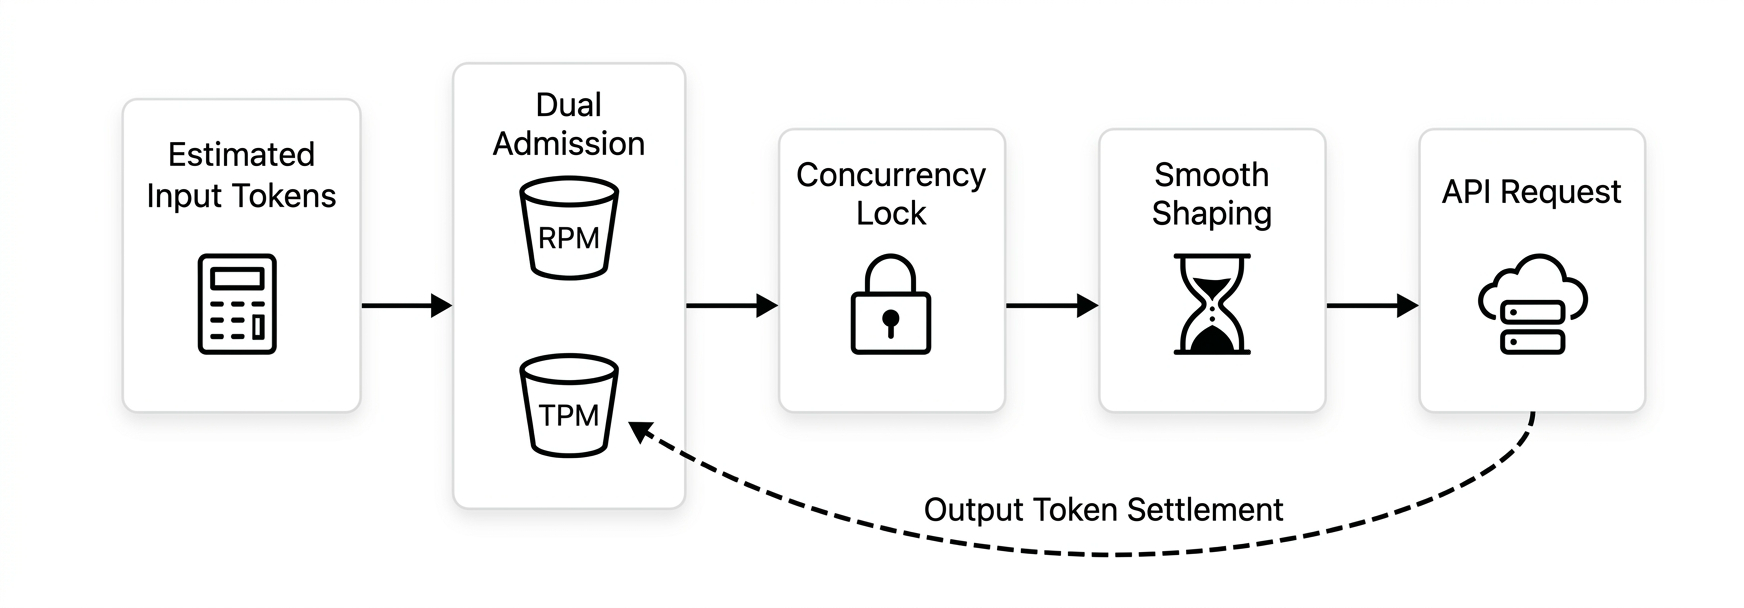
Ce lissage conservateur sacrifie une partie de la concurrence de pointe. Il ne convient pas aux services exigeant une latence extrêmement faible.
Exemple de code
import time

class TokenBucket:
    """Advanced token bucket that supports a continuous warm-up mechanism."""
    def __init__(self, quota_per_minute: float, warmup_seconds: float = 0.0):
        self.capacity = quota_per_minute
        self.tokens = 0.0
        self.target_refill_rate = quota_per_minute / 60.0
        self.warmup_seconds = warmup_seconds
        self.start_time = time.monotonic()
        self.last_update_time = self.start_time
        self.cumulative_generated = 0.0

    def _get_cumulative_tokens(self, t: float) -> float:
        if t <= 0:
            return 0.0
        R = self.target_refill_rate
        T = self.warmup_seconds
        if T <= 0:
            return R * t
        if t <= T:
            return (R / (2 * T)) * (t ** 2)
        else:
            warmup_total = (R * T) / 2.0
            return warmup_total + R * (t - T)

    def _get_time_for_cumulative_tokens(self, target_cumulative: float) -> float:
        if target_cumulative <= 0:
            return 0.0
        R = self.target_refill_rate
        T = self.warmup_seconds
        if T <= 0:
            return target_cumulative / R
        warmup_total = (R * T) / 2.0
        if target_cumulative <= warmup_total:
            return ((2 * T * target_cumulative) / R) ** 0.5
        else:
            return (target_cumulative - warmup_total) / R + T

    def reserve(self, cost: float = 1.0) -> float:
        now = time.monotonic()
        relative_now = now - self.start_time
        current_cumulative = self._get_cumulative_tokens(relative_now)
        new_tokens = current_cumulative - self.cumulative_generated
        self.tokens = min(self.capacity, self.tokens + new_tokens)
        self.cumulative_generated = current_cumulative
        self.last_update_time = now
        if self.tokens >= cost:
            self.tokens -= cost
            return 0.0
        deficit = cost - self.tokens
        self.tokens -= cost
        target_cumulative = self.cumulative_generated + deficit
        target_time = self._get_time_for_cumulative_tokens(target_cumulative)
        wait_seconds = target_time - relative_now
        return max(0.0, wait_seconds)

    def adjust(self, amount: float):
        self.tokens = min(self.capacity, self.tokens + amount)
import time

class SmoothRateLimiter:
    def __init__(self, rate_per_minute: float):
        self._min_interval = 60.0 / rate_per_minute
        self._last_operation = time.monotonic()

    def reserve(self) -> float:
        now = time.monotonic()
        elapsed = now - self._last_operation
        wait_time = max(0.0, self._min_interval - elapsed)
        self._last_operation = now + wait_time
        return wait_time
import asyncio

class TrafficShapingClient:
    def __init__(self):
        self._rpm_bucket = TokenBucket(quota_per_minute=600)
        self._tpm_bucket = TokenBucket(quota_per_minute=1_000_000)
        self._smooth_limiter = SmoothRateLimiter(rate_per_minute=600)
        self._concurrency_semaphore = asyncio.Semaphore(20)

    async def _execute_throttled_request(self, model, prompt, max_tokens, input_tokens):
        # [Step 1] Dual admission control
        # Check both RPM and TPM, and take the longer wait time
        wait_rpm = self._rpm_bucket.reserve(1.0)
        # The TPM check only requests a quota for input tokens
        wait_tpm = self._tpm_bucket.reserve(input_tokens)
        admission_wait = max(wait_rpm, wait_tpm)
        if admission_wait > 0:
            await asyncio.sleep(admission_wait)

        # [Step 2] Acquire concurrency lock
        async with self._concurrency_semaphore:
            # [Step 3] Traffic shaping
            # Key: Perform smoothing wait inside the lock
            # Sacrifices some concurrency efficiency for precise control over send intervals
            smooth_wait = self._smooth_limiter.reserve()
            if smooth_wait > 0:
                await asyncio.sleep(smooth_wait)

            # [Step 4] Send request
            content, actual_usage = await self._send_chat_request(model, prompt, max_tokens)

            # [Step 5] Settle output tokens
            output_tokens = actual_usage.completion_tokens
            if output_tokens > 0:
                self._tpm_bucket.adjust(-output_tokens)
            return content
Stratégie de contrôle de congestion adaptatif
Adaptée aux charges de travail dynamiques à grande échelle : passerelles API, proxys complexes, systèmes multi-locataires.
Remarque
Conseil de sélection : Cette stratégie n'est pas une solution universelleCette stratégie gère des environnements hautement incertains et volatils. Ce n'est pas un choix universel :
- Paradoxe de performance : Si la charge est prévisible (comme le traitement par lots), des paramètres statiques optimaux surpassent le sondage dynamique qui nécessite « essais et convergence ».
- Surcharge de sondage : Les algorithmes dynamiques impliquent inévitablement une montée en charge au démarrage et des fluctuations exploratoires, ce qui constitue une surcharge inutile dans des scénarios connus.
- Coût de maintenance : La boucle de rétroaction fermée accroît la complexité du système et la difficulté du dépannage.
À moins que votre activité ne présente une très grande échelle, une charge complexe et une volatilité importante, choisissez l'une des trois premières stratégies plus simples.
La limitation du taux de requêtes et la mise en forme du trafic sont des stratégies à quota statique ; elles fonctionnent bien sous des charges stables et prévisibles. Mais au niveau de la passerelle, les charges en aval changent constamment (requêtes courtes mêlées à des inférences profondes) et les seuils de la plateforme fluctuent dynamiquement. Les stratégies statiques peinent à concilier efficacité et stabilité.
Inspirée par BBR, cette stratégie construit un système de contrôle en boucle fermée basé sur l'EBP (Elastic Bandwidth Probing). Elle utilise les quotas RPM/TPM comme limite supérieure directrice et calcule dynamiquement le taux d'envoi optimal à partir des retours en temps réel (variations de latence, signaux de limitation de débit).
- EBP : Stocke le niveau historique le plus élevé atteint avec succès. Calcule le gain de sondage en simulant la tension d'un ressort basée sur la distance entre la concurrence actuelle et ce niveau (plus loin = plus rapide, plus proche = plus lent). Ajoute une petite poussée linéaire pour continuer à explorer même à saturation élevée.
- Détection de congestion TPT : Le temps de génération des LLM évolue selon la longueur de la sortie ; une latence élevée sur des textes longs ne signifie pas qu'il y a congestion. Le TPT (Time Per Token) filtre le bruit lié à la longueur du contenu. La congestion n'est déclarée que lorsque le TPT se dégrade significativement.
- Régulateur anti-rafale : Quelle que soit la cible EBP, le régulateur plafonne l'accélération de la croissance de la concurrence pour garantir une montée en charge progressive et éviter les changements brusques qui déclencheraient les limites de taux de croissance.
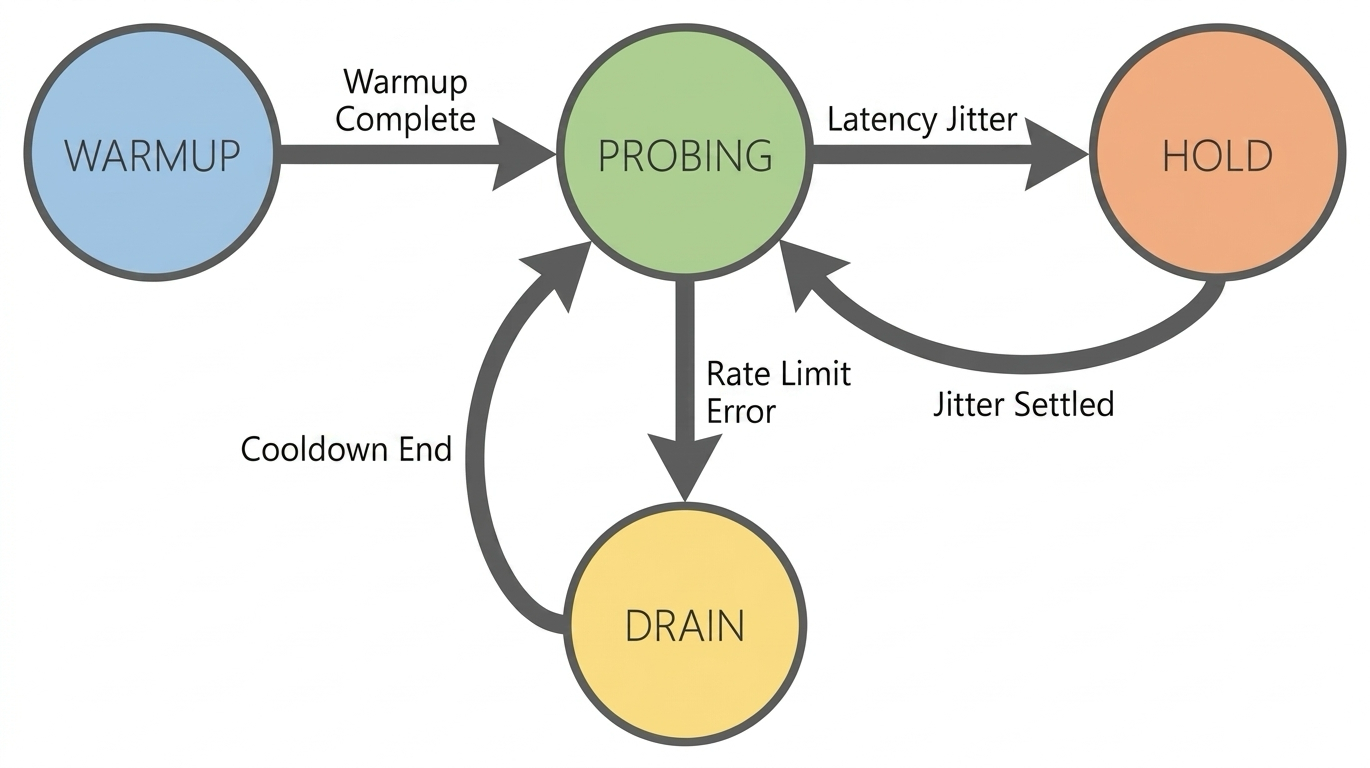
Modifications clés par rapport au BBR natif pour les grands modèles :
- Sondage guidé : Introduit les quotas RPM/TPM connus comme « limite supérieure directrice » pour éviter les collisions fréquentes causées par un sondage à l'aveugle.
- Source du signal (RTT → TPT) : Le BBR natif utilise le RTT. Dans les scénarios LLM, la latence liée à la longueur du contenu éclipse la gigue réseau. Le TPT élimine cette interférence.
- Amélioration du mécanisme de réponse (ProbeRTT → Hold) : Face aux fluctuations de latence, le système choisit de maintenir le niveau de concurrence actuel plutôt que de se retirer proactivement et de réduire le débit.
- Réponse à la limitation stricte (Packet Loss → 429 Drain) : Une fois qu'une erreur
429est déclenchée, le système entre dans un état Drain agressif et effectue une récupération rapide après une période de refroidissement.
Limitations :
- Bruit TPT : Le TPT est estimé comme « latence totale / tokens totaux ». La latence totale inclut l'aller-retour réseau, la mise en file d'attente et le délai du premier token ; elle est donc sensible à la gigue ou aux entrées longues, ce qui peut déclencher faussement l'état Hold.
- Famine des requêtes volumineuses : Utilise un réveil FIFO non strict pour les performances de planification. Lorsque les quotas sont rares, les requêtes à faible nombre de tokens peuvent préempter les ressources, obligeant les requêtes à grand nombre de tokens à attendre trop longtemps.
- Démarrage à froid : Nécessite une période de montée en charge pour construire un modèle statistique. Dans les tâches à faible charge ou de courte durée, le débit peut être inférieur à celui des trois premières stratégies.
Exemple de code
class ElasticCongestionController:
    async def acquire(self):
        """[Admission phase] Check before initiating a request"""
        # 1. SSR slow-start restart: If idle for too long, proactively decay the limit
        #    to prevent burst traffic caused by an outdated watermark.
        if self.is_idle_too_long():
            self.perform_slow_start_restart()

        # 2. Circuit breaker check: If in DRAIN (cooldown) state, force wait.
        if self.state == CongestionState.DRAIN:
            await self.wait_for_cooldown()

        # 3. Dual budget check: Check both concurrency slots and token budget.
        await self.wait_for_budget(request_tokens)

    async def release(self, latency, actual_tokens, error):
        """[Feedback phase] Decision after the request finishes"""
        if error:
            # [Fault response] On rate limit error (429/503): Immediately drain + multiplicative backoff
            self.state = CongestionState.DRAIN
            self.concurrency_limit *= self.backoff_factor  # e.g. 0.7
            return

        # [Normal response] Calculate TPT (Time-Per-Token)
        current_tpt = latency / actual_tokens

        # [Congestion awareness] TPT spike (generation slows down): Enter HOLD to observe
        # Maintain concurrency level, neither backing off nor increasing
        if current_tpt > self.metrics.ema_tpt * 2.0:
            self.state = CongestionState.HOLD
        else:
            # [Steady-state probing] Network is healthy: Perform EBP elastic probing
            self.state = CongestionState.PROBING
            self.update_limit_via_ebp()
def probe_next_limit(self, current_limit, max_known_capacity):
    """
    Calculate the next concurrency limit
    Core formula: Next = Max(Spring Tension, Additive Thrust) + Governor Smoothing
    """
    # 1. Calculate physical limit (Little's Law)
    # Theoretical limit = Throughput * Latency * Buffer Factor
    dynamic_ceiling = self.metrics.tps * self.metrics.avg_latency * 1.2

    # 2. Spring logic (Spring Tension)
    # The farther from the historical high watermark, the greater the tension (accelerate); the closer, the smaller (decelerate)
    tension = 1.0 - (current_limit / max_known_capacity)
    spring_target = current_limit * (1.0 + tension * gain)

    # 3. Additive thrust
    # Solves the "Zeno's Paradox": When tension approaches 0, forcibly add a small linear increment
    # to ensure the system can break out of local maxima and continue exploring the boundary.
    linear_target = current_limit + self.min_additive_step

    raw_target = max(spring_target, linear_target)

    # 4. Anti-burst rate governor
    # Limits the acceleration of concurrency growth to prevent step changes.
    final_limit = self.governor.smooth(raw_target)

    return min(final_limit, dynamic_ceiling)
class CongestionMetrics:
    def update_stats(self, latency, token_count):
        """
        [Sensor] Update statistical metrics in real time
        Use EMA (exponential moving average) to filter out noise from long-tail requests
        """
        alpha = 0.2  # Smoothing factor

        # 1. Estimate single request size (Token Size)
        self.ema_tokens = (1 - alpha) * self.ema_tokens + alpha * token_count

        # 2. Estimate TPT (Time Per Token)
        # Use TPT instead of Latency to eliminate errors caused by different LLM generation lengths
        instant_tpt = latency / token_count
        self.ema_tpt = (1 - alpha) * self.ema_tpt + alpha * instant_tpt

    def track_inflight(self, estimated_tokens):
        """
        [Blind spot filling] Correct the lag of "counting only after response"
        Pre-deduct the quota the moment a request is initiated
        """
        self.inflight_tokens += estimated_tokens
Solutions de repli architecturales
Lorsque la configuration de la plateforme et le contrôle du trafic côté client ne suffisent toujours pas à répondre aux exigences de disponibilité ou de débit de pointe, ajoutez des mécanismes de repli au niveau architectural.
Repli de modèle
Lorsque le modèle principal ne peut pas répondre en raison d'une limitation de débit ou de problèmes de service, basculez automatiquement vers un modèle alternatif disposant d'un quota plus généreux.
Principes de conception du chemin de repli- Choisissez des modèles de séries différentes : La limitation de débit s'applique par modèle. Utilisez un modèle différent comme repli ; par exemple, passez de
qwen3.6-plusàqwen3.6-flash. - Déclenchez le repli uniquement en cas d'erreur de limitation de débit : Effectuez le repli sur les erreurs
429, et non pour toutes les exceptions. Changer de modèle ne résoudra pas les délais d'attente réseau ni les erreurs de paramètres. - Validez le modèle de repli à l'avance : Assurez-vous qu'il prend en charge les fonctionnalités requises (Function Calling, sortie structurée, etc.) pour éviter des problèmes fonctionnels après le basculement.
Exemple de code
L'exemple suivant illustre la logique de repli de modèle basée sur le code d'erreur 429. Lorsqu'une requête adressée au modèle principal déclenche une limitation de débit, le système bascule automatiquement vers le modèle de repli pour une nouvelle tentative.
import os
import asyncio
from openai import AsyncOpenAI, APIStatusError

# Primary and fallback models (different series, independent quotas)
PRIMARY_MODEL = "qwen3.6-plus"
FALLBACK_MODEL = "qwen3.6-flash"

client = AsyncOpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

async def chat_with_fallback(messages: list) -> str:
    """Request with fallback: Automatically switches to the fallback model when the primary model is rate-limited."""
    for model in [PRIMARY_MODEL, FALLBACK_MODEL]:
        try:
            response = await client.chat.completions.create(
                model=model,
                messages=messages
            )
            return response.choices[0].message.content
        except APIStatusError as e:
            if e.status_code == 429 and model == PRIMARY_MODEL:
                print(f"[Rate Limit Triggered] {model}, falling back to {FALLBACK_MODEL}")
                continue
            raise
    raise RuntimeError("All models are unavailable")

async def main():
    result = await chat_with_fallback(
        messages=[{"role": "user", "content": "Hello"}]
    )
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
Le repli de modèle peut être combiné avec des stratégies de contrôle du trafic côté client. Par exemple, intégrez la logique de repli dans le mécanisme de nouvelle tentative de la stratégie de limitation du taux de requêtes. Lorsque les tentatives sont épuisées et que la limitation de débit persiste, basculez vers le modèle de repli.
Lissage des pics de charge via files d'attente de messages (MQ)
Pour les services d'arrière-plan ne nécessitant pas de réponses immédiates, introduisez un middleware de messagerie (RabbitMQ, Kafka) pour lisser les pics de charge. Le trafic en rafale entre d'abord dans la MQ ; les consommateurs extraient et traitent les messages à un rythme régulier correspondant au quota de limitation de débit. Cela découple les pics frontaux des appels backend.
Convient aux activités où les utilisateurs acceptent des résultats asynchrones : traitement de tickets, modération de contenu, annotation de données par lots.
Points clés de la conception :
- Contrôle du taux de consommation : Le côté consommateur doit utiliser la stratégie de limitation du taux de requêtes ou de mise en forme du trafic pour consommer les messages à un rythme régulier basé sur le quota RPM/TPM, plutôt que d'extraire les messages sans limites.
- Gestion des lettres mortes : Déplacez les messages ayant échoué après plusieurs tentatives vers une file d'attente de lettres mortes et déclenchez une alerte. Empêchez les tentatives infinies de bloquer la consommation.
- Propagation de la contre-pression : Lorsque l'arriéré de la MQ dépasse un seuil, propagez la pression en amont (par exemple, renvoyez un statut de mise en file d'attente) pour éviter une croissance illimitée de la file.
Considérations pour l'environnement de production
Les exemples de code utilisent une boucle monothread asyncio Python pour illustrer les algorithmes fondamentaux. Avant une utilisation en production à grande échelle, prenez en compte les points suivants.
-
Adaptation aux modèles non textuels
Les stratégies ci-dessus utilisent des modèles textuels comme exemples, mais les principes fondamentaux s'appliquent aux services multimodaux (génération d'images, synthèse vocale). Les unités diffèrent, mais l'essence reste la même : limiter le taux de soumission et la capacité de traitement.
- Les modèles tels que la reconnaissance vocale sont généralement contraints à la fois par le nombre de requêtes par unité de temps (comme le RPM) et par l'utilisation (comme la durée audio). Les stratégies sont fondamentalement les mêmes que pour les modèles textuels.
- Les modèles pour images et vidéos sont généralement contraints par le taux de soumission des tâches et le nombre de tâches simultanées. Adoptez la même approche que la stratégie de limitation du taux de requêtes : limitez le taux de soumission des tâches et utilisez un sémaphore pour contrôler la concurrence.
Quelle que soit l'évolution des métriques, le principe de limitation côté client reste identique. Remplacez le compteur ou la métrique de sondage par celui correspondant à votre modalité. Pour les règles spécifiques, consultez la rubrique Limitation de débit.
-
Atomicité dans les modèles concurrents
Exemple :
asyncioutilise une planification coopérative monothread, de sorte que les modifications d'état sont intrinsèquement atomiques au sein d'un seul processus.Production : Dans des environnements multithreads ou multiprocessus, assurez la sécurité concurrentielle du seau à jetons et de la fenêtre statistique. Les conditions de course compromettront le contrôle du trafic.
-
Limitation de débit distribuée
Exemple : Tous les composants de contrôle du trafic résident en mémoire.
Production : Dans les déploiements multi-instances, chaque instance effectue sa propre limitation indépendamment. L'utilisation totale peut dépasser la limite. Utilisez un compteur centralisé (tel que Redis) pour gérer l'utilisation sur tous les nœuds.
-
Files d'attente prioritaires et prévention de la famine
Exemple : Aucune différenciation de priorité. La stratégie de contrôle de congestion adaptatif utilise un réveil FIFO non strict pour les performances de planification.
Production : Pour les requêtes haute/basse priorité, implémentez une file d'attente prioritaire pondérée afin de garantir la bande passante pour le trafic haute priorité. Réservez un quota minimal pour les files d'attente basse priorité afin d'éviter la famine.