Le reflux des journaux convertit les journaux d'inférence SLS (Simple Log Service) en jeux de données structurés exploitables pour le fine-tuning ou l'évaluation de modèles.
Présentation de la fonctionnalité
La fonctionnalité de reflux des journaux récupère les données de journaux d'inférence depuis SLS (Simple Log Service) vers la plateforme Bailian, les formate et génère des jeux de données structurés (au format JSONL). Ces jeux de données servent ensuite au fine-tuning ou à l'évaluation des modèles. Le reflux produit des données structurées et non une simple copie brute des journaux d'origine.
Périmètre
Le reflux des journaux permet de créer deux types de jeux de données :
- Training set : Conçu pour le scénario de génération de texte, ce jeu de données prend en charge les méthodes d'entraînement SFT (Supervised Fine-Tuning).
- Evaluation set : Destiné au scénario de génération de texte.
Le reflux des journaux est actuellement disponible uniquement dans les régions China (Beijing) et Singapore. L'option de reflux des journaux n'apparaît pas dans les autres régions. La limite supérieure pour un seul reflux est de 100 000 entrées. Vous pouvez effectuer plusieurs reflux vers différentes versions du même jeu de données afin d'accumuler davantage de données.
Deux modes de stockage sont pris en charge pour le reflux des journaux : Platform Storage (par défaut) . Pour connaître les différences entre ces modes et obtenir des conseils de sélection, consultez la rubrique Créer un jeu de données de reflux des journaux.
Les jeux de données générés par le reflux sont directement utilisables pour les tâches en aval : les jeux d'entraînement servent au réglage de modèle et les jeux d'évaluation à l'évaluation des modèles.
Activer et autoriser les services associés
Avant d'utiliser le reflux des journaux, assurez-vous que la région actuelle est China (Beijing) ou Singapore (l'option de reflux des journaux n'est pas affichée dans les autres régions), puis effectuez l'activation du service et l'autorisation des permissions sur la page Model monitoring. Une fois toutes les étapes terminées, le tiroir de configuration d'autorisation se ferme automatiquement et vous accédez au formulaire de reflux des journaux.
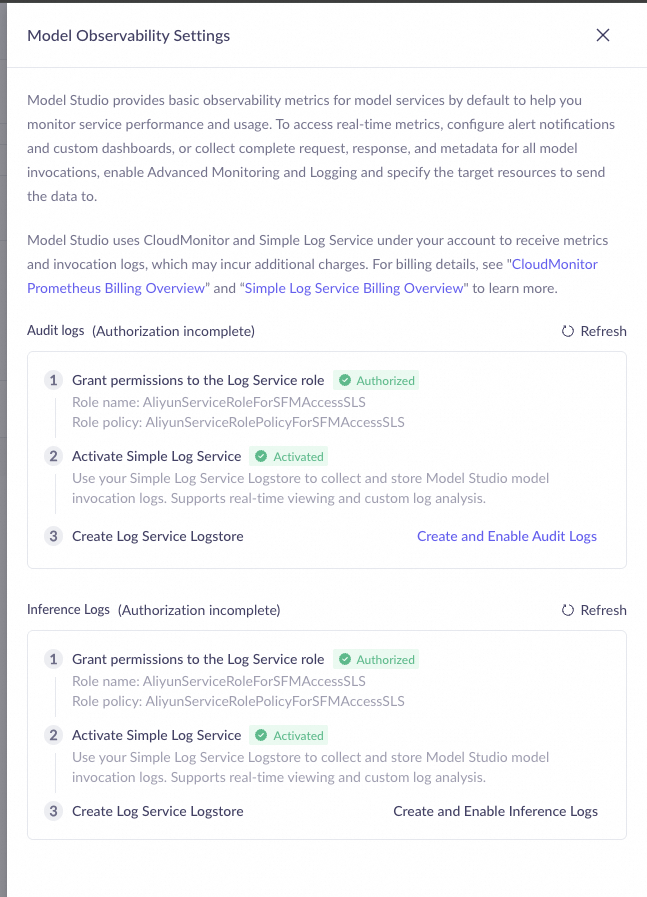
Activer les journaux d'audit et les journaux d'inférence
L'activation des journaux d'audit et des journaux d'inférence nécessite chacune trois étapes. Le reflux des journaux n'est disponible que lorsque ces six conditions sont remplies. Les journaux d'audit étant un prérequis aux journaux d'inférence, vous devez impérativement terminer toutes les étapes relatives aux journaux d'audit en premier.
Journaux d'audit- Autorisez le rôle lié au service SLS : cliquez sur Authorize Now pour autoriser le rôle AliyunServiceRoleForSFMAccessSLS. En l'absence d'autorisation, un libellé rouge Not Authorized s'affiche.
- Activez SLS Log Service : si le service n'est pas activé, un statut Not Activated ainsi qu'un lien de redirection apparaissent. Cliquez sur ce lien pour accéder à la console SLS et finaliser l'activation.
- Activez les journaux d'audit : cliquez sur Create and Enable Audit Logs. Le système crée alors une instance LogStore et interroge son état jusqu'à ce qu'elle soit opérationnelle (délai maximal de 60 secondes).
- Autorisez le rôle lié au service SLS pour les journaux d'inférence.
- Vérifiez que SLS Log Service est bien activé.
- Activez les journaux d'inférence : si les journaux d'audit ne sont pas activés, ce bouton est grisé. Vous devez d'abord activer les journaux d'audit.
ImportantL'activation doit respecter l'ordre suivant : d'abord les journaux d'audit, puis les journaux d'inférence. La désactivation suit l'ordre inverse : désactivez d'abord les journaux d'inférence, puis les journaux d'audit. Une fois les journaux désactivés, les données existantes ne peuvent pas être restaurées. Assurez-vous de ne plus avoir besoin des données de journal avant d'effectuer cette opération. Dès l'activation des journaux d'inférence, SLS engendre en continu des frais de stockage et de lecture/écriture. Pensez à les désactiver lorsqu'ils ne sont plus nécessaires.
Le tableau ci-dessous récapitule les rôles liés au service impliqués dans le reflux des journaux.
Nom du rôle | Objectif | Moment de l'autorisation |
|---|---|---|
AliyunServiceRoleForSFMAccessSLS | Accès de Bailian aux données de journaux SLS | Autorisé une fois pour les journaux d'audit et une fois pour les journaux d'inférence |
Créer un jeu de données de reflux des journaux
Trois points d'entrée permettent d'accéder au reflux des journaux, chacun menant au formulaire de configuration pour créer un jeu de données :
Page de liste de surveillance des modèles
En haut de la page de liste de surveillance, cliquez sur Monitoring. Lors d'une première utilisation, complétez d'abord la configuration d'autorisation. Une fois l'autorisation validée, le formulaire de reflux des journaux s'affiche automatiquement.
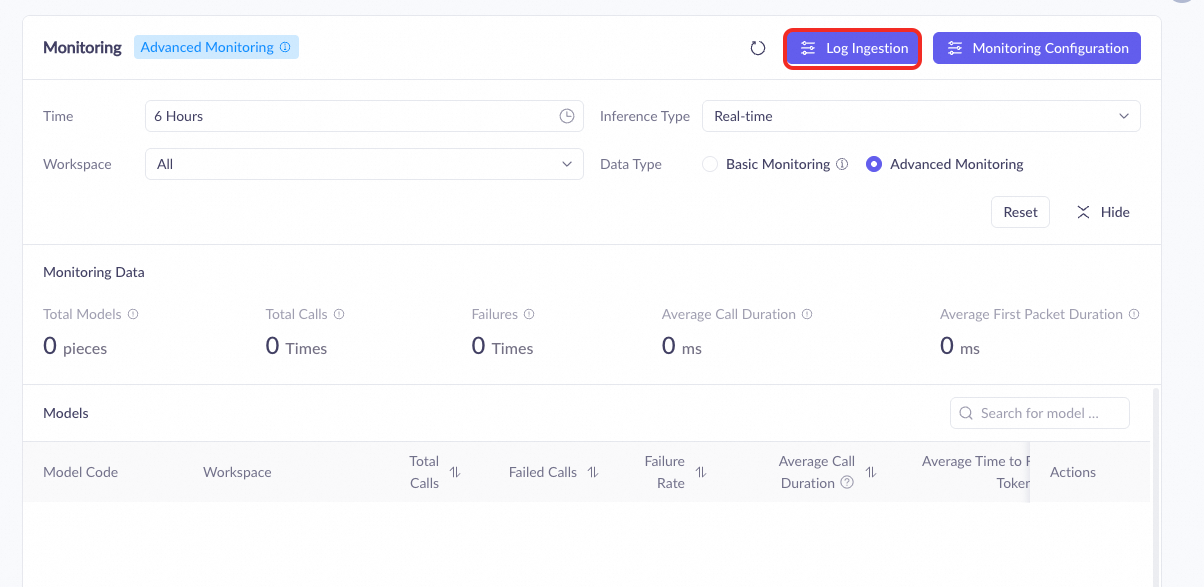
Page de détails de surveillance des modèles
Dans la zone de sélection temporelle de la page de détails de surveillance des modèles, cliquez sur Monitoring. En passant par ce point d'entrée, le formulaire préremplit automatiquement la plage horaire, la clé API et le modèle de la page en cours ; le modèle ne peut pas être modifié.
Page de gestion des données
Lors de la création d'un nouveau jeu de données sur la page Log Ingestion, sélectionnez Log Ingestion comme méthode d'importation. Cette option n'est visible que pour les jeux d'entraînement (génération de texte + SFT) ou les jeux d'évaluation (génération de texte).
Configurer les paramètres de reflux
Une fois dans le formulaire de reflux des journaux, configurez les paramètres suivants de haut en bas. Certains paramètres ont des prérequis : le filtrage par clé API nécessite d'avoir d'abord sélectionné une plage horaire, et la sélection du modèle requiert à la fois une plage horaire et une clé API. Toute modification de la plage horaire, du type de données, du scénario d'entraînement ou de la méthode d'entraînement entraîne la réinitialisation en cascade d'autres paramètres. Il est donc recommandé de remplir le formulaire strictement dans l'ordre. Les valeurs des paramètres sont décrites dans le tableau ci-dessous.
Data management : le système affiche le nombre estimé d'entrées de données de reflux en fonction des conditions de filtrage. Si ce nombre dépasse 100 000, un avertissement rouge s'affiche et le surplus ne sera pas inclus dans le reflux. Lorsque les résultats de la requête sont trop nombreux, le bouton Log Backflow est désactivé ; vous devez alors restreindre la plage de filtrage.
NoteRègles de réinitialisation en cascade du formulaire : la modification de la plage horaire réinitialise la clé API (retour à Estimated backflow data) et la sélection du modèle (effacée) ; la modification du type de données, du scénario d'entraînement ou de la méthode d'entraînement réinitialise l'emplacement de stockage et la méthode d'importation.
ImportantLe mode de stockage, le type de données et la méthode d'entraînement ne peuvent plus être modifiés après la création. Vérifiez soigneusement vos choix avant de valider.
Paramètre | Description | Obligatoire | Description des valeurs |
|---|---|---|---|
Emplacement du reflux | Mode de stockage du jeu de données | Oui | Stockage sur la plateforme (par défaut). Non modifiable après la création |
Nom du jeu de données | Nom d'affichage du jeu de données dans la liste | Oui | Caractères chinois, anglais, chiffres, traits de soulignement, barres obliques et tirets, jusqu'à 50 caractères. Format de nommage recommandé : fonction_scénario_nom_modèle_date. Non modifiable après la création |
Description du jeu de données | Description complémentaire de l'objectif du jeu de données | Non | Jusqu'à 200 caractères |
Type et format | Type d'usage du jeu de données | Oui | Jeu d'entraînement ou jeu d'évaluation. Lorsque le jeu d'évaluation est sélectionné, le scénario d'entraînement et la méthode d'entraînement sont masqués. Non modifiable après la création |
Scénario d'entraînement | Type de scénario d'entraînement (affiché uniquement pour les jeux d'entraînement) | Oui | Actuellement, seule la génération de texte est prise en charge |
Méthode d'entraînement | Méthode de fine-tuning (affichée uniquement pour les jeux d'entraînement) | Oui | SFT ; les options sont affichées dynamiquement par le système. Verrouillé après la création |
Plage horaire | Période des journaux à refluer | Oui | 30 derniers jours (aujourd'hui inclus), précision à l'heure, la minute et la seconde. Toute modification réinitialise la clé API et la sélection du modèle |
Filtre de clé API | Filtrer les données de journal par clé API | Oui | All (aucun filtre), Other (exclut les clés listées) ou sélection de clés spécifiques (sélection multiple) |
Sélection du modèle | Modèles cibles pour le reflux | Oui | Jusqu'à 10. Les modèles ne correspondant pas au filtre de type de capacité sont grisés |
Consulter les résultats du reflux
Après avoir soumis une tâche de reflux des journaux, consultez le jeu de données et la progression de l'importation sur la page de liste de gestion des données.
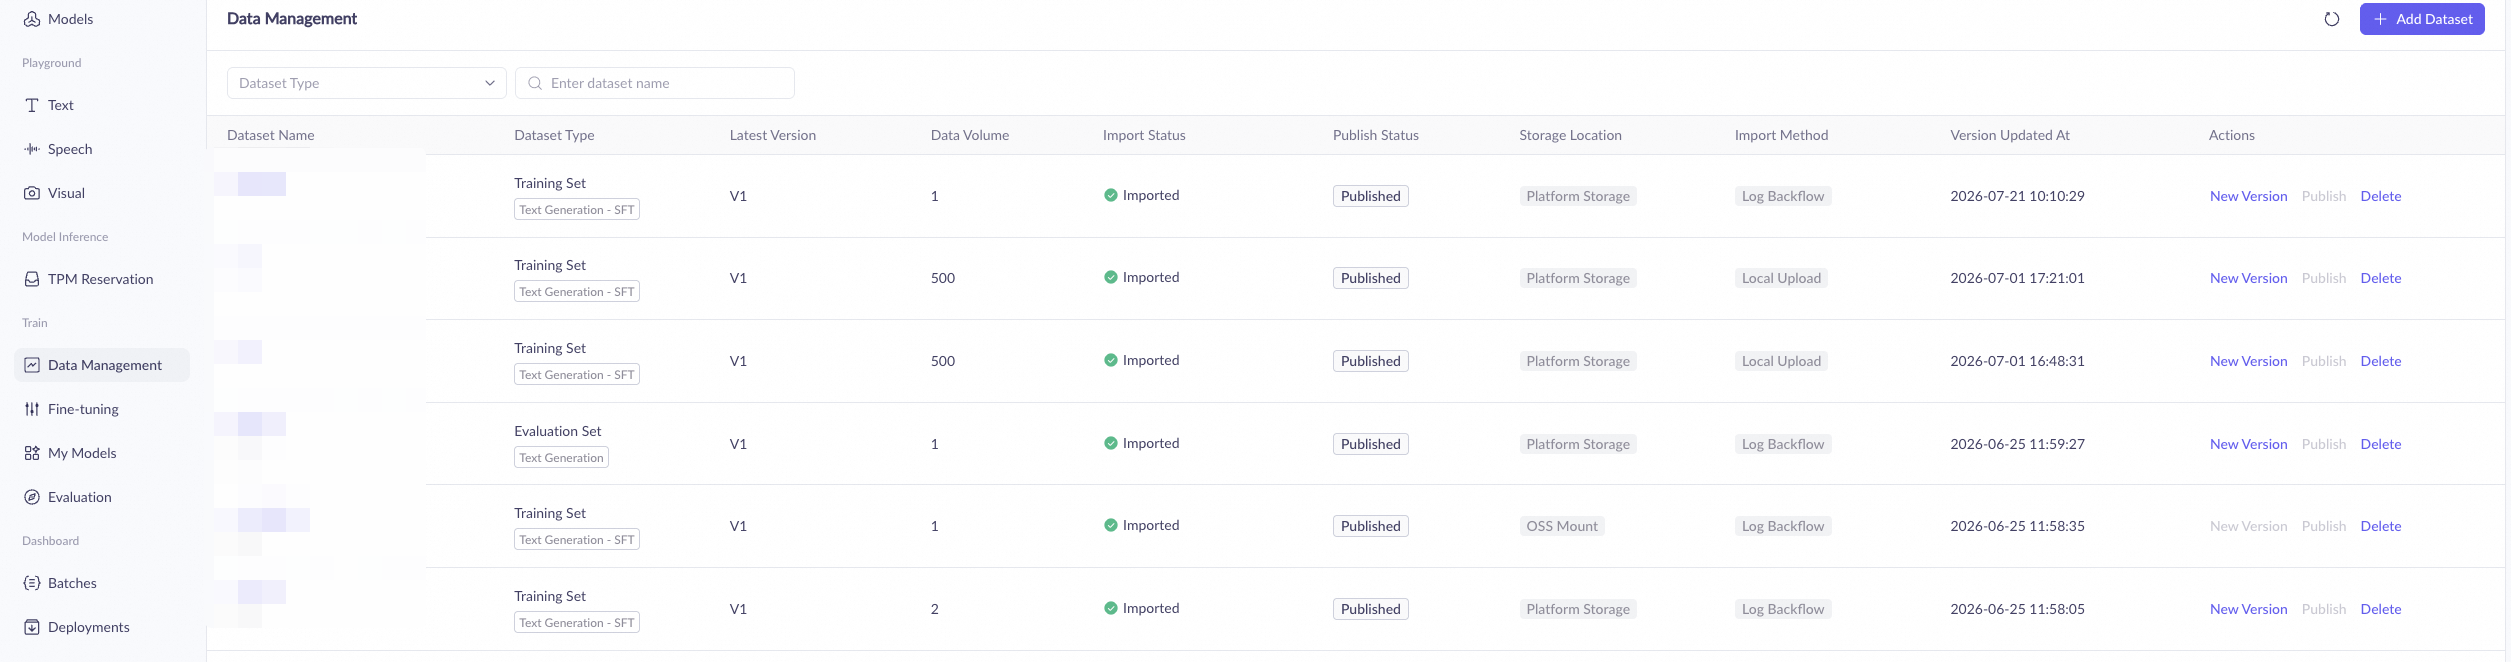
Affichage sur la page de liste
Pour les jeux de données créés par reflux des journaux, la méthode d'importation apparaît sous le libellé OK sur la page de liste. L'emplacement de stockage s'affiche comme All selon le choix effectué lors de la création.
La page de liste permet de suivre l'état d'importation de la tâche. En cas d'échec, le motif spécifique retourné par le système est consultable.
En mode de stockage sur la plateforme, le système publie automatiquement la version du jeu de données une fois l'importation terminée, sans aucune intervention manuelle.
Informations de la page de détails
Les informations affichées sur la page de détails du jeu de données varient selon le mode de stockage :
- Log Ingestion : affiche l'état de publication, le volume de données, la date de création, le FileID, le type de données, l'état d'importation et l'adresse d'importation OSS.
- Autres cas : affiche l'état de publication, le volume de données, la date de création, le FileID, le type de données et l'état d'importation.
Ajouter des données de reflux des journaux
Sur la page Data management, vous pouvez ajouter un nouveau lot de données de reflux des journaux à un jeu de données existant selon deux méthodes :
Page d'importation des données
Accédez à la page Platform Storage d'un jeu de données existant et sélectionnez OSS Mount comme méthode d'importation. Les paramètres du formulaire sont identiques à ceux du flux de création. Pour plus de détails, consultez Créer un jeu de données de reflux des journaux. Cette méthode permet en outre de filtrer par espace de travail.
Cette méthode s'applique à tous les types de stockage des jeux de données .
Boîte de dialogue d'ajout de version
Sur la page de détails du jeu de données, cliquez sur OSS Mount, puis sélectionnez la méthode d'importation par reflux des journaux dans la boîte de dialogue. Cette méthode est réservée aux jeux de données avec stockage sur la plateforme.
Bonnes pratiques pour le reflux incrémentiel
Il est recommandé de procéder par lots, en ciblant séparément différentes périodes ou différents modèles, afin de constituer progressivement des jeux d'entraînement de haute qualité. Chaque lot peut sélectionner avec précision les modèles performants et les données issues des heures de pointe métier, garantissant ainsi une qualité supérieure à celle d'un reflux unique massif.
FAQ
Quelles requêtes sont incluses dans « Other » du filtre de clé API ?
Question : Quelles requêtes sont incluses dans Log Backflow du filtre de clé API ?
New Version exclut les requêtes provenant des clés listées, y compris les clés supprimées ou les journaux générés par d'autres espaces de travail. New Version n'applique aucun filtre par clé. Pour une description complète des trois modes (All/Other/sélection individuelle), reportez-vous au paramètre de filtre de clé API dans la rubrique Créer un jeu de données de reflux des journaux.
La limite de 100 000 entrées s'applique-t-elle au volume total du jeu de données ?
Question : La limite d'un seul reflux est de 100 000 entrées. Cela signifie-t-il que le volume total du jeu de données est également limité à 100 000 entrées ?
Non. La limite de 100 000 entrées s'applique à un seul reflux, et non au volume total du jeu de données. Vous pouvez effectuer plusieurs reflux vers différentes versions du même jeu de données, et le volume cumulé n'est pas soumis à cette limite. Par exemple, en procédant par lots pour différentes périodes, chaque fois dans la limite de 100 000 entrées, le jeu de données final peut accumuler bien plus de 100 000 entrées.
Les journaux d'audit et les journaux d'inférence correspondent-ils à la même opération ?
Question : L'activation des journaux nécessite des opérations distinctes pour les journaux d'audit et les journaux d'inférence. Quel est le lien entre les deux ?
Ils doivent être activés séparément, et les journaux d'audit doivent être configurés avant de pouvoir activer les journaux d'inférence. Pour les étapes détaillées, consultez Activer et autoriser les services associés.
Pourquoi le volume de données estimé ne correspond-il pas aux résultats réels du reflux ?
Question : Le volume de données estimé affiché avant la soumission diffère du nombre réel d'entrées une fois le reflux terminé.
Le volume de données estimé est une valeur approximative basée sur les conditions de filtrage. Le nombre réel d'entrées après le reflux peut varier légèrement, ce qui est normal. L'estimation sert principalement à déterminer si les conditions de filtrage doivent être ajustées (par exemple, lorsqu'elles dépassent 100 000 entrées, vous êtes invité à restreindre la plage) et ne constitue pas un décompte exact.