MaxCompute permet d'accéder aux données d'événements publics GitHub issues de GH Archive, un projet qui archive l'activité publique GitHub heure par heure. Utilisez ce jeu de données pour analyser les écosystèmes open source, suivre les tendances des langages de programmation et mesurer l'activité des projets sur des millions de référentiels.
Ce jeu de données est destiné uniquement à des tests de produit. L'exactitude des données n'est pas garantie. Ne l'utilisez pas dans un environnement de production.
Tables disponibles
Le jeu de données est stocké dans le schéma github_events du projet BIGDATA_PUBLIC_DATASET. Toutes les tables sont accessibles via des requêtes SQL inter-projets.
| Nom de la table | Description | Cycle de mise à jour |
|---|---|---|
dwd_github_events_odps |
Table de faits — une ligne par événement public GitHub | T+1 heure |
dws_overview_by_repo_month |
Table d'agrégation — métriques mensuelles par référentiel | T+1 jour |
db_repos |
ID et noms des projets de bases de données open source | — |
programming_language_repos |
ID et noms des projets de langages de programmation open source | — |
Les listes de projets db_repos et programming_language_repos proviennent de ossinsight.
Pour savoir comment ces données sont générées, consultez Traitement intégré des données hors ligne et en temps réel basé sur le jeu de données d'événements publics GitHub.
Schémas de table
dwd_github_events_odps
Cette table de faits stocke un enregistrement par événement public GitHub, mis à jour toutes les heures (T+1).
| Nom du champ | Type de données | Description |
|---|---|---|
id |
BIGINT | L'ID de l'événement. |
actor_id |
BIGINT | L'ID de l'initiateur de l'événement. |
actor_login |
STRING | Le nom de connexion de l'initiateur de l'événement. |
repo_id |
BIGINT | L'ID du référentiel. |
repo_name |
STRING | Le nom du référentiel, au format owner/repository_name. |
org_id |
BIGINT | L'ID de l'organisation propriétaire du référentiel. |
org_login |
STRING | Le nom de l'organisation propriétaire du référentiel. |
type |
STRING | Le type d'événement. Pour la liste complète, consultez Types d'événements GitHub. |
created_at |
DATETIME | L'heure à laquelle l'événement s'est produit. |
action |
STRING | L'action de l'événement (par exemple, opened ou created). |
iss_or_pr_id |
BIGINT | L'ID de l'issue ou de la pull request. |
number |
BIGINT | Le numéro de séquence de l'issue ou de la pull request. |
comment_id |
BIGINT | L'ID du commentaire. |
commit_id |
STRING | L'ID du commit. |
member_id |
BIGINT | L'ID du membre. |
rev_or_push_or_rel_id |
BIGINT | L'ID de la review, du push ou de la release. |
ref |
STRING | Le nom de la ressource créée ou supprimée. |
ref_type |
STRING | Le type de la ressource créée ou supprimée. |
state |
STRING | Le statut de l'issue, de la pull request ou de la review de pull request. |
author_association |
STRING | La relation entre l'initiateur de l'événement et le référentiel. |
language |
STRING | Le langage de programmation du code dans la merge request. |
merged |
BOOLEAN | Indique si la pull request a été fusionnée. |
merged_at |
DATETIME | L'heure à laquelle le code a été fusionné. |
additions |
BIGINT | Le nombre de lignes ajoutées. |
deletions |
BIGINT | Le nombre de lignes supprimées. |
changed_files |
BIGINT | Le nombre de fichiers modifiés par la pull request. |
push_size |
BIGINT | Le nombre total de commits dans le push. |
push_distinct_size |
BIGINT | Le nombre de commits distincts dans le push. |
hr |
STRING | L'heure à laquelle l'événement s'est produit. Par exemple, un événement à 00:23 a la valeur 00. |
month |
STRING | Le mois auquel l'événement s'est produit, au format yyyy-MM. Par exemple, octobre 2015 correspond à 2015-10. |
year |
STRING | L'année à laquelle l'événement s'est produit. Par exemple, 2015. |
ds |
STRING | La date à laquelle l'événement s'est produit, au format yyyy-MM-dd. |
dws_overview_by_repo_month
Cette table d'agrégation stocke les métriques mensuelles par référentiel, mises à jour tous les jours (T+1).
| Nom du champ | Type de données | Description |
|---|---|---|
repo_id |
BIGINT | L'ID du référentiel. |
repo_name |
STRING | Le nom du référentiel, au format owner/repository_name. |
stars |
BIGINT | Le nombre d'étoiles reçues par le référentiel ce mois-là. |
commits |
BIGINT | Le nombre de commits effectués sur le référentiel ce mois-là. |
pushes |
BIGINT | Le nombre de pushes effectués sur le référentiel ce mois-là. |
total_prs |
BIGINT | Le nombre total de pull requests ce mois-là. |
pr_creators |
BIGINT | Le nombre de créateurs de pull requests ce mois-là. |
pr_reviews |
BIGINT | Le nombre de reviews de pull requests ce mois-là. |
pr_reviewers |
BIGINT | Le nombre de reviewers de pull requests ce mois-là. |
total_issues |
BIGINT | Le nombre total d'issues ce mois-là. |
forks |
BIGINT | Le nombre de forks ce mois-là. |
month |
STRING | Le mois, au format yyyy-MM. Par exemple, octobre 2015 correspond à 2015-10. |
Régions disponibles
| Région | ID de région |
|---|---|
| Chine (Hangzhou) | cn-hangzhou |
| Chine (Shanghai) | cn-shanghai |
| Chine (Pékin) | cn-beijing |
| Chine (Zhangjiakou) | cn-zhangjiakou |
| Chine (Ulanqab) | cn-wulanchabu |
| Chine (Shenzhen) | cn-shenzhen |
| Chine (Chengdu) | cn-chengdu |
Notes d'utilisation
Les jeux de données publics sont stockés dans le projet BIGDATA_PUBLIC_DATASET. Comme vous n'êtes pas membre de ce projet, toutes les requêtes utilisent un accès inter-projets. Tenez compte des points suivants :
Spécifiez le chemin complet de la table dans SQL. Préfixez chaque nom de table avec le projet et le schéma :
bigdata_public_dataset.github_events.<table_name>.-
Activez la syntaxe de schéma. Si la syntaxe de schéma au niveau du locataire n'est pas activée pour votre compte, ajoutez la ligne suivante au début de chaque script SQL :
SET odps.namespace.schema = true; Le stockage est gratuit ; les requêtes sont facturées. Vous n'êtes pas facturé pour le stockage des données du jeu de données public, mais les ressources de calcul consommées par vos requêtes le sont. Pour plus de détails, consultez .
Data Map n'est pas disponible pour les jeux de données publics. L'accès inter-projets signifie que vous ne pouvez pas parcourir ces tables dans Data Map de DataWorks.
DataAnalysis de DataWorks nécessite du SQL. Si la syntaxe de schéma au niveau du locataire n'est pas activée, interrogez les données en exécutant directement des instructions SQL plutôt qu'en utilisant l'interface visuelle DataAnalysis.
Pour plus d'informations sur les opérations de schéma, consultez Opérations de schéma.
Interroger le jeu de données
Prérequis
Avant de commencer, assurez-vous d'avoir :
Un service MaxCompute activé
Un projet MaxCompute. Pour plus de détails, consultez Créer un projet MaxCompute.
Outils pris en charge
Exécutez les requêtes à l'aide de l'un des outils suivants :
Exécuter votre première requête
L'exemple suivant récupère 100 lignes de la table de faits pour une date spécifique :
-- Enable session-level schema syntax if tenant-level syntax is not enabled.
SET odps.namespace.schema = true;

-- Query 100 records from May 10, 2024.
SELECT *
FROM bigdata_public_dataset.github_events.dwd_github_events_odps
WHERE ds = '2024-05-10'
LIMIT 100;
Exemples de requêtes et analyses
Les exemples suivants utilisent les tables dwd_github_events_odps et dws_overview_by_repo_month pour répondre à des questions courantes sur les bases de données open source et les langages de programmation. Tous les exemples nécessitent l'activation de la syntaxe de schéma.
Bases de données open source
Ce groupe de requêtes utilise la table de référence db_repos pour limiter les résultats aux projets de bases de données open source connus, couvrant les classements de popularité, les tendances des étoiles et l'activité des contributeurs.
Quelles étaient les bases de données open source les plus populaires de 2018 à 2022 ?
SET odps.namespace.schema = TRUE;

SELECT
  dws.repo_id AS repo_id,
  repos.name AS repo_name,
  SUM(dws.stars) AS stars
FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month dws
JOIN bigdata_public_dataset.github_events.db_repos repos ON dws.repo_id = repos.id
WHERE month >= '2015-01' AND month <= '2022-12'
GROUP BY dws.repo_id, repos.name
ORDER BY stars DESC
LIMIT 10;
Résultat de l'analyse : elasticsearch était le projet de base de données open source le plus populaire, suivi de redis et prometheus.

Comment les classements des principaux projets de bases de données ont-ils évolué chaque année de 2018 à 2022 ?
SET odps.namespace.schema = TRUE;
SET odps.sql.validate.orderby.limit = FALSE;

WITH tmp AS (
  SELECT
    dws.repo_id AS repo_id,
    repos.name AS repo_name,
    SUM(dws.stars) AS stars,
    SUBSTR(month, 1, 4) AS year,
    ROW_NUMBER() OVER (PARTITION BY SUBSTR(month, 1, 4) ORDER BY SUM(dws.stars) DESC) AS ranknum
  FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month dws
  JOIN bigdata_public_dataset.github_events.db_repos repos ON dws.repo_id = repos.id
  WHERE month >= '2018-01'
  GROUP BY dws.repo_id, repos.name, SUBSTR(month, 1, 4)
)
SELECT repo_id, repo_name, stars, ranknum, year
FROM tmp
WHERE year <= 2022 AND ranknum <= 10
ORDER BY year ASC, ranknum ASC;
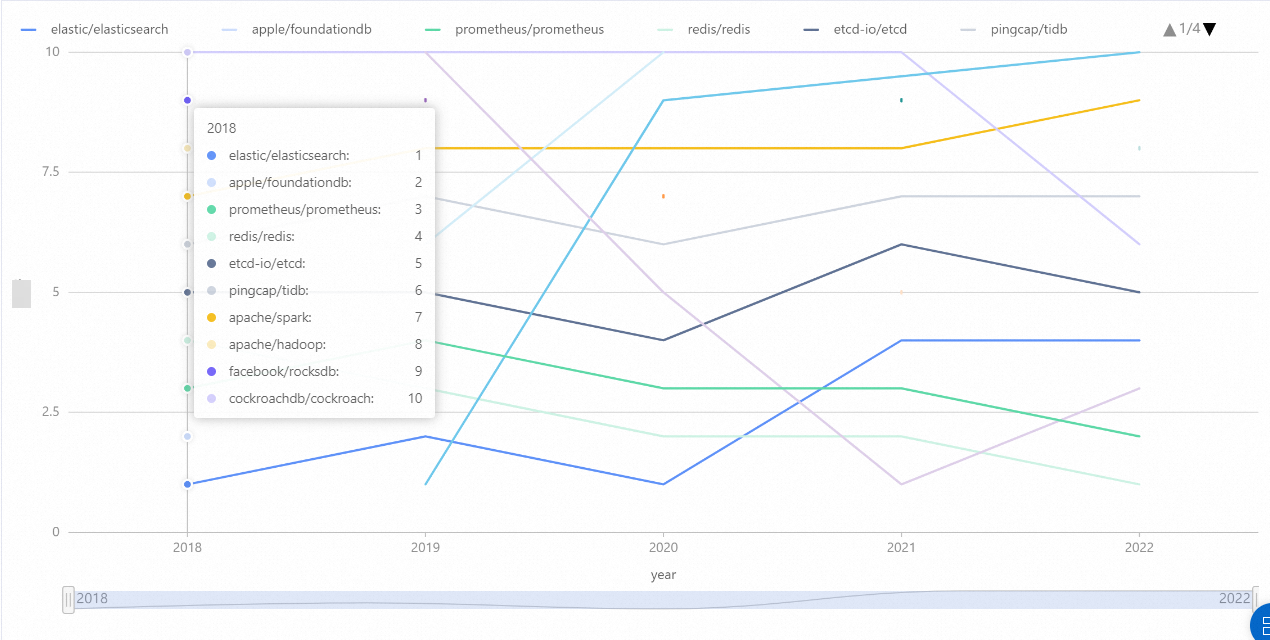
Résultat de l'analyse : clickhouse a connu la croissance la plus rapide de tous les projets, passant de la dixième place en 2018 à la première en 2021. En 2022, il a été dépassé par redis, en hausse constante. taosdata/TDengine a atteint la première place en 2019, mais est tombé à la neuvième en un an.
Quelle a été l'évolution mensuelle du nombre d'étoiles pour les 10 principaux projets de bases de données de 2018 à 2022 ?
SET odps.namespace.schema = true;
SET odps.sql.validate.orderby.limit = false;

WITH top_10_repos AS (
  SELECT
    dws.repo_id AS repo_id,
    repos.name AS repo_name,
    SUM(dws.stars) AS stars
  FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month dws
  JOIN bigdata_public_dataset.github_events.db_repos repos ON dws.repo_id = repos.id
  WHERE month >= '2018-01' AND month <= '2022-12'
  GROUP BY dws.repo_id, repos.name
  ORDER BY stars DESC
  LIMIT 10
),
tmp AS (
  SELECT
    month,
    repo_id,
    stars,
    SUM(stars) OVER (PARTITION BY repo_id ORDER BY month ASC) AS total_stars
  FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month
  WHERE month >= '2015-01' AND stars IS NOT NULL
    AND repo_id IN (SELECT repo_id FROM top_10_repos)
  GROUP BY repo_id, month, stars
  ORDER BY month ASC, repo_id
)
SELECT
  tmp.month AS month,
  top_10_repos.repo_name AS repo_name,
  tmp.total_stars AS total_stars
FROM tmp
JOIN top_10_repos ON top_10_repos.repo_id = tmp.repo_id
GROUP BY month, repo_name, total_stars
ORDER BY month ASC, repo_name;
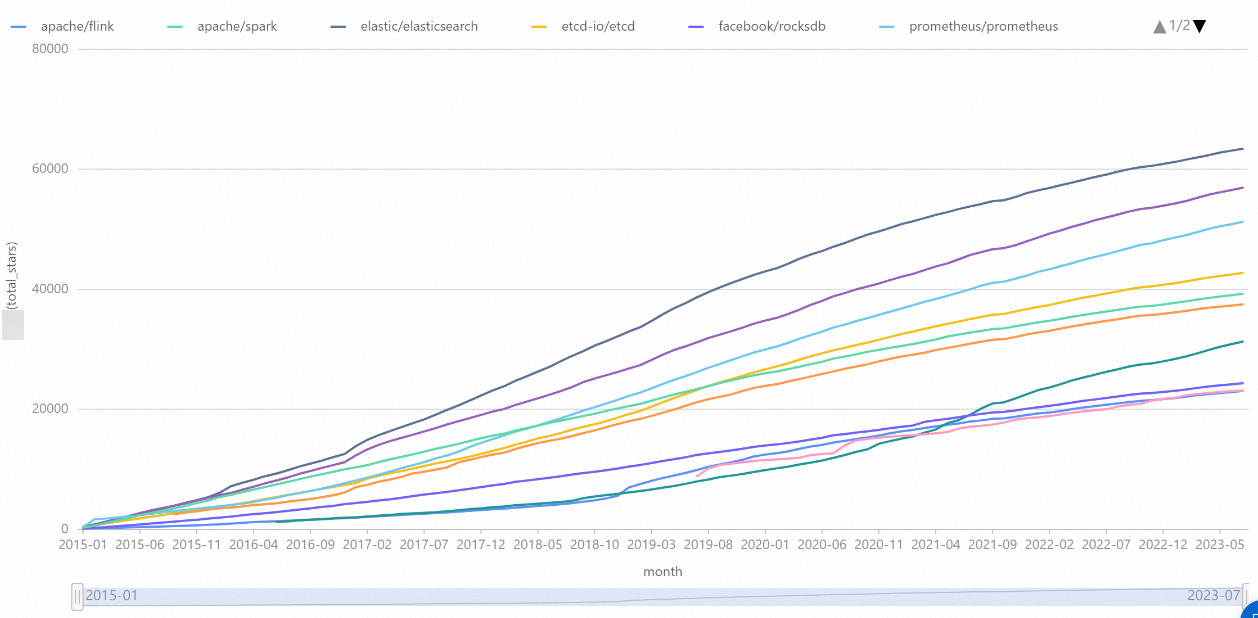
Résultat de l'analyse : elasticsearch a été constamment le projet de base de données le plus étoilé. clickhouse a connu une croissance cumulative rapide à partir de 2021.
Quelles bases de données étaient les plus populaires au premier semestre 2023 ?
SET odps.namespace.schema = true;

SELECT
  repos.name AS repo_name,
  SUM(dws.stars) AS stars
FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month dws
JOIN bigdata_public_dataset.github_events.db_repos repos ON repos.id = dws.repo_id
WHERE month >= '2023-01' AND month <= '2023-06'
GROUP BY repo_name
ORDER BY stars DESC
LIMIT 10;
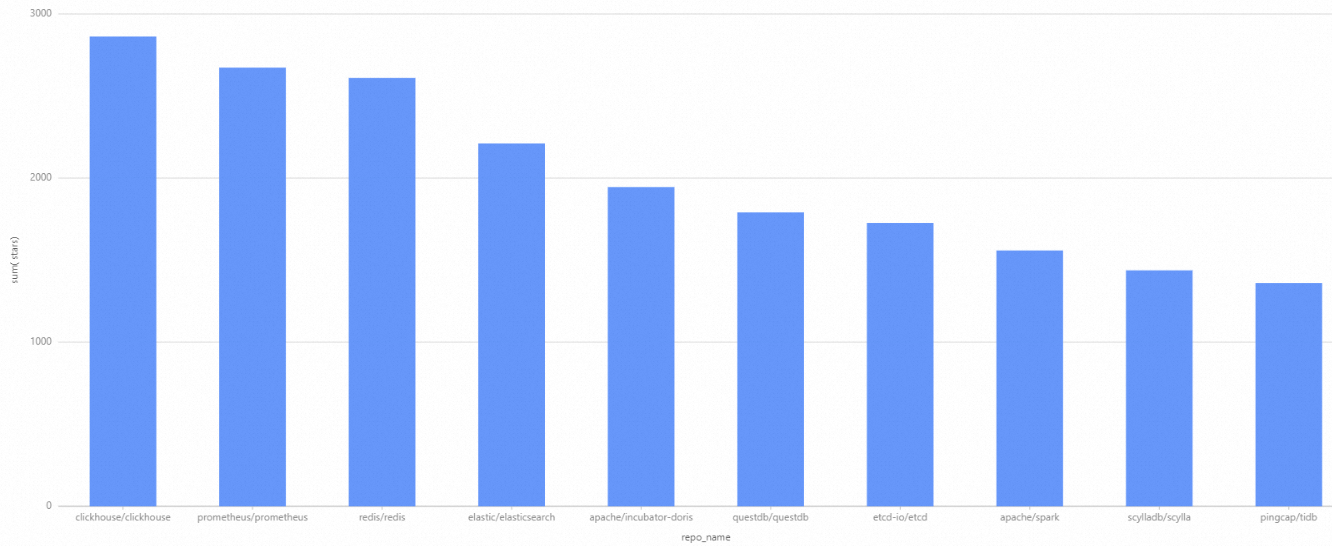
Résultat de l'analyse : clickhouse était la base de données la plus populaire au premier semestre 2023, suivie de prometheus et redis.
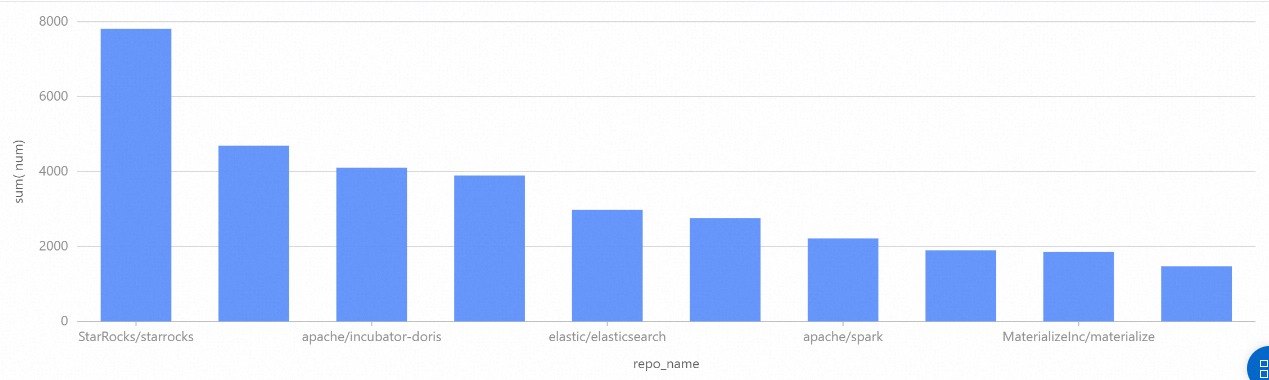
Quelles bases de données étaient les plus activement maintenues au premier semestre 2023 ?
Cette requête mesure l'activité en comptant les événements d'ouverture de pull requests, ce qui reflète le travail de développement en cours.
SET odps.namespace.schema = true;

SELECT
  repos.name AS repo_name,
  COUNT(dwd.id) AS num
FROM bigdata_public_dataset.github_events.dwd_github_events_odps dwd
JOIN bigdata_public_dataset.github_events.db_repos repos ON repos.id = dwd.repo_id
WHERE type = 'PullRequestEvent'
  AND ds >= '2023-01-01' AND ds <= '2023-06-30'
  AND action = 'opened'
GROUP BY repos.name
ORDER BY num DESC
LIMIT 10;
Résultat de l'analyse : StarRocks était le projet de base de données open source le plus activement maintenu au premier semestre 2023.
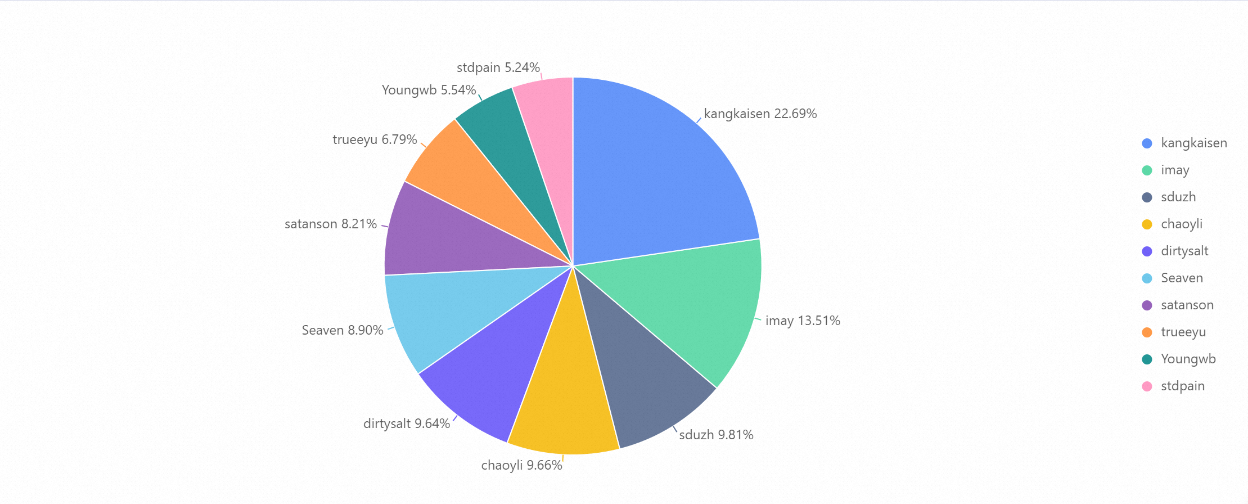
Qui étaient les principaux contributeurs individuels au projet de base de données le plus actif ?
Cette requête compte les événements de contribution — pull requests, issues, commentaires, reviews et pushes — par contributeur pour un référentiel et une plage de temps donnés.
SET odps.namespace.schema = true;

WITH a AS (
  SELECT
    repo_id,
    repo_name,
    actor_id,
    actor_login,
    COUNT(*) AS contribution,
    ds
  FROM bigdata_public_dataset.github_events.dwd_github_events_odps
  WHERE ds >= '2021-01-01' AND ds <= '2021-12-31'
    AND (
      (type = 'PullRequestEvent' AND action = 'opened')
      OR (type = 'IssuesEvent' AND action = 'opened')
      OR (type = 'IssueCommentEvent' AND action = 'created')
      OR (type = 'PullRequestReviewEvent' AND action = 'created')
      OR (type = 'PullRequestReviewCommentEvent' AND action = 'created')
      OR (type = 'PushEvent' AND action IS NULL)
    )
  GROUP BY repo_id, repo_name, actor_id, actor_login, ds
)
SELECT
  repo_name,
  actor_login,
  SUM(contribution) AS contribution
FROM a
WHERE repo_name = 'StarRocks/starrocks'
  AND actor_login NOT LIKE '%[bot]'
  AND actor_login NOT LIKE 'cockroach%'
GROUP BY repo_name, actor_login
ORDER BY contribution DESC
LIMIT 10;
Résultat de l'analyse : kangkaisen était le principal contributeur individuel au référentiel StarRocks/starrocks en 2021.
Langages de programmation
Ce groupe de requêtes utilise la table de référence programming_language_repos pour limiter les résultats aux projets de runtime et de compilateur de langages, répondant à des questions sur les tendances d'utilisation et de popularité.
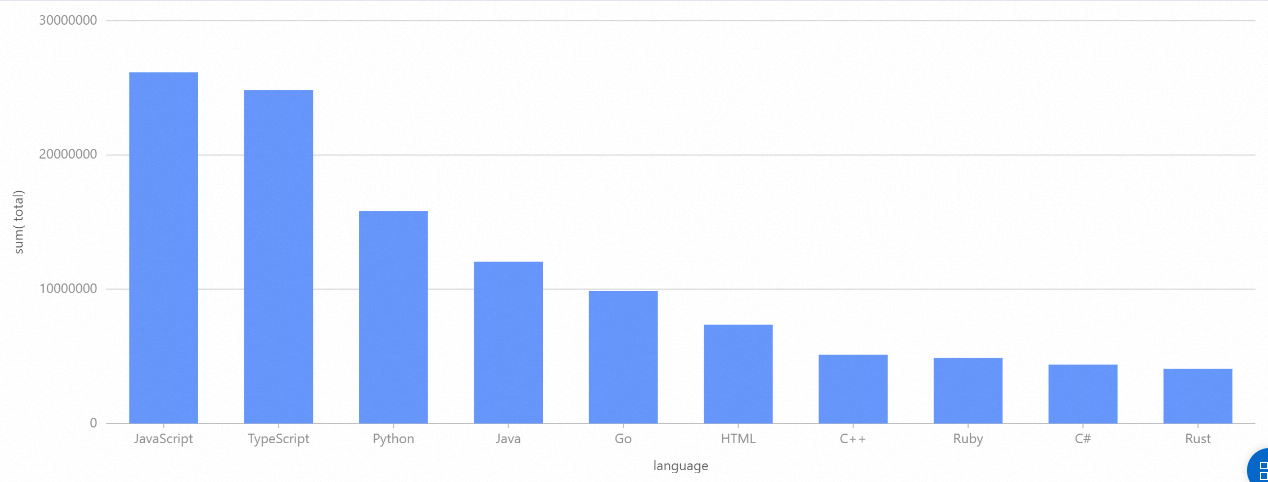
Quels étaient les 10 langages de programmation les plus utilisés au cours de l'année écoulée ?
SET odps.namespace.schema = true;

SELECT
  language,
  COUNT(*) AS total
FROM bigdata_public_dataset.github_events.dwd_github_events_odps
WHERE ds >= DATE_ADD(GETDATE(), -365)
  AND language IS NOT NULL
GROUP BY language
ORDER BY total DESC
LIMIT 10;
Résultat de l'analyse : JavaScript était le langage le plus utilisé, suivi de TypeScript et Python.
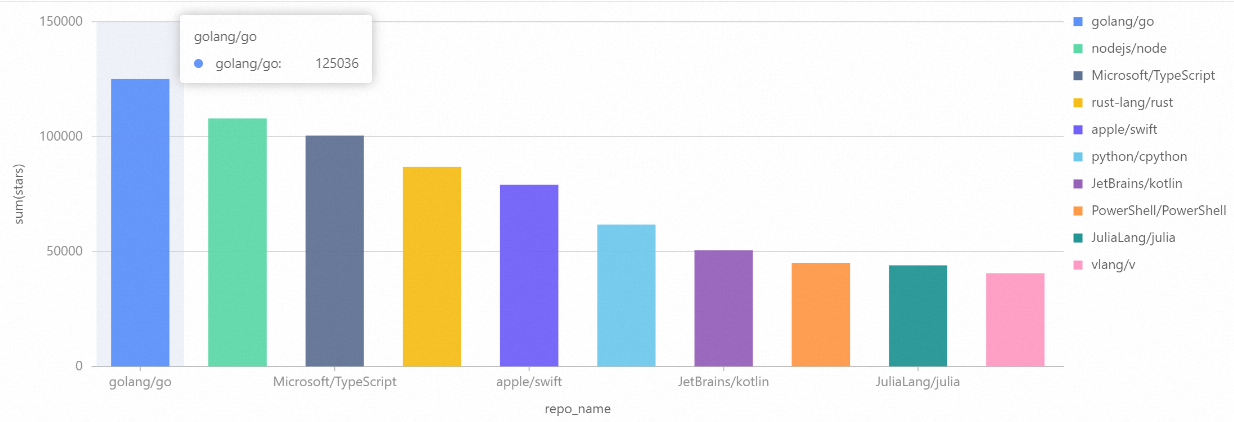
Quels projets de langages de programmation ont reçu le plus d'étoiles de 2018 à 2022 ?
SET odps.namespace.schema = TRUE;

SELECT
  dws.repo_id AS repo_id,
  repos.name AS repo_name,
  SUM(dws.stars) AS stars
FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month dws
JOIN bigdata_public_dataset.github_events.programming_language_repos repos ON dws.repo_id = repos.id
WHERE month >= '2015-01'
GROUP BY dws.repo_id, repos.name
ORDER BY stars DESC
LIMIT 10;
Résultat de l'analyse : Go était le projet de langage de programmation le plus populaire avec 81 642 étoiles, suivi de TypeScript et Node.
Comment les nombres cumulés d'étoiles pour les 10 principaux projets de langages ont-ils évolué mois par mois ?
SET odps.namespace.schema = true;
SET odps.sql.validate.orderby.limit = false;

WITH top_10_repos AS (
  SELECT
    dws.repo_id AS repo_id,
    repos.name AS repo_name,
    SUM(dws.stars) AS stars
  FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month dws
  JOIN bigdata_public_dataset.github_events.programming_language_repos repos ON dws.repo_id = repos.id
  WHERE month >= '2018-01' AND month <= '2022-12'
  GROUP BY dws.repo_id, repos.name
  ORDER BY stars DESC
  LIMIT 10
),
tmp AS (
  SELECT
    month,
    repo_id,
    stars,
    SUM(stars) OVER (PARTITION BY repo_id ORDER BY month ASC) AS total_stars
  FROM bigdata_public_dataset.github_events.dws_overview_by_repo_month
  WHERE month >= '2015-01' AND stars IS NOT NULL
    AND repo_id IN (SELECT repo_id FROM top_10_repos)
  GROUP BY repo_id, month, stars
  ORDER BY month ASC, repo_id
)
SELECT
  tmp.month AS month,
  top_10_repos.repo_name AS repo_name,
  tmp.total_stars AS total_stars
FROM tmp
JOIN top_10_repos ON top_10_repos.repo_id = tmp.repo_id
GROUP BY month, repo_name, total_stars
ORDER BY month ASC, repo_name;
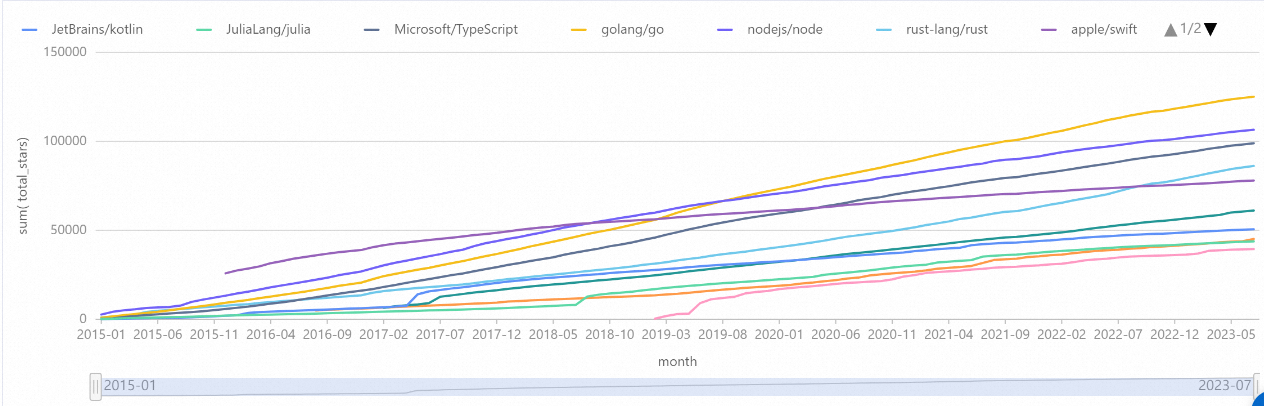
Résultat de l'analyse : Go a connu la croissance cumulative d'étoiles la plus rapide de tous les projets de langages de programmation sur la période de cinq ans.