Créez une solution d'analytique unifiée par lots et en temps réel à l'aide des données d'événements GitHub. MaxCompute sert d'entrepôt de données par lots, tandis que Realtime Compute for Apache Flink et Hologres constituent l'entrepôt de données en temps réel. Hologres et MaxCompute fournissent ensuite une couche unifiée pour l'analyse des données en temps réel et par lots.
Contexte
Avec la digitalisation croissante des entreprises, la demande pour des données plus récentes s'intensifie. Au-delà du traitement par lots traditionnel pour les données à grande échelle, de nombreuses entreprises exigent désormais le traitement, le stockage et l'analyse des données en temps réel. L'analytique unifiée par lots et en temps réel répond à ce besoin.
L'analytique unifiée par lots et en temps réel gère et traite les données en temps réel et par lots sur une seule plateforme, permettant une connexion fluide entre le traitement en temps réel et l'analytique par lots. Les principaux avantages incluent :
Amélioration de l'efficacité du traitement des données : l'intégration des données en temps réel et par lots sur une seule plateforme réduit les coûts de transfert et de conversion des données.
Amélioration de la précision de l'analytique : la combinaison des données en temps réel et par lots pour l'analyse améliore la précision de vos résultats.
Simplification de la gestion des données : une approche unifiée rationalise la gestion et le traitement des données.
Meilleur support décisionnel : exploitez pleinement vos données pour soutenir les décisions commerciales.
Alibaba Cloud propose une solution d'entrepôt de données simplifiée et unifiée pour les scénarios par lots et en temps réel. Cette solution utilise MaxCompute pour le traitement par lots et Hologres pour l'analytique en temps réel. Associées aux capacités de traitement en temps réel de Realtime Compute for Apache Flink, ces services forment le moteur principal de l'entrepôt de données unifié d'Alibaba Cloud.
Architecture de la solution
Le diagramme suivant illustre le pipeline complet pour l'analytique unifiée par lots et en temps réel sur le jeu de données public des événements GitHub à l'aide de MaxCompute et Hologres.
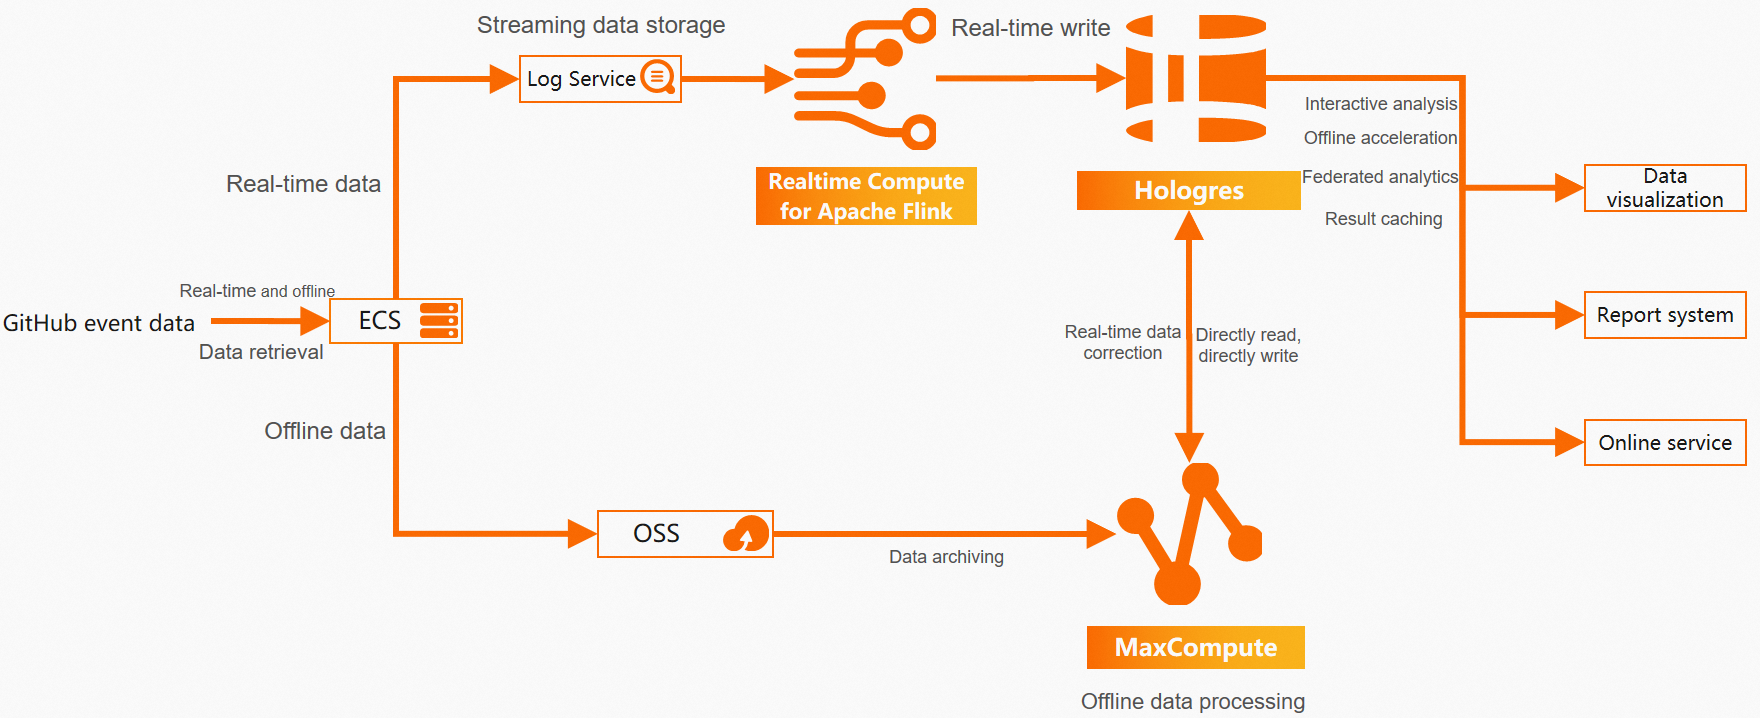
Dans cette architecture, une instance ECS collecte et agrège les données d'événements en temps réel et par lots provenant de GitHub en tant que source de données. Les données alimentent un pipeline en temps réel et un pipeline par lots, puis sont consolidées dans Hologres en tant que couche de service unifiée.
Pipeline en temps réel : Realtime Compute for Apache Flink traite les données de Simple Log Service (SLS) en temps réel et les écrit dans Hologres. Hologres prend en charge l'écriture et la mise à jour des données en temps réel, avec des données interrogeables immédiatement après leur ingestion. Leur intégration native permet le développement d'entrepôts de données en temps réel à haut débit, à faible latence et pilotés par modèle pour des cas d'utilisation tels que l'extraction des derniers événements et l'analyse des tendances.
Pipeline par lots : MaxCompute traite et archive des volumes massifs de données par lots. Object Storage Service (OSS) fournit un stockage pratique, sécurisé et peu coûteux pour les données JSON brutes. MaxCompute peut lire et analyser directement les données semi-structurées dans OSS via des tables externes, intégrer les données à haute valeur ajoutée dans son stockage interne et travailler avec DataWorks pour construire un entrepôt de données par lots.
Hologres est intégré de manière transparente à MaxCompute au niveau de la couche de stockage, ce qui vous permet d'accélérer les requêtes sur des volumes massifs de données historiques dans MaxCompute. Cela prend en charge les requêtes à faible fréquence et hautes performances sur les données historiques. Vous pouvez également utiliser le pipeline par lots pour corriger les données en temps réel et résoudre des problèmes tels que les omissions de données dans le pipeline en temps réel.
Cette solution offre les avantages suivants :
Pipeline par lots stable et efficace : prend en charge l'écriture et la mise à jour horaires des données, le traitement par lots à grande échelle, les calculs complexes et la réduction des coûts de calcul.
Pipeline en temps réel mature : prend en charge l'ingestion en temps réel, le calcul d'événements et l'analytique, offrant des réponses en quelques secondes.
Stockage et service unifiés : Hologres fournit une couche de service unifiée avec un stockage centralisé des données et une interface externe cohérente (une seule interface SQL pour les requêtes OLAP et clé-valeur).
Analytique unifiée par lots et en temps réel : réduit la redondance et le mouvement des données, et permet la correction des données.
Cette approche de développement tout-en-un permet une réponse des données à la seconde, une visibilité de bout en bout du statut, une architecture simplifiée avec moins de composants et une réduction des coûts d'O&M.
Compréhension de l'activité et des données
Les développeurs génèrent de nombreux événements lorsqu'ils travaillent sur des projets open source sur GitHub. GitHub enregistre les détails de chaque événement, y compris le type d'événement, le développeur et le dépôt de code. GitHub met à disposition des événements publics, tels que l'ajout d'une étoile à un dépôt ou la validation de code. Pour une liste complète des types d'événements, consultez Événements Webhook et charges utiles.
GitHub fournit des événements publics via une OpenAPI. L'API propose des données en temps réel avec un délai de cinq minutes. Pour plus d'informations, consultez Événements.
Le projet GH Archive collecte et fournit des archives horaires des événements publics GitHub. Utilisez ces archives pour obtenir des données hors ligne. Pour plus d'informations, consultez GH Archive.
Compréhension de l'activité GitHub
L'activité principale de GitHub consiste à gérer le code et les interactions. Elle implique trois entités principales : Developer, Repository et Organization.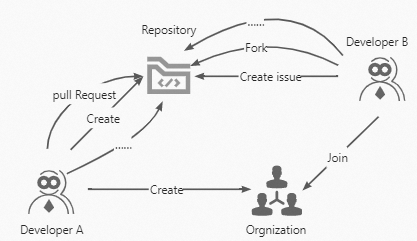
Pour cette analyse de données, un Event est également stocké et enregistré en tant qu'entité.
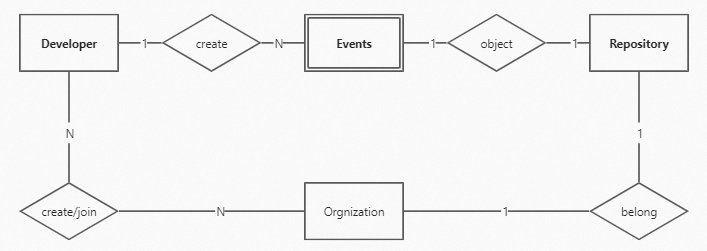
Compréhension des données brutes des événements publics
L'exemple suivant montre les données JSON d'un événement brut :
{
    "id": "19541192931",
    "type": "WatchEvent",
    "actor":
    {
        "id": 23286640,
        "login": "herekeo",
        "display_login": "herekeo",
        "gravatar_id": "",
        "url": "https://api.github.com/users/herekeo",
        "avatar_url": "https://avatars.githubusercontent.com/u/23286640?"
    },
    "repo":
    {
        "id": 52760178,
        "name": "crazyguitar/pysheeet",
        "url": "https://api.github.com/repos/crazyguitar/pysheeet"
    },
    "payload":
    {
        "action": "started"
    },
    "public": true,
    "created_at": "2022-01-01T00:03:04Z"
}
Cette analyse couvre 15 types d'événements publics. Elle n'inclut pas les événements qui ne se sont jamais produits ou qui ne sont plus enregistrés. Pour plus de détails sur ces types d'événements, consultez Types d'événements publics Github.
Prérequis
Une instance Elastic Compute Service (ECS) est créée et une adresse IP élastique (EIP) lui est associée. L'instance est utilisée pour extraire les données d'événements en temps réel de l'API GitHub. Pour plus d'informations, consultez Guide de création et Adresse IP élastique.
Object Storage Service (OSS) est activé et l'outil ossutil est installé sur l'instance ECS pour stocker les fichiers de données JSON provenant de GH Archive. Pour plus d'informations, consultez Activer OSS et Installer ossutil.
MaxCompute est activé et un projet est créé. Pour plus d'informations, consultez Créer un projet MaxCompute.
DataWorks est activé et un espace de travail est créé pour créer des tâches de planification hors ligne. Pour plus d'informations, consultez Créer un espace de travail.
Simple Log Service (SLS) est activé, et un projet et un Logstore sont créés pour collecter les données de l'instance ECS sous forme de journaux. Pour plus d'informations, consultez Collecter et analyser les journaux texte ECS à l'aide de LoongCollector.
Une instance Realtime Compute for Apache Flink est activée pour écrire les données de journal de SLS vers Hologres en temps réel. Pour plus d'informations, consultez Activer Realtime Compute for Apache Flink.
Hologres est activé. Pour plus d'informations, consultez Acheter une instance Hologres.
Construire un entrepôt de données hors ligne (mises à jour horaires)
Télécharger les fichiers de données brutes à l'aide d'une instance ECS et les télécharger vers OSS
Utilisez une instance Elastic Compute Service (ECS) pour télécharger les fichiers de données JSON depuis GH Archive.
Téléchargez les données historiques à l'aide de la commande
wget. Par exemple, exécutezwget https://data.gharchive.org/{2012..2022}-{01..12}-{01..31}-{0..23}.json.gzpour télécharger les données horaires de 2012 à 2022.-
Pour télécharger les nouvelles données générées chaque heure, configurez une tâche planifiée horaire comme suit.
RemarqueAssurez-vous qu'ossutil est installé sur l'instance ECS. Pour plus d'informations, consultez Installer ossutil. Téléchargez le package d'installation d'ossutil et téléchargez-le sur l'instance ECS. Exécutez
yum install unzippour installer le logiciel unzip. Ensuite, décompressez le package ossutil et déplacez le fichier exécutable vers le répertoire/usr/bin/.Assurez-vous d'avoir créé un bucket Object Storage Service (OSS) dans la même région que votre instance ECS. Vous pouvez utiliser un nom de bucket personnalisé. Cet exemple utilise le nom de bucket
githubevents.Dans cet exemple, les fichiers sont téléchargés dans le répertoire
/opt/hourlydata/gh_datasur l'instance ECS. Vous pouvez utiliser un répertoire différent.
-
Exécutez la commande suivante pour créer un fichier nommé
download_code.shdans le répertoire/opt/hourlydata.cd /opt/hourlydata vim download_code.sh -
Appuyez sur
ipour entrer en mode édition et ajoutez le script suivant.d=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%-H') h=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%H') url=https://data.gharchive.org/${d}.json.gz echo ${url} # Download the data to the ./gh_data/ directory. You can use a different directory. wget ${url} -P ./gh_data/ # Change to the gh_data directory. cd gh_data # Decompress the downloaded data into a JSON file. gzip -d ${d}.json echo ${d}.json # Change to the root directory. cd /root # Use ossutil to upload the data to OSS. # Create the hr=${h} directory in the githubevents OSS bucket. ossutil mkdir oss://githubevents/hr=${h} # Upload the data from the /opt/hourlydata/gh_data directory to OSS. You can use a different directory. ossutil cp -r /opt/hourlydata/gh_data oss://githubevents/hr=${h} -u echo oss uploaded successfully! rm -rf /opt/hourlydata/gh_data/${d}.json echo ecs deleted! Appuyez sur la touche Esc, saisissez
:wqet appuyez sur Entrée pour enregistrer et fermer le fichier.-
Exécutez la commande suivante pour exécuter le script
download_code.shà 10 minutes passées de chaque heure.# 1. Run the following command and press I to enter edit mode. crontab -e # 2. Add the following command. Then, press Esc, enter :wq, and press Enter to exit. 10 * * * * cd /opt/hourlydata && sh download_code.sh > download.logAprès l'exécution du script, le fichier JSON de l'heure précédente est téléchargé à 10 minutes passées de chaque heure. Le fichier est ensuite décompressé sur l'instance ECS et téléchargé vers OSS au chemin
oss://githubevents. Pour lire uniquement le fichier de l'heure précédente, un répertoire nommé'hr=%Y-%M-%D-%H'est créé en tant que partition pour chaque fichier lors du téléchargement. Cela garantit que les opérations d'écriture de données ultérieures lisent les fichiers uniquement à partir de la dernière partition.
Importer les données OSS dans MaxCompute à l'aide d'une table externe
Exécutez les commandes suivantes dans le client MaxCompute ou dans un nœud ODPS SQL dans DataWorks. Pour plus d'informations, consultez Se connecter à MaxCompute à l'aide du client (odpscmd) ou Développer une tâche ODPS SQL.
-
Créez la table externe
githubeventspour lire les fichiers JSON stockés dans OSS :CREATE EXTERNAL TABLE IF NOT EXISTS githubevents ( col STRING ) PARTITIONED BY ( hr STRING ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/githubevents/' ;Pour plus d'informations sur la création de tables externes pour accéder aux données OSS dans MaxCompute, consultez Accéder aux données non structurées dans OSS.
-
Créez la table de faits
dwd_github_events_odpspour stocker les données. Le code suivant montre l'instruction Data Definition Language (DDL) :CREATE TABLE IF NOT EXISTS dwd_github_events_odps ( id BIGINT COMMENT 'Event ID' ,actor_id BIGINT COMMENT 'ID of the event initiator' ,actor_login STRING COMMENT 'Logon name of the event initiator' ,repo_id BIGINT COMMENT 'Repository ID' ,repo_name STRING COMMENT 'Full name of the repository in the format of owner/repository_name' ,org_id BIGINT COMMENT 'ID of the organization to which the repository belongs' ,org_login STRING COMMENT 'Name of the organization to which the repository belongs' ,`type` STRING COMMENT 'Event type' ,created_at DATETIME COMMENT 'Time when the event occurred' ,action STRING COMMENT 'Event action' ,iss_or_pr_id BIGINT COMMENT 'ID of the issue or pull request' ,number BIGINT COMMENT 'Number of the issue or pull request' ,comment_id BIGINT COMMENT 'Comment ID' ,commit_id STRING COMMENT 'Commit ID' ,member_id BIGINT COMMENT 'Member ID' ,rev_or_push_or_rel_id BIGINT COMMENT 'ID of the review, push, or release' ,ref STRING COMMENT 'Name of the created or deleted resource' ,ref_type STRING COMMENT 'Type of the created or deleted resource' ,state STRING COMMENT 'Status of the issue, pull request, or pull request review' ,author_association STRING COMMENT 'Relationship between the actor and the repository' ,language STRING COMMENT 'Language of the code in the pull request' ,merged BOOLEAN COMMENT 'Indicates whether the pull request was merged' ,merged_at DATETIME COMMENT 'Time when the code was merged' ,additions BIGINT COMMENT 'Number of added lines of code' ,deletions BIGINT COMMENT 'Number of deleted lines of code' ,changed_files BIGINT COMMENT 'Number of files changed in the pull request' ,push_size BIGINT COMMENT 'Number of commits' ,push_distinct_size BIGINT COMMENT 'Number of distinct commits' ,hr STRING COMMENT 'Hour when the event occurred. For example, if the event occurred at 00:23, the value of hr is 00.' ,`month` STRING COMMENT 'Month when the event occurred. For example, if the event occurred in October 2015, the value of month is 2015-10.' ,`year` STRING COMMENT 'Year when the event occurred. For example, if the event occurred in 2015, the value of year is 2015.' ) PARTITIONED BY ( ds STRING COMMENT 'Date when the event occurred, in the yyyy-mm-dd format.' ); -
Analysez les données JSON et écrivez-les dans la table de faits.
Exécutez la commande suivante pour ajouter des partitions, analyser les données JSON et écrire les données dans la table
dwd_github_events_odps:msck repair table githubevents add partitions; set odps.sql.hive.compatible = true; set odps.sql.split.hive.bridge = true; INSERT into TABLE dwd_github_events_odps PARTITION(ds) SELECT CAST(GET_JSON_OBJECT(col,'$.id') AS BIGINT ) AS id ,CAST(GET_JSON_OBJECT(col,'$.actor.id')AS BIGINT) AS actor_id ,GET_JSON_OBJECT(col,'$.actor.login') AS actor_login ,CAST(GET_JSON_OBJECT(col,'$.repo.id')AS BIGINT) AS repo_id ,GET_JSON_OBJECT(col,'$.repo.name') AS repo_name ,CAST(GET_JSON_OBJECT(col,'$.org.id')AS BIGINT) AS org_id ,GET_JSON_OBJECT(col,'$.org.login') AS org_login ,GET_JSON_OBJECT(col,'$.type') as type ,to_date(GET_JSON_OBJECT(col,'$.created_at'), 'yyyy-mm-ddThh:mi:ssZ') AS created_at ,GET_JSON_OBJECT(col,'$.payload.action') AS action ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.id')AS BIGINT) END AS iss_or_pr_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.number')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.number')AS BIGINT) ELSE CAST(GET_JSON_OBJECT(col,'$.payload.number')AS BIGINT) END AS number ,CAST(GET_JSON_OBJECT(col,'$.payload.comment.id')AS BIGINT) AS comment_id ,GET_JSON_OBJECT(col,'$.payload.comment.commit_id') AS commit_id ,CAST(GET_JSON_OBJECT(col,'$.payload.member.id')AS BIGINT) AS member_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.review.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="PushEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.push_id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="ReleaseEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.release.id')AS BIGINT) END AS rev_or_push_or_rel_id ,GET_JSON_OBJECT(col,'$.payload.ref') AS ref ,GET_JSON_OBJECT(col,'$.payload.ref_type') AS ref_type ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.state') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.state') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.state') END AS state ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssueCommentEvent" THEN GET_JSON_OBJECT(col,'$.payload.comment.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.author_association') END AS author_association ,GET_JSON_OBJECT(col,'$.payload.pull_request.base.repo.language') AS language ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.merged') AS BOOLEAN) AS merged ,to_date(GET_JSON_OBJECT(col,'$.payload.pull_request.merged_at'), 'yyyy-mm-ddThh:mi:ssZ') AS merged_at ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.additions')AS BIGINT) AS additions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.deletions')AS BIGINT) AS deletions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.changed_files')AS BIGINT) AS changed_files ,CAST(GET_JSON_OBJECT(col,'$.payload.size')AS BIGINT) AS push_size ,CAST(GET_JSON_OBJECT(col,'$.payload.distinct_size')AS BIGINT) AS push_distinct_size ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),12,2) as hr ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,7),'/','-') as month ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,4) as year ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,10),'/','-') as ds from githubevents where hr = cast(to_char(dateadd(getdate(),-9,'hh'), 'yyyy-mm-dd-hh') as string); -
Interrogez les données.
Exécutez la commande suivante pour interroger les données de la table
dwd_github_events_odps:SET odps.sql.allow.fullscan=true; SELECT * FROM dwd_github_events_odps where ds = '2023-03-31' limit 10;Le résultat d'exemple suivant est renvoyé :
Le résultat contient les champs suivants :
id: ID de l'événementactor_id/actor_login: ID utilisateur et nom d'utilisateurrepo_id/repo_name: ID du dépôt et nom du dépôtorg_id/org_login: ID de l'organisation et nom de l'organisation (vide pour certains événements)type: Type d'événement, tel que CreateEvent, PushEvent, DeleteEvent, PullRequestReviewEventcreated_at: Heure de créationaction: Type d'action
Construire un entrepôt de données en temps réel
Obtenir des données en temps réel à l'aide d'ECS
Une instance Elastic Compute Service (ECS) est utilisée pour extraire les données d'événements en temps réel de l'API GitHub. Le script d'exemple suivant montre comment collecter des données en temps réel à partir de l'API GitHub.
Chaque fois que le script s'exécute, il fonctionne pendant 1 minute. Il collecte les données d'événements en temps réel fournies par l'API pendant cette période et stocke chaque événement au format JSON.
Ce script ne garantit pas que toutes les données d'événements en temps réel sont collectées.
Pour collecter continuellement des données à partir de l'API GitHub, fournissez les en-têtes Accept et Authorization. La valeur de Accept est fixe. Pour Authorization, saisissez le jeton d'accès personnel que vous avez obtenu auprès de GitHub. Pour plus d'informations sur la création d'un jeton d'accès personnel, consultez cette documentation.
-
Exécutez les commandes suivantes pour créer un fichier nommé
download_realtime_data.pydans le répertoire/opt/realtime.cd /opt/realtime vim download_realtime_data.py -
Appuyez sur
ipour entrer en mode édition et ajoutez le contenu d'exemple suivant au fichier.#!python import requests import json import sys import time # Get the API URL def get_next_link(resp): resp_link = resp.headers['link'] link = '' for l in resp_link.split(', '): link = l.split('; ')[0][1:-1] rel = l.split('; ')[1] if rel == 'rel="next"': return link return None # Collect one page of data from the API def download(link, fname): # Define the Accept and Authorization headers for the GitHub API headers = {"Accept": "application/vnd.github+json","Authorization": "<Bearer> <github_api_token>"} resp = requests.get(link, headers=headers) if int(resp.status_code) != 200: return None with open(fname, 'a') as f: for j in resp.json(): f.write(json.dumps(j)) f.write('\n') print('downloaded {} events to {}'.format(len(resp.json()), fname)) return resp # Collect multiple pages of data from the API def download_all_data(fname): link = 'https://api.github.com/events?per_page=100&page=1' while True: resp = download(link, fname) if resp is None: break link = get_next_link(resp) if link is None: break # Define the current time def get_current_ms(): return round(time.time()*1000) # Define the script execution duration as 1 minute def main(fname): current_ms = get_current_ms() while get_current_ms() - current_ms < 60*1000: download_all_data(fname) time.sleep(0.1) # Run the script if __name__ == '__main__': if len(sys.argv) < 2: print('usage: python {} <log_file>'.format(sys.argv[0])) exit(0) main(sys.argv[1]) -
Appuyez sur la touche Esc, saisissez
:wq, puis appuyez sur Entrée pour enregistrer et fermer le fichier. -
Créez un fichier
run_py.shafin d'exécuterdownload_realtime_data.pyet de stocker séparément les données collectées lors de chaque exécution. Le contenu est le suivant :python /opt/realtime/download_realtime_data.py /opt/realtime/gh_realtime_data/$(date '+%Y-%m-%d-%H:%M:%S').json -
Créez un fichier
delete_log.shpour supprimer les données historiques. Le contenu est le suivant :d=$(TZ=UTC date --date='2 day ago' '+%Y-%m-%d') rm -f /opt/realtime/gh_realtime_data/*${d}*.json -
Exécutez les commandes suivantes pour collecter les données GitHub toutes les minutes et supprimer les données historiques chaque jour.
#1. Run the following command and press I to enter edit mode.
crontab -e

#2. Add the following commands. Then, press Esc, enter :wq, and press Enter to exit.
* * * * * bash /opt/realtime/run_py.sh
1 1 * * * bash /opt/realtime/delete_log.sh
Collecte des données ECS à l'aide de SLS
Simple Log Service (SLS) collecte les données d'événements en temps réel provenant de l'instance ECS sous forme de journaux.
SLS prend en charge la collecte des journaux depuis les instances ECS via Logtail. Étant donné que les données sont au format JSON, vous pouvez utiliser le mode JSON de Logtail pour collecter rapidement les journaux JSON incrémentiels depuis l'instance ECS. Pour plus d'informations, consultez Collecte de journaux en mode JSON. Dans cette rubrique, SLS est configuré pour analyser les paires clé-valeur de premier niveau des données brutes.
Dans cet exemple, le paramètre de chemin d'accès aux journaux pour la configuration Logtail est défini sur /opt/realtime/gh_realtime_data/**/*.json.
Une fois la configuration terminée, SLS collecte en continu les données d'événements incrémentielles depuis l'instance ECS. Vous pouvez consulter les données de journal collectées dans l'onglet Raw Logs de la console SLS. Chaque entrée de journal contient des champs de premier niveau analysés, tels que actor, created_at, id, org, payload, public, repo et type.
Écriture des données SLS dans Hologres en temps réel à l'aide de Flink
Flink écrit les données de journal collectées par SLS dans Hologres en temps réel. En utilisant une table source SLS et une table de résultats Hologres dans Flink, vous pouvez diffuser les données de SLS vers Hologres. Pour plus d'informations, consultez Importation de données depuis Simple Log Service.
-
Créez une table interne Hologres.
La table interne ne conserve que certaines paires clé-valeur des données JSON brutes. L'ID d'événement
idet la datedssont définis comme clé primaire. L'ID d'événementidest défini comme clé de distribution. La datedsest définie comme clé de partition. L'heure de l'événementcreated_atest définie commeevent_time_column. Vous pouvez créer des index pour d'autres champs selon vos besoins. Pour plus d'informations sur les index, consultez CREATE TABLE. L'instruction DDL suivante est utilisée pour créer la table dans cet exemple.DROP TABLE IF EXISTS gh_realtime_data; BEGIN; CREATE TABLE gh_realtime_data ( id bigint, actor_id bigint, actor_login text, repo_id bigint, repo_name text, org_id bigint, org_login text, type text, created_at timestamp with time zone NOT NULL, action text, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id text, member_id bigint, rev_or_push_or_rel_id bigint, ref text, ref_type text, state text, author_association text, language text, merged boolean, merged_at timestamp with time zone, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr text, month text, year text, ds text, PRIMARY KEY (id,ds) ) PARTITION BY LIST (ds); CALL set_table_property('public.gh_realtime_data', 'distribution_key', 'id'); CALL set_table_property('public.gh_realtime_data', 'event_time_column', 'created_at'); CALL set_table_property('public.gh_realtime_data', 'clustering_key', 'created_at'); COMMENT ON COLUMN public.gh_realtime_data.id IS 'Event ID'; COMMENT ON COLUMN public.gh_realtime_data.actor_id IS 'ID of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.actor_login IS 'Logon name of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.repo_id IS 'repo ID'; COMMENT ON COLUMN public.gh_realtime_data.repo_name IS 'repo name'; COMMENT ON COLUMN public.gh_realtime_data.org_id IS 'ID of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.org_login IS 'Name of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.type IS 'Event type'; COMMENT ON COLUMN public.gh_realtime_data.created_at IS 'Time when the event occurred'; COMMENT ON COLUMN public.gh_realtime_data.action IS 'Event action'; COMMENT ON COLUMN public.gh_realtime_data.iss_or_pr_id IS 'issue/pull_request ID'; COMMENT ON COLUMN public.gh_realtime_data.number IS 'issue/pull_request number'; COMMENT ON COLUMN public.gh_realtime_data.comment_id IS 'comment ID'; COMMENT ON COLUMN public.gh_realtime_data.commit_id IS 'Commit ID'; COMMENT ON COLUMN public.gh_realtime_data.member_id IS 'Member ID'; COMMENT ON COLUMN public.gh_realtime_data.rev_or_push_or_rel_id IS 'review/push/release ID'; COMMENT ON COLUMN public.gh_realtime_data.ref IS 'Name of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.ref_type IS 'Type of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.state IS 'Status of the issue/pull_request/pull_request_review'; COMMENT ON COLUMN public.gh_realtime_data.author_association IS 'Relationship between the actor and the repo'; COMMENT ON COLUMN public.gh_realtime_data.language IS 'Programming language'; COMMENT ON COLUMN public.gh_realtime_data.merged IS 'Specifies whether the merge is accepted'; COMMENT ON COLUMN public.gh_realtime_data.merged_at IS 'Time when the code was merged'; COMMENT ON COLUMN public.gh_realtime_data.additions IS 'Number of added lines of code'; COMMENT ON COLUMN public.gh_realtime_data.deletions IS 'Number of deleted lines of code'; COMMENT ON COLUMN public.gh_realtime_data.changed_files IS 'Number of files changed in the pull request'; COMMENT ON COLUMN public.gh_realtime_data.push_size IS 'Number of pushes'; COMMENT ON COLUMN public.gh_realtime_data.push_distinct_size IS 'Number of distinct pushes'; COMMENT ON COLUMN public.gh_realtime_data.hr IS 'The hour when the event occurred. For example, if the time is 00:23, hr=00.'; COMMENT ON COLUMN public.gh_realtime_data.month IS 'The month when the event occurred. For example, if the date is October 2015, month=2015-10.'; COMMENT ON COLUMN public.gh_realtime_data.year IS 'The year when the event occurred. For example, if the year is 2015, year=2015.'; COMMENT ON COLUMN public.gh_realtime_data.ds IS 'The day when the event occurred. ds=yyyy-mm-dd.'; COMMIT; -
Écrivez les données en temps réel à l'aide de Flink.
Utilisez Flink pour analyser les données SLS et les écrire dans Hologres en temps réel. Les instructions Flink suivantes filtrent les données : les données erronées dont l'ID d'événement ou l'heure de l'événement (
created_at) est nul sont ignorées, et seules les données d'événements récentes sont conservées.CREATE TEMPORARY TABLE sls_input ( actor varchar, created_at varchar, id bigint, org varchar, payload varchar, public varchar, repo varchar, type varchar ) WITH ( 'connector' = 'sls', 'endpoint' = '<endpoint>',--The private endpoint of SLS 'accessid' = '<accesskey id>',--The AccessKey ID of your account 'accesskey' = '<accesskey secret>',--The AccessKey secret of your account 'project' = '<project name>',--The name of the SLS project 'logstore' = '<logstore name>'--The name of the SLS Logstore 'starttime' = '2023-04-06 00:00:00',--The start time for SLS data collection ); CREATE TEMPORARY TABLE hologres_sink ( id bigint, actor_id bigint, actor_login string, repo_id bigint, repo_name string, org_id bigint, org_login string, type string, created_at timestamp, action string, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id string, member_id bigint, rev_or_push_or_rel_id bigint, `ref` string, ref_type string, state string, author_association string, `language` string, merged boolean, merged_at timestamp, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr string, `month` string, `year` string, ds string ) WITH ( 'connector' = 'hologres', 'dbname' = '<hologres dbname>', --The name of the Hologres database 'tablename' = '<hologres tablename>', --The name of the Hologres table that receives data 'username' = '<accesskey id>', --The AccessKey ID of the current Alibaba Cloud account 'password' = '<accesskey secret>', --The AccessKey Secret of the current Alibaba Cloud account 'endpoint' = '<endpoint>', --The VPC endpoint of the current Hologres instance 'jdbcretrycount' = '1', --The number of retries upon connection failure 'partitionrouter' = 'true', --Specifies whether to write data to a partitioned table 'createparttable' = 'true', --Specifies whether to automatically create partitions 'mutatetype' = 'insertorignore' --The data writing mode ); INSERT INTO hologres_sink SELECT id ,CAST(JSON_VALUE(actor, '$.id') AS bigint) AS actor_id ,JSON_VALUE(actor, '$.login') AS actor_login ,CAST(JSON_VALUE(repo, '$.id') AS bigint) AS repo_id ,JSON_VALUE(repo, '$.name') AS repo_name ,CAST(JSON_VALUE(org, '$.id') AS bigint) AS org_id ,JSON_VALUE(org, '$.login') AS org_login ,type ,TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS created_at ,JSON_VALUE(payload, '$.action') AS action ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.id') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.id') AS bigint) END AS iss_or_pr_id ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.number') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.number') AS bigint) ELSE CAST(JSON_VALUE(payload, '$.number') AS bigint) END AS number ,CAST(JSON_VALUE(payload, '$.comment.id') AS bigint) AS comment_id ,JSON_VALUE(payload, '$.comment.commit_id') AS commit_id ,CAST(JSON_VALUE(payload, '$.member.id') AS bigint) AS member_id ,CASE WHEN type='PullRequestReviewEvent' THEN CAST(JSON_VALUE(payload, '$.review.id') AS bigint) WHEN type='PushEvent' THEN CAST(JSON_VALUE(payload, '$.push_id') AS bigint) WHEN type='ReleaseEvent' THEN CAST(JSON_VALUE(payload, '$.release.id') AS bigint) END AS rev_or_push_or_rel_id ,JSON_VALUE(payload, '$.ref') AS `ref` ,JSON_VALUE(payload, '$.ref_type') AS ref_type ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.state') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.state') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.state') END AS state ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.author_association') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.author_association') WHEN type='IssueCommentEvent' THEN JSON_VALUE(payload, '$.comment.author_association') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.author_association') END AS author_association ,JSON_VALUE(payload, '$.pull_request.base.repo.language') AS `language` ,CAST(JSON_VALUE(payload, '$.pull_request.merged') AS boolean) AS merged ,TO_TIMESTAMP_TZ(replace(JSON_VALUE(payload, '$.pull_request.merged_at'),'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS merged_at ,CAST(JSON_VALUE(payload, '$.pull_request.additions') AS bigint) AS additions ,CAST(JSON_VALUE(payload, '$.pull_request.deletions') AS bigint) AS deletions ,CAST(JSON_VALUE(payload, '$.pull_request.changed_files') AS bigint) AS changed_files ,CAST(JSON_VALUE(payload, '$.size') AS bigint) AS push_size ,CAST(JSON_VALUE(payload, '$.distinct_size') AS bigint) AS push_distinct_size ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),12,2) as hr ,REPLACE(SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,7),'/','-') as `month` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,4) as `year` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,10) as ds FROM sls_input WHERE id IS NOT NULL AND created_at IS NOT NULL AND to_date(replace(created_at,'T',' ')) >= date_add(CURRENT_DATE, -1);Pour plus d'informations sur les paramètres, consultez Simple Log Service (SLS) et Hologres.
RemarqueLes données d'événements brutes de GitHub utilisent le fuseau horaire UTC et ne possèdent pas d'attribut de fuseau horaire. Le fuseau horaire par défaut de Hologres est UTC+8. Par conséquent, ajustez le fuseau horaire lors de l'écriture des données de Flink vers Hologres en temps réel. Attribuez l'attribut de fuseau horaire UTC aux données de la table source dans Flink SQL. Procédez comme suit :
Étape 1 : Accédez à la page d'édition du job
Connectez-vous à la console Realtime Compute for Apache Flink.
Accédez à l'espace de travail cible.
Recherchez votre job Flink SQL ou JAR et cliquez sur Edit.
Étape 2 : Ouvrez l'onglet Deployment Details
⚠️ Modification clé : « Flink Configuration » n'est plus une section distincte. Elle est fusionnée avec « Deployment Details ».
En haut de la page d'édition du job, basculez vers l'onglet Deployment Details.
Faites défiler vers le bas jusqu'à la section Parameter Configuration.
Étape 3 : Ajoutez une configuration personnalisée
Cliquez sur le bouton Edit à droite de Parameter Configuration.
Dans la boîte de dialogue qui s'affiche, repérez la zone de texte Other Configuration.
Dans la zone de texte, ajoutez le paramètre Flink
table.local-time-zone:Asia/Shanghaien tant que paire clé-valeur pour définir le fuseau horaire du système Flink surAsia/Shanghai.
-
Interrogez les données.
Interrogez les données SLS écrites dans Hologres via Flink, puis effectuez le développement des données selon vos besoins.
SELECT * FROM public.gh_realtime_data limit 10;Le résultat de la requête renvoie les champs suivants :
idactor_idactor_loginrepo_idrepo_nameorg_idorg_logintype(type d'événement, tel que PullRequestReviewEvent, CreateEvent, PushEvent, PullRequestEvent)created_atactioniss_or_pr_id
Correction des données en temps réel à l'aide des données hors ligne
Dans ce scénario, il peut manquer des données en temps réel. Vous pouvez utiliser les données hors ligne pour corriger les données en temps réel. Les étapes suivantes montrent comment corriger les données en temps réel de la veille. Ajustez la période de correction selon vos besoins.
-
Créez une table externe dans Hologres pour obtenir les données hors ligne MaxCompute.
IMPORT FOREIGN SCHEMA <maxcompute_project_name> LIMIT to
(
    <foreign_table_name>
)
FROM SERVER odps_server INTO public OPTIONS(if_table_exist 'update',if_unsupported_type 'error');
Pour plus d'informations sur les paramètres, consultez IMPORT FOREIGN SCHEMA.
-
Créez une table temporaire pour corriger les données en temps réel de la veille avec les données hors ligne.
RemarqueHologres V2.1.17 et versions ultérieures prennent en charge Serverless Computing. Pour des scénarios tels que l'importation de données hors ligne à grande échelle, les jobs ETL volumineux et les requêtes à fort volume sur des tables externes, vous pouvez utiliser Serverless Computing pour exécuter ces tâches. Cette fonctionnalité utilise des ressources serverless supplémentaires au lieu des ressources de votre instance, ce qui améliore la stabilité de l'instance et réduit la probabilité d'erreurs de mémoire insuffisante (OOM). Vous n'avez pas besoin de réserver des ressources de calcul supplémentaires pour votre instance et vous n'êtes facturé que pour les tâches que vous exécutez. Pour plus d'informations sur Serverless Computing, consultez Serverless Computing. Pour savoir comment utiliser Serverless Computing, consultez Utilisation de Serverless Computing.
-- Clean up potential temporary tables
DROP TABLE IF EXISTS gh_realtime_data_tmp;

-- Create a temporary table
SET hg_experimental_enable_create_table_like_properties = ON;
CALL HG_CREATE_TABLE_LIKE ('gh_realtime_data_tmp', 'select * from gh_realtime_data');

-- (Optional) Use Serverless Computing to perform large-scale offline data import and ETL jobs.
SET hg_computing_resource = 'serverless';

-- Insert data into the temporary table and update statistics
INSERT INTO gh_realtime_data_tmp
SELECT
    *
FROM
    <foreign_table_name>
WHERE
    ds = current_date - interval '1 day'
ON CONFLICT (id, ds)
    DO NOTHING;
ANALYZE gh_realtime_data_tmp;

-- Reset the configuration to ensure that non-essential SQL statements do not use Serverless resources.
RESET hg_computing_resource;

-- Replace the atomic table with the existing temporary child table
BEGIN;
DROP TABLE IF EXISTS "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data_tmp RENAME TO "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data ATTACH PARTITION "gh_realtime_data_<yesterday_date>" FOR VALUES IN ('<yesterday_date>');
COMMIT;
Analyse des données
Vous pouvez effectuer une large gamme d'analyses sur les données collectées. Selon la plage temporelle requise par votre activité, concevez votre entrepôt de données en couches pour prendre en charge l'analyse en temps réel, l'analyse hors ligne et l'analyse intégrée en temps réel et hors ligne.
Les exemples suivants analysent les données en temps réel. Vous pouvez également analyser les données pour des référentiels de code ou des développeurs spécifiques.
-
Interrogez le nombre total d'événements publics pour aujourd'hui.
SELECT
    count(*)
FROM
    gh_realtime_data
WHERE
    created_at >= date_trunc('day', now());
Voici un exemple de résultat :
count ------ 1006 -
Interrogez les projets les plus actifs (avec le plus d'événements) au cours de la dernière journée.
SELECT
    repo_name,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
GROUP BY
    repo_name
ORDER BY
    events DESC
LIMIT 5;
Voici un exemple de résultat :
repo_name events ----------------------------------------+------ leo424y/heysiri.ml 29 arm-on/plan 10 Christoffel-T/fiverr-pat-20230331 9 mate-academy/react_dynamic-list-of-goods 9 openvinotoolkit/openvino 7 -
Interrogez les développeurs les plus actifs (avec le plus d'événements) au cours de la dernière journée.
SELECT
    actor_login,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
    AND actor_login NOT LIKE '%[bot]'
GROUP BY
    actor_login
ORDER BY
    events DESC
LIMIT 5;
Voici un exemple de résultat :
actor_login events ------------------+------ direwolf-github 13 arm-on 10 sergii-nosachenko 9 Christoffel-T 9 yangwang201911 7 -
Interrogez le classement des langages de programmation les plus populaires au cours de la dernière heure.
SELECT
    language,
    count(*) total
FROM
    gh_realtime_data
WHERE
    created_at > now() - interval '1 hour'
    AND language IS NOT NULL
GROUP BY
    language
ORDER BY
    total DESC
LIMIT 10;
Voici un exemple de résultat :
language total -----------+---- JavaScript 25 C++ 15 Python 14 TypeScript 13 Java 8 PHP 8 -
Interrogez le classement des projets par nombre d'étoiles reçues au cours de la dernière journée.
RemarqueCet exemple ne tient pas compte des cas où les utilisateurs retirent leur étoile d'un projet.
SELECT
    repo_id,
    repo_name,
    COUNT(actor_login) total
FROM
    gh_realtime_data
WHERE
    type = 'WatchEvent'
    AND created_at > now() - interval '1 day'
GROUP BY
    repo_id,
    repo_name
ORDER BY
    total DESC
LIMIT 10;
Voici un exemple de résultat :
repo_id repo_name total ---------+----------------------------------+----- 618058471 facebookresearch/segment-anything 4 619959033 nomic-ai/gpt4all 1 97249406 denysdovhan/wtfjs 1 9791525 digininja/DVWA 1 168118422 aylei/interview 1 343520006 joehillen/sysz 1 162279822 agalwood/Motrix 1 577723410 huggingface/swift-coreml-diffusers 1 609539715 e2b-dev/e2b 1 254839429 maniackk/KKCallStack 1 -
Interrogez les utilisateurs et projets actifs quotidiens pour aujourd'hui.
SELECT
    uniq (actor_id) actor_num,
    uniq (repo_id) repo_num
FROM
    gh_realtime_data
WHERE
    created_at > date_trunc('day', now());
Voici un exemple de résultat :
actor_num	repo_num
---------+--------
743	      816