Cette rubrique explique comment créer, lire et écrire des données dans des tables externes Parquet stockées dans Object Storage Service (OSS).
Périmètre
Les tables externes OSS ne prennent pas en charge la propriété cluster.
La taille d'un fichier unique ne peut pas dépasser 2 Go. Vous devez fractionner les fichiers dont la taille est supérieure à 2 Go.
MaxCompute et OSS doivent se trouver dans la même région.
Description des autorisations
Lorsque vous accédez aux tables externes OSS, les données sont consultées via le rôle spécifié dans le paramètre
odps.properties.rolearn, que vous utilisiez un compte Alibaba Cloud, un utilisateur RAM ou un rôle RAM. Par conséquent, vous devez créer un rôle RAM, lui accorder les autorisations nécessaires pour accéder au bucket OSS cible, puis configurer l'ARN de ce rôle dans le paramètreodps.properties.rolearn. Pour plus d'informations, consultez la section Paramètres.Vous pouvez autoriser l'accès au sein d'un même compte ou entre différents comptes selon vos besoins métier. Nous vous recommandons d'utiliser une politique d'autorisation personnalisée pour un contrôle d'accès plus granulaire. Pour plus d'informations, consultez la section Autorisation pour les sources de données externes.
Créer une table externe
Syntaxe
Lorsque le schéma du fichier Parquet diffère de celui de la table externe :
Nombre de colonnes différent : si le fichier Parquet contient moins de colonnes que défini dans la DDL de la table externe, les colonnes manquantes renvoient la valeur NULL. Si le fichier contient plus de colonnes, les colonnes supplémentaires sont ignorées.
Type de colonne différent : si le type d'une colonne dans le fichier Parquet ne correspond pas au type correspondant défini dans la DDL, l'opération de lecture échoue. Par exemple, une erreur telle que
ODPS-0123131:User defined function exception - Traceback:xxxest signalée si vous tentez de lire une colonne INT en tant que champ STRING.
Syntaxe simplifiée
CREATE EXTERNAL TABLE [IF NOT EXISTS] <mc_oss_extable_name>
(
  <col_name> <data_type>,
  ...
)
[COMMENT <table_comment>]
[PARTITIONED BY (<col_name> <data_type>, ...)]
STORED AS parquet
LOCATION '<oss_location>'
[tblproperties ('<tbproperty_name>'='<tbproperty_value>',...)];
Syntaxe détaillée
CREATE EXTERNAL TABLE [IF NOT EXISTS] <mc_oss_extable_name>
(
  <col_name> <data_type>,
  ...
)
[COMMENT <table_comment>]
[PARTITIONED BY (<col_name> <data_type>, ...)]
ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'
WITH serdeproperties(
    'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>',
    'mcfed.parquet.compression'='ZSTD/SNAPPY/GZIP'
)
STORED AS parquet
LOCATION '<oss_location>'
;
Paramètres courants
Pour plus d'informations sur les paramètres courants, consultez la section Paramètres de syntaxe de base.
Paramètres spécifiques
Paramètres with serdeproperties
property_name | Cas d'utilisation | Description | property_value | Valeur par défaut |
mcfed.parquet.compression | Ajoutez cette propriété pour écrire des données Parquet compressées dans OSS. | Propriété de compression Parquet. Les données Parquet ne sont pas compressées par défaut. |
| Aucune |
mcfed.parquet.compression.codec.zstd.level | Ajoutez cette propriété lorsque | Un niveau supérieur augmente le taux de compression. Toutefois, les tests montrent que les niveaux élevés offrent des gains minimes en termes de réduction de la taille des données tout en augmentant considérablement le temps et la consommation de ressources. Pour les scénarios de big data, un niveau ZSTD faible (3 à 5) offre le meilleur équilibre entre performances et compression. Exemple : | La valeur peut aller de 1 à 22. | 3 |
parquet.file.cache.size | Ajoutez cette propriété pour améliorer les performances de lecture des fichiers de données OSS lors du traitement des données Parquet. | Spécifie la quantité de données pouvant être mise en cache lors de la lecture des fichiers de données OSS. Unité : Ko. | 1024 | Aucune |
parquet.io.buffer.size | Ajoutez cette propriété pour améliorer les performances de lecture des fichiers de données OSS lors du traitement des données Parquet. | Spécifie la quantité de données pouvant être mise en cache lorsque la taille du fichier de données OSS dépasse 1024 Ko. Unité : Ko. | 4096 | Aucune |
Paramètres tblproperties
property_name | Cas d'utilisation | Description | property_value | Valeur par défaut |
io.compression.codecs | Ajoutez cette propriété si vos fichiers de données OSS sont au format Raw-Snappy. | Active l'analyseur open source intégré pour le format SNAPPY. Si vous définissez ce paramètre sur True, MaxCompute peut lire les données compressées. Sinon, l'opération de lecture échoue. | com.aliyun.odps.io.compress.SnappyRawCodec. | Aucune |
odps.external.data.output.prefix (Compatible avec odps.external.data.prefix) | Ajoutez cette propriété pour spécifier un préfixe personnalisé pour les fichiers de sortie. |
| Une combinaison valide de caractères, par exemple 'mc_'. | Aucune |
odps.external.data.enable.extension | Ajoutez cette propriété pour afficher l'extension des fichiers de sortie. | Définissez la valeur sur True pour afficher l'extension du fichier. Sinon, l'extension est masquée. |
| False |
odps.external.data.output.suffix | Ajoutez cette propriété pour spécifier un suffixe personnalisé pour les fichiers de sortie. | Doit contenir uniquement des lettres, des chiffres et des traits de soulignement (a-z, A-Z, 0-9, _). | Une combinaison valide de caractères, par exemple '_hangzhou'. | Aucune |
odps.external.data.output.explicit.extension | Ajoutez cette propriété pour spécifier une extension personnalisée pour les fichiers de sortie. |
| Une combinaison valide de caractères, par exemple "jsonl". | Aucune |
odps.ext.column.mapping | Ajoutez cette propriété lorsque les noms de champs dans les fichiers de données OSS contiennent des caractères spéciaux. | Cette propriété définit des mappages de noms de colonnes personnalisés. Par exemple, si les champs du fichier OSS sont id BIGINT, $_test DOUBLE et =name STRING, définissez la valeur du paramètre sur t_test:$_test,t_name:=_name lors de la création de la table externe. Vous devez uniquement spécifier les mappages pour les champs contenant des caractères spéciaux. | Aucune valeur fixe | Aucune |
odps.ext.column.mapping.delimiters (À utiliser uniquement lorsque les caractères des noms de colonnes entrent en conflit avec les délimiteurs par défaut dans les mappages de noms de colonnes. Généralement non recommandé.) | Ajoutez cette propriété lorsque les noms de colonnes contiennent les caractères spéciaux | Cette propriété personnalise les délimiteurs intra-groupe et inter-groupe pour les paires clé-valeur. La valeur doit contenir exactement deux caractères : le premier caractère sert de délimiteur clé-valeur, et le second caractère sert de délimiteur entre les différentes paires clé-valeur. | Aucune valeur fixe. Exemple : | Valeur par défaut :
|
mcfed.parquet.compression | Ajoutez cette propriété pour écrire des données Parquet compressées dans OSS. Aucun paramètre supplémentaire n'est nécessaire pour lire les fichiers compressés. | Propriété de compression Parquet. Les données Parquet ne sont pas compressées par défaut. |
| Aucune |
mcfed.parquet.block.size | Contrôle la taille des blocs des fichiers Parquet, ce qui affecte l'efficacité du stockage et les performances de lecture. | Propriété de réglage Parquet. Définit la taille du bloc Parquet en octets. | Entier non négatif | 134217728 (128 Mo) |
mcfed.parquet.block.row.count.limit | Lors de l'écriture de données dans une table externe Parquet, limite le nombre d'enregistrements dans chaque groupe de lignes pour éviter les erreurs de mémoire insuffisante (OOM). | Propriété de réglage Parquet. Contrôle le nombre maximal d'enregistrements par groupe de lignes. Si une erreur OOM se produit, réduisez la valeur de ce paramètre. Suggestion :
| Entier non négatif | 2147483647 (Integer.MAX_VALUE) |
mcfed.parquet.page.size.row.check.min | Lors de l'écriture de données dans une table externe Parquet, contrôle la fréquence des vérifications de mémoire pour éviter les erreurs OOM. | Propriété de réglage Parquet. Limite le nombre minimal d'enregistrements entre les vérifications de mémoire. Si une erreur OOM se produit, réduisez la valeur de ce paramètre. | Entier non négatif | 100 |
mcfed.parquet.page.size.row.check.max | Lors de l'écriture de données dans une table externe Parquet, contrôle la fréquence des vérifications de mémoire pour éviter les erreurs OOM. | Propriété de réglage Parquet. Limite le nombre minimal d'enregistrements entre les vérifications de mémoire. Si une erreur OOM se produit, réduisez la valeur de ce paramètre. Étant donné que des vérifications fréquentes de la mémoire ajoutent une surcharge, l'ajustement de ce paramètre peut affecter les performances. Recommandations relatives aux paramètres :
| Entier non négatif | 1000 |
mcfed.parquet.compression.codec.zstd.level | Ajoutez cette propriété pour spécifier le niveau de compression de l'algorithme ZSTD lors de l'écriture de données Parquet dans OSS avec compression ZSTD. | Propriété de compression Parquet. Spécifie le niveau de compression de l'algorithme ZSTD. La valeur peut aller de 1 à 22. | Entier non négatif | 3 |
Liste d'autorisation et liste de blocage
Les tables externes OSS de MaxCompute prennent en charge le filtrage via liste d'autorisation et liste de blocage. En définissant les paramètres de liste d'autorisation et de liste de blocage dans tblproperties, vous pouvez filtrer les fichiers à lire depuis un répertoire. Pour plus de détails, consultez la section Liste d'autorisation et liste de blocage.
Écrire des données
Pour plus de détails sur la syntaxe d'écriture dans MaxCompute, consultez la section Syntaxe d'écriture.
Requête et analyse
Consultez la section Syntaxe des requêtes pour plus de détails sur la syntaxe SELECT.
Reportez-vous à la section Optimisation des requêtes pour obtenir des informations sur l'optimisation des plans de requête.
Pour en savoir plus sur la lecture directe des fichiers LOCATION, consultez la rubrique Requête sans schéma.
-
Optimisation des requêtes : les tables externes Parquet prennent en charge l'optimisation des requêtes via l'activation du Predicate Push Down (PPD). Pour connaître les résultats en termes de performances, reportez-vous à la section Prise en charge du Predicate Push Down (Parquet PPD).
Ajoutez les paramètres suivants avant votre instruction SQL pour activer le PPD :
-- PPD parameters must be used in Native mode, which means the Native switch must be set to true.
-- Enable the Parquet native reader.
SET odps.ext.parquet.native = true;
-- Enable Parquet PPD.
SET odps.sql.parquet.use.predicate.pushdown = true;
Prise en charge du Predicate Push Down (Parquet PPD)
Par défaut, les tables externes Parquet ne prennent pas en charge le Predicate Push Down (PPD). Lorsque vous exécutez une requête avec une condition de filtre WHERE, MaxCompute analyse l'intégralité des données. Cela entraîne des opérations d'E/S inutiles, une consommation de ressources accrue et une latence de requête plus élevée. Pour résoudre ce problème, vous pouvez activer le PPD à l'aide d'un paramètre. Cette fonctionnalité utilise les métadonnées des fichiers Parquet pour filtrer les données au niveau du groupe de lignes lors de la phase d'analyse, ce qui améliore les performances des requêtes et réduit la consommation de ressources ainsi que les coûts.
Utilisation
-
Activer le Predicate Push Down (PPD)
Avant d'exécuter une requête SQL, utilisez la commande
setpour définir les deux paramètres suivants au niveau de la session afin d'activer le PPD Parquet.-- Enable the Parquet native reader. set odps.ext.parquet.native = true; -- Enable Parquet PPD. set odps.sql.parquet.use.predicate.pushdown = true; -
Exemple
Cet exemple utilise un jeu de données de test TPC-DS de 1 To et la table externe Parquet
tpcds_1t_store_sales. Dans cet exemple, le PPD est activé et une requête avec filtre est exécutée. Le volume total de données s'élève à2 879 987 999lignes.-- Create the external table tpcds_1t_store_sales. CREATE EXTERNAL TABLE IF NOT EXISTS tpcds_1t_store_sales ( ss_sold_date_sk BIGINT, ss_sold_time_sk BIGINT, ss_item_sk BIGINT, ss_customer_sk BIGINT, ss_cdemo_sk BIGINT, ss_hdemo_sk BIGINT, ss_addr_sk BIGINT, ss_store_sk BIGINT, ss_promo_sk BIGINT, ss_ticket_number BIGINT, ss_quantity BIGINT, ss_wholesale_cost DECIMAL(7,2), ss_list_price DECIMAL(7,2), ss_sales_price DECIMAL(7,2), ss_ext_discount_amt DECIMAL(7,2), ss_ext_sales_price DECIMAL(7,2), ss_ext_wholesale_cost DECIMAL(7,2), ss_ext_list_price DECIMAL(7,2), ss_ext_tax DECIMAL(7,2), ss_coupon_amt DECIMAL(7,2), ss_net_paid DECIMAL(7,2), ss_net_paid_inc_tax DECIMAL(7,2), ss_net_profit DECIMAL(7,2) ) ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe' WITH serdeproperties( 'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>', 'mcfed.parquet.compression'='zstd' ) STORED AS parquet LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss_bucket_path/'; -- Use the 1 TB TPC-DS test dataset. INSERT OVERWRITE TABLE tpcds_1t_store_sales SELECT ss_sold_date_sk, ss_sold_time_sk, ss_item_sk, ss_customer_sk, ss_cdemo_sk, ss_hdemo_sk, ss_addr_sk, ss_store_sk, ss_promo_sk, ss_ticket_number, ss_quantity, ss_wholesale_cost, ss_list_price, ss_sales_price, ss_ext_discount_amt, ss_ext_sales_price, ss_ext_wholesale_cost, ss_ext_list_price, ss_ext_tax, ss_coupon_amt, ss_net_paid, ss_net_paid_inc_tax, ss_net_profit FROM bigdata_public_dataset.tpcds_1t.store_sales; -- Run the query. SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales WHERE ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;
Comparaison des performances
L'activation du PPD réduit la quantité de données analysées, ce qui diminue la latence des requêtes et la consommation de ressources.
|
Mode |
Nombre total de lignes dans la table |
Lignes analysées |
Octets analysés |
Durée du mapper |
Consommation totale de ressources |
Description |
|
Table externe Parquet sans PPD |
2 879 987 999 |
2 879 987 999 (100 %) |
19 386 793 984 (100 %) |
18 s |
CPU 19,25 cœur-minute, mémoire 24,07 Go-minute 100 % |
|
|
Table externe Parquet avec PPD |
2 879 987 999 |
762 366 649 (26,47 %) |
3 339 386 880 (17,22 %) |
12 s |
cpu 11,47 cœur × min, mémoire 14,33 Go × min ~59,58 % |
La réduction significative du volume de données analysées permet de diminuer la latence et la consommation de ressources. |
|
Table interne avec PPD |
2 879 987 999 |
32 830 000 (1,14 %) |
1 633 880 386 (8,43 %) |
9 s |
cpu 5,62 cœur × min, mémoire 7,02 Go × min ~29,19 % |
Le PPD est plus efficace sur les tables internes car les données sont triées. |
Détails des tests
-
Table externe Parquet sans PPD
SET odps.ext.parquet.native = true;
SET odps.sql.parquet.use.predicate.pushdown = false;
SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;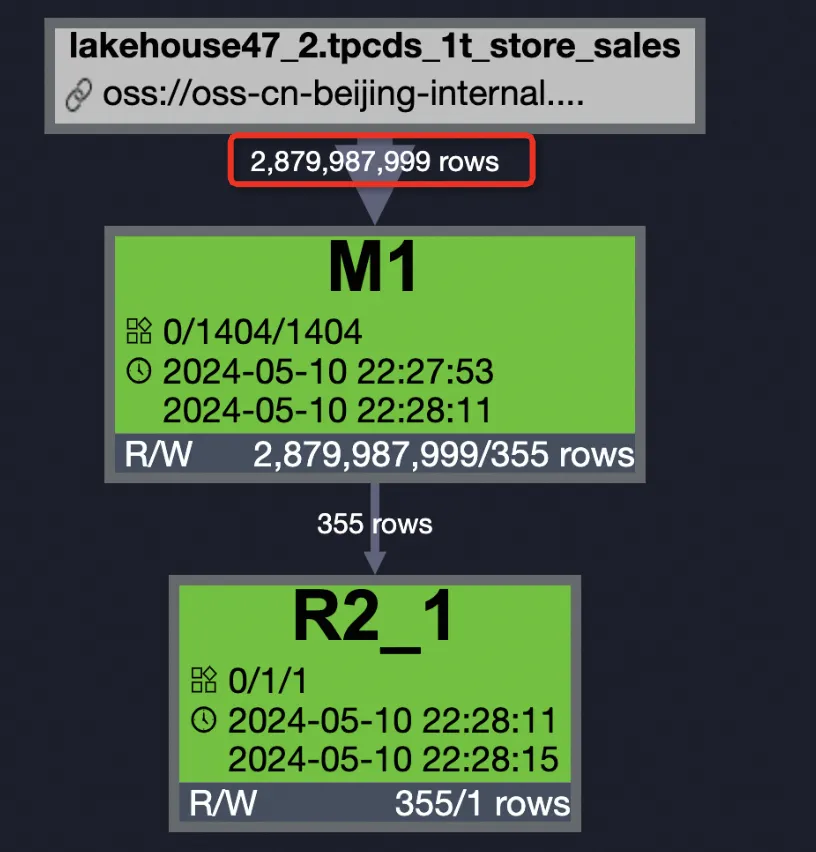
Les résultats indiquent que pour la tâche M1 dans Fuxi Jobs, IO Records Input est de 2,9 G, IO Bytes Input est de 18,06 Go et Latency est de 00:00:18.000.
L'onglet Summary des résultats d'exécution montre que la consommation de ressources est de cpu
19,25 Core × Minet de mémoire24,07 GB × Min. La durée d'exécution du job est de23,000secondes et le mode d'exécution estfuxi job 2.0. La tâche M1 compte 1 404 instances, une durée d'exécution de18,000secondes, 2 879 987 999 enregistrements en entrée et 355 enregistrements en sortie. La tâche R2_1 compte 1 instance, une durée d'exécution de4,000secondes et 1 enregistrement en sortie. -
Table externe Parquet avec PPD
SET odps.ext.parquet.native = true;
SET odps.sql.parquet.use.predicate.pushdown = true;
SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;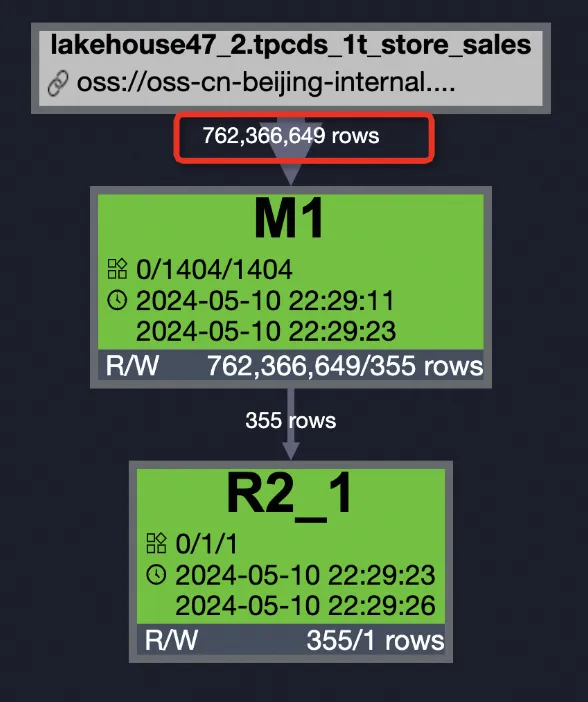
Après l'exécution de cette requête, le résumé du job indique que la consommation de ressources est de
cpu 11,47 Core × Min, memory 14,33 GB × Min, avec une durée totale d'exécution de 15 secondes. L'étape M1 comprend 1 404 instances, une durée d'exécution de 12 secondes et 762 366 649 enregistrements en entrée (environ 3 339 386 880 octets). L'étape R2_1 compte 1 instance et une durée d'exécution de 3 secondes.De nombreux mappeurs sont vides et n'ont pas besoin de lire de données :
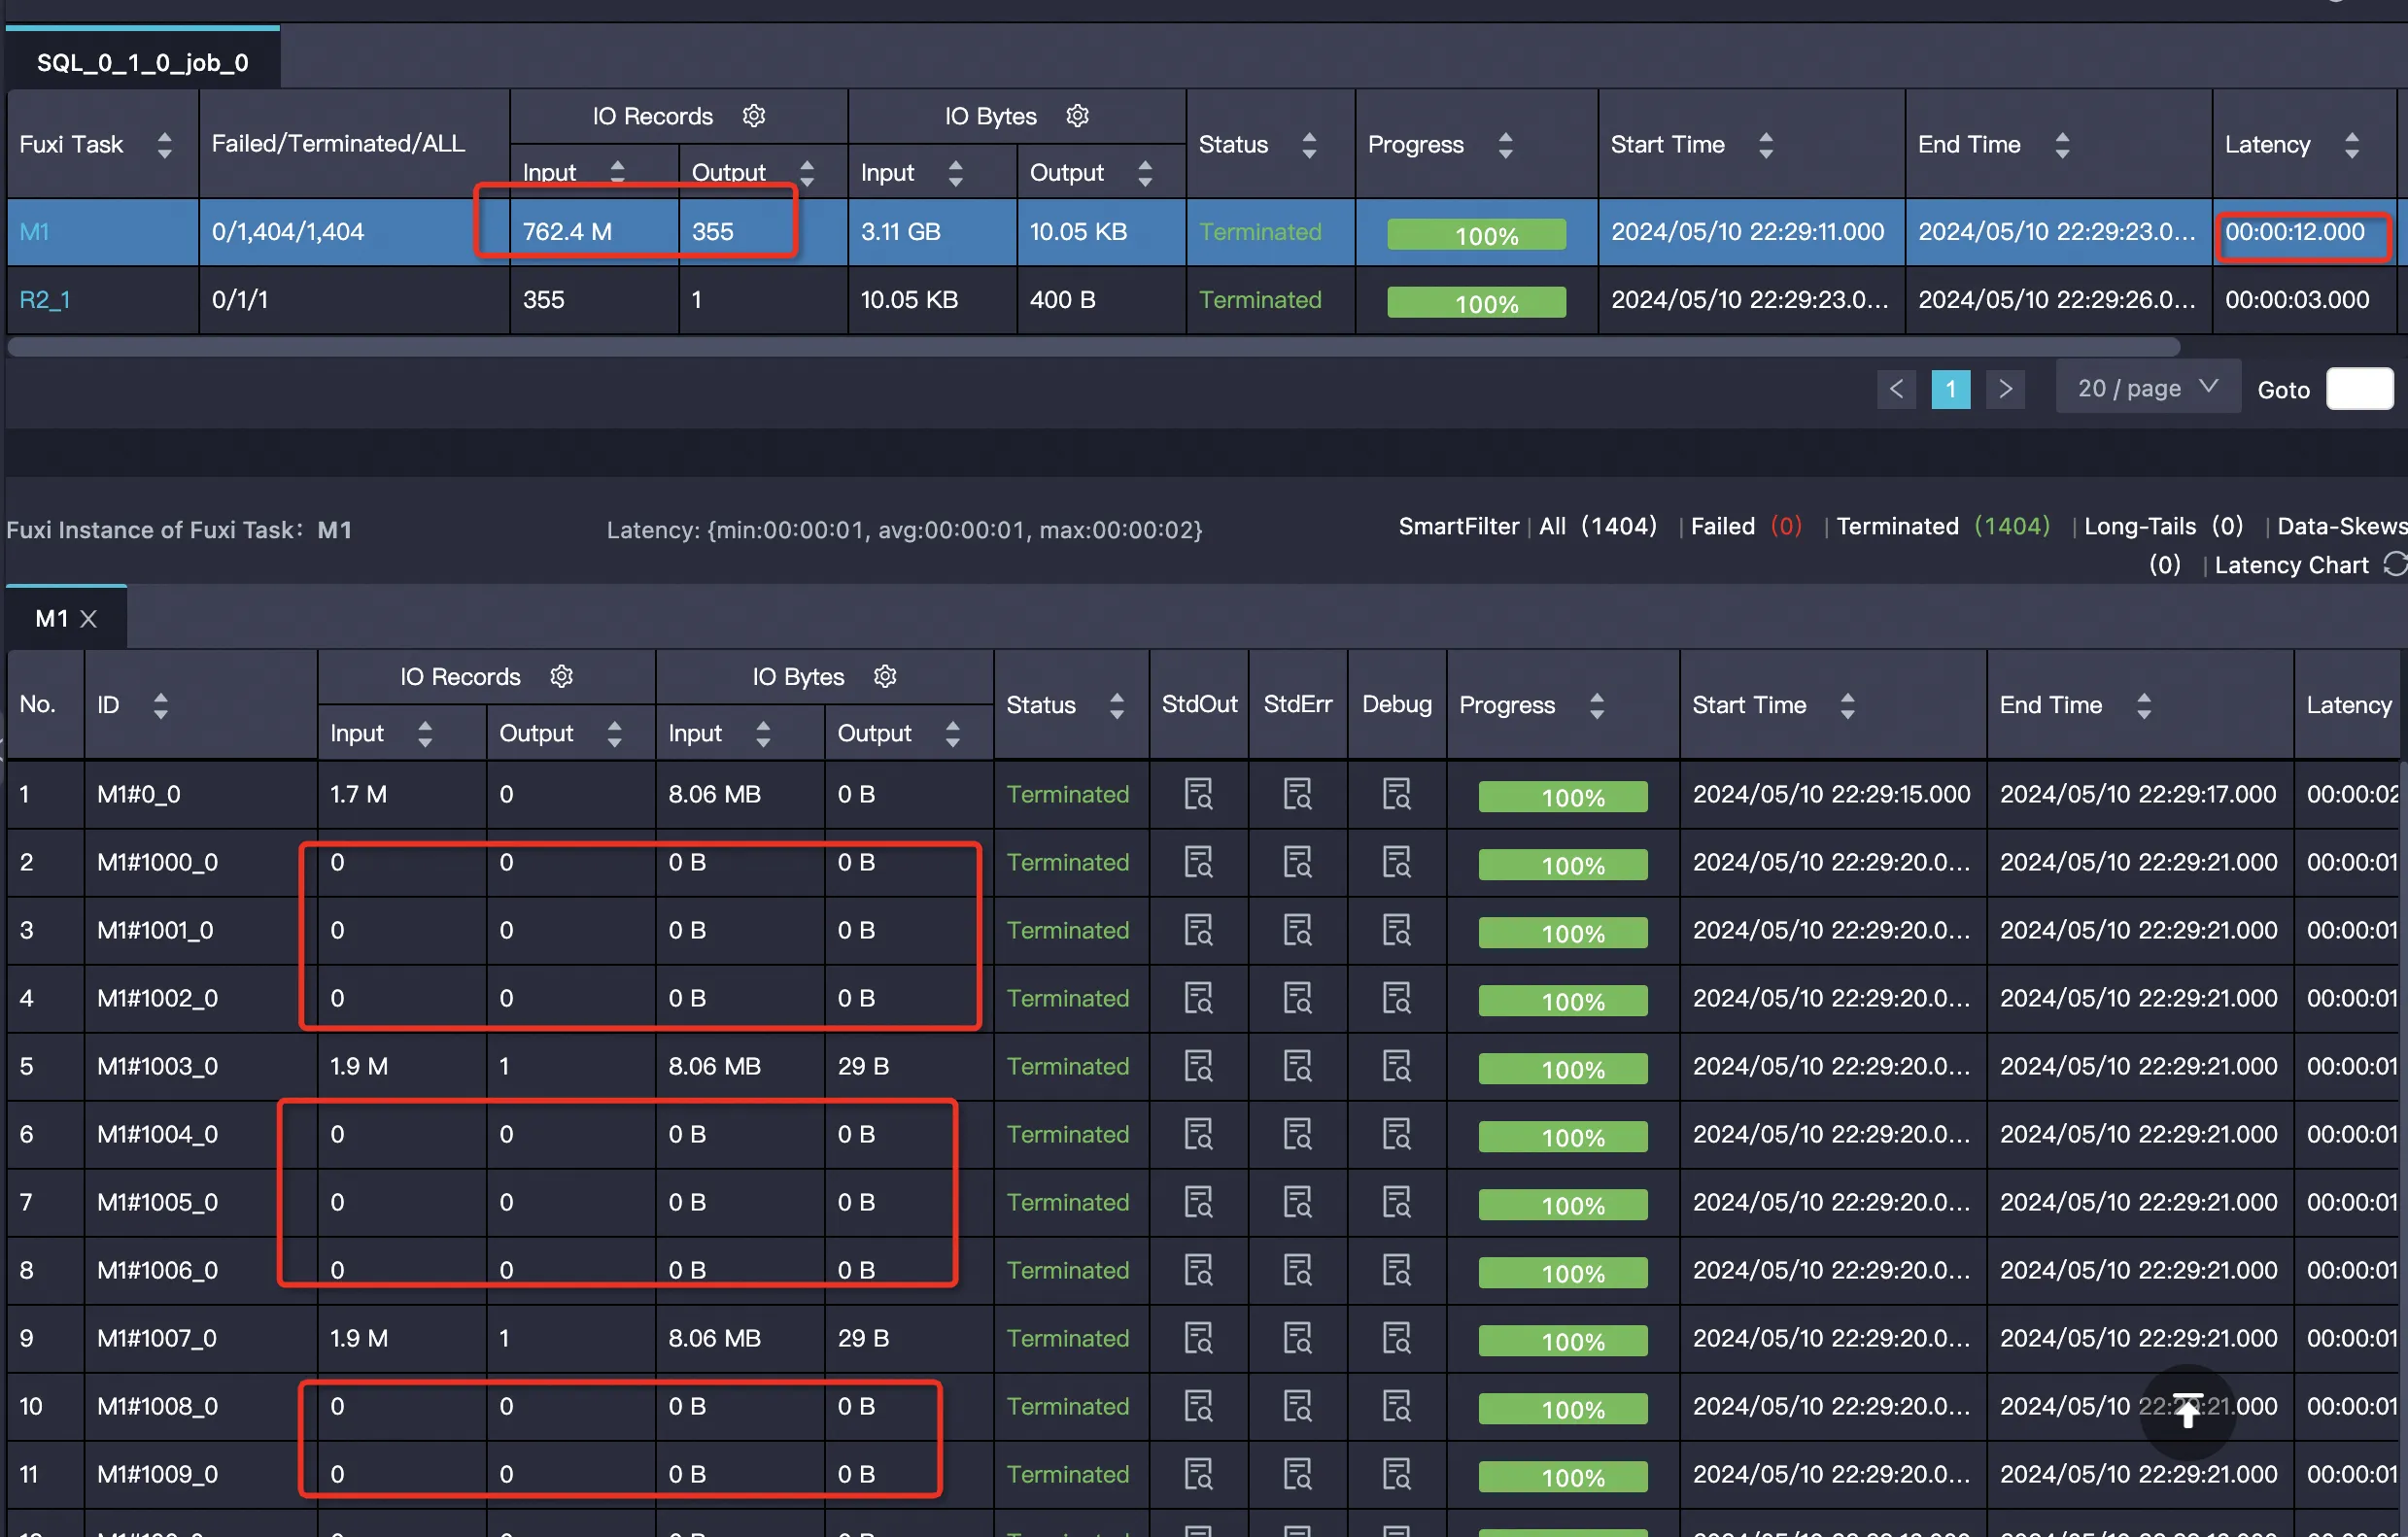
Journal du découpage réel des groupes de lignes :
[2024-05-10 22:29:22.692182] [INFO] [239551] [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70 16/common/table/file_formats/parquet/parquet_row_group_pruner.cpp:100] The expression to prune row groups:(((ss_store_s k == 2:int64) and (ss_sold_date_sk >= 2451871:int64)) and (ss_sold_date_sk <= 2451880:int64)) [2024-05-10 22:29:22.705508] [INFO] [239551] [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70 16/common/table/file_formats/parquet/parquet_reader_factory.cpp:136] Parquet row group pruning is enabled, millisecon ds elapsed:13 Total row group count:1 Pruned row group count:1 The first several row group indexes: [2024-05-10 22:29:22.705532] [INFO] [239551] [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70 16/common/table/file_formats/parquet/parquet_reader_factory.cpp:60] total feasible parquet row group count:0] -
Table interne avec PPD
L'effet de découpage est plus significatif car les données de la table interne sont triées.
SELECT SUM(ss_sold_date_sk) FROM bigdata_public_dataset.tpcds_1t.store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;
Après l'exécution de cette requête, le DAG du job indique que le nombre total de lignes dans la source de données est de 2 879 987 999, mais que le nombre réel de lignes analysées n'est que de 32 830 000. L'étape M1 (703 instances) lit 32 830 000 lignes et produit 323 lignes en sortie. L'étape R2_1 reçoit 323 lignes et produit 1 ligne en sortie. Cela démontre que l'effet de découpage est important lorsque le PPD est activé pour une table interne dont les données sont triées.
La surveillance Fuxi Jobs montre que le job
SQL_0_1_0_job_0est terminé. Il comprend deux tâches Fuxi, M1 et R2_1, toutes deux ayant le statut Terminated. M1 compte 703 instances, une entrée de 32,8 M d'enregistrements (1,52 Go), une sortie de 323 enregistrements et une latence de 00:00:09.375. R2_1 compte 1 instance, une entrée de 323 enregistrements, une sortie de 1 enregistrement et une latence de 00:00:03.873. Les détails des instances M1 révèlent 4 instances présentant un déséquilibre de données (Data-Skew). Des instances telles queM1#101_0,M1#103_0etM1#105_0affichent 0 pour l'entrée et la sortie. Cela indique qu'il s'agit d'instances de test à vide (dry-run) et que cette requête présente un problème de déséquilibre de données.resource cost: cpu 5.62 Core * Min, memory 7.02 GB * Min inputs: lakehouse47_2.default.tpcds_1t_store_sales2: 32830000 (1633880386 bytes) outputs: Job run time: 14.000 Job run mode: fuxi job 2.0 Job run engine: execution engine M1: instance count: 703 run time: 9.000 instance time: min: 0.000, max: 2.000, avg: 0.000 input records: TableScan1: 32830000 (min: 0, max: 210000, avg: 46699) output records: StreamLineWrite1: 323 (min: 0, max: 1, avg: 0) metrics_output_count: Calc1: 58025 (min: 0, max: 461, avg: 82) HashAgg1: 323 (min: 0, max: 1, avg: 0) StreamLineWrite1: 323 (min: 0, max: 1, avg: 0) TableScan1: 32830000 (min: 0, max: 210000, avg: 46699) metrics_inner_time_ms: Calc1: 4 (min: 0, max: 2, avg: 0) MaxInstance: 21 GlobalInit: 57752 (min: 60, max: 386, avg: 82) MaxInstance: 17 HashAgg1: 0 (min: 0, max: 0, avg: 0) MaxInstance: 2 StreamLineWrite1: 20469 (min: 5, max: 899, avg: 29) MaxInstance: 400 TableScan1: 131977 (min: 51, max: 1417, avg: 187) MaxInstance: 301 R2_1: instance count: 1 run time: 4.000 instance time: min: 0.000, max: 0.000, avg: 0.000 input records: StreamLineRead1: 323 (min: 323, max: 323, avg: 323) output records: AdhocSink1: 1 (min: 1, max: 1, avg: 1) metrics_output_count: AdhocSink1: 1 (min: 1, max: 1, avg: 1)
Comparaison des performances Parquet et ZSTD
La section suivante compare les performances de différents formats de compression pour les tables externes Parquet.
Remarque : les résultats des tests sont fournis à titre indicatif uniquement. Les performances peuvent varier en fonction du scénario métier. Nous vous recommandons d'effectuer des tests et une évaluation supplémentaires pour votre cas d'utilisation spécifique.
Performances des requêtes
Jeu de données : TPC-DS 1 To
Ressources : plus de 900 CU
Méthode de test : ETL
|
Métrique |
Parquet non compressé |
Parquet-Snappy |
Parquet-ZSTD |
|
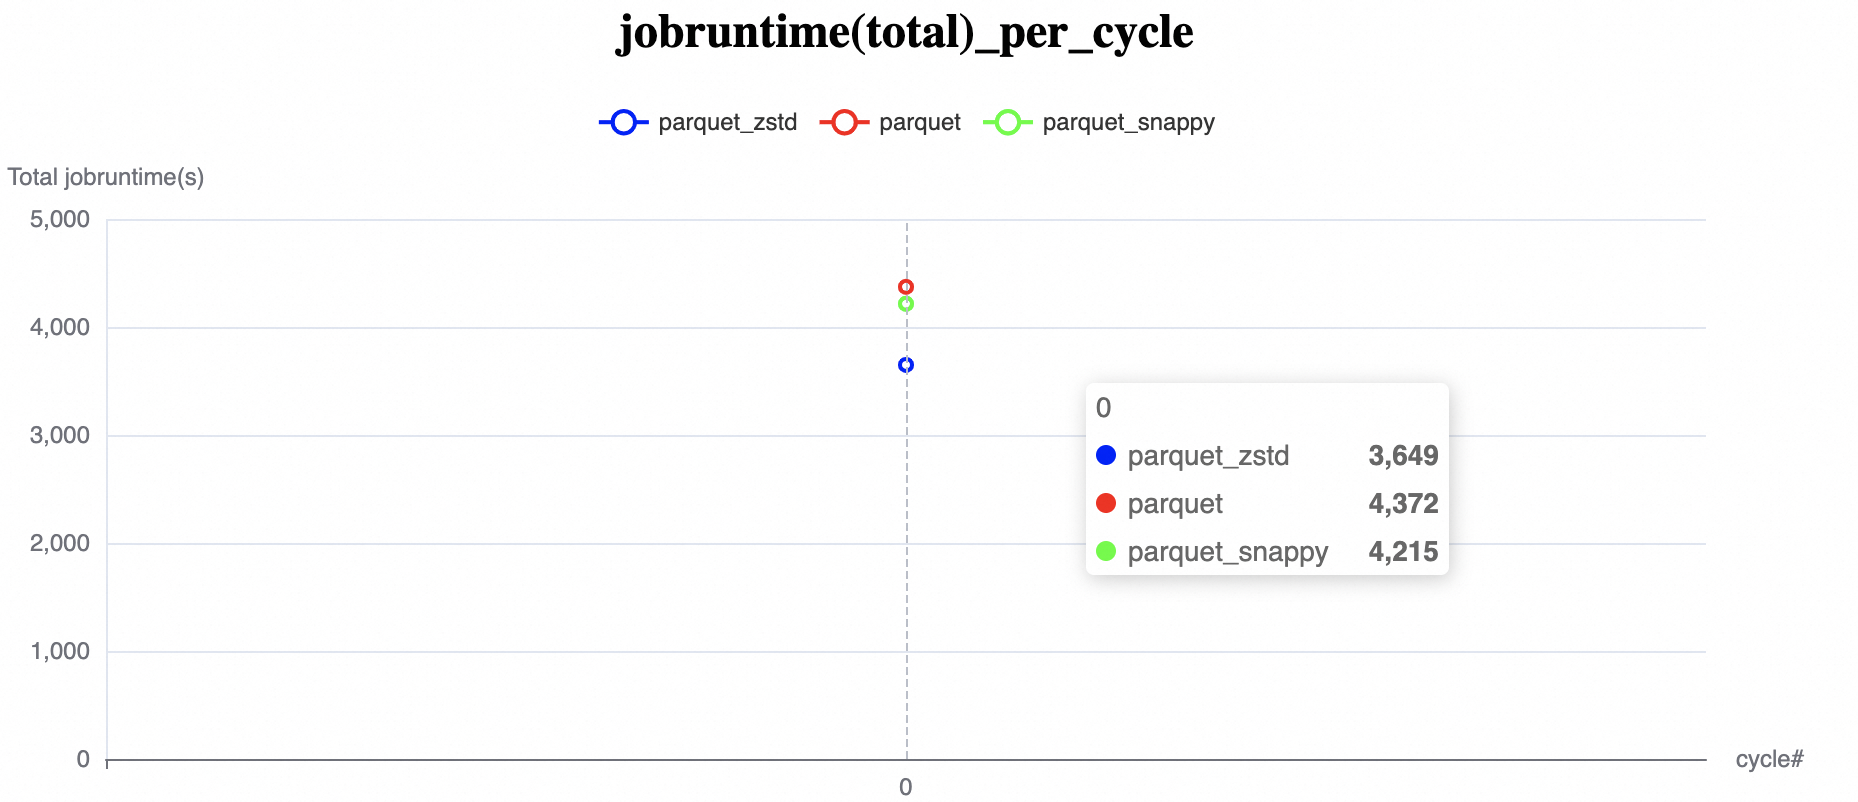
Durée d'exécution du job (s) |
4372 |
4215 |
3649 |
|
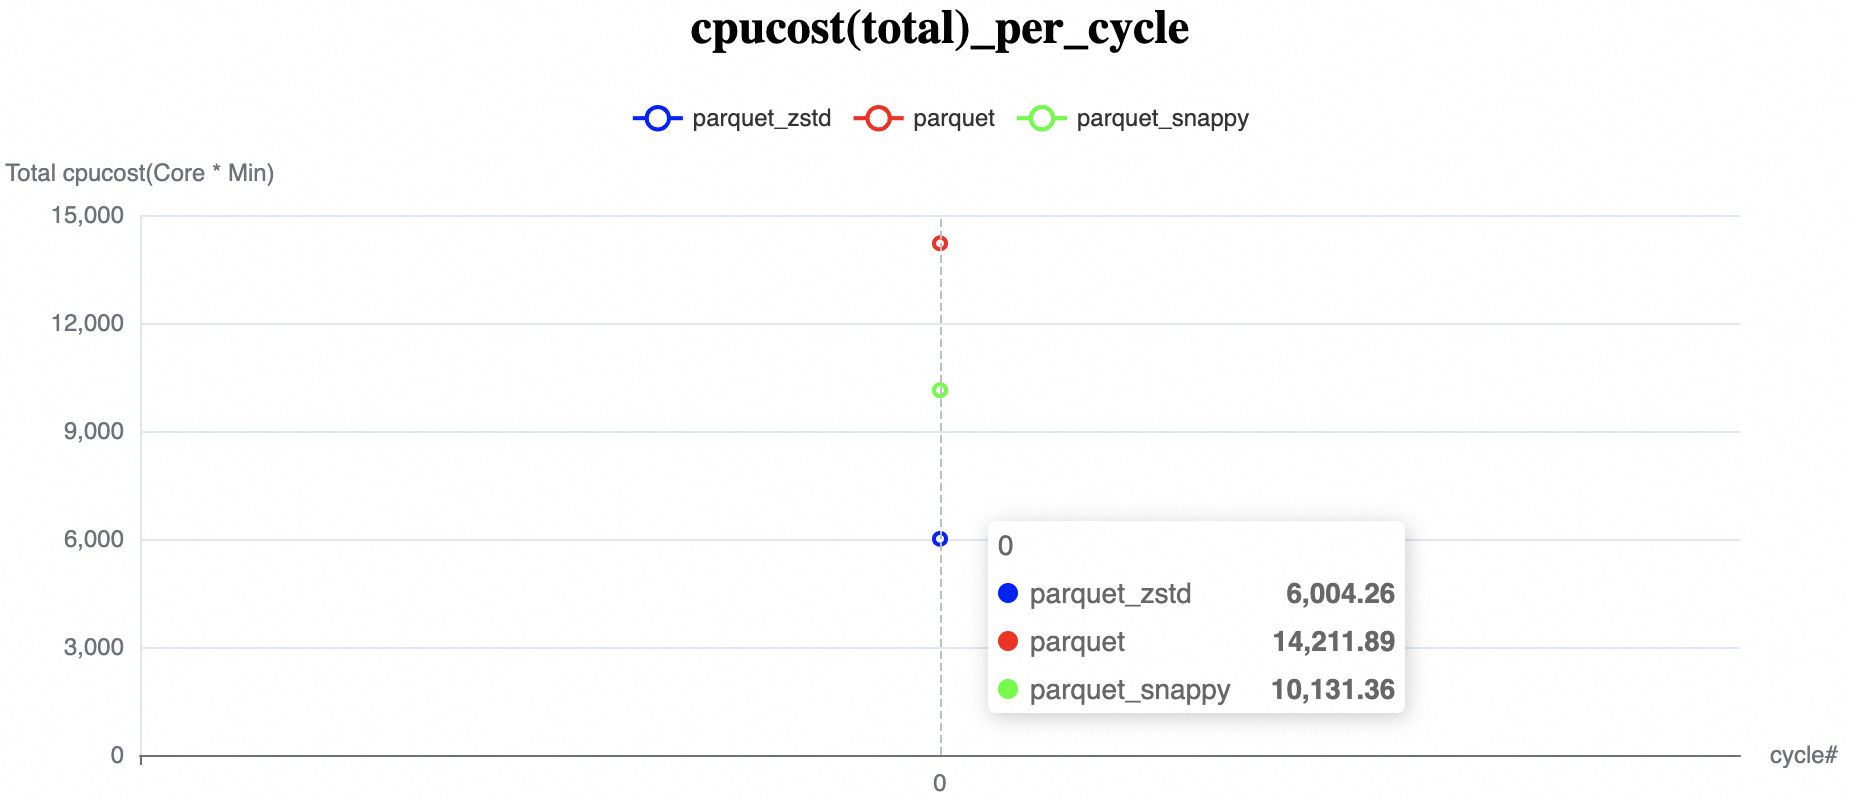
Coût CPU |
14211,89 |
10131,36 |
6004,26 |
|
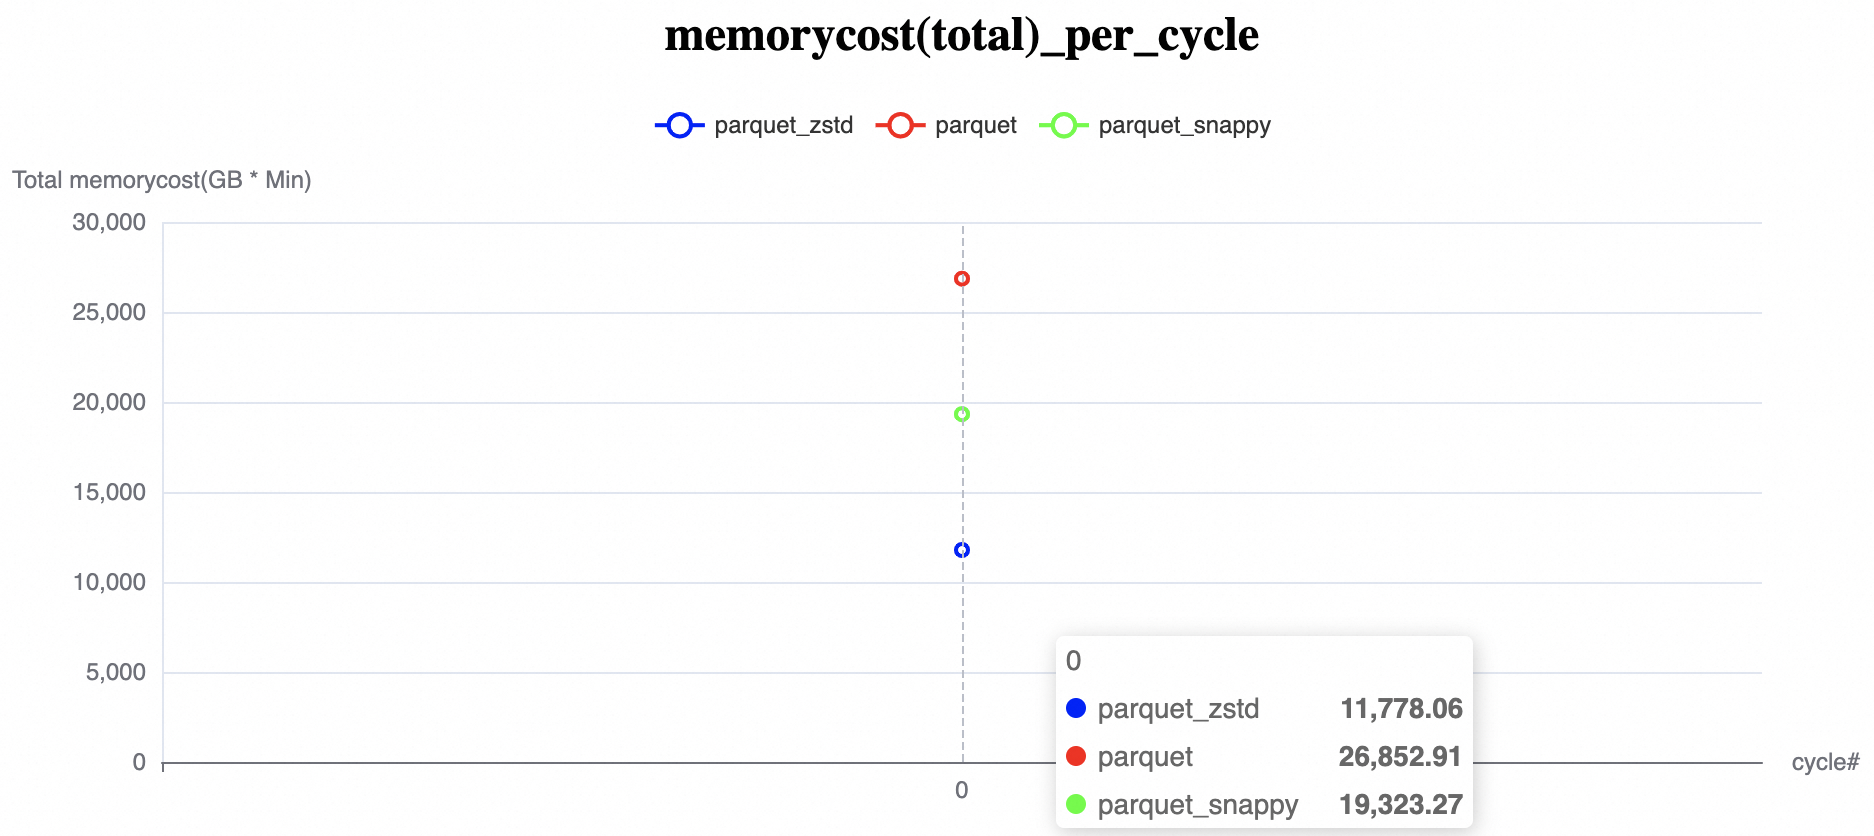
Coût mémoire |
26852,91 |
19323,27 |
11778,06 |
|
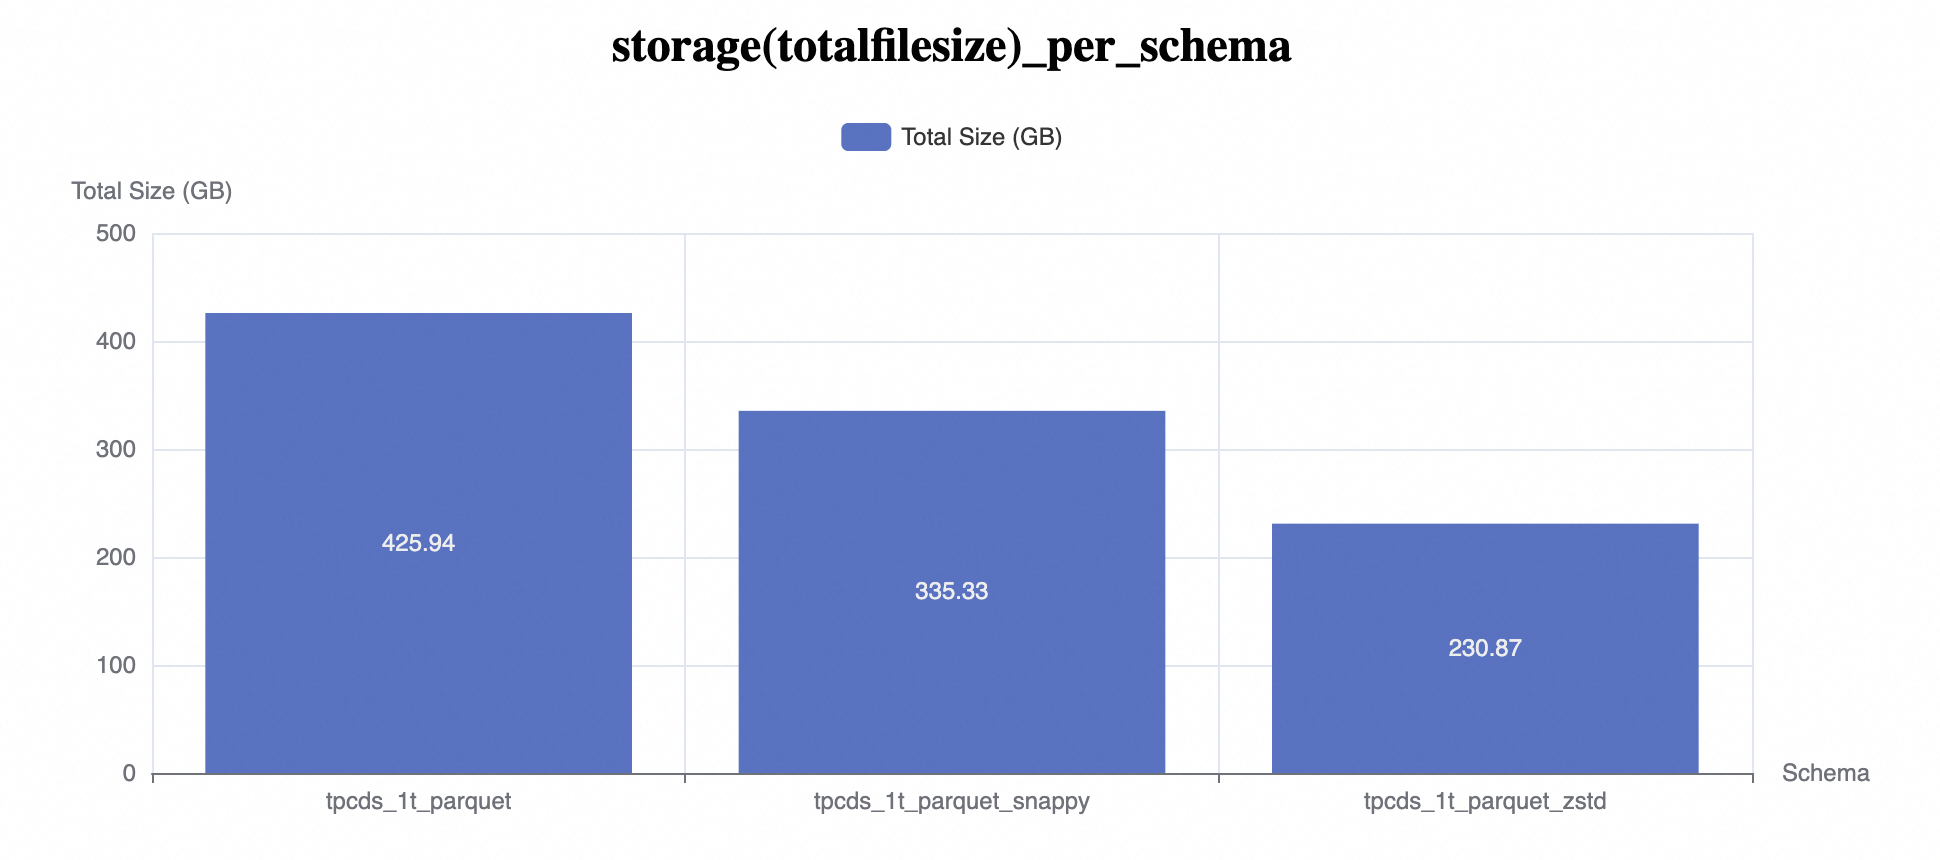
Stockage (Go) |
425,94 |
335,33 |
230,87 |
Latence : ZSTD est 13,4 % plus rapide que Snappy et 16,5 % plus rapide que le format non compressé.
CPU : ZSTD utilise 40,7 % moins de CPU que Snappy et 57,75 % moins que le format non compressé.
Mémoire : ZSTD utilise 39,04 % moins de mémoire que Snappy et 56,13 % moins que le format non compressé.
Stockage : ZSTD utilise 31,15 % moins d'espace de stockage que Snappy et 45,8 % moins que le format non compressé.
Efficacité du stockage
Jeu de données : TPC-DS 1 To
Ressources : plus de 900 CU
Méthode de test : ETL
Non compressé : bien que ce format ne soit pas compressé, il génère des volumes de données plus importants et des frais d'E/S plus élevés, ce qui entraîne de mauvaises performances globales.
Snappy : la vitesse de compression n'est pas supérieure à celle de ZSTD de bas niveau, mais le taux de compression est plus élevé. Cela se traduit par de moins bonnes performances globales que ZSTD de bas niveau.
ZSTD : la taille des données de sortie converge rapidement. Des niveaux plus élevés apportent une compression supplémentaire minime (seulement 13,87 % de plus) mais provoquent une augmentation rapide du temps et de la consommation de ressources, ce qui réduit considérablement le rapport coût-efficacité. Pour ce scénario, ZSTD de bas niveau (niveaux 3 à 5) offre les meilleurs résultats. Le niveau 3 est la valeur par défaut.
Sur le jeu de données TPC-DS de 1 To, ZSTD a utilisé 31,1 % d'espace de stockage en moins que Snappy et 45,8 % en moins que le format non compressé.
|
Format de compression |
Taille des données de sortie (Go / Taux de compression) |
Durée d'exécution du job (s) |
Durée TableSink (s, % de la durée du job) |
CPU (cœur × min) |
Mémoire (Go × min) |
|
Non compressé |
486,67 (100 %) |
256 406 |
~ 134,61 (52,5 %) |
2353,19 |
3361,71 |
|
Snappy |
238,33 (48,97 %) |
239 087 |
~ 73,88 (30,9 %) |
2110,31 |
3014,73 |
|
ZSTD (niveau 1, min) |
164,71 (33,84 %) |
233 170 |
~ 65,75 (28,2 %) |
2110,23 |
3014,61 |
|
ZSTD (niveau 2) |
165,3 (33,97 %) |
231 226 |
~ 64,51 (27,9 %) |
2100,79 |
3001,13 |
|
ZSTD (niveau 3, par défaut) |
158,9 (32,65 %) |
236 985 |
~ 67,07 (28,3 %) |
2115,10 |
3021,57 |
|
ZSTD (niveau 4) |
159,52 (32,77 %) |
232 477 |
~ 67,65 (29,1 %) |
2100,13 |
3000,19 |
|
ZSTD (niveau 5) |
157,89 (32,44 %) |
232,248 |
~ 71,07 (30,6 %) |
2103,96 |
3005,66 |
|
ZSTD (niveau 6) |
160,47 (32,97 %) |
236 669 |
~ 78,10 (33,0 %) |
2137,63 |
3053,75 |
|
ZSTD (niveau 9) |
152,00 (31,23 %) |
254 073 |
~ 100,36 (39,5 %) |
2287,61 |
3268,01 |
|
ZSTD (niveau 14) |
144,63 (29,72 %) |
455 019 |
~ 341,26 (75,5 %) |
4076,00 |
5822,86 |
|
ZSTD (niveau 19) |
150,87 (31,00 %) |
727 841 |
~ 614,30 (84,4 %) |
6933,10 |
9904,43 |
|
ZSTD (niveau 22, max) |
150,81 (30,99 %) |
5381,359 |
~ 5 257,59 (97,7 %) |
42848,13 |
61211,62 |
Exemple de scénario
Cet exemple illustre la création d'une table externe Parquet partitionnée avec compression ZSTD, ainsi que les opérations de lecture et d'écriture sur cette table.
-
Prérequis
Vous avez créé un projet MaxCompute.
-
Vous avez préparé un bucket et un répertoire OSS. Pour plus d'informations, consultez les rubriques Créer un bucket et Gérer les répertoires.
Assurez-vous que votre bucket se trouve dans la même région que votre projet MaxCompute.
-
Accordez les autorisations nécessaires.
Vous disposez des autorisations d'accès à OSS. Vous pouvez accéder à une table externe OSS via un compte Alibaba Cloud, un utilisateur RAM ou un rôle RAM. Pour savoir comment accorder ces autorisations, consultez la rubrique Autorisation STS pour OSS.
Vous possédez l'autorisation CreateTable dans le projet MaxCompute. Pour en savoir plus sur les autorisations liées aux tables, consultez la rubrique Autorisations MaxCompute.
-
Préparez un fichier de données au format ZSTD.
Dans le bucket
oss-mc-testcontenant les données d'exemple, créez le dossierparquet_zstd_jni/dt=20230418et stockez le fichier de données dans le dossier de partitiondt=20230418. -
Créez une table externe Parquet utilisant le format de compression ZSTD.
CREATE EXTERNAL TABLE IF NOT EXISTS mc_oss_parquet_data_type_zstd ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongtitue DOUBLE, recordTime STRING, direction STRING ) PARTITIONED BY (dt STRING ) ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe' WITH serdeproperties( 'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>', 'mcfed.parquet.compression'='zstd' ) STORED AS parquet LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/parquet_zstd_jni/'; -
Importez les données de partition. Si la table externe OSS est partitionnée, vous devez également importer les données de partition. Pour plus de détails, consultez la rubrique Tables externes OSS.
-- Import partition data. MSCK REPAIR TABLE mc_oss_parquet_data_type_zstd ADD PARTITIONS; -
Lisez les données depuis la table externe Parquet.
SELECT * FROM mc_oss_parquet_data_type_zstd WHERE dt='20230418' LIMIT 10;Le résultat suivant s'affiche :
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+ | vehicleid | recordid | patientid | calls | locationlatitute | locationlongtitue | recordtime | direction | dt | +------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+ | 1 | 12 | 76 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:10 | SW | 20230418 | | 1 | 1 | 51 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:00 | S | 20230418 | | 1 | 2 | 13 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:01 | NE | 20230418 | | 1 | 3 | 48 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:02 | NE | 20230418 | | 1 | 4 | 30 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:03 | W | 20230418 | | 1 | 5 | 47 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:04 | S | 20230418 | | 1 | 6 | 9 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:05 | S | 20230418 | | 1 | 7 | 53 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:06 | N | 20230418 | | 1 | 8 | 63 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:07 | SW | 20230418 | | 1 | 9 | 4 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:08 | NE | 20230418 | | 1 | 10 | 31 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:09 | N | 20230418 | +------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+ -
Écrivez des données dans la table externe Parquet.
INSERT INTO mc_oss_parquet_data_type_zstd PARTITION ( dt = '20230418')
  VALUES  (1,16,76,1,46.81006,-92.08174,'9/14/2014 0:10','SW');
-- Query the newly written data
SELECT * FROM mc_oss_parquet_data_type_zstd WHERE dt = '20230418' AND recordid=16;
Le résultat est le suivant :
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| vehicleid  | recordid   | patientid  | calls      | locationlatitute | locationlongtitue | recordtime     | direction  | dt         |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| 1          | 16         | 76         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:10 | SW         | 20230418   |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
Types de données pris en charge
Pour plus d'informations sur les types de données MaxCompute, consultez les rubriques Types de données (version 1.0) et Types de données (version 2.0).
Mode Java Native Interface (JNI) :
set odps.ext.parquet.native=false. Ce mode utilise l'implémentation Java open source d'origine pour analyser les fichiers de données Parquet lors de la lecture depuis une table externe. Il prend en charge les opérations de lecture et d'écriture.-
Mode natif :
set odps.ext.parquet.native=true. Ce mode s'appuie sur une nouvelle implémentation native en C++ pour analyser les fichiers de données Parquet lors de la lecture depuis une table externe. Il ne prend en charge que les opérations de lecture.Mode
Mode Java (lecture/écriture)
Mode natif (lecture seule)
TINYINT
SMALLINT
INT
BIGINT
BINARY
FLOAT
DOUBLE
DECIMAL(precision,scale)
VARCHAR(n)
CHAR(n)
STRING
DATE
DATETIME
TIMESTAMP
TIMESTAMP_NTZ
BOOLEAN
ARRAY
MAP
STRUCT
JSON
Formats de compression pris en charge
Pour lire ou écrire des fichiers OSS compressés, ajoutez la configuration de propriété with serdeproperties à l'instruction de création de table. Pour plus d'informations, consultez la section Paramètres de propriété with serdeproperties.
|
Propriété de compression |
Lecture |
Écriture |
|
Gzip |
|
|
|
ZSTD |
|
|
|
SNAPPY (SnappyRawCodec) |
|
|
|
SNAPPY (SnappyCodec) |
|
|
Prise en charge de l'évolution du schéma
Les tables externes Parquet mappent les valeurs de colonne entre le schéma et les colonnes du fichier par nom.
La colonne Problèmes de compatibilité des données du tableau ci-dessous indique si les données peuvent être lues correctement après une opération d'évolution du schéma. Cela s'applique aussi bien aux nouvelles données conformes au schéma modifié qu'aux données historiques utilisant l'ancien schéma.
Type d'opération | Pris en charge | Description | Problèmes de compatibilité des données |
Ajouter une colonne |
|
| |
Supprimer une colonne | Les tables externes Parquet mappent les valeurs de colonne par nom. | Compatible | |
Réorganiser les colonnes | Les tables externes Parquet mappent les valeurs de colonne par nom. | Compatible | |
Modifier le type de données d'une colonne | Cette opération n'est pas prise en charge. Le format Parquet impose une validation stricte du schéma. La modification d'un type de données peut rendre les données illisibles. | Sans objet | |
Renommer une colonne | Cette opération n'est pas prise en charge. Le format Parquet impose une validation stricte du schéma, ce qui peut rendre des types précédemment compatibles illisibles après modification. | Sans objet | |
Modifier le commentaire d'une colonne | Le commentaire doit être une chaîne valide ne dépassant pas 1 024 octets. Sinon, une erreur se produit. | Compatible | |
Modifier la propriété de non-nullité d'une colonne | Cette opération n'est pas prise en charge. Les colonnes sont nullable par défaut. | Sans objet |
FAQ
Incompatibilité des types de colonne entre un fichier Parquet et la DDL de la table externe
-
Message d'erreur
ODPS-0123131:User defined function exception - Traceback: java.lang.ClassCastException: org.apache.hadoop.io.LongWritable cannot be cast to org.apache.hadoop.io.IntWritable at org.apache.hadoop.hive.serde2.objectinspector.primitive.WritableIntObjectInspector.getPrimitiveJavaObject(WritableIntObjectInspector.java:46) -
Description de l'erreur
Le type de champ LongWritable du fichier Parquet ne correspond pas au type INT défini dans la DDL de la table externe.
-
Solution
Remplacez le type INT par BIGINT dans la DDL de la table externe.
Erreur lors de l'écriture dans une table externe : java.lang.OutOfMemoryError
-
Message d'erreur
ODPS-0123131:User defined function exception - Traceback: java.lang.OutOfMemoryError: Java heap space at java.io.ByteArrayOutputStream.<init>(ByteArrayOutputStream.java:77) at org.apache.parquet.bytes.BytesInput$BAOS.<init>(BytesInput.java:175) at org.apache.parquet.bytes.BytesInput$BAOS.<init>(BytesInput.java:173) at org.apache.parquet.bytes.BytesInput.toByteArray(BytesInput.java:161) -
Description de l'erreur
Une erreur d'épuisement de la mémoire (OOM) se produit lors de l'écriture d'un volume important de données dans une table externe Parquet.
-
Solution
Lors de la création d'une table externe, commencez par réduire la valeur du paramètre
mcfed.parquet.block.row.count.limit. Si l'erreur OOM persiste ou si le fichier de sortie est trop volumineux, diminuez également le paramètremcfed.parquet.page.size.row.check.maxafin d'effectuer des vérifications mémoire plus fréquentes. Pour plus de détails, consultez la section Paramètres uniques.Avant d'écrire des données dans la table externe Parquet, ajoutez les paramètres suivants.
-- Set the maximum memory size for the UDF JVM heap.
SET odps.sql.udf.jvm.memory=12288;
-- Control the batch size on the runtime side.
SET odps.sql.executionengine.batch.rowcount =64;
-- Set the memory size for each Map worker.
SET odps.stage.mapper.mem=12288;
-- Set the input data volume for each Map worker (input file shard size) to indirectly control the number of workers per Map stage.
SET odps.stage.mapper.split.size=64;