MaxCompute prend en charge les tables externes OSS qui mappent des répertoires Object Storage Service (OSS). Utilisez les tables externes OSS pour lire des données non structurées depuis OSS ou y écrire des données.
Notes d'utilisation
Les tables externes OSS ne prennent pas en charge la propriété cluster.
La taille d'un fichier unique ne peut pas dépasser 2 Go. Vous devez fractionner les fichiers dont la taille est supérieure à 2 Go.
MaxCompute et OSS doivent se trouver dans la même région.
Méthodes d'accès
Les plateformes suivantes permettent de créer et d'utiliser des tables externes OSS.
Méthode | Plateforme |
SQL MaxCompute | |
Visualisation |
Prérequis
Vous avez créé un projet MaxCompute.
-
Préparez un bucket et un répertoire OSS. Créez un bucket et gérez les répertoires.
MaxCompute peut créer automatiquement des répertoires OSS. Si une instruction SQL inclut des tables externes et des UDF, une seule instruction SQL peut lire ou écrire dans la table externe et exécuter l'UDF. La création manuelle de répertoires est également prise en charge.
Étant donné que MaxCompute n'est déployé que dans certaines régions, la connectivité réseau interrégionale peut poser problème. Conservez votre bucket dans la même région que votre projet MaxCompute.
-
Autorisation
Obtenez les permissions nécessaires pour accéder à OSS. Un compte Alibaba Cloud, un utilisateur RAM ou un rôle RAM peut accéder aux tables externes OSS. Autorisation STS pour OSS.
Obtenez l'autorisation CreateTable dans votre projet MaxCompute. Permissions MaxCompute.
Description des permissions
Lorsque vous accédez aux tables externes OSS, les données sont consultées via le rôle spécifié dans le paramètre
odps.properties.rolearn, que vous utilisiez un compte Alibaba Cloud, un utilisateur RAM ou un rôle RAM. Par conséquent, vous devez créer un rôle RAM, lui accorder les permissions d'accès au bucket OSS cible, puis configurer l'ARN du rôle dans le paramètreodps.properties.rolearn. Pour plus d'informations, consultez la section Paramètres.Vous pouvez autoriser l'accès intra-compte ou inter-comptes selon vos besoins métier. Nous vous recommandons d'utiliser une politique d'autorisation personnalisée pour un contrôle d'accès plus granulaire. Pour plus d'informations, consultez la section Autorisation pour les sources de données externes.
Créer une table externe OSS
-
Tables partitionnées et non partitionnées :
Choisissez en fonction de la manière dont vos fichiers de données sont stockés dans OSS. Utilisez une table partitionnée si les fichiers se trouvent dans des chemins partitionnés ; sinon, optez pour une table non partitionnée.
Les tables externes OSS prennent en charge les opérations de partition.
Nom de domaine réseau : utilisez le nom de domaine du réseau classique pour OSS. MaxCompute ne garantit pas la connectivité réseau pour les noms de domaine publics.
Une table externe OSS enregistre uniquement le mappage vers un répertoire OSS. La suppression d'une table externe OSS n'entraîne pas la suppression des fichiers de données dans le répertoire OSS mappé.
Si un fichier de données OSS est un objet archivé, vous devez d'abord restaurer l'objet.
La syntaxe CREATE EXTERNAL TABLE varie selon le format du fichier de données. Adaptez la syntaxe et les paramètres à votre format de données. Des paramètres incorrects provoquent des échecs en lecture et en écriture.
Syntaxe
Créer une table externe à l'aide de l'analyseur de données texte intégré
Syntaxe | Format du fichier de données | Exemple |
| Formats de fichiers de données pris en charge pour la lecture ou l'écriture dans OSS :
|
Créer une table externe à l'aide d'un analyseur de données open source intégré
Syntaxe | Format du fichier de données | Exemple |
| Formats de fichiers de données pris en charge pour la lecture ou l'écriture dans OSS :
|
Créer une table externe à l'aide d'un analyseur personnalisé
Syntaxe | Format du fichier de données | Exemple |
| Formats de fichiers de données pris en charge pour la lecture ou l'écriture dans OSS : fichiers de données dans des formats autres que ceux répertoriés ci-dessus. |
Paramètres
Les paramètres suivants sont communs à tous les formats de tables externes. Pour les paramètres spécifiques à un format, consultez la documentation correspondante.
-
Paramètres de la syntaxe de base
Paramètre
Obligatoire
Description
mc_oss_extable_name
Oui
Nom de la table externe OSS à créer.
Les noms de table ne sont pas sensibles à la casse et ne peuvent pas être convertis de force vers une casse spécifique.
col_name
Oui
Nom d'une colonne dans la table externe OSS.
Le schéma de la table externe doit correspondre au schéma du fichier de données OSS. Sinon, les données ne peuvent pas être lues.
data_type
Oui
Type de données d'une colonne dans la table externe OSS.
Le type de données de chaque colonne doit correspondre à la colonne correspondante dans le fichier de données OSS. Sinon, les données ne peuvent pas être lues.
table_comment
Non
Commentaire associé à la table. Il doit s'agir d'une chaîne valide ne dépassant pas 1 024 octets. Dans le cas contraire, une erreur est signalée.
partitioned by (col_name data_type, ...)
Non
Si les fichiers de données dans OSS sont stockés dans un chemin partitionné, incluez ce paramètre pour créer une table partitionnée.
col_name : nom de la colonne de clé de partition.
data_type : type de données de la colonne de clé de partition.
'<(tb)property_name>'='<(tb)property_value>'
Oui
Propriétés étendues de la table externe. Consultez la documentation spécifique au format pour plus de détails.
oss_location
Oui
Chemin OSS où se trouvent les fichiers de données. Par défaut, tous les fichiers de données de ce chemin sont lus.
Le format est
oss://<oss_endpoint>/<Bucket name>/<OSS directory name>/.oss_endpoint :
Nom de domaine OSS. Vous devez utiliser le point de terminaison du réseau classique fourni par OSS, qui contient
-internal.Exemple :
oss://oss-cn-beijing-internal.aliyuncs.com/xxx.Les noms de domaine du réseau classique OSS sont répertoriés dans Régions et points de terminaison.
Veillez à ce que la région OSS où sont stockés les fichiers de données soit identique à la région de votre projet MaxCompute. Si elles diffèrent, des problèmes de connectivité réseau peuvent survenir.
Si vous ne spécifiez pas de point de terminaison, le système utilise celui de la région où se trouve le projet actuel.
Cette méthode n'est pas recommandée, car le stockage de fichiers inter-régions peut entraîner des problèmes de connectivité réseau.
Bucket name : nom du bucket OSS. Le nom du bucket doit suivre le
oss_endpoint.Exemple :
oss://oss-cn-beijing-internal.aliyuncs.com/your_bucket/path/.Consultez les noms des buckets dans Lister les buckets.
Directory name : nom du répertoire OSS. Ne spécifiez pas de nom de fichier après le répertoire.
Exemple :
oss://oss-cn-beijing-internal.aliyuncs.com/oss-mc-test/Demo1/.Exemples incorrects :
 -- HTTP connections are not supported.
    http://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
    -- HTTPS connections are not supported.
    https://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
    -- Incorrect connection address.
    oss://oss-cn-shanghai-internal.aliyuncs.com/Demo1
    -- Do not specify a file name.
    oss://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/vehicle.csv
-
Attributs WITH serdeproperties
property_name
Scénario
property_value
Valeur par défaut
odps.properties.rolearn
Ajoutez cette propriété lors de l'utilisation de l'autorisation STS.
Spécifiez l'ARN du rôle RAM disposant des autorisations nécessaires pour accéder à OSS.
Obtenez l'ARN à partir des détails du rôle dans la console RAM. Exemple :
acs:ram::xxxxxx:role/<role_name>.Si les propriétaires de MaxCompute et d'OSS sont le même compte :
Si vous ne spécifiez pas
odps.properties.rolearndans l'instruction de création de table, l'ARN du rôlealiyunodpsdefaultroleest utilisé par défaut. Vous devez d'abord créer le rôle RAM en utilisant l'autorisation STS. Le rôleAliyunODPSDefaultRoledispose d'autorisations étendues. Nous vous recommandons d'accorder des autorisations via un rôle personnalisé.Pour utiliser l'ARN d'un rôle personnalisé, créez d'abord le rôle personnalisé. Autorisation STS pour OSS (autorisation personnalisée).
Si les propriétaires de MaxCompute et d'OSS sont des comptes différents, vous devez spécifier l'ARN d'un rôle personnalisé. Pour plus d'informations, consultez Autorisation STS pour OSS (autorisation personnalisée).
Liste d'autorisation et liste de blocage
Les tables externes MaxCompute OSS prennent en charge le filtrage par liste d'autorisation (whitelist) et liste de blocage (blacklist). En définissant les paramètres de liste d'autorisation et de liste de blocage dans tblproperties, vous pouvez filtrer les fichiers à lire depuis un répertoire.
-
Paramètres tblproperties
-
Règles d'application
La liste de blocage est prioritaire sur la liste d'autorisation : si un fichier correspond à n'importe quelle condition de la liste de blocage, il est exclu.
-
L'indicateur de session et le paramètre de liste de blocage tblproperties ont une relation « OU ». Si les deux sont configurés, ils prennent tous deux effet : un fichier correspondant à l'une ou l'autre condition de liste de blocage est exclu. La configuration via tblProperties est recommandée.
Méthode de configuration
Type de chemin
Paramètre
indicateur de session
Chemin absolu
odps.sql.unstructured.file.pattern.black.list
tblproperties
Chemin relatif
odps.external.data.file.blacklist.regex
-
Remarques sur les expressions régulières
Les ancres de début de ligne
^et de fin de ligne$sont facultatives. Par exemple, pour faire correspondre les fichiers.json,.*\.jsonsuffit.-
Un seul motif regex est pris en charge. Pour exclure plusieurs types de fichiers, utilisez | :
-- Exclude csv, txt, and parquet files
"odps.external.data.file.blacklist.regex": ".*\\.(txt|csv|parquet)$"
-
Mettre à jour les paramètres de liste d'autorisation et de liste de blocage
ALTER TABLE {table_name} SET tblproperties('odps.external.data.file.whitelist.regex'='new_regex') ALTER TABLE {table_name} SET tblproperties('odps.external.data.file.blacklist.regex'='new_regex') -
Exemples
-
Données d'exemple
-- Assume the OSS directory contains the following files: oss://xxx/bucket/level1/data1.txt oss://xxx/bucket/level1/data2.json oss://xxx/bucket/level1/data3.csv oss://xxx/bucket/level1/level2/data4.txt oss://xxx/bucket/level1/level2/data5.json oss://xxx/bucket/level1/level2/data6.parquet -
Liste d'autorisation : lire uniquement les fichiers JSON
CREATE EXTERNAL TABLE test_whitelist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED AS textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json'); -- Whitelist: JSON files only -- By running SELECT * FROM test_whitelist_table, all JSON files are selected. -- Query returns data from data2.json and level2/data5.json -
Liste de blocage : exclure les fichiers txt, csv et parquet
CREATE EXTERNAL TABLE test_blacklist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.blacklist.regex'='.*\\.(txt|csv|parquet)$'); -- Blacklist: exclude txt, csv, parquet -- By running SELECT * FROM test_blacklist_table, all TXT, CSV, and Parquet files are filtered out. -- Query returns data from data2.json and level2/data5.json -
Combinaison liste d'autorisation et liste de blocage : lire les fichiers txt, exclure le répertoire level2
CREATE EXTERNAL TABLE test_whitelist_blacklist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.txt', -- Whitelist: txt files only 'odps.external.data.file.blacklist.regex'='.*level2/.*'); -- Blacklist: exclude level2 directory -- By running select * from test_whitelist_blacklist_table, -- Whitelist filters txt files, then blacklist excludes level2 directory -- Query returns data from data1.txt only -
Listage récursif : contrôler la lecture des fichiers dans les sous-répertoires
CREATE EXTERNAL TABLE test_recursive_enabled ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json' -- Whitelist: json files only 'odps.external.data.file.recursive.listing.enabled'='true'); -- Recursive enabled -- By running SELECT * FROM test_recursive_enabled, all JSON files are selected. -- Query returns data from data2.json and level2/data5.json CREATE EXTERNAL TABLE test_recursive_disabled ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json' -- Whitelist: json files only 'odps.external.data.file.recursive.listing.enabled'='false' -- Recursive disabled ); -- By running SELECT * FROM test_recursive_disabled, all JSON files are selected, but recursive reading is disabled. -- Query returns data from data2.json only (level2 directory excluded) -
Mettre à jour la liste d'autorisation et la liste de blocage via ALTER TABLE
CREATE EXTERNAL TABLE test_alter_table_properties
(
  id INT,
  name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- Enable file extension support
  'odps.external.data.file.whitelist.regex'='.*\\.json'); -- Whitelist: json files only

-- By running SELECT * FROM test_alter_table_properties, all JSON files are selected
-- Query returns data from data2.json and level2/data5.json

ALTER TABLE test_alter_table_properties
SET tblproperties(
  'odps.external.data.file.whitelist.regex'='.*level2/.*\\.json'
)
-- By running select * from test_alter_table_properties
-- Query now returns data from level2/data5.json only
-
Lecture des données depuis OSS
Notes
Une fois la table externe OSS créée, vous pouvez lire les données stockées dans OSS via cette table. Pour connaître les types de fichiers pris en charge et la syntaxe de création, consultez la section Syntaxe.
Si une instruction SQL fait appel à des types de données complexes, ajoutez le préfixe
set odps.sql.type.system.odps2=true;et soumettez l'ensemble simultanément. Consultez la rubrique Versions des types de données.Pour les tables externes OSS qui mappent des données open source, définissez
set odps.sql.hive.compatible=true;au niveau de la session avant de lire les données depuis OSS. À défaut, une erreur se produira.OSS impose des limites de bande passante. Si le trafic de lecture/écriture dépasse la limite de bande passante de l'instance sur une courte période, les performances de la table externe se dégradent. Consultez la documentation relative aux Limites et métriques de performance.
Syntaxe
<select_statement> FROM <from_statement>;select_statement : clause
SELECTpermettant d'interroger les données à insérer dans la table cible depuis la table source.from_statement : clause
FROMspécifiant la source de données, telle que le nom de la table externe.
Données non partitionnées
Données non partitionnées
Après avoir créé une table externe OSS non partitionnée, vous pouvez lire les données depuis OSS en utilisant l'une des méthodes suivantes :
-
Méthode 1 (recommandée) : importez les données au format open source depuis OSS vers une table interne MaxCompute, puis lisez les données.
Cette approche est idéale pour les calculs répétés ou les scénarios nécessitant des performances élevées. Créez une table interne dont le schéma est identique à celui de la table externe, importez les données, puis exécutez des requêtes complexes. Le stockage interne bénéficie des optimisations de MaxCompute. Exemple de commande :
CREATE TABLE <table_internal> LIKE <mc_oss_extable_name>; INSERT OVERWRITE TABLE <table_internal> SELECT * FROM <mc_oss_extable_name>; -
Méthode 2 : lisez les données directement depuis OSS, de manière similaire aux opérations sur les tables internes MaxCompute.
Cette méthode convient aux scénarios où les exigences de performance sont moins critiques. Chaque requête lit les données directement depuis OSS plutôt que depuis le stockage interne.
Données partitionnées
Données partitionnées
MaxCompute effectue une analyse complète de toutes les données présentes dans le répertoire OSS, y compris les sous-répertoires. Pour les jeux de données volumineux, cela génère des E/S inutiles et augmente le temps de traitement. Deux solutions s'offrent à vous.
-
**Méthode 1 (recommandée) : stockez les données sur OSS en utilisant un format de chemin partitionné standard ou un format de chemin partitionné personnalisé**.
Spécifiez la partition et oss_location dans l'instruction de création de la table. Les chemins partitionnés standard sont recommandés.
-
Méthode 2 : planifiez plusieurs chemins de stockage de données.
Créez plusieurs tables externes, chacune pointant vers un sous-ensemble des données OSS. Cette méthode est fastidieuse et n'est pas recommandée.
Format de chemin partitionné standard
oss://<oss_endpoint>/<Bucket name>/<directory name>/<partitionKey1=value1>/<partitionKey2=value2>/...Exemple : une entreprise stocke des fichiers journaux quotidiens au format CSV sur OSS et traite ces données chaque jour avec MaxCompute. Le chemin partitionné standard pour le stockage des données OSS doit être configuré comme suit.
oss://oss-odps-test/log_data/year=2016/month=06/day=01/logfile
oss://oss-odps-test/log_data/year=2016/month=06/day=02/logfile
oss://oss-odps-test/log_data/year=2016/month=07/day=10/logfile
oss://oss-odps-test/log_data/year=2016/month=08/day=08/logfile
...
Format de chemin partitionné personnalisé
Un format de chemin partitionné personnalisé contient uniquement les valeurs des colonnes de partition, sans les noms des colonnes. Exemple :
oss://oss-odps-test/log_data_customized/2016/06/01/logfile
oss://oss-odps-test/log_data_customized/2016/06/02/logfile
oss://oss-odps-test/log_data_customized/2016/07/10/logfile
oss://oss-odps-test/log_data_customized/2016/08/08/logfile
...
Si les données OSS utilisent un chemin partitionné non standard, vous pouvez lier manuellement les sous-répertoires aux partitions.
Après avoir créé la table externe, utilisez alter table ... add partition ... location ... pour associer les sous-répertoires aux partitions. Exemple :
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '01')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/01/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '02')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/02/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '07', day = '10')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/07/10/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '08', day = '08')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/08/08/';
Optimisation des requêtes
Collecte dynamique des statistiques
Collecte dynamique des statistiques
Les données externes ne disposent pas de statistiques préexistantes, ce qui contraint l'optimiseur de requêtes à adopter une stratégie conservatrice peu efficace. La collecte dynamique des statistiques permet à l'optimiseur de recueillir les statistiques de la table pendant l'exécution de la requête afin d'identifier les petites tables. Cela active le Hash Join, optimise l'ordre des jointures, réduit les brassages de données (shuffles) et raccourcit les pipelines d'exécution.
Les paramètres suivants s'appliquent uniquement aux scénarios de tables Hive sur OSS (telles que Parquet, ORC, JSON et CSV) et ne concernent pas les scénarios de tables de lac de données, comme les tables externes Paimon, Hudi ou Delta Lake.
SET odps.meta.exttable.stats.onlinecollect=true;
SELECT * FROM <tablename>;
Test de performance
Jeu de données de test : Données TPC-DS
Échelle du test : 100 Go
Ressources de test : 100 CU
Notes : Les scénarios métier variant, il est recommandé d'effectuer une évaluation supplémentaire basée sur vos charges de travail spécifiques. Activez l'indicateur de manière sélective selon votre SQL métier.
-
Activation de l'indicateur
SET odps.meta.exttable.stats.onlinecollect=true; -
Conclusion
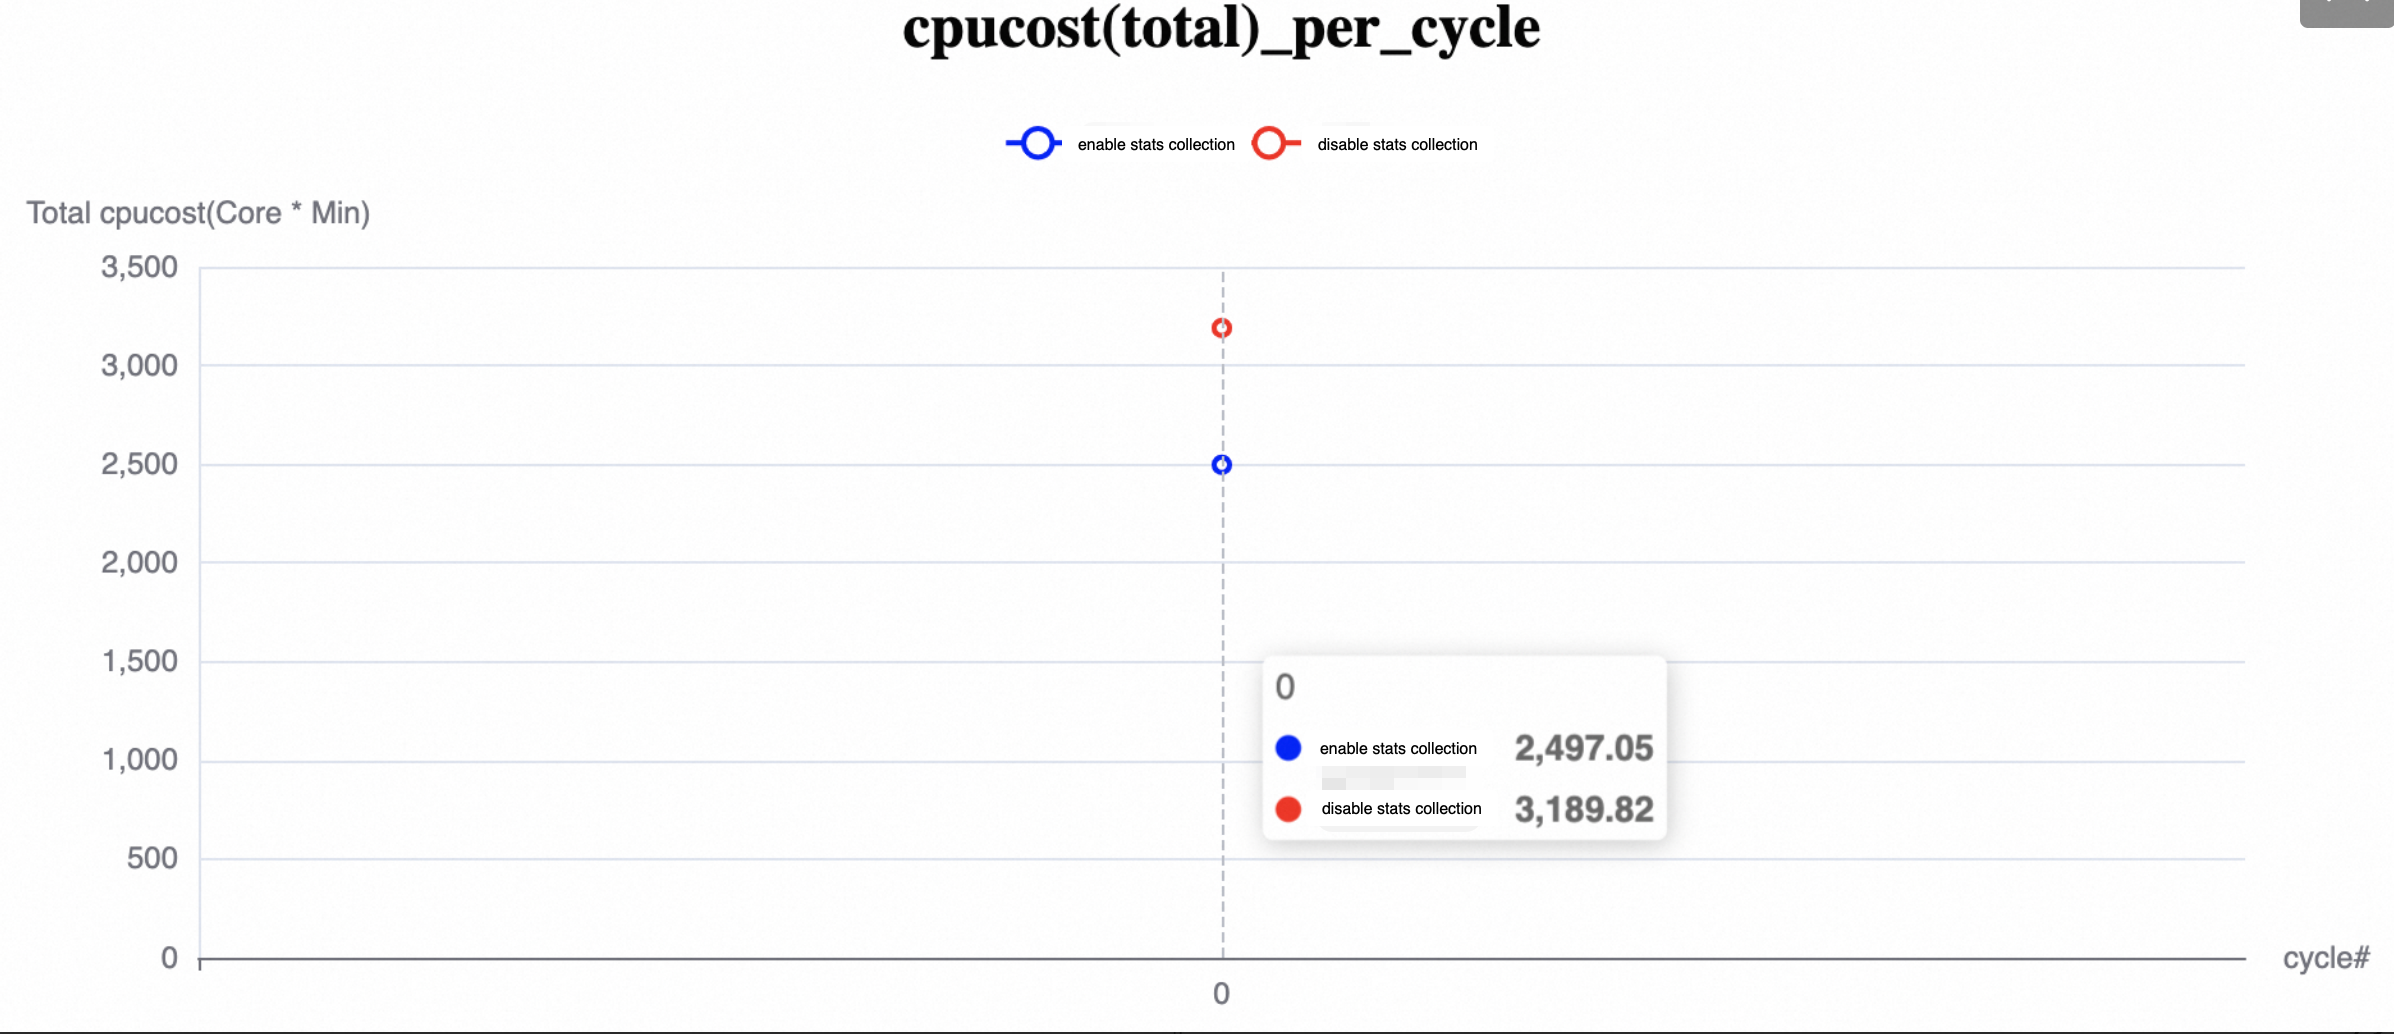
Le temps d'exécution du job a diminué de 22,75 %, l'utilisation du CPU a baissé de 21,72 % et l'utilisation de la mémoire a reculé de 24 %.
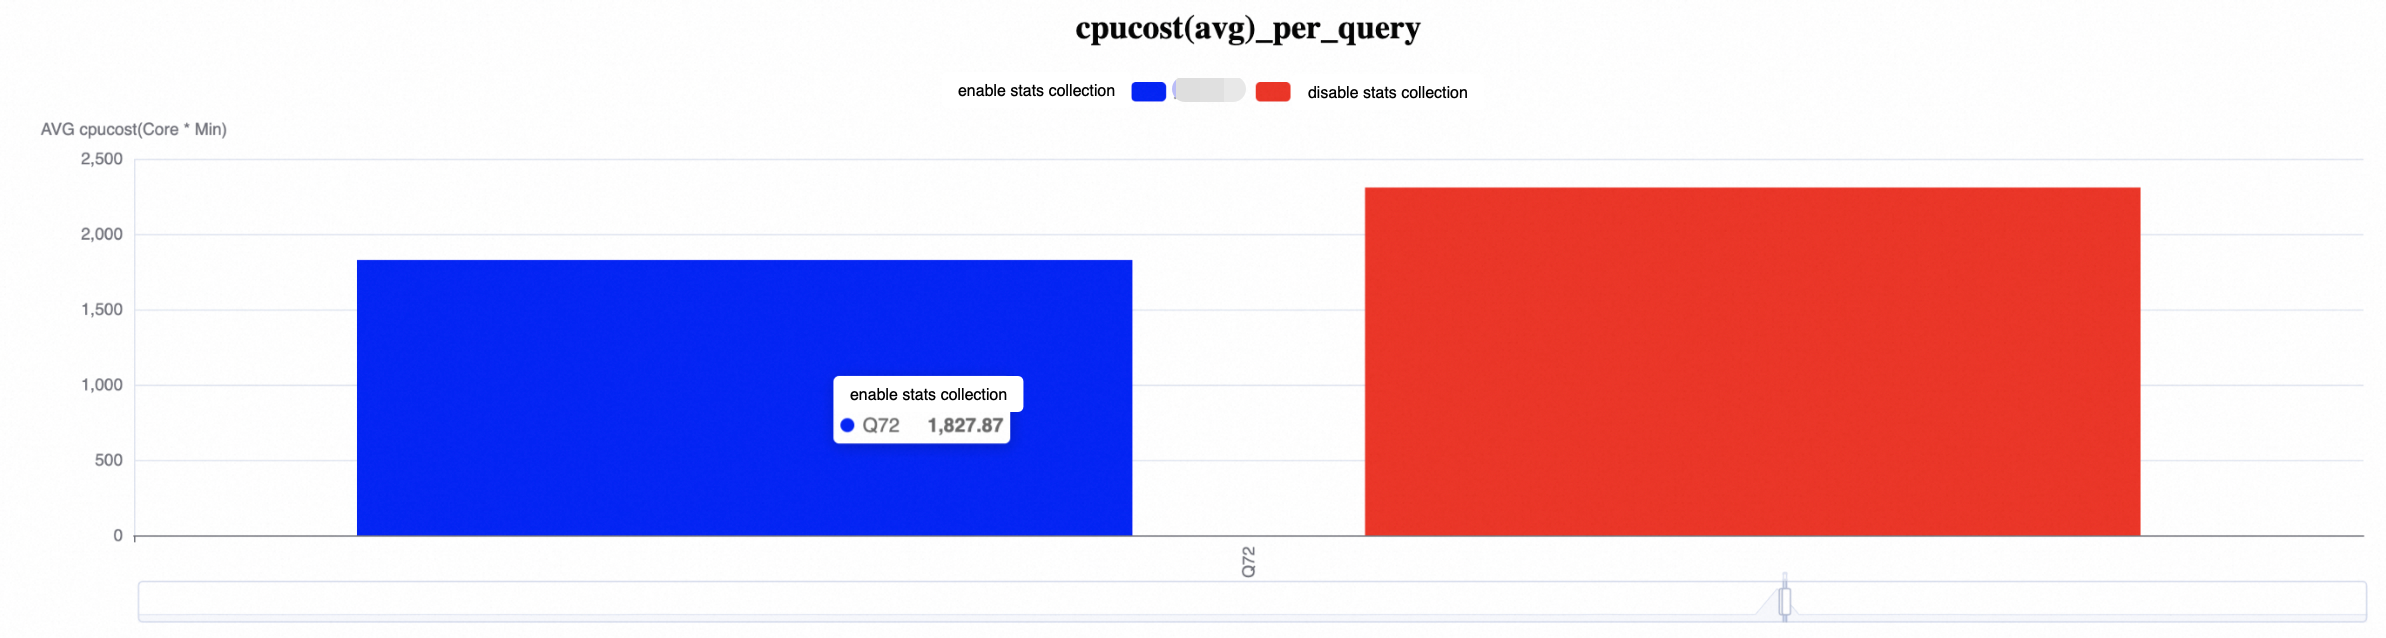
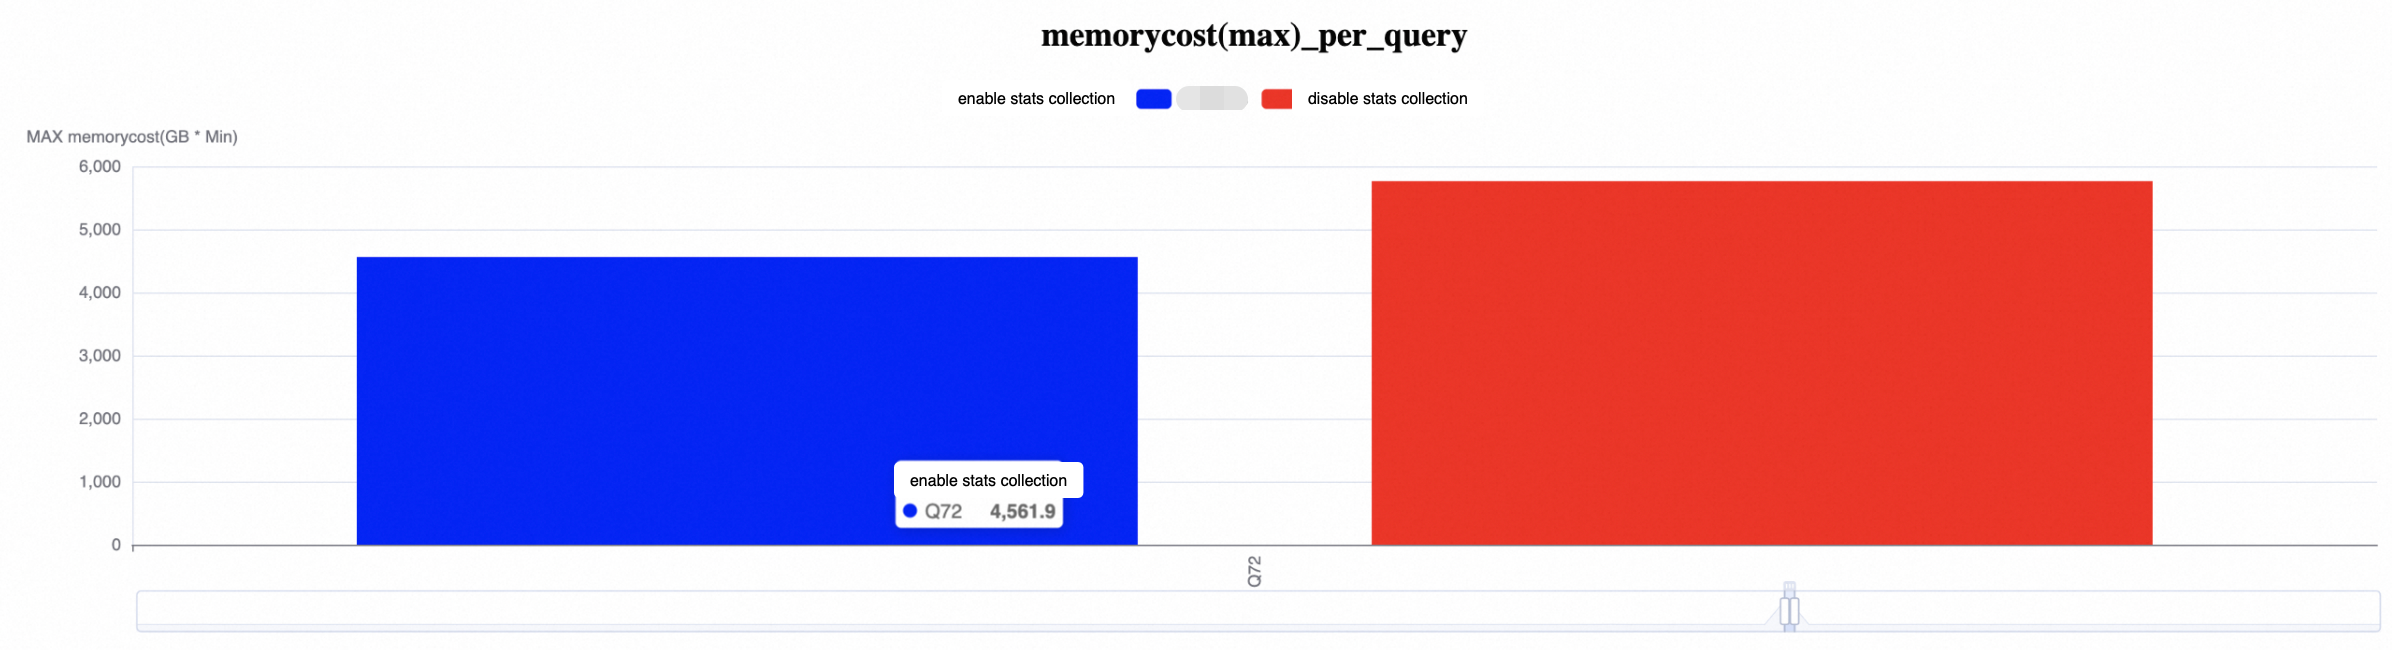
Q72 est la requête la plus lente, avec une réduction du temps d'exécution du job de 17,61 %, du CPU de 20,82 % et de la mémoire de 20,86 %.
Pour TPCDS-Q72, l'absence de statistiques sur les petites tables entraîne une dégradation significative du plan d'exécution ; l'ajout de statistiques améliore les performances jusqu'à 5 fois. Les requêtes Q3, Q18, Q19, Q72 et Q99 montrent également des améliorations notables.
Dans l'ensemble, la majorité des requêtes en tirent un bénéfice considérable. Un petit nombre de requêtes ne voient aucune amélioration du temps de bout en bout, car leurs plans d'exécution restent inchangés et elles subissent uniquement la surcharge liée à la collecte des statistiques. La latence supplémentaire introduite dans la phase de l'optimiseur varie de quelques dizaines à quelques centaines de millisecondes, avec un impact minimal sur le temps total d'exécution.
-
Toutes les requêtes
Le temps d'exécution du job a diminué de 22,75 %, l'utilisation du CPU a baissé de 21,72 % et l'utilisation de la mémoire a reculé de 24 %.



-
Q72
Q72 est la requête la plus lente, avec une réduction du temps d'exécution du job de 17,61 %, du CPU de 20,82 % et de la mémoire de 20,86 %.

Optimisation du fractionnement des tables externes
Optimisation du fractionnement des tables externes
Ajustez la taille du fractionnement pour contrôler la quantité de données traitée par chaque tâche concurrente.
Si le volume de données est important et que la taille du fractionnement est trop petite, le nombre excessif de fractions entraîne un parallélisme élevé et l'instance passe la majeure partie de son temps à attendre des ressources.
Si le volume de données est faible et que la taille du fractionnement est trop grande, le nombre insuffisant de fractions provoque un manque de concurrence et laisse des ressources inutilisées.
-- You can use either of the following parameters.

-- Unit: MiB. Default value: 256 MiB. Applies to internal or external tables.
SET odps.stage.mapper.split.size=<value>;
SELECT * FROM <tablename>;

-- Unit: MiB. Default value: 256 MiB. Applies only to external tables.
SET odps.sql.unstructured.data.split.size=<value>;
SELECT * FROM <tablename>;
Contrôle du DOP
Contrôle du parallélisme avec le DOP
Vous pouvez définir le paramètre odps.sql.split.dop pour ajuster le degré de parallélisme lors de la lecture des données. Ce paramètre a une priorité supérieure à odps.sql.mapper.split.size.
Si la valeur dop est supérieure au nombre de fichiers dans le répertoire OSS, la concurrence réelle peut différer considérablement de la valeur dop configurée.
Si la valeur dop est trop faible, elle ne prendra pas effet. Utilisez le paramètre
odps.input.file.num.limitpour modifier le nombre maximal de fichiers qu'une seule instance peut traiter.
Syntaxe
-- Syntax for the two-tier model: set odps.sql.split.dop={"project.table": xxx};
-- Syntax for the three-tier model: set odps.sql.split.dop={"project.schema.table": xxx};

SET odps.sql.split.dop={
  "project.schema.table1": xxx,
  "project.schema.table2": yyy
};

SET odps.sql.common.table.planner.ext.hive.bridge=FALSE;

SELECT * FROM <your_table>;
Exemple d'utilisation
Problème et solution concernant la distorsion du DOP causée par un trop grand nombre de petits fichiers
MaxCompute limite le traitement à un maximum de 240 fichiers par instance. Si un répertoire de table externe OSS contient 3 449 fichiers, le degré de parallélisme minimal sera de 3 449 / 240 ≈ 15. Si vous définissez le DOP sur une valeur inférieure à 15, le paramètre sera ignoré.
Pour résoudre ce problème, définissez odps.input.file.num.limit afin de modifier le nombre maximal de fichiers qu'une seule instance peut traiter.
SET odps.sql.split.dop = {"lakehouse47_3.tpch_1t_parquet_snappy.lineitem": 2};
SET odps.input.file.num.limit = 5000;
Une seule instance peut traiter jusqu'à 5 000 fichiers OSS. Comme le nombre de fichiers dans la table lineitem est bien inférieur à cette limite, le degré de parallélisme réel correspond à la valeur DOP configurée.
Écriture des données dans OSS
MaxCompute permet d'écrire dans OSS les données provenant de tables internes ou de tables externes traitées. Pour connaître les limites, consultez la section Portée.
Écrivez des données dans OSS à l'aide d'un analyseur de texte intégré ou d'un analyseur de données open source : Analyseur de texte intégré, Analyseur open source intégré.
Écrivez des données dans OSS à l'aide d'un analyseur personnalisé : Exemple : Création d'une table externe OSS à l'aide d'un analyseur personnalisé.
Écrivez des données dans OSS en utilisant la fonctionnalité de téléchargement multipartie d'OSS : Écriture de données dans OSS à l'aide de la fonctionnalité de téléchargement multipartie d'OSS.
Syntaxe
INSERT {INTO|OVERWRITE} TABLE <table_name> PARTITION (<ptcol_name>[, <ptcol_name> ...])
<select_statement> FROM <from_statement>;|
Paramètre |
Obligatoire |
Description |
|
table_name |
Oui |
Nom de la table externe dans laquelle écrire. |
|
select_statement |
Oui |
Clause |
|
from_statement |
Oui |
Clause |
Pour insérer des données dans des partitions dynamiques, consultez la rubrique Insertion ou écrasement de données dans des partitions dynamiques .
Notes
Si l'opération
INSERT OVERWRITE ... SELECT ... FROM ...;alloue 1 000 mappeurs sur la table source from_tablename, 1 000 fichiers TSV ou CSV seront générés.-
Vous pouvez contrôler le nombre de fichiers générés à l'aide des configurations fournies par MaxCompute.
Si l'outil de sortie (outputter) se trouve dans un mappeur : utilisez
odps.stage.mapper.split.sizepour contrôler le nombre de mappeurs concurrents, ce qui ajuste le nombre de fichiers générés.Si l'outil de sortie se trouve dans un réducteur ou un joiner : utilisez respectivement
odps.stage.reducer.numetodps.stage.joiner.numpour ajuster le nombre de fichiers générés.
Risque d'écritures incohérentes : lorsque vous utilisez une instruction INSERT OVERWRITE sur une table externe OSS ou la commande UNLOAD pour exporter des fichiers vers OSS, les données présentes dans le sous-répertoire de l'emplacement OSS spécifié ou correspondant à la partition sont supprimées avant l'écriture des nouvelles données. Si le répertoire d'emplacement contient des données importantes écrites directement dans OSS par d'autres moteurs externes, ces données seront également supprimées avant l'écriture des nouvelles données. Par conséquent, vous devez vous assurer que les fichiers existants dans le répertoire d'emplacement de la table externe sont sauvegardés ou que le répertoire UNLOAD est vide. Pour les autres risques liés aux écritures incohérentes, consultez la section Portée.
Écriture de données dans OSS à l'aide de la fonctionnalité de téléchargement multipartie d'OSS
Pour écrire des données dans OSS au format open source, créez une table externe avec un analyseur de données open source et activez la fonctionnalité de téléchargement multipartie d'OSS.
Pour activer la fonctionnalité de téléchargement multipartie d'OSS, configurez les éléments suivants :
Scénario | Commande |
Définir au niveau du projet | S'applique à l'ensemble du projet. |
Définir au niveau de la session | S'applique uniquement à la tâche en cours. |
La valeur par défaut de odps.sql.unstructured.oss.commit.mode est false. Les deux modes fonctionnent comme suit :
|
Valeur |
Principe |
|
false |
Les données sont stockées dans un dossier .odps situé sous le répertoire LOCATION, accompagnées d'un fichier .meta assurant la cohérence des données. Le contenu .odps ne peut être traité correctement que par MaxCompute. D'autres moteurs peuvent échouer à l'analyser. |
|
true |
MaxCompute utilise la fonctionnalité de téléchargement multipartie pour assurer la compatibilité avec d'autres moteurs de traitement de données. Il emploie une méthode de |
Gérer les fichiers exportés
Paramètres
Ajoutez un préfixe, un suffixe ou une extension aux fichiers de données de sortie à l'aide des paramètres suivants.
property_name | Scénario | Description | property_value | Valeur par défaut |
odps.external.data.output.prefix (Compatible avec odps.external.data.prefix) | Ajoutez cette propriété lorsque vous devez ajouter un préfixe personnalisé aux fichiers de sortie. |
| Une combinaison de caractères autorisés, telle que 'mc_' | Aucune |
odps.external.data.enable.extension | Ajoutez cette propriété lorsque vous devez afficher l'extension des fichiers de sortie. | True indique que l'extension du fichier de sortie est affichée. False indique qu'elle ne l'est pas. |
| False |
odps.external.data.output.suffix | Ajoutez cette propriété lorsque vous devez ajouter un suffixe personnalisé aux fichiers de sortie. | Contient uniquement des chiffres, des lettres et des underscores (a-z, A-Z, 0-9, _). | Une combinaison de caractères autorisés, telle que '_hangzhou' | Aucune |
odps.external.data.output.explicit.extension | Ajoutez cette propriété lorsque vous devez ajouter une extension personnalisée aux fichiers de sortie. |
| Une combinaison de caractères autorisés, telle que "jsonl" | Aucune |
Exemples
-
Définissez le préfixe personnalisé pour les fichiers écrits dans OSS sur
test06_. La DDL est la suivante :CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom prefix. 'odps.external.data.output.prefix'='test06_') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Après l'écriture des données, les fichiers générés dans OSS sont nommés avec le préfixe personnalisé
test06_, par exempletest06_202509101. -
Pour personnaliser le suffixe des fichiers écrits dans OSS en tant que
_beijing, la DDL est la suivante :CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom suffix. 'odps.external.data.output.suffix'='_beijing') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW'); -
Pour générer automatiquement une extension de fichier pour les fichiers de sortie, utilisez la DDL suivante :
CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Automatically generate a file extension. 'odps.external.data.enable.extension'='true') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW'); -
Pour personnaliser l'extension de fichier en
jsonlpour les fichiers écrits dans OSS, la DDL est la suivante :CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom file extension. 'odps.external.data.output.explicit.extension'='jsonl') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Le nom de fichier généré est
20250905072538695g3mlopvxicr4_M1_1_0_0-0_TableSink1.jsonl, avec l'extension de fichier personnalisée.jsonl. -
Pour les fichiers écrits dans OSS, définissez le préfixe sur
mc_, le suffixe sur_beijinget l'extension de fichier surjsonl. La DDL est la suivante :CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom prefix. 'odps.external.data.output.prefix'='mc_', -- Add a custom suffix. 'odps.external.data.output.suffix'='_beijing', -- Add a custom file extension. 'odps.external.data.output.explicit.extension'='jsonl') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Le nom de fichier généré est
mc_20250905073013526gra1l214x6t6_M1_1_0_0-0_TableSink1_beijing.jsonl, où20250905073013526est l'horodatage généré par le système et la partie centrale est l'identifiant de tâche.
Écrire de gros fichiers à l'aide de partitions dynamiques
Scénario métier
Exportez les résultats de calcul d'une table ancêtre vers OSS sous forme de partitions, en les écrivant sous forme de gros fichiers (par exemple, 4 Go). Configurez le paramètre odps.adaptive.shuffle.desired.partition.size (en Mo) avec des partitions dynamiques.
Avantage : vous pouvez contrôler la taille de fichier de sortie souhaitée en configurant la valeur du paramètre.
Inconvénient : le temps d'exécution global est plus long, car l'écriture de gros fichiers réduit le degré de parallélisme, ce qui augmente le temps d'exécution.
Descriptions des métriques
-- The service.mode must be turned off.
SET odps.service.mode=off;

-- The dynamic partition capability must be enabled.
SET odps.sql.reshuffle.dynamicpt=true;

-- Set the desired data consumption for each reducer. Assume you want each file to be 4 GB.
SET odps.adaptive.shuffle.desired.partition.size=4096;
Exemple
Écrivez un fichier JSON d'environ 4 Go dans OSS.
Préparez les données de test. Utilisez la table de jeu de données public
bigdata_public_dataset.tpcds_1t.web_sales, qui fait environ 30 Go. Les données étant stockées dans un format compressé sur MaxCompute, la taille augmente après l'exportation.-
Créez une table externe JSON.
-- Sample table name: json_ext_web_sales CREATE EXTERNAL TABLE json_ext_web_sales( c_int INT , c_string STRING ) PARTITIONED BY (pt STRING) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/demo-test/'; -
Sans définir aucun paramètre, écrivez la table de test dans la table externe JSON au format de partition dynamique.
-- The service.mode must be turned off.
set odps.service.mode=off;

-- Enable the Layer 3 syntax switch.
SET odps.namespace.schema=true;

-- Write to the JSON external table in a dynamic partition format.
INSERT OVERWRITE json_ext_web_sales
PARTITION(pt)
SELECT CAST(ws_item_sk AS INT) AS c_int,
       CAST(ws_bill_customer_sk AS string) AS c_string ,
      COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt
FROM  bigdata_public_dataset.tpcds_1t.web_sales;
Deux fichiers sont stockés sur OSS, avec des tailles respectives de 2 112 Go et 2 102 Go.
-
Ajoutez le paramètre
odps.adaptive.shuffle.desired.partition.sizepour la sortie de gros fichiers et écrivez la table de test dans la table externe JSON au format de partition dynamique.-- The service.mode must be turned off. SET odps.service.mode=off; -- Enable the Layer 3 syntax switch. SET odps.namespace.schema=true; -- The dynamic partition capability must be enabled. SET odps.sql.reshuffle.dynamicpt=true; -- Set the desired data consumption for each reducer. Assume you want each file to be 4 GB. SET odps.adaptive.shuffle.desired.partition.size=4096; -- Write to the JSON external table in a dynamic partition format. INSERT OVERWRITE json_ext_web_sales PARTITION(pt) SELECT CAST(ws_item_sk AS INT) AS c_int, CAST(ws_bill_customer_sk AS string) AS c_string , COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt FROM bigdata_public_dataset.tpcds_1t.web_sales;Le fichier de données unique généré a une taille d'environ 4 214 Go.
Opérations de partition sur les tables externes OSS
Les tables externes OSS prennent en charge les opérations de partition. Opérations de partition sur les tables externes OSS et Opérations de partition sur les tables internes. Le tableau suivant répertorie les opérations prises en charge.
|
Opération |
Prise en charge |
|
Ajouter une partition |
|
|
Modifier l'heure de mise à jour de la partition |
|
|
Modifier la valeur de la partition |
|
|
Fusionner des partitions |
|
|
Lister les partitions |
|
|
Afficher les informations de partition |
|
|
Supprimer une partition |
|
|
Vider une partition |
|
Importer depuis ou exporter vers OSS
Commande LOAD : importe des données depuis un stockage externe, tel qu'OSS, dans une table ou une partition MaxCompute.
Commande UNLOAD : exporte des données d'un projet MaxCompute vers un stockage externe, tel qu'OSS, pour une utilisation par d'autres moteurs de calcul.
Annexe : Préparer les exemples de données
-
Préparer les répertoires OSS
Les informations fournies concernant les exemples de données sont les suivantes :
oss_endpoint :
oss-cn-hangzhou-internal.aliyuncs.com, soit Chine (Hangzhou).Nom du bucket :
oss-mc-test.Noms des répertoires :
Demo1/,Demo2/,Demo3/etSampleData/.
-
Données de table non partitionnée
Le fichier téléchargé dans le répertoire
Demo1/est vehicle.csv, qui contient les données suivantes. Le répertoireDemo1/est utilisé pour mapper une table non partitionnée créée avec l'analyseur de données texte intégré.1,1,51,1,46.81006,-92.08174,9/14/2014 0:00,S 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00,W 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00,S 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00,S 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00,N 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00,SW 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00,NE 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00,N -
Données de table partitionnée
Le répertoire
Demo2/contient cinq sous-répertoires :direction=N/,direction=NE/,direction=S/,direction=SW/etdirection=W/. Les fichiers téléchargés sont respectivement vehicle1.csv, vehicle2.csv, vehicle3.csv, vehicle4.csv et vehicle5.csv. Ces fichiers contiennent les données suivantes. Le répertoireDemo2/est utilisé pour mapper une table partitionnée créée avec l'analyseur de données texte intégré.--vehicle1.csv 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle2.csv 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle3.csv 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle4.csv 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle5.csv 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00 -
Données compressées
Le fichier téléchargé dans le répertoire
Demo3/est vehicle.csv.gz. Le fichier contenu dans le package compressé est vehicle.csv, qui a le même contenu que le fichier du répertoireDemo1/. Il est utilisé pour mapper une table externe OSS avec des propriétés de compression. -
Données d'analyseur personnalisé
Le fichier téléchargé dans le répertoire
SampleData/est vehicle6.csv, qui contient les données suivantes. Le répertoireSampleData/est utilisé pour mapper une table externe OSS créée avec un analyseur de données open source.1|1|51|1|46.81006|-92.08174|9/14/2014 0:00|S 1|2|13|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|3|48|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|4|30|1|46.81006|-92.08174|9/14/2014 0:00|W 1|5|47|1|46.81006|-92.08174|9/14/2014 0:00|S 1|6|9|1|46.81006|-92.08174|9/14/2014 0:00|S 1|7|53|1|46.81006|-92.08174|9/14/2014 0:00|N 1|8|63|1|46.81006|-92.08174|9/14/2014 0:00|SW 1|9|4|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|10|31|1|46.81006|-92.08174|9/14/2014 0:00|N
FAQ sur les tables externes OSS
Comment résoudre l'erreur « Inline data exceeds the maximum allowed size » lors du traitement des données OSS à l'aide d'une table externe ?
-
Problème
Lors du traitement des données OSS, l'erreur
Inline data exceeds the maximum allowed sizeest signalée. -
Cause
OSS Store impose une limite de taille pour chaque petit fichier. Une erreur est signalée si un fichier dépasse 3 Go.
-
Solution
Ajustez les deux propriétés suivantes pour contrôler la taille des données que chaque réducteur écrit dans la table externe, en maintenant les fichiers dans la limite de 3 Go.
set odps.sql.mapper.split.size=256; # Adjusts the size of data read by each mapper, in MB.
set odps.stage.reducer.num=100; # Adjusts the number of workers in the reduce stage.
Comment résoudre une erreur de dépassement de mémoire survenant après le chargement d'une UDF pour accéder à une table externe OSS sur MaxCompute, alors que la UDF a réussi les tests locaux ?
-
Problème
Lors de l'accès à une table externe OSS sur MaxCompute, une UDF ayant passé avec succès les tests locaux renvoie l'erreur suivante après son chargement.
FAILED: ODPS-0123131:User defined function exception - Traceback:
java.lang.OutOfMemoryError: Java heap space
Après avoir défini les paramètres suivants, le temps d'exécution augmente, mais l'erreur persiste.
set odps.stage.mapper.mem = 2048; set odps.stage.mapper.jvm.mem = 4096; -
Cause
La table externe contient un nombre excessif de fichiers objets, ce qui entraîne une consommation mémoire trop importante. De plus, aucune partition n'est configurée.
-
Solution
Utilisez un volume de données réduit pour la requête.
Partitionnez les fichiers objets afin de diminuer l'utilisation de la mémoire.
Comment fusionner plusieurs petits fichiers en un seul fichier à l'aide d'une table externe OSS ?
Consultez le journal Logview pour vérifier si la dernière étape du plan d'exécution SQL est un reducer ou un joiner.
S'il s'agit d'un reducer, exécutez l'instruction
set odps.stage.reducer.num=1;S'il s'agit d'un joiner, exécutez l'instruction
set odps.stage.joiner.num=1;
Comment résoudre l'erreur « Couldn't connect to server » lors de la lecture d'une table externe OSS ?
-
Problème
Lors de la lecture des données depuis une table externe OSS, l'erreur
ODPS-0123131:User defined function exception - common/io/oss/oss_client.cpp(95): OSSRequestException: req_id: , http status code: -998, error code: HttpIoError, message: Couldn't connect to serverest signalée. -
Cause
Cause 1 : Lors de la création de la table externe OSS, un endpoint public a été utilisé pour le paramètre
oss_endpointdans l'adresse oss_location, au lieu d'un endpoint interne.Cause 2 : Lors de la création de la table externe OSS, l'endpoint d'une autre région a été utilisé pour le paramètre
oss_endpointdans l'adresse oss_location.
-
Solution
-
Pour la cause 1
Vérifiez que le paramètre
oss_endpointdans oss_location correspond à un endpoint interne. S'il s'agit d'un endpoint public, remplacez-le par un endpoint interne. Consultez la section Paramètres.Par exemple, si un utilisateur de la région Indonésie (Jakarta) a utilisé l'adresse
oss://oss-ap-southeast-5.aliyuncs.com/<bucket>/....pour créer une table externe, il doit la remplacer par l'adresse interne correspondanteoss://oss-ap-southeast-5-internal.aliyuncs.com/<bucket>/..... -
Pour la cause 2
Vérifiez que le paramètre
oss_endpointdans oss_location correspond à la région que vous souhaitez atteindre. Les noms de domaine du réseau classique OSS sont répertoriés dans la section Régions et endpoints.
-
Comment résoudre l'erreur « Network is unreachable (connect failed) » lors de la création d'une table externe OSS ?
-
Problème
Lors de la création d'une table externe OSS, l'erreur
ODPS-0130071:[1,1] Semantic analysis exception - external table checking failure, error message: Cannot connect to the endpoint 'oss-cn-beijing.aliyuncs.com': Connect to bucket.oss-cn-beijing.aliyuncs.com:80 [bucket.oss-cn-beijing.aliyuncs.com] failed: Network is unreachable (connect failed)est signalée. -
Cause
Lors de la création de la table externe OSS, un endpoint public a été utilisé pour le paramètre
oss_endpointdans l'adresse oss_location, au lieu d'un endpoint interne. -
Solution
Vérifiez que le paramètre
oss_endpointdans oss_location correspond à un endpoint interne. S'il s'agit d'un endpoint public, remplacez-le par un endpoint interne. Consultez la section Paramètres.Par exemple, si un utilisateur de la région Chine (Pékin) a utilisé l'adresse
oss://oss-cn-beijing.aliyuncs.com/<bucket>/....pour créer une table externe, il doit la remplacer par l'adresse interne correspondanteoss://oss-cn-beijing-internal.aliyuncs.com/<bucket>/.....
Comment résoudre la lenteur d'exécution des jobs SQL sur une table externe OSS ?
-
Lecture lente des fichiers compressés GZ dans une table externe OSS
-
Symptômes
Un utilisateur a créé une table externe OSS dont la source de données est un fichier compressé GZ de 200 Go stocké dans OSS. Le processus de lecture des données est lent.
-
Cause
La vitesse de traitement SQL est faible car un nombre insuffisant de mappers exécutent les calculs lors de l'étape map.
-
Solution
-
Pour les données structurées, vous pouvez définir le paramètre suivant afin d'ajuster le volume de données lu par un seul mapper et ainsi accélérer l'exécution SQL.
set odps.sql.mapper.split.size=256; # Adjusts the size of table data read by each mapper, in MB. Pour les données non structurées, vérifiez s'il n'y a qu'un seul fichier OSS dans le chemin de la table externe OSS. Si c'est le cas, un seul mapper peut être généré, car les données non structurées au format compressé ne peuvent pas être fractionnées. Cela entraîne une lenteur du traitement. Nous vous recommandons de diviser le fichier OSS volumineux en fichiers plus petits dans le chemin correspondant de la table externe sur OSS. Cette opération augmente le nombre de mappers générés lors de la lecture de la table externe et améliore la vitesse de lecture.
-
-
-
Recherche lente des données de table externe MaxCompute à l'aide d'un SDK
-
Symptômes
La recherche des données de table externe MaxCompute à l'aide d'un SDK est lente.
-
Solution
Les tables externes ne prennent en charge que les analyses complètes de table, ce qui est lent. Utilisez plutôt une table interne MaxCompute.
-
Comment résoudre le problème de suppression des anciennes données sans écriture des nouvelles données lors de l'utilisation de la fonctionnalité de chargement multipartie OSS ?
-
Problème
Dans un scénario
insert overwrite, si le job échoue dans des cas extrêmes, le résultat peut ne pas correspondre aux attentes. Les anciennes données sont supprimées, mais les nouvelles données ne sont pas écrites. -
Cause
L'écriture des nouvelles données dans la table cible échoue en raison d'une défaillance matérielle ou d'un échec de mise à jour des métadonnées, événements très rares. L'opération de suppression dans OSS ne prend pas en charge la restauration, de sorte que les anciennes données supprimées ne peuvent pas être récupérées.
-
Solution
Si vous écrasez une table externe OSS en vous basant sur ses anciennes données, par exemple avec la commande
insert overwrite table T select * from table T;, sauvegardez préalablement les données OSS. En cas d'échec du job, vous pourrez alors écraser la table externe OSS à partir des anciennes données sauvegardées.Si le job
insert overwritepeut être resoumis, contentez-vous de le resoumettre en cas d'échec.
Solution à l'erreur « table not found » lors de l'accès à une table externe OSS depuis Spark
-
Problème
Lors de l'utilisation de Spark pour accéder à une table externe OSS, la tâche échoue avec une erreur « table not found ».
-
Solution
-
Ajoutez les paramètres suivants :
Activez la configuration des tables externes : spark.sql.catalog.odps.enableExternalTable=true ;
Configurez la région où se trouve OSS : spark.hadoop.odps.oss.region.default=cn-<region>
-
Si l'erreur persiste après l'ajout des paramètres ci-dessus :
at java.lang.Thread.run(Thread.java:745)
Caused by: java.lang.Exception: com.aliyun.odps.cupid.CupidException: connectionId and rolearn are mutually exclusive
    at com.aliyun.odps.cupid.table.v1.commontable.impl.reader.CupidCommonTableReadSession.splitTable
Recréez la table externe OSS, puis accédez-y à nouveau.
-
Références
-
Formats de tables externes OSS pris en charge :
Créez une table externe OSS et lisez ou écrivez des données dans OSS à l'aide d'un analyseur personnalisé : Analyseurs personnalisés.
Analysez un fichier OSS en un jeu de données doté d'un schéma prenant en charge le filtrage et le traitement des colonnes : Fonctionnalité spéciale : Requête sans schéma.