MaxCompute prend en charge l'écriture de données en temps réel et la mise à jour des clés primaires en quelques minutes grâce aux tables Delta, réduisant ainsi la latence entre l'ingestion des données et leur disponibilité pour les requêtes à 5–10 minutes.
Les pipelines par lots traditionnels ne rendent les données visibles que le lendemain, ce qui est trop lent pour les événements sensibles au temps, tels que les journaux de comportement des clients, les commentaires, les évaluations ou les mentions « J'aime » autour de contenus viraux. L'ingestion en temps quasi réel synchronise les données incrémentielles vers une table Delta en quelques minutes. Si vous disposez déjà d'une tâche de production écrivant dans la couche de stockage de données opérationnelles (ODS) sur MaxCompute, utilisez la fonctionnalité UPSERT des tables Delta pour ingérer les données sans modifier cette tâche. La fonction UPSERT évite les doublons, améliore l'efficacité du stockage et réduit les coûts associés.
Fonctionnement de l'ingestion en temps quasi réel
Cette solution utilise le connecteur Flink pour écrire des données en continu dans une table Delta MaxCompute via une session upsert gérée par le service Tunnel.

Écriture des données Flink dans une table Delta
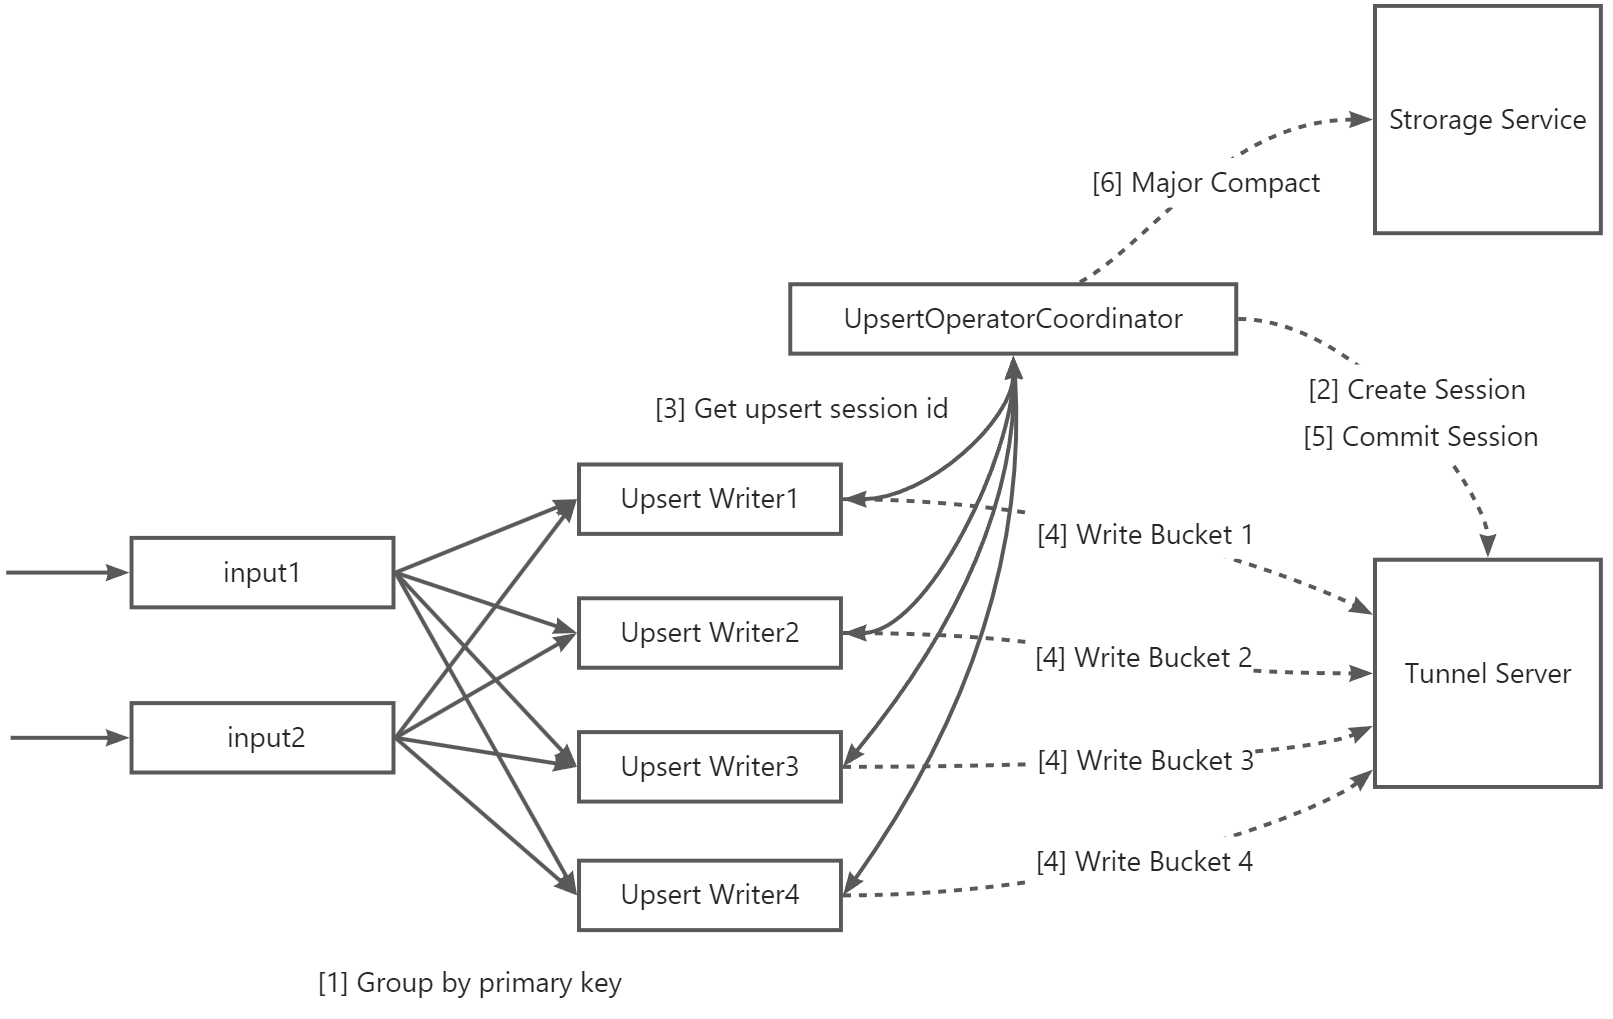
Le connecteur Flink écrit les données dans une table Delta MaxCompute selon un processus en six étapes.
| Étape | Description |
|---|---|
| 1 | Regroupez les données par clé primaire et écrivez-les simultanément dans la table. À titre alternatif, regroupez les données par colonne de clé de partition lorsque : les données sont écrites simultanément dans un grand nombre de partitions, elles sont réparties uniformément entre les partitions et la table comporte moins de 10 buckets. |
| 2 | UpsertWriterTask analyse les partitions auxquelles appartiennent les données et envoie une requête à UpsertOperatorCoordinator. Ce dernier crée une session upsert pour les écritures en temps réel dans ces partitions. |
| 3 | UpsertOperatorCoordinator renvoie l'ID de session upsert à UpsertWriterTask. |
| 4 | UpsertWriterTask crée un Upsert Writer basé sur la session et se connecte au serveur Tunnel MaxCompute pour écrire les données en continu. En mode cache de fichier, les données sont mises en tampon sur le disque local du nœud Flink et transmises au serveur Tunnel lorsque la taille du fichier atteint un seuil ou qu'un point de contrôle démarre. |
| 5 | Au démarrage d'un point de contrôle, Upsert Writer soumet toutes les données au serveur Tunnel et déclenche un commit. Les données deviennent visibles après la réussite du commit. |
| 6 | Si la compaction majeure automatique est activée, UpsertOperatorCoordinator initie une opération de compaction majeure vers le Storage Service lorsque le nombre de commits de partition dépasse un seuil. Avertissement
La compaction majeure peut augmenter la latence de l'importation de données en temps réel selon la taille des données de la table. Utilisez la compaction majeure automatique avec prudence. |
Pour une procédure détaillée, consultez Utilisation de Flink pour écrire des données dans une table Delta.
Optimisation des paramètres UPSERT pour le débit
Les paramètres UPSERT par défaut conviennent à la plupart des charges de travail, mais ajustez-les pour atteindre des objectifs de débit spécifiques ou stabiliser les performances lors d'un nombre élevé de partitions. Pour une référence complète des paramètres, voir Paramètres de l'instruction UPSERT.
Référence de base : buckets et parallélisme du sink
Deux paramètres déterminent votre débit maximal théorique :
Nombre de buckets : Le débit d'écriture maximal estimé est de 1 Mo/s × nombre de buckets. Définissez cette valeur en fonction de votre taux d'ingestion soutenu.
sink.parallelism: Pour des performances optimales, définissez cette valeur identique au nombre de buckets. Au minimum, le nombre de buckets doit être un multiple entier desink.parallelism.
Le nombre de buckets attribués à chaque nœud sink est : nombre de buckets ÷ sink.parallelism.
Tables non partitionnées
Cas d'utilisation : Vos données ne comportent pas de colonnes de clé de partition, ou vous écrivez dans une seule partition logique.
Si l'augmentation de sink.parallelism n'améliore pas le débit, le goulot d'étranglement se situe probablement en amont du nœud sink. Optimisez d'abord le pipeline de traitement des données en amont.
Si upsert.writer.buffer-size ÷ buckets-per-sink-node descend en dessous de 128 Ko, l'efficacité de la transmission réseau diminue. Augmentez upsert.writer.buffer-size pour retrouver des performances optimales.
Pour augmenter le débit, augmentez upsert.flush.concurrent (par défaut : 2). Surveillez les performances lors de cette augmentation : une valeur trop élevée provoque le vidage simultané de plusieurs buckets, entraînant une congestion réseau et une réduction du débit global.
Peu de partitions
Cas d'utilisation : Vous écrivez simultanément dans un petit nombre de partitions.
Appliquez les recommandations ci-dessus pour les tables non partitionnées et prenez également en compte les éléments suivants :
Lors d'un point de contrôle, les écritures dans chaque partition sont validées indépendamment, ce qui peut limiter le débit global.
La mémoire tampon maximale par nœud sink est de
upsert.writer.buffer-size × nombre de partitions. En cas d'erreur de mémoire insuffisante (OOM), réduisezupsert.writer.buffer-size.Augmentez
upsert.commit.thread-num(par défaut :16) pour paralléliser les commits lors d'un point de contrôle. Ne dépassez pas32; au-delà de ce seuil, les problèmes liés à une concurrence excessive dégradent les performances.
Nombre élevé de partitions (mode cache de fichier)
Cas d'utilisation : Vous écrivez simultanément dans un grand nombre de partitions et le temps de commit du point de contrôle constitue le goulot d'étranglement.
Appliquez les recommandations ci-dessus pour les scénarios avec peu de partitions et prenez également en compte les éléments suivants :
Les données de chaque partition sont mises en cache dans un fichier local et écrites dans MaxCompute simultanément lors d'un point de contrôle.
sink.file-cached.writer.num(par défaut :16) contrôle le nombre de partitions qu'un seul nœud sink écrit simultanément. Ne définissez pas cette valeur au-dessus de32.Le nombre effectif de buckets d'écriture concurrents est
sink.file-cached.writer.num × upsert.flush.concurrent. Ajustez ces deux paramètres conjointement, mais maintenez leur produit à un niveau suffisamment bas pour éviter la congestion réseau.
Pour la liste complète des paramètres du mode cache de fichier, voir Paramètres d'écriture des données en mode cache de fichier.
Référence des paramètres clés
| Paramètre | Valeur par défaut | Maximum recommandé | Description |
|---|---|---|---|
sink.parallelism |
— | — | Parallélisme des nœuds sink ; définissez une valeur égale au nombre de buckets |
upsert.writer.buffer-size |
— | — | Taille du tampon par bucket ; augmentez-la si le débit tombe en dessous de 128 Ko par bucket |
upsert.flush.concurrent |
2 | — | Buckets vidés simultanément ; augmentez progressivement et surveillez la congestion réseau |
upsert.commit.thread-num |
16 | 32 | Threads pour les commits de partition parallèles lors du point de contrôle ; au-delà de 32, les problèmes liés à une concurrence excessive réduisent le débit |
sink.file-cached.writer.num |
16 | 32 | Writers de partition concurrents en mode cache de fichier ; au-delà de 32, la congestion réseau réduit le débit |
Lorsque les ajustements sont inefficaces
Si les objectifs de débit ne sont toujours pas atteints après optimisation :
Le quota du groupe de ressources Tunnel public pour chaque projet est plafonné. Lorsque ce plafond est atteint, les écritures sont rejetées, ce qui réduit le débit effectif. Basculez vers un groupe de ressources Tunnel exclusif ou réduisez la concurrence.
Le pipeline de traitement des données en amont qui alimente le connecteur peut constituer le goulot d'étranglement. Profilez et optimisez le pipeline en amont.
Résilience et gestion des erreurs
Concevez votre pipeline pour gérer les modes de défaillance suivants avant le déploiement en production.
Expiration du point de contrôle avant achèvement
Erreur : Checkpoint xxx expired before completing
Un trop grand nombre de partitions sont écrites durant un seul intervalle de point de contrôle, ce qui entraîne le dépassement du délai d'expiration du point de contrôle lors de la phase de commit.
Pour résoudre ce problème :
Augmentez l'intervalle du point de contrôle Flink afin de laisser plus de temps à la phase de commit pour s'achever.
Activez le mode cache de fichier en définissant
sink.file-cached.enablesurtrue.
Pour les paramètres du mode cache de fichier, voir Annexe : Paramètres du connecteur Flink de la nouvelle version.
Perte d'OperatorEvent, déclenchement du basculement de tâche
Erreur : org.apache.flink.util.FlinkException: An OperatorEvent from an OperatorCoordinator to a task was lost. Triggering task failover to ensure consistency.
La communication entre le JobManager et le TaskManager a été interrompue. La tâche réessaie automatiquement. Si le problème persiste, augmentez les ressources de la tâche pour stabiliser la connexion.
Décalage horaire de huit heures après l'écriture des données TIMESTAMP
Le type TIMESTAMP de Flink ne contient aucune information de fuseau horaire. MaxCompute traite les valeurs TIMESTAMP entrantes comme UTC+0, puis les convertit dans le fuseau horaire configuré pour le projet lors de la lecture, ce qui produit un décalage apparent de 8 heures pour les projets UTC+8.
Remplacez les colonnes TIMESTAMP de votre table sink MaxCompute par TIMESTAMP_LTZ. TIMESTAMP_LTZ conserve le contexte du fuseau horaire tout au long du pipeline, évitant ainsi tout décalage de conversion lors de la lecture.
Erreur Tengine lors de l'écriture des données
Erreur : Une page HTML de Tengine affiche Sorry, the page you are looking for is currently unavailable.
Le service Tunnel est temporairement indisponible. Attendez que le service soit rétabli ; la tâche Flink réessaie automatiquement et reprend l'écriture une fois le Tunnel restauré.
SlotExceeded : dépassement du quota d'écriture
Erreur : java.io.IOException: RequestId=xxxxxx, ErrorCode=SlotExceeded, ErrorMessage=Your slot quota is exceeded.
Le nombre de slots d'écriture concurrents a dépassé le quota du projet. Réduisez la concurrence d'écriture (diminuez sink.parallelism) ou augmentez le parallélisme des groupes de ressources Tunnel exclusifs pour étendre le quota disponible.