Les workflows par lots traditionnels de MaxCompute importent les données incrémentielles sur plusieurs heures ou jours et nécessitent des tâches ETL de fusion complexes, ce qui entraîne une latence élevée, des coûts de stockage importants et une maintenance difficile. L'architecture intégrée pour le stockage et le traitement des données complètes et incrémentielles en quasi-temps réel résout ce problème en introduisant les tables Delta : un format de table unifié qui prend en charge les upserts via clé primaire, les requêtes de voyage dans le temps (time travel) et la gouvernance automatique des données au sein d'un système entièrement géré. Réduisez la latence des données de bout en bout de plusieurs heures ou jours à 5–10 minutes sans exécuter de pipelines ETL distincts.
Contexte
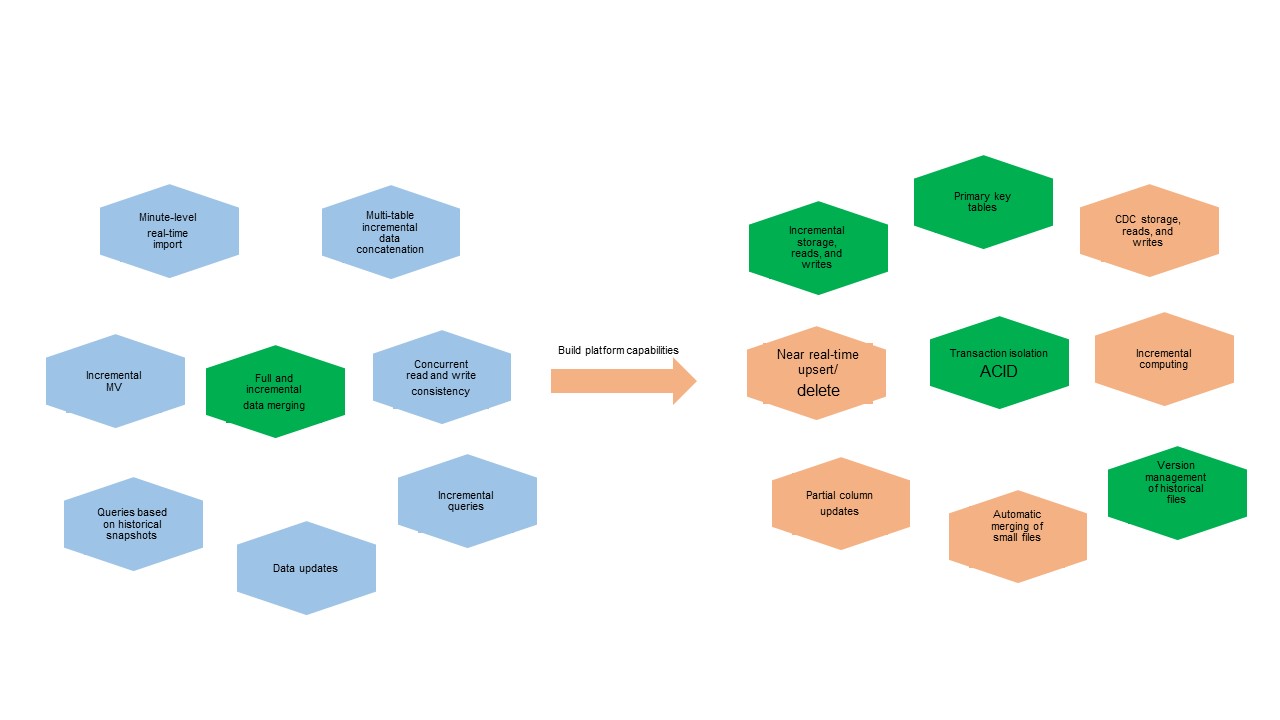
À mesure que les volumes de données augmentent et que les scénarios métier deviennent plus exigeants, l'importation de données en quasi-temps réel nécessite des moteurs de plateforme offrant une isolation des transactions et une fusion automatique des petits fichiers. La fusion des données complètes et incrémentielles exige la capacité de stocker, lire et écrire des données incrémentielles à l'aide de clés primaires.
Avant cette architecture intégrée, trois solutions antérieures répondaient à ces besoins, chacune présentant des compromis en termes de coût, de facilité d'utilisation, de latence et de débit :
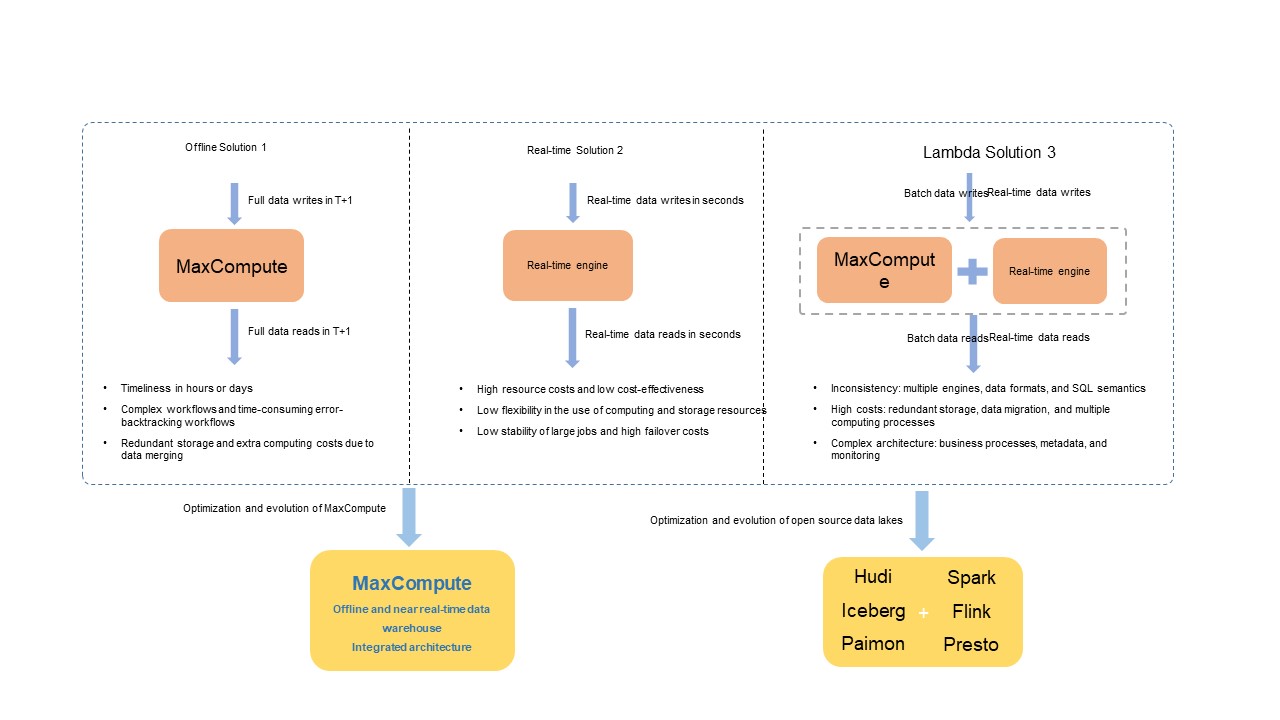
Dans l'écosystème open source, des moteurs tels que Spark, Flink et Trino — intégrés à des formats de lac de données comme Apache Hudi, Delta Lake, Apache Iceberg et Apache Paimon — résolvent des problèmes similaires dans l'architecture Lambda en combinant des moteurs de calcul ouverts avec des magasins de données unifiés.
Architecture intégrée pour le stockage et le traitement des données complètes et incrémentielles en quasi-temps réel
L'architecture intégrée de MaxCompute prend en charge une large gamme de sources de données. Importez des données complètes et incrémentielles dans un service de stockage dédié à l'aide d'outils de développement personnalisés. Un service de gestion des données backend optimise et orchestre automatiquement la structure de stockage des données. Des moteurs de calcul unifiés gèrent à la fois le traitement des données incrémentielles en quasi-temps réel et par lots. Un service de métadonnées unifié gère les métadonnées des transactions et des fichiers.
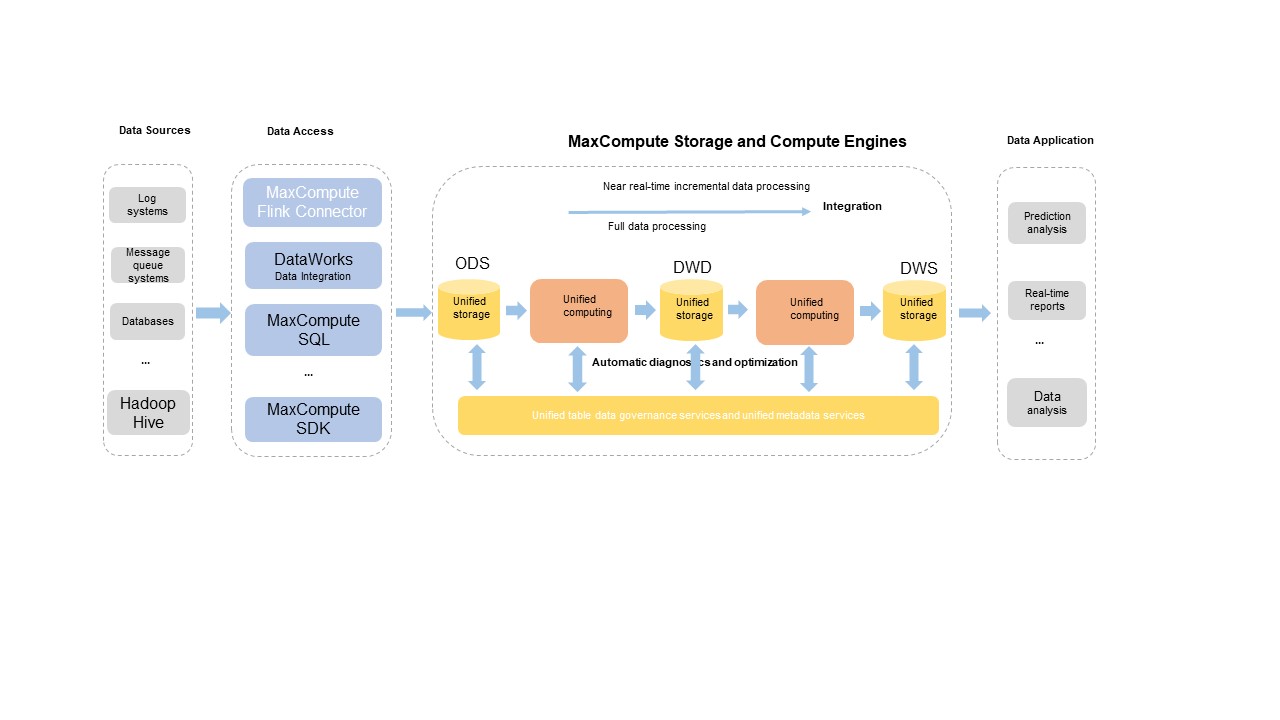
L'architecture prend en charge les fonctionnalités principales suivantes :
Tables avec clé primaire
Upserts en temps réel
Requêtes de voyage dans le temps (time travel)
Requêtes incrémentielles
Opérations du langage de manipulation de données (DML) SQL
Gouvernance et optimisation automatiques des données de table
Pour plus de détails sur le fonctionnement de l'architecture et les opérations associées, consultez la section Présentation des tables Delta et Opérations de base.
Avantages de l'architecture
L'architecture intégrée prend en charge les principales fonctionnalités communes des formats de lac de données open source tels qu'Apache Hudi et Apache Iceberg afin de faciliter la migration entre les processus métier. En tant qu'architecture native de plateforme développée par Alibaba Cloud, elle offre également les avantages suivants :
| Avantage | Description |
|---|---|
| Intégration unifiée | Utilise des services de stockage, des services de métadonnées et des moteurs de calcul unifiés pour une intégration profonde et efficace, offrant un stockage rentable, une gestion efficace des fichiers, une haute efficacité des requêtes et des requêtes de voyage dans le temps sur les données incrémentielles. |
| Syntaxe SQL complète | Fournit un système de syntaxe SQL polyvalent conçu pour prendre en charge toutes les fonctionnalités principales. |
| Outils d'importation de données optimisés | Met à disposition des outils profondément personnalisés pour l'importation de données dans des scénarios métier complexes. |
| Compatibilité transparente | S'intègre aux scénarios métier MaxCompute existants sans nécessiter de migration de données ni de coûts de stockage et de calcul supplémentaires. |
| Gestion automatisée des fichiers | Assure une gestion entièrement automatisée des fichiers pour une stabilité et des performances accrues des opérations de lecture et d'écriture, avec une optimisation automatique de l'efficacité du stockage. |
| Entièrement géré, zéro configuration | Basé sur le service entièrement géré de MaxCompute, disponible immédiatement sans coûts d'accès supplémentaires. Créez une table Delta et l'architecture prend effet immédiatement. |
| Calendrier de développement autonome | Maintient un calendrier de développement autonome et contrôlable. |
Scénarios métier
Formats de table et gouvernance des données
Création de table
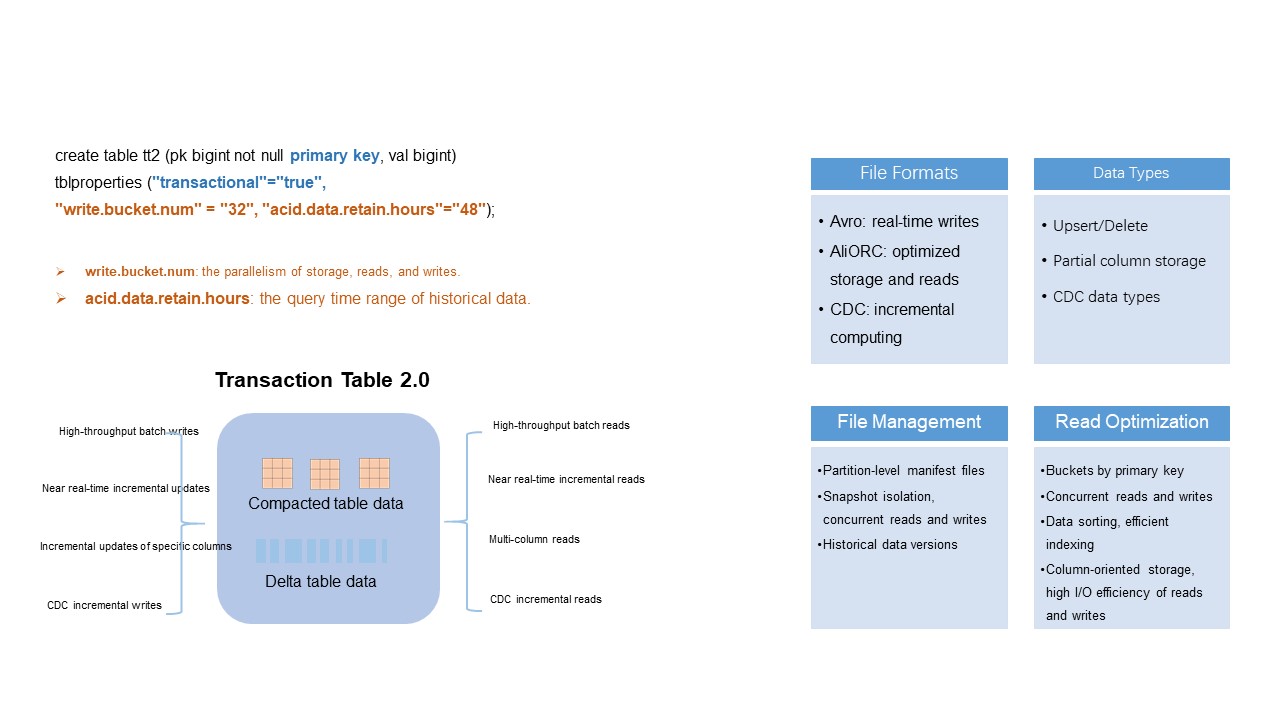
MaxCompute introduit les tables Delta avec un format de données de table unifié pour prendre en charge l'architecture intégrée. Les tables Delta prennent en charge toutes les fonctionnalités des workflows de traitement par lots existants et des nouveaux workflows tels que le stockage et le traitement des données incrémentielles en quasi-temps réel.
Pour créer une table Delta, spécifiez les clés primaires et définissez "transactional"="true" dans l'instruction CREATE TABLE :
CREATE TABLE tt2 (pk BIGINT NOT NULL PRIMARY KEY, val STRING) tblproperties ("transactional"="true");
CREATE TABLE par_tt2 (pk BIGINT NOT NULL PRIMARY KEY, val STRING)  PARTITIONED BY (pt STRING) tblproperties ("transactional"="true");
Les clés primaires garantissent l'unicité des lignes. La propriété transactional active le mécanisme de transaction ACID (atomicité, cohérence, isolation et durabilité) avec isolation par snapshot pour les opérations de lecture et d'écriture. Pour plus de détails, consultez la section Opérations sur les tables.
Paramètres clés pour les tables Delta
Pour la référence complète des paramètres, consultez la section « Paramètres des tables Delta » dans Opérations sur les tables.
write.bucket.num
Spécifie le nombre de buckets par table partitionnée ou non partitionnée, ainsi que le nombre de nœuds d'écriture concurrents. La valeur par défaut est 16. Valeurs valides : (0, 4096].
Pour les tables partitionnées : la valeur peut être modifiée et s'applique automatiquement aux nouvelles partitions.
Pour les tables non partitionnées : la valeur ne peut pas être modifiée après la création.
Un plus grand nombre de buckets augmente le parallélisme d'écriture et de requête, mais génère également davantage de petits fichiers, ce qui augmente les coûts de stockage et réduit l'efficacité de lecture. Suivez ces directives pour dimensionner les buckets :
| Scénario | Recommandation |
|---|---|
| Données < 1 Go (non partitionnées ou partitionnées) | 4–16 buckets |
| Données > 1 Go | Conservez chaque bucket entre 128 Mo et 256 Mo |
| Données > 1 To | Conservez chaque bucket entre 500 Mo et 1 Go |
| Table partitionnée avec > 500 partitions, chacune contenant quelques dizaines de Mo | 1–2 buckets par partition pour éviter la prolifération de petits fichiers |
acid.data.retain.hours
Spécifie la plage de temps des données historiques disponibles pour les requêtes de voyage dans le temps. La valeur par défaut est 24. Valeurs valides : [0, 168] (unité : heures).
Définissez sur
0pour désactiver les requêtes de voyage dans le temps et réduire considérablement les coûts de stockage des données historiques.Pour les données historiques datant de plus de 168 heures (7 jours), contactez le support technique MaxCompute.
Définissez une période de rétention adaptée à vos exigences métier. Des périodes de rétention plus longues augmentent les coûts de stockage et peuvent ralentir les requêtes. Une fois la période de rétention écoulée, le système récupère et efface automatiquement les données historiques, y compris les journaux d'opérations et les fichiers de données ; vous ne pouvez alors plus interroger ces données via le voyage dans le temps. Pour effacer de force les données historiques avant l'expiration de la période, exécutez la commande purge.
Évolution du schéma
Les tables Delta prennent en charge l'évolution complète du schéma, y compris l'ajout et la suppression de colonnes. Lors de l'interrogation de données historiques avec le voyage dans le temps, le système lit les données selon le schéma de cette version historique.
Les clés primaires ne peuvent pas être modifiées.
L'exemple suivant ajoute une colonne :
ALTER TABLE tt2 ADD columns (val2 string);Pour la syntaxe DDL complète, consultez la section Opérations sur les tables.
Formats de données de table
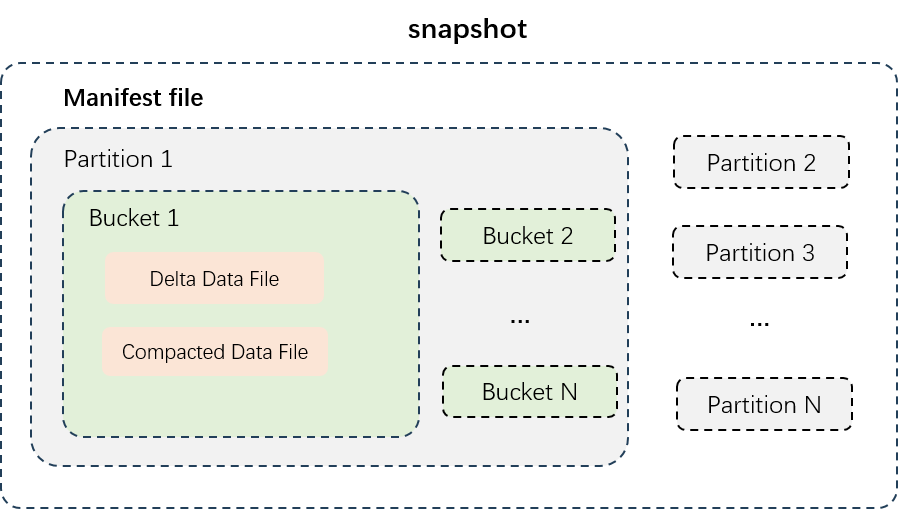
La figure ci-dessus illustre la structure de données d'une table partitionnée. Les fichiers de données sont physiquement isolés par partition (stockés dans des répertoires distincts) et les données de chaque partition sont divisées en buckets. Les tables Delta utilisent deux types de fichiers de données :
| Type de fichier | Description | Format de stockage | Idéal pour |
|---|---|---|---|
| Fichiers de données Delta | Données incrémentielles générées après chaque écriture de transaction ou fusion de petits fichiers. Stocke les données historiques intermédiaires de toutes les lignes pour prendre en charge les lectures et écritures en quasi-temps réel. | Orienté ligne (Avro) | Ingestion en quasi-temps réel ; voyage dans le temps sur les versions récentes |
| Fichiers de données compactés | Générés après la compaction des fichiers Delta. Ne conservent que le dernier enregistrement par clé primaire, sans historique intermédiaire. Optimisés pour des requêtes rapides. | Orienté colonne (AliORC) | Requêtes analytiques ; lectures par lots à haut débit |
Gouvernance et optimisation automatiques des données
Problème : prolifération des petits fichiers
Les tables Delta prennent en charge l'importation de données incrémentielles en quasi-temps réel en quelques minutes. Dans les scénarios d'écriture à fort trafic avec de nombreux buckets, le nombre de petits fichiers de données incrémentielles peut augmenter rapidement, entraînant un nombre excessif de demandes d'accès, des coûts élevés et une faible efficacité des E/S. Les opérations UPDATE et DELETE intensives aggravent encore ce problème en générant un grand nombre d'enregistrements historiques intermédiaires redondants.
Solution : quatre services de gouvernance automatisés
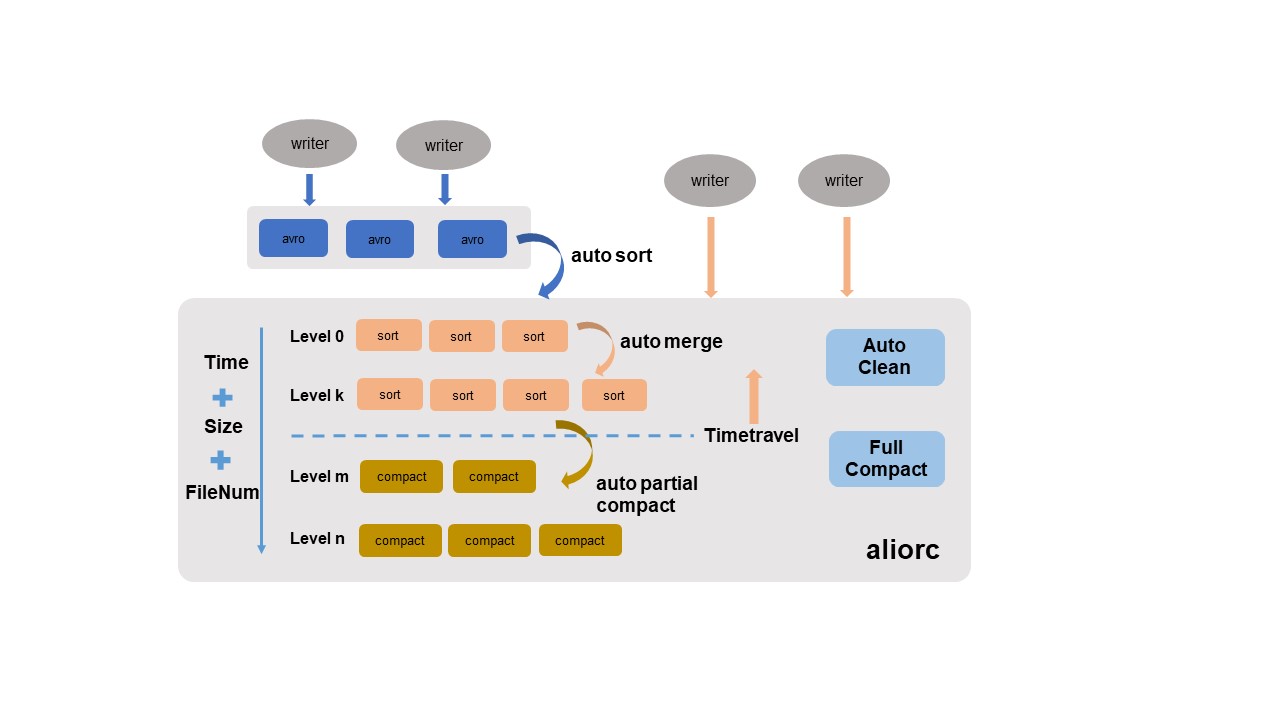
Le moteur de stockage MaxCompute gouverne et optimise automatiquement les données stockées sans configuration manuelle. Le moteur de stockage identifie intelligemment les caractéristiques des données selon plusieurs dimensions et applique automatiquement les politiques appropriées.
| Service | Fonctionnement |
|---|---|
| Auto sort | Convertit les fichiers Avro orientés ligne écrits en temps réel en fichiers AliORC orientés colonne. Réduit les coûts de stockage et améliore les performances de lecture. |
| Auto merge | Fusionne périodiquement les petits fichiers en analysant la taille des fichiers, leur quantité et la série temporelle d'écriture, puis effectue une fusion par niveau. Les données historiques intermédiaires sont préservées pour maintenir l'intégrité du voyage dans le temps. |
| Auto partial compact | Fusionne les fichiers et efface les enregistrements historiques qui se situent en dehors de la fenêtre de rétention du voyage dans le temps. Réduit les coûts de stockage liés aux charges de travail UPDATE/DELETE intensives et améliore l'efficacité de lecture. |
| Auto clean | Supprime les fichiers d'origine après qu'Auto sort, Auto merge ou Auto partial compact a généré de nouveaux fichiers de remplacement. Libère l'espace de stockage en temps réel. |
Auto partial compact efface uniquement les enregistrements historiques dont l'heure de création dépasse la fenêtre de rétention du voyage dans le temps.
Pour les scénarios nécessitant des performances de requête optimales, déclenchez manuellement une compaction majeure :
SET odps.merge.task.mode=service;
ALTER TABLE tt2 compact major;La compaction majeure consolide toutes les données de chaque bucket, efface toutes les données historiques et génère des fichiers AliORC orientés colonne. Cela entraîne une surcharge d'exécution supplémentaire et augmente les coûts de stockage des nouveaux fichiers. Utilisez-la uniquement lorsque cela est nécessaire.
Pour plus d'informations, consultez la section COMPACTION.
Écritures de données
Upserts en quasi-temps réel en quelques minutes
Pourquoi les tables Delta : Le traitement par lots traditionnel importe les données incrémentielles vers une nouvelle table ou partition sur plusieurs heures ou jours, puis déclenche un processus ETL hors ligne pour joindre et fusionner ces données incrémentielles avec les données de table existantes. Cette approche présente une latence élevée ainsi que des coûts de ressources et de stockage importants.
Avec les tables Delta, le pipeline d'upsert maintient une latence de 5 à 10 minutes entre l'écriture des données et leur interrogation. Aucun processus complexe de fusion ETL n'est requis, ce qui réduit à la fois les coûts de calcul et de stockage.
Une variété de sources de données est courante en production : bases de données, systèmes de journaux, files d'attente de messages. MaxCompute fournit un plug-in connecteur Flink open source qui fonctionne avec DataWorks Data Integration et d'autres outils d'importation de données. Il prend en charge la conception personnalisée et l'optimisation du développement pour les scénarios de haute concurrence, de tolérance aux pannes et de soumission de transactions.
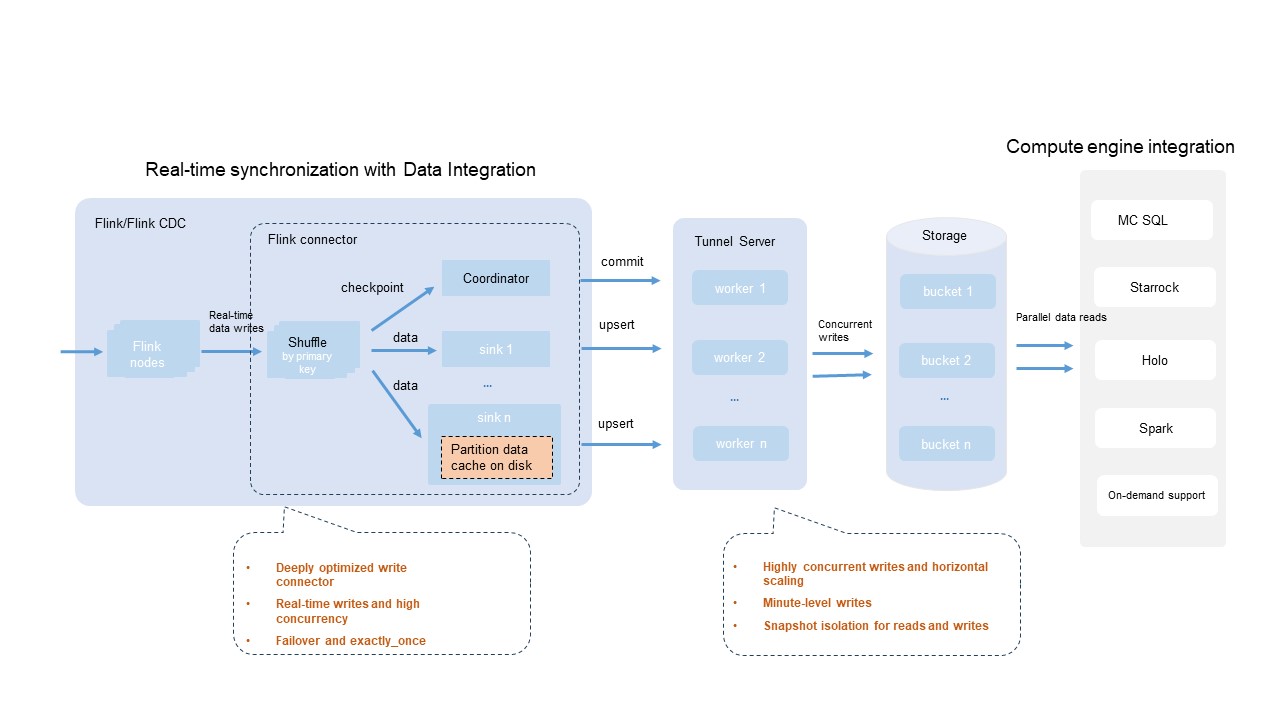
Capacités clés de l'intégration du connecteur Flink :
| Capacité | Description |
|---|---|
| Large compatibilité des moteurs | La plupart des moteurs de calcul et des outils compatibles avec l'écosystème Flink prennent en charge les déploiements Flink utilisant le connecteur Flink MaxCompute pour écrire des données dans les tables Delta en temps réel. |
| Parallélisme d'écriture configurable | Ajustez le paramètre write.bucket.num pour régler le parallélisme d'écriture. Pour des performances d'écriture optimales, définissez write.bucket.num sur un multiple entier du parallélisme du sink Flink. |
| Sémantique exactly-once | Utilise le mécanisme de checkpoint intégré de Flink pour la tolérance aux pannes, garantissant que le traitement des données suit la sémantique exactly-once. |
| Écritures de partitions à grande échelle | Prend en charge l'écriture simultanée dans des milliers de partitions. |
| Visibilité en quasi-temps réel | Les données sont visibles en quelques minutes, avec une isolation par snapshot pour les opérations de lecture et d'écriture. |
Le débit du trafic varie selon l'environnement et la configuration. Estimez le débit maximal en fonction de la capacité de traitement d'un seul bucket (1 Mo/s). Le groupe de ressources Tunnel partagé est utilisé par défaut pour MaxCompute Tunnel, ce qui peut entraîner un débit instable en cas de forte contention des ressources. Des limites sont également imposées sur la consommation de ressources.
Synchronisation de données en temps réel depuis des bases de données à l'aide de DataWorks Data Integration
De nombreux systèmes de production combinent le traitement transactionnel en ligne (OLTP), le traitement analytique en ligne (OLAP) et des moteurs d'analyse hors ligne. Un workflow courant consiste à synchroniser les nouveaux enregistrements d'une table unique ou d'une base de données entière vers MaxCompute en temps réel pour analyse.
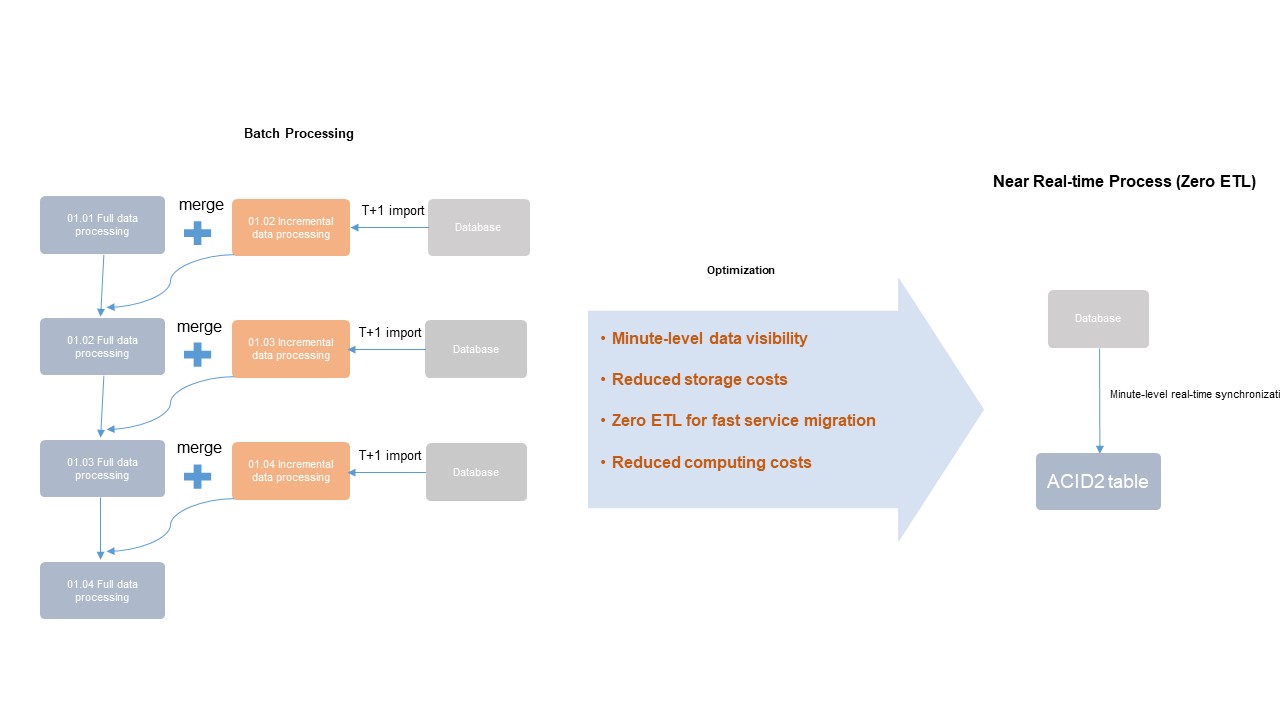
La figure ci-dessus contraste deux approches :
Gauche (traitement par lots) : Les données incrémentielles sont importées vers une nouvelle table ou partition sur plusieurs heures ou jours. Un processus ETL hors ligne joint ensuite et fusionne les données incrémentielles avec les données de table existantes. Cette approche présente une latence élevée ainsi que des coûts de ressources et de stockage importants.
Droite (architecture intégrée) : Les nouveaux enregistrements sont lus depuis les bases de données en quelques minutes. Aucune extraction ou fusion périodique des données n'est nécessaire ; les tables Delta gèrent directement les mises à jour, minimisant ainsi les coûts de calcul et de stockage.
Traitement par lots à l'aide d'instructions SQL DML et d'upserts
Les modules Compiler, Optimizer et Runtime du moteur SQL sont modifiés et optimisés pour les opérations sur les tables Delta. Cela inclut l'analyse syntaxique, les plans d'optimisation, la logique de déduplication basée sur la clé primaire et les upserts au moment de l'exécution pour fournir une prise en charge complète de la syntaxe SQL.
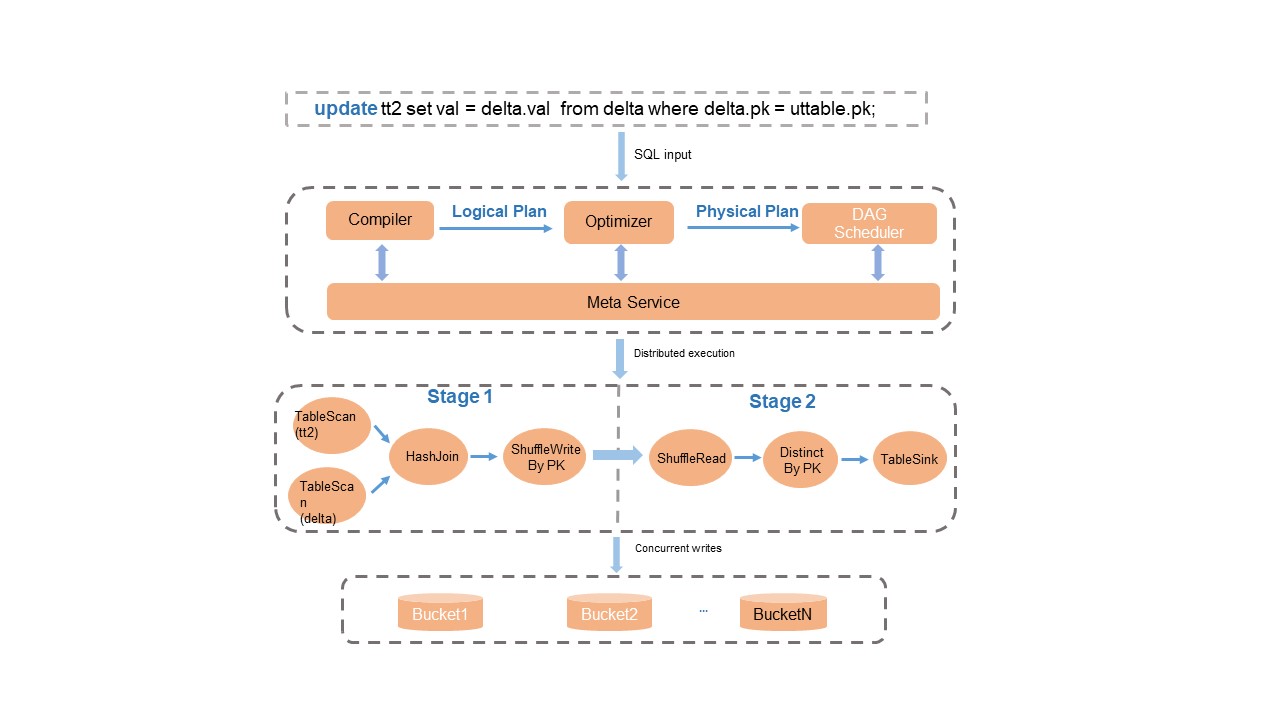
Comportements clés :
Cohérence des transactions : Une fois le traitement des données terminé, le service de métadonnées effectue la détection des conflits de transactions et les mises à jour atomiques des métadonnées, garantissant l'isolation en lecture/écriture et la cohérence des transactions.
Upserts simplifiés : Le système fusionne automatiquement les enregistrements basés sur les clés primaires lors des requêtes sur les tables Delta. Pour les scénarios mélangeant les opérations INSERT et UPDATE, utilisez
INSERT INTOau lieu de la syntaxe complexeUPDATEouMERGE INTO; cela réduit les E/S de lecture et économise les ressources de calcul.
Pour la syntaxe DML SQL complète, consultez la section Opérations DML.
Requêtes de données
Requêtes de voyage dans le temps (Time travel)
Les requêtes de voyage dans le temps vous permettent d'interroger les versions historiques d'une table Delta. Les cas d'utilisation courants incluent :
Récupération de données : Restaurez les données vers une version historique spécifiée après une modification ou une suppression accidentelle.
Retour en arrière historique : Auditez ou réanalysez les données métier à partir d'un point dans le passé.
Exemples de requêtes :
-- Query historical data at a specific timestamp.
SELECT * FROM tt2 TIMESTAMP AS OF '2024-04-01 01:00:00';
-- Query historical data from 5 minutes before the current time.
SELECT * FROM tt2 TIMESTAMP AS OF CURRENT_TIMESTAMP() - 300;
-- Query historical data from the second-to-last commit.
SELECT * FROM tt2 TIMESTAMP AS OF GET_LATEST_TIMESTAMP('tt2', 2);
La figure suivante montre le fonctionnement d'une requête de voyage dans le temps :
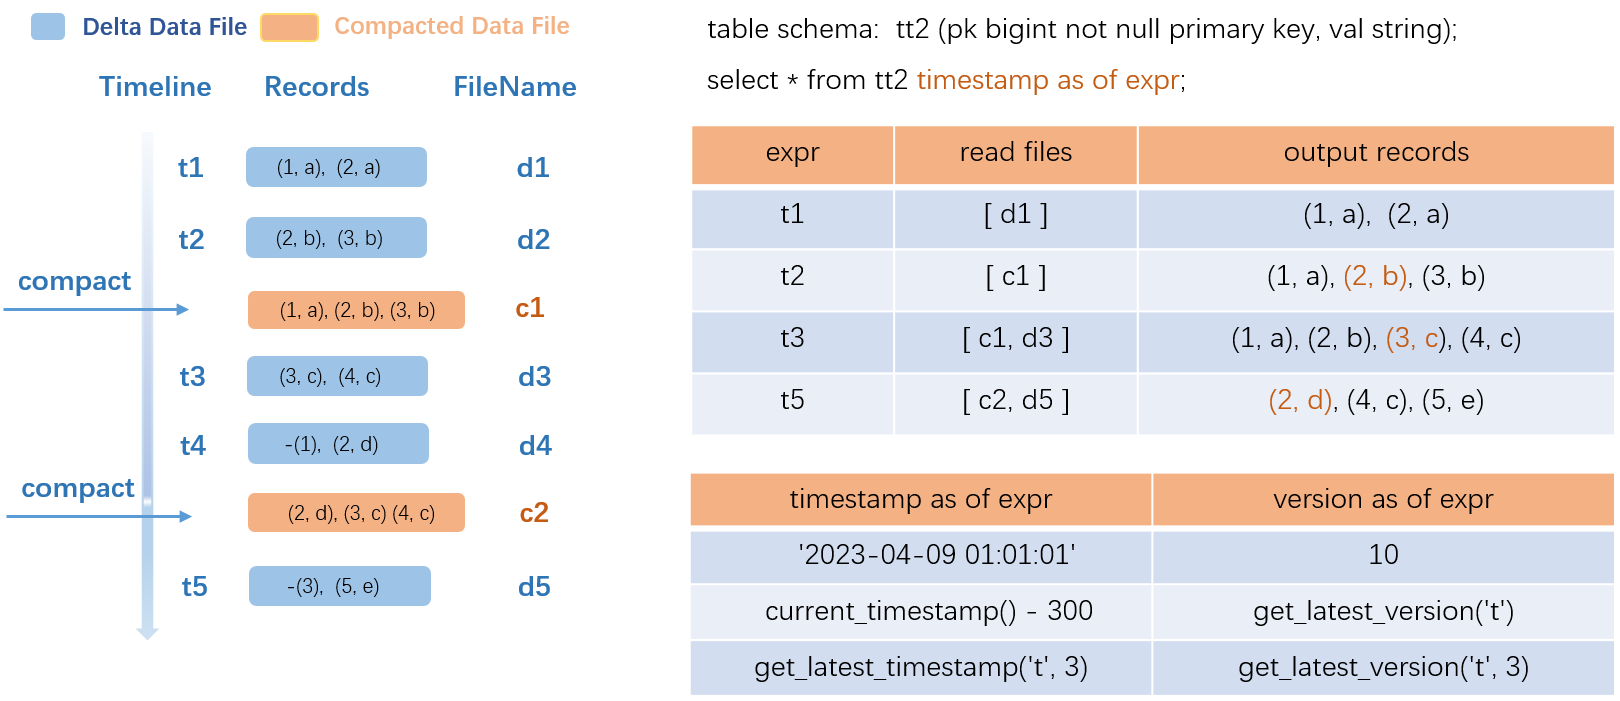
L'exemple utilise une table transactionnelle nommée src :
Côté gauche (processus de mise à jour des données) : Les transactions t1 à t5 génèrent chacune un fichier de données delta. COMPACTION s'exécute aux étapes t2 et t4, produisant les fichiers compactés c1 et c2. Dans c1, l'enregistrement historique intermédiaire
(2,a)est supprimé et le dernier enregistrement(2,b)est conservé.Résolution de requête : Pour interroger les données historiques à t1, le système lit uniquement le fichier delta d1. Pour interroger à t2, il lit le fichier compacté c1 et renvoie trois enregistrements. Pour interroger à t3, il lit c1 et le fichier delta d3, puis les fusionne pour la sortie. Une fréquence plus élevée de COMPACTION accélère les requêtes mais augmente la surcharge opérationnelle ; choisissez une politique de déclenchement adaptée à vos besoins.
La syntaxe SQL prend en charge les constantes, les fonctions courantes et les clauses TIMESTAMP AS OF expr et VERSION AS OF expr pour des requêtes historiques précises. Pour plus de détails, consultez la section Requêtes de voyage dans le temps.
Requêtes incrémentielles
MaxCompute conçoit et développe une nouvelle syntaxe SQL de requête incrémentielle pour optimiser les requêtes et le calcul incrémentiels pour les tables Delta. Après soumission d'une instruction SQL de requête incrémentielle, le moteur MaxCompute analyse les versions historiques des données incrémentielles à interroger, récupère les fichiers de données compactés pertinents, fusionne les données des fichiers et renvoie le résultat.
La figure suivante montre le processus de requête incrémentielle :
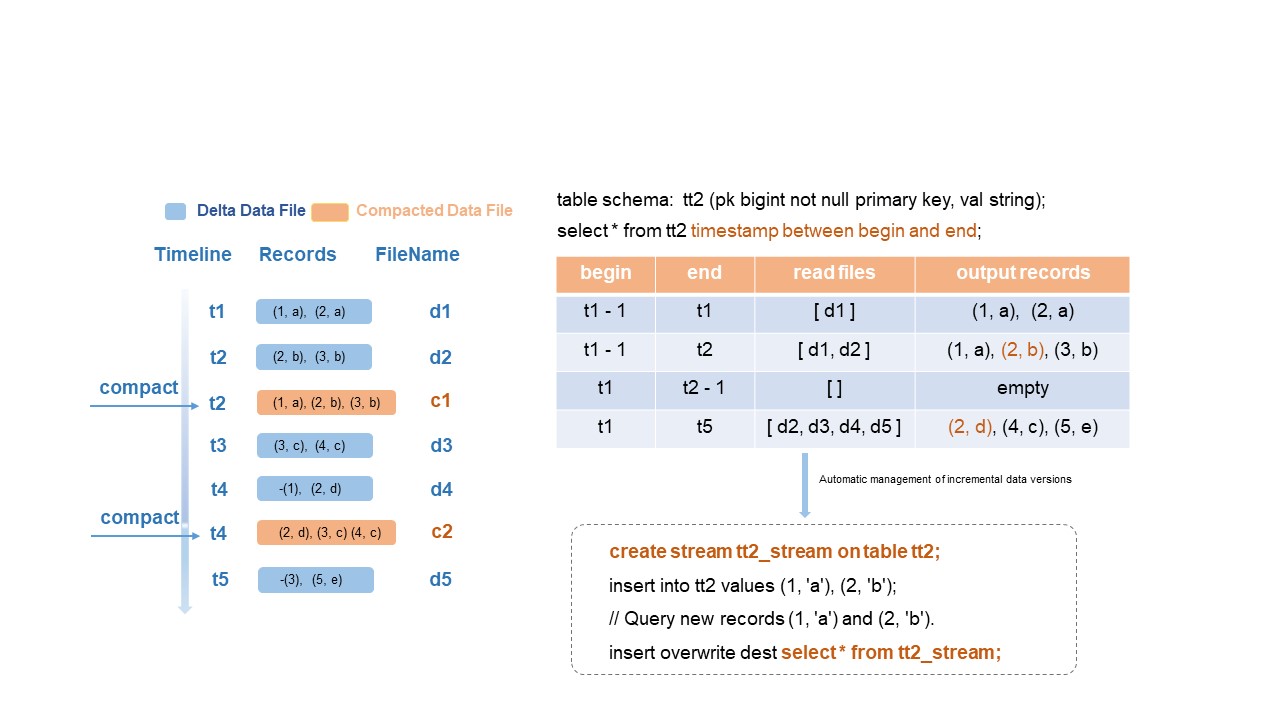
L'exemple utilise la même table transactionnelle src avec les transactions t1 à t5 et les fichiers compactés c1 (à t2) et c2 (à t4) :
Si
beginest t1-1 etendest t1, le système lit uniquement le fichier delta d1 à t1.Si
endest t2, le système lit les fichiers delta d1 et d2.Si
beginest t1 etendest t2-1, la plage de requête s'étend de t1 à t2. Aucune donnée incrémentielle n'existe dans cette plage, donc des lignes vides sont renvoyées.
Les données des fichiers compactés c1 et c2 générés par COMPACTION ne sont pas considérées comme de nouvelles données pour la sortie des requêtes incrémentielles.
Pour la syntaxe des requêtes incrémentielles et les limites des paramètres, consultez la section « Paramètres et limites des requêtes incrémentielles » dans Requêtes de voyage dans le temps et requêtes incrémentielles.
Optimisation du saut de données basé sur la clé primaire
La distribution des données et les index des tables Delta sont construits sur les valeurs des colonnes de clé primaire. Lorsque vous interrogez par clé primaire, le système filtre à plusieurs niveaux pour réduire considérablement la quantité de données lues, améliorant l'efficacité des requêtes de centaines à milliers de fois.
Exemple : Une table Delta contient 100 millions d'enregistrements. Le filtrage par une seule valeur de clé primaire peut nécessiter la lecture de seulement 10 000 enregistrements.
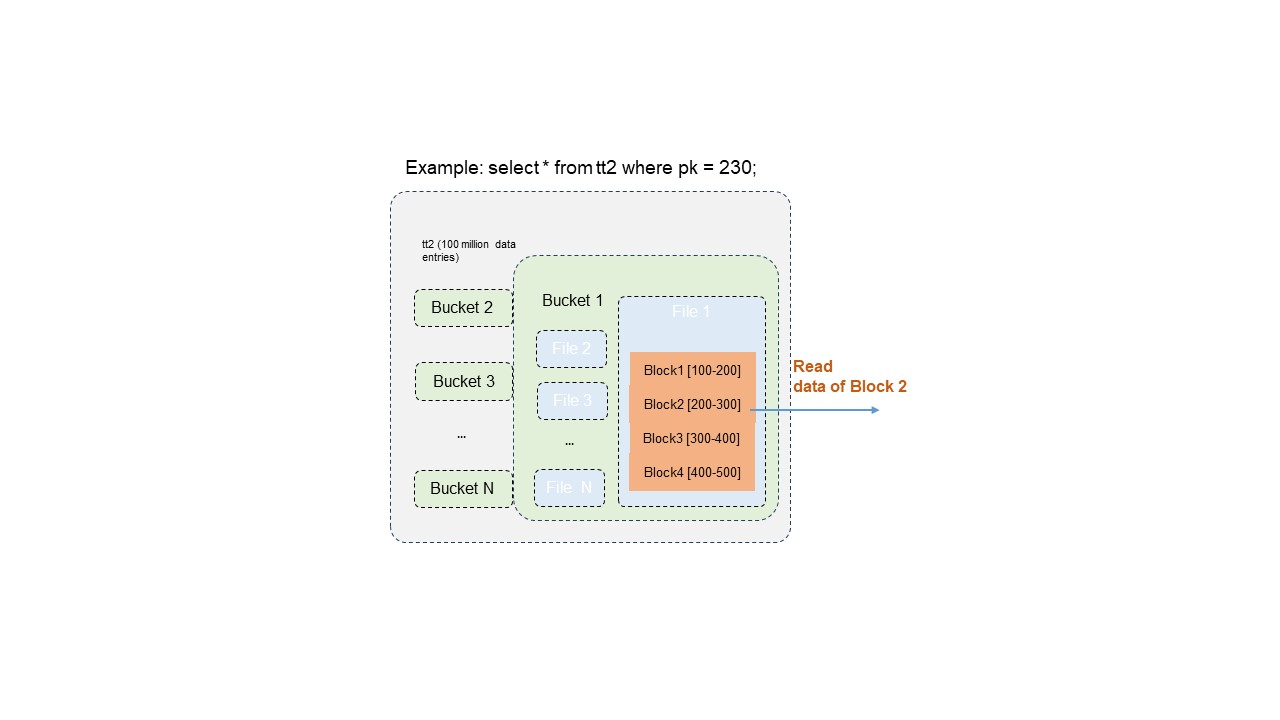
Le processus de filtrage à trois niveaux :
Élagage des buckets (Bucket pruning) : Localise le bucket contenant la clé primaire cible, éliminant ainsi l'analyse de tous les autres buckets.
Élagage des fichiers de données : Au sein du bucket cible, identifie uniquement les fichiers de données contenant la valeur de la clé primaire.
Filtrage de plage au niveau des blocs : Applique un filtrage précis basé sur la distribution des valeurs de clé primaire au sein des blocs de fichiers, extrayant uniquement les blocs contenant la valeur cible.
Optimisation des plans de requête et d'analyse SQL
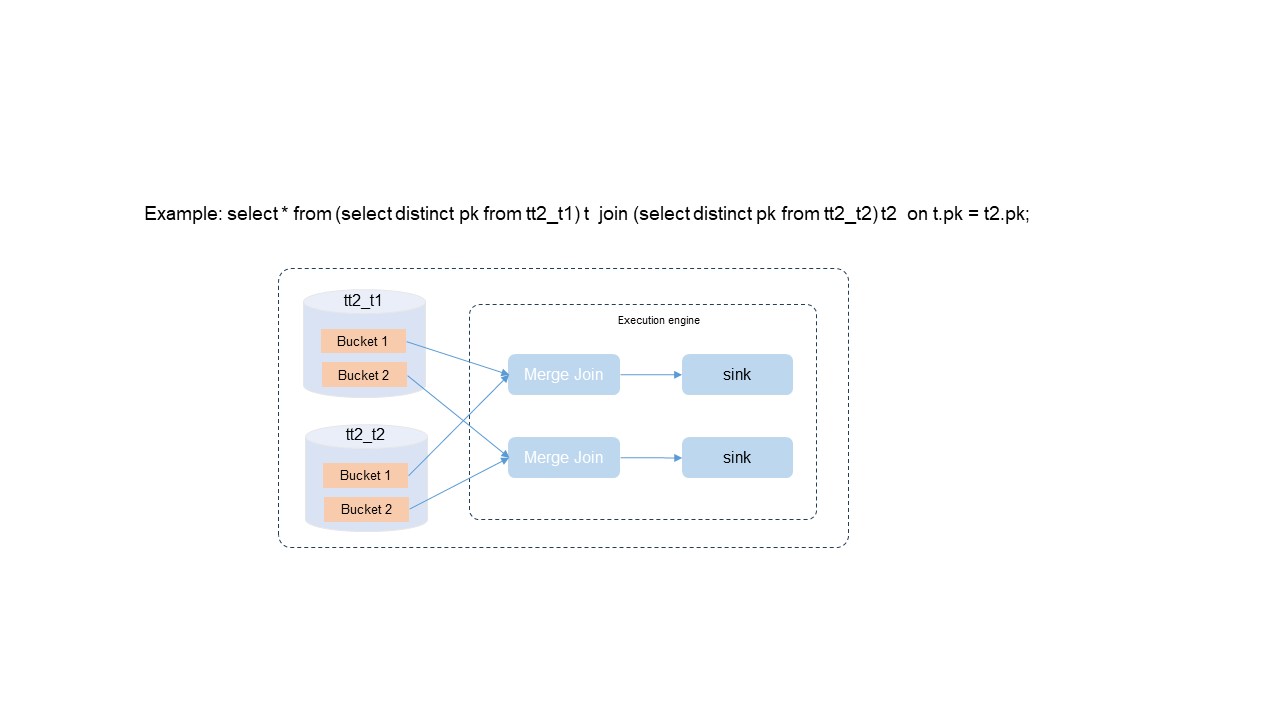
Chaque bucket d'une table Delta stocke des données uniques et triées par valeur de clé primaire. L'optimiseur SQL exploite ces propriétés pour éliminer les opérations coûteuses :
| Optimisation | Fonctionnement | Avantage |
|---|---|---|
| Élimination DISTINCT | L'unicité de la clé primaire garantit l'absence de doublons, permettant à l'optimiseur de sauter entièrement l'opération DISTINCT. | Supprime la surcharge de calcul inutile. |
| Jointure locale au bucket (Bucket local join) | Lorsque la clé de jointure correspond à la clé primaire, l'optimiseur sélectionne une politique de jointure locale au bucket plutôt qu'un brassage global (shuffle). | Réduit les échanges de données à grande échelle entre les nœuds, diminuant la consommation de ressources et améliorant le débit. |
| Merge join sans tri | Les données de chaque bucket sont déjà ordonnées par clé primaire. L'optimiseur utilise un algorithme de merge join au lieu d'un pré-tri. | Simplifie le calcul et économise les ressources de calcul. |
Après élimination de DISTINCT, du tri et du brassage global, les performances des requêtes s'améliorent de 100 %.