La vue système hologres.hg_worker_info indique la répartition des shards entre les workers et l'appartenance de chaque worker à un virtual warehouse. Utilisez-la pour diagnostiquer une utilisation inégale du CPU, signe courant d'un déséquilibre de charge, et appliquer les mesures correctives ciblées.
Limites
Seules les versions Hologres V1.3.23 et ultérieures prennent en charge
hologres.hg_worker_info. Vérifiez la version de votre instance sur la page des détails de l'instance dans la console Hologres. Si la version est antérieure à la V1.3.23, mettez à niveau l'instance manuellement ou contactez le support. Pour les instructions de mise à niveau, consultez la rubrique Mises à niveau des instances.La vue affiche uniquement l'allocation des shards en temps réel. Les données historiques d'allocation ne sont pas disponibles.
Après la création d'un groupe de tables, le champ
worker_idest renseigné avec un délai de 10 à 20 secondes. Une interrogation immédiate après la création peut renvoyer un champworker_idvide.Si un groupe de tables ne contient aucune table, aucune ressource n'est allouée aux workers. Dans ce cas,
worker_idapparaît sous la formeid/0. À partir de Hologres V2.1, les workers sans shard apparaissent également dans la vue, avec un champworker_idvide.La vue couvre uniquement la base de données actuelle. Pour obtenir une vue complète au niveau de l'instance, interrogez chaque base de données séparément et agrégez les résultats.
Afficher l'allocation des shards
La vue hologres.hg_worker_info expose quatre champs :
| Champ | Type de données | Description |
|---|---|---|
worker_id |
TEXT | ID du worker dans la base de données actuelle |
table_group_name |
TEXT | Nom du groupe de tables |
shard_id |
BIGINT | ID du shard au sein du groupe de tables |
warehouse_id |
BIGINT | ID du virtual warehouse auquel appartient le worker |
Exécutez l'instruction suivante pour afficher l'allocation actuelle des shards :
SELECT * FROM hologres.hg_worker_info;Exemple de sortie :
 worker_id  | table_group_name | shard_id
------------+------------------+----------
 bca90a00ef | tg1              |        0
 ea405b4a9c | tg1              |        1
 bca90a00ef | tg1              |        2
 ea405b4a9c | tg1              |        3
 bca90a00ef | db2_tg_default   |        0
 ea405b4a9c | db2_tg_default   |        1
 bca90a00ef | db2_tg_default   |        2
 ea405b4a9c | db2_tg_default   |        3
 ea405b4a9c | db2_tg_internal  |        3
xx_tg_internal est le groupe de tables intégré utilisé pour gérer les métadonnées. Ignorez-le lors de l'analyse de la distribution des shards.Diagnostiquer le déséquilibre de charge
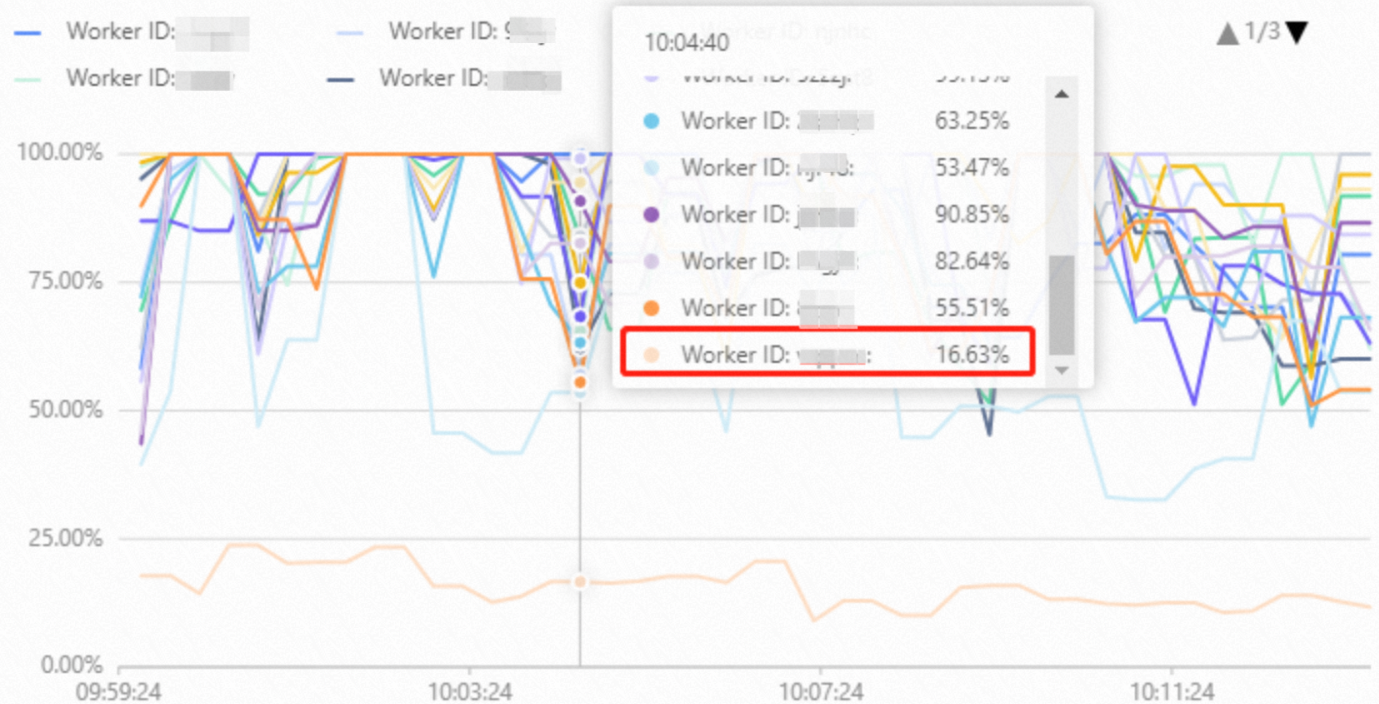
Si un ou plusieurs workers affichent une utilisation du CPU systématiquement inférieure à celle des autres, les shards peuvent ne pas être répartis uniformément. Exécutez d'abord cette requête pour vérifier le nombre de shards par worker :
SELECT worker_id, COUNT(1) AS shard_count
FROM hologres.hg_worker_info
GROUP BY worker_id;
Une instance équilibrée présente le même shard_count pour tous les workers. Si les comptes diffèrent, poursuivez l'analyse ci-dessous pour identifier la cause racine.
Corriger le déséquilibre de charge
Le déséquilibre de charge a trois causes courantes. Identifiez celle qui s'applique à votre instance, puis appliquez la correction correspondante.
Cause 1 : Redistribution inégale des shards après un basculement de worker
Lorsqu'un worker tombe en panne, par exemple en raison d'une erreur d'épuisement de la mémoire (OOM), le système déplace temporairement ses shards vers d'autres workers. Après la récupération du worker, certains shards sont ramenés, mais la redistribution peut être inégale.
Étant donné que les workers sont partagés entre toutes les bases de données d'une instance tandis que hg_worker_info n'affiche que la base de données actuelle, vérifiez chaque base de données séparément et additionnez les résultats pour obtenir le nombre total de shards par worker sur l'ensemble de l'instance.
Diagnostic
SELECT worker_id, COUNT(1) AS shard_count
FROM hologres.hg_worker_info
GROUP BY worker_id;
Exemple de sortie pour une instance à six workers :
 worker_id  | shard_count
------------+-------------
 bca90a     |      4
 ea405b     |      4
 tkn4vc     |      4
 bqw5cq     |      3
 mbbrf6     |      3
 hsx66f     |      1
(6 rows)
Les nombres de shards diffèrent considérablement d'un worker à l'autre : hsx66f ne détient qu'un seul shard tandis que les autres en détiennent trois ou quatre, soit un rapport de 4:1. Les workers disposant de moins de shards affichent généralement une utilisation du CPU plus faible dans la console Hologres.
Correction
Redémarrez l'instance. Cela déclenche un rééquilibrage complet des shards sur tous les workers. Sans redémarrage, les workers inactifs ne recevront des shards supplémentaires que si un autre worker tombe à nouveau en panne.
Cause 2 : Déséquilibre des données
Lorsque la plupart des lignes d'une table sont concentrées sur un petit nombre de shards, les workers propriétaires de ces shards traitent une quantité disproportionnée de données. Leur utilisation du CPU augmente alors brusquement, tandis que les autres workers restent sous-utilisés.
Diagnostic
Étape 1 : Vérifiez la présence d'un déséquilibre des données dans la table.
SELECT hg_shard_id, COUNT(1)
FROM <table_name>
GROUP BY hg_shard_id
ORDER BY 2;
Exemple de sortie montrant une table déséquilibrée : le shard 39 contient environ cinq fois plus de lignes que les autres.
hg_shard_id | count
-------------+--------
          53 |  29130
          65 |  28628
          66 |  26970
          70 |  28767
          77 |  28753
          24 |  30310
          15 |  29550
          39 | 164983
Étape 2 : Identifiez le worker responsable du shard déséquilibré.
Remplacez <tablename> et <shard_id> par les valeurs obtenues à l'étape précédente :
SELECT DISTINCT b.table_name, a.worker_id, a.table_group_name, a.shard_id
FROM hologres.hg_worker_info a
JOIN (
    SELECT property_value, table_name
    FROM hologres.hg_table_properties
    WHERE property_key = 'table_group'
) b
ON a.table_group_name = b.property_value
AND b.table_name = '<tablename>'
AND shard_id = <shard_id>;
Exemple de sortie :
table_name  | worker_id  | table_group_name  | shard_id
------------+------------+-------------------+----------
 table03    | bca90a00ef | db2_tg_default    |       39
Si l'utilisation du CPU de bca90a00ef est beaucoup plus élevée que celle des autres workers, le déséquilibre des données en est la cause.
Correction
Reconfigurez la clé de distribution afin que les lignes soient réparties plus uniformément entre les shards. Pour des conseils détaillés, consultez la rubrique Optimiser les performances des requêtes sur les tables internes Hologres.
Divisez les tables fortement déséquilibrées. Si les données sont intrinsèquement déséquilibrées, par exemple une table de commandes de streaming en direct où quelques streamers populaires représentent la vaste majorité du volume brut de marchandises (GMV), divisez la table selon la dimension déséquilibrée plutôt que d'essayer de la redistribuer.
Cause 3 : Nombre de shards non aligné sur le nombre de workers
Des nombres de shards qui ne sont pas des multiples du nombre de workers entraînent une allocation inégale par conception : certains workers obtiennent toujours un shard supplémentaire.
Diagnostic
SELECT table_group_name, worker_id,
       COUNT(1) AS shard_count, warehouse_id
FROM hologres.hg_worker_info
GROUP BY table_group_name, worker_id, warehouse_id
ORDER BY table_group_name DESC;
Exemple de sortie pour une instance à deux workers :
table_group_name | worker_id  | shard_count  | warehouse_id
------------------+------------+--------------+-------------
 tg2              | ea405b4a9c |           1  |           1
 tg2              | bca90a00ef |           2  |           2
 tg1              | ea405b4a9c |           5  |           1
 tg1              | bca90a00ef |           6  |           2
 db2_tg_default   | bca90a00ef |           4  |           2
 db2_tg_default   | ea405b4a9c |           4  |           1
 db2_tg_internal  | bca90a00ef |           1  |           2
(7 rows)
Analyse de la sortie :
tg2possède 3 shards répartis sur 2 workers (1 contre 2) : ce n'est pas un multiple de 2, donc un worker aura toujours plus de shards.tg1possède 11 shards répartis sur 2 workers (5 contre 6) : même problème.db2_tg_defaultpossède 8 shards répartis sur 2 workers (4 contre 4) : répartition uniforme.
Correction
Définissez le nombre de shards pour chaque groupe de tables comme un multiple du nombre de workers. Estimez la valeur appropriée en fonction de vos besoins métier, puis reconfigurez ou augmentez la capacité de l'instance en conséquence.