Hologres repose sur une architecture de découplage du stockage (Storage Disaggregation). Cette rubrique décrit la conception de cette architecture et le rôle de chaque composant.
Modèles d'architecture de stockage et de calcul
Les systèmes distribués utilisent couramment trois architectures de stockage et de calcul.
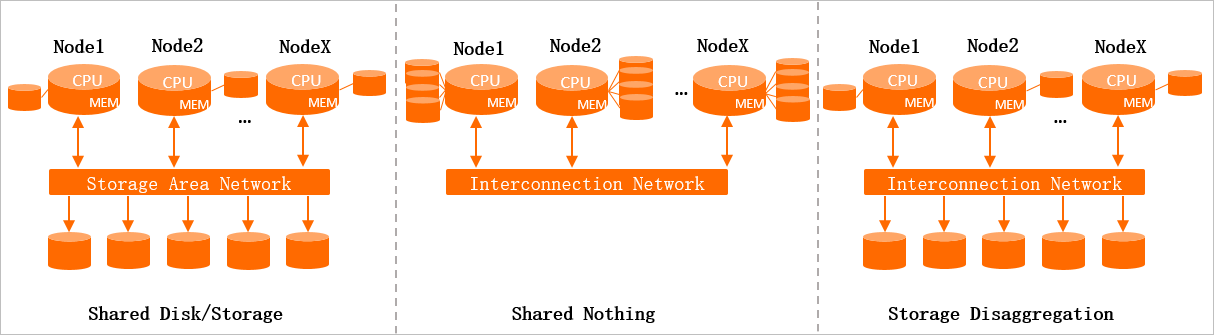
Shared Disk / Shared Storage
Tous les nœuds de travail partagent un cluster de stockage distribué. Chaque nœud accède aux données comme si elles étaient locales. Bien que le cluster de stockage soit facilement extensible, les nœuds de travail nécessitent une coordination distribuée pour maintenir la cohérence, ce qui limite le nombre maximal de nœuds.
Shared Nothing
Chaque nœud de travail monte son propre stockage local et traite les données d'un seul shard. Les nœuds communiquent entre eux et un nœud de résumé dédié agrège les résultats. Cette architecture permet une mise à l'échelle horizontale, mais présente des compromis : après un basculement, le nœud en cours de récupération doit recharger les données avant de pouvoir traiter les requêtes, et toute extension déclenche un rééquilibrage des données entre les nœuds, une opération longue.
Storage Disaggregation
Un cluster de stockage distribué est partagé, mais chaque nœud de calcul traite les données d'un shard dédié, à l'instar de l'architecture Shared Nothing, tout en maintenant un cache local. Cette architecture offre les avantages suivants :
Cohérence des données simplifiée : un seul nœud de travail écrit dans un shard à la fois, ce qui élimine la nécessité d'une coordination complexe.
Mise à l'échelle flexible : les ressources de calcul et de stockage peuvent être dimensionnées indépendamment. En cas de pic de trafic, étendez uniquement la couche de calcul sans déclencher de rééquilibrage des données.
Récupération rapide après incident : après une panne, un nouveau nœud extrait les données du stockage distribué de manière asynchrone et reprend le service rapidement.
Hologres utilise l'architecture Storage Disaggregation, qui combine la simplicité de gestion du stockage partagé avec les performances et l'évolutivité du calcul basé sur les shards. Le stockage sous-jacent est Pangu, le système de fichiers distribué d'Alibaba, qui joue un rôle similaire à celui du Hadoop Distributed File System (HDFS).
Composants de l'architecture Hologres
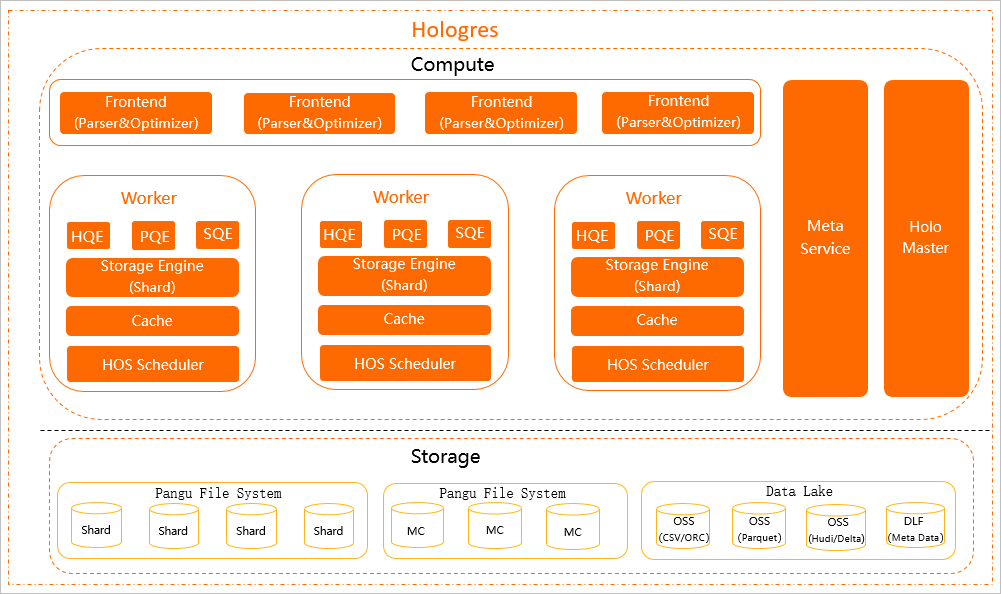
Le schéma suivant illustre l'architecture Hologres.
Couche de calcul
Frontend (FE)
Le FE authentifie, analyse et optimise les instructions SQL. Une instance Hologres exécute plusieurs FE. Hologres étant compatible avec PostgreSQL 11, vous pouvez utiliser la syntaxe standard PostgreSQL et vous connecter avec des outils de développement et des outils Business Intelligence (BI) compatibles PostgreSQL sans configuration supplémentaire.
HoloWorker
Les HoloWorkers planifient et exécutent les requêtes utilisateur. Chaque HoloWorker contient un moteur de requête (Query Engine, QE), un moteur de stockage (Storage Engine, SE), un cache et un planificateur HOS (HOS Scheduler).
Moteur de requête (QE)
HoloWorker prend en charge trois moteurs de requête, chacun répondant à une charge de travail différente.
| Moteur | Objectif | Caractéristiques principales |
|---|---|---|
| Hologres Query Engine (HQE) | Moteur principal pour les requêtes analytiques | Architecture MPP évolutive avec opérateurs vectorisés ; maximise l'utilisation du CPU pour des performances de requête élevées |
| PostgreSQL Query Engine (PQE) | Couche de compatibilité PostgreSQL | Prend en charge PostGIS et les UDF écrites en PL/Java, PL/SQL ou PL/Python ; gère les opérations non encore prises en charge par HQE |
| Seahawks Query Engine (SQE) | Intégration MaxCompute | Se connecte à MaxCompute sans migration de données ; prend en charge les tables de hachage, les tables clusterisées par plage et l'analyse interactive des données batch de niveau PB |
L'objectif à long terme est d'intégrer toutes les fonctionnalités du PQE dans le HQE.
Moteur de stockage (SE)
Le SE gère les données et traite toutes les opérations de création, lecture, mise à jour et suppression (CRUD).
Cache
Le composant Cache met en cache les résultats des requêtes pour améliorer les performances.
HOS Scheduler
HOS Scheduler fournit des capacités de planification légères.
Meta Service
Meta Service gère les métadonnées, y compris les structures de table et la distribution des données au sein du SE, et les fournit aux FE.
Holo Master
Hologres s'exécute nativement sur Kubernetes. Si un nœud de travail tombe en panne, Kubernetes provisionne un remplacement en peu de temps, maintenant ainsi la disponibilité au niveau du nœud. Holo Master surveille l'état de santé des composants au sein de chaque nœud de travail et redémarre tout composant dont l'état devient anormal, réduisant ainsi les interruptions de service.
Couche de stockage
Les données Hologres sont stockées dans Pangu, le système de fichiers distribué d'Alibaba. La couche de stockage s'intègre également à des sources de données externes :
MaxCompute : Hologres lit les données MaxCompute stockées dans Pangu. Pangu permet un accès mutuel efficace entre Hologres et MaxCompute sans déplacement de données.
Object Storage Service (OSS) et Data Lake Formation (DLF) : Hologres interroge les données dans OSS et DLF pour accélérer l'analyse dans les data lakes. Les formats pris en charge incluent CSV, ORC, Parquet, Hudi, Delta et Meta Data. Hologres peut également écrire des données dans OSS pour réduire les coûts de stockage.