Si vos données MaxCompute dépassent 200 Go et que vous visez des temps de réponse aux requêtes de l'ordre de la seconde, importez-les dans des tables internes Hologres. Contrairement à l'interrogation via des tables externes, les tables internes prennent en charge les index, ce qui améliore considérablement les performances des requêtes. Cette rubrique explique comment importer des données MaxCompute à l'aide de SQL dans différents scénarios et comment résoudre les erreurs d'épuisement de la mémoire (OOM).
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Une table MaxCompute contenant les données à importer
Une instance Hologres active connectée à votre projet MaxCompute
(Facultatif) Une connaissance du mappage des types de données entre MaxCompute et Hologres
Remarques d'utilisation
Les partitions MaxCompute et Hologres ne correspondent pas directement. Un champ de partition MaxCompute devient un champ standard dans Hologres. Vous pouvez importer les données d'une table MaxCompute partitionnée vers une table Hologres partitionnée ou non.
Hologres ne prend en charge que le partitionnement à un seul niveau. Lors de l'importation depuis une table MaxCompute à partitions multiples, mappez un seul champ de partition. Les autres champs de partition deviennent des champs standards dans Hologres.
Pour mettre à jour ou écraser les données existantes lors de l'importation, utilisez la syntaxe INSERT ON CONFLICT (UPSERT).
Après la mise à jour des données d'une table MaxCompute, le cache Hologres peut présenter une latence allant jusqu'à 10 minutes. Avant l'importation, exécutez la commande IMPORT FOREIGN SCHEMA pour actualiser les métadonnées de la table externe et récupérer les dernières données.
Privilégiez l'importation via SQL plutôt que l'intégration de données pour transférer des données MaxCompute vers Hologres. L'approche SQL offre de meilleures performances.
Importer des données depuis une table MaxCompute non partitionnée
Étape 1 : Préparer les données source
Utilisez une table MaxCompute existante ou créez-en une nouvelle. Cet exemple utilise la table customer du jeu de données public public_data dans MaxCompute. Pour plus d'informations sur l'accès aux jeux de données publics, consultez la rubrique Utiliser les jeux de données publics.
Voici l'instruction DDL de la table customer ainsi qu'un exemple de requête :
-- DDL of the table in the MaxCompute public dataset
CREATE TABLE IF NOT EXISTS public_data.customer(
  c_customer_sk BIGINT,
  c_customer_id STRING,
  c_current_cdemo_sk BIGINT,
  c_current_hdemo_sk BIGINT,
  c_current_addr_sk BIGINT,
  c_first_shipto_date_sk BIGINT,
  c_first_sales_date_sk BIGINT,
  c_salutation STRING,
  c_first_name STRING,
  c_last_name STRING,
  c_preferred_cust_flag STRING,
  c_birth_day BIGINT,
  c_birth_month BIGINT,
  c_birth_year BIGINT,
  c_birth_country STRING,
  c_login STRING,
  c_email_address STRING,
  c_last_review_date STRING,
  useless STRING);

-- Query the table to verify data
SELECT * FROM public_data.customer;
La figure suivante présente un échantillon des données.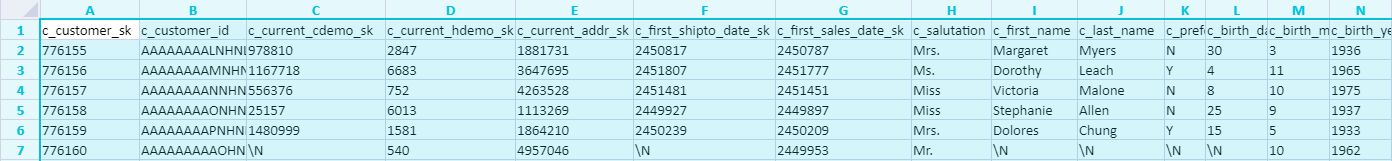
Étape 2 : Créer une table externe dans Hologres
Créez une table externe pour mapper la table source MaxCompute :
CREATE FOREIGN TABLE foreign_customer (
    "c_customer_sk" int8,
    "c_customer_id" text,
    "c_current_cdemo_sk" int8,
    "c_current_hdemo_sk" int8,
    "c_current_addr_sk" int8,
    "c_first_shipto_date_sk" int8,
    "c_first_sales_date_sk" int8,
    "c_salutation" text,
    "c_first_name" text,
    "c_last_name" text,
    "c_preferred_cust_flag" text,
    "c_birth_day" int8,
    "c_birth_month" int8,
    "c_birth_year" int8,
    "c_birth_country" text,
    "c_login" text,
    "c_email_address" text,
    "c_last_review_date" text,
    "useless" text
)
SERVER odps_server
OPTIONS (project_name 'public_data', table_name 'customer');|
Paramètre |
Description |
|
|
Le serveur de table externe. Utilisez le serveur intégré |
|
|
Le nom du projet MaxCompute où réside la table source. |
|
|
Le nom de la table MaxCompute à importer. |
Les types de données des champs dans la table externe doivent correspondre à ceux de la table MaxCompute. Pour consulter la référence de mappage, reportez-vous à la section mappage des types de données entre MaxCompute et Hologres.
Étape 3 : Créer une table interne dans Hologres
Créez une table interne pour recevoir les données importées. Définissez des index appropriés afin d'optimiser les performances des requêtes. Pour plus de détails sur les propriétés des tables, consultez la rubrique CREATE TABLE.
-- Create a column-oriented internal table
BEGIN;
CREATE TABLE public.holo_customer (
 "c_customer_sk" int8,
 "c_customer_id" text,
 "c_current_cdemo_sk" int8,
 "c_current_hdemo_sk" int8,
 "c_current_addr_sk" int8,
 "c_first_shipto_date_sk" int8,
 "c_first_sales_date_sk" int8,
 "c_salutation" text,
 "c_first_name" text,
 "c_last_name" text,
 "c_preferred_cust_flag" text,
 "c_birth_day" int8,
 "c_birth_month" int8,
 "c_birth_year" int8,
 "c_birth_country" text,
 "c_login" text,
 "c_email_address" text,
 "c_last_review_date" text,
 "useless" text
);
CALL SET_TABLE_PROPERTY('public.holo_customer', 'orientation', 'column');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'bitmap_columns', 'c_customer_id,c_salutation,c_first_name,c_last_name,c_preferred_cust_flag,c_birth_country,c_login,c_email_address,c_last_review_date,useless');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'dictionary_encoding_columns', 'c_customer_id:auto,c_salutation:auto,c_first_name:auto,c_last_name:auto,c_preferred_cust_flag:auto,c_birth_country:auto,c_login:auto,c_email_address:auto,c_last_review_date:auto,useless:auto');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'time_to_live_in_seconds', '3153600000');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'storage_format', 'segment');
COMMIT;
Étape 4 : Exécuter l'instruction INSERT
Utilisez INSERT INTO ... SELECT pour copier les données de la table externe vers la table interne. Vous pouvez importer tous les champs ou seulement un sous-ensemble.
À partir de Hologres V2.1.17, vous pouvez utiliser Serverless Computing pour les importations hors ligne à grande échelle, les tâches ETL (Extract, Transform, Load) volumineuses et les requêtes intensives sur les tables externes. Serverless Computing utilise des ressources serverless dédiées au lieu des ressources de votre instance, ce qui améliore la stabilité et réduit les erreurs OOM. Vous ne payez que pour les tâches exécutées. Pour plus de détails, consultez les rubriques Serverless Computing et le guide d'utilisation de Serverless Computing .
-- (Optional) Use Serverless Computing for large-scale import and ETL jobs.
SET hg_computing_resource = 'serverless';

-- Import a subset of fields
INSERT INTO holo_customer (c_customer_sk, c_customer_id, c_email_address, c_last_review_date, useless)
SELECT
    c_customer_sk,
    c_customer_id,
    c_email_address,
    c_last_review_date,
    useless
FROM foreign_customer;

-- Import all fields
INSERT INTO holo_customer
SELECT * FROM foreign_customer;

-- Reset the resource setting so subsequent SQL statements do not use serverless resources.
RESET hg_computing_resource;
Étape 5 : Interroger les données importées
Une fois l'importation terminée, interrogez la table interne pour vérifier les données :
SELECT * FROM holo_customer;Importer des données depuis une table MaxCompute partitionnée
Pour obtenir des instructions détaillées, consultez la rubrique Importer des données depuis une table MaxCompute partitionnée.
Bonnes pratiques pour INSERT OVERWRITE
Pour connaître les modèles et recommandations relatifs à INSERT OVERWRITE, consultez la rubrique INSERT OVERWRITE.
Synchroniser les données avec un outil de visualisation ou des tâches planifiées
Pour les importations ponctuelles de grande ampleur ou la synchronisation récurrente des données, utilisez HoloWeb ou DataWorks au lieu de rédiger manuellement du code SQL.
Utiliser HoloWeb pour une synchronisation en un clic
HoloWeb propose une interface utilisateur guidée qui génère et exécute le code SQL d'importation pour vous.
Ouvrez la page HoloWeb. Pour les instructions d'accès, consultez la rubrique Se connecter à HoloWeb et exécuter une requête.
Dans la barre de menus supérieure, choisissez Metadata Management > MaxCompute Query Acceleration, puis cliquez sur Import MaxCompute Data.
-
Configurez les paramètres sur la page Create MaxCompute Data Import Task.
L'option SQL Script affiche l'instruction SQL générée automatiquement à partir de votre configuration. Vous ne pouvez pas modifier directement l'instruction dans SQL Script . Pour la personnaliser, copiez l'instruction, modifiez-la manuellement, puis exécutez-la en tant que code SQL.
Catégorie
Paramètre
Description
Sélectionner l'instance
Nom de l'instance
Le nom de l'instance Hologres connectée.
Table source MaxCompute
Nom du projet
Le nom du projet MaxCompute.
Nom du schéma
Le nom du schéma MaxCompute. Masqué pour les projets utilisant le modèle à deux couches. Pour les projets utilisant le modèle à trois couches, sélectionnez parmi les schémas autorisés.
Nom de la table
La table MaxCompute à importer. Prend en charge la recherche floue basée sur le préfixe.
Table cible Hologres
Nom de la base de données
La base de données Hologres dans laquelle la table interne sera créée.
Nom du schéma
Le schéma Hologres. La valeur par défaut est public.
Nom de la table
Le nom de la nouvelle table interne. Par défaut, il reprend le nom de la table MaxCompute, mais vous pouvez le renommer.
Description de la table cible
Une description facultative pour la nouvelle table interne.
Paramètres
Paramètres GUC
Les paramètres GUC (Grand Unified Configuration) à appliquer. Pour plus de détails, consultez la rubrique Paramètres GUC.
Paramètres d'importation
Champs
Les champs à importer. Sélectionnez-les tous ou uniquement un sous-ensemble.
Configuration des partitions
Champ de partition
Sélectionnez un champ de partition. Hologres ne prend en charge que les partitions de premier niveau. Pour les partitions MaxCompute multiniveaux, configurez un seul champ de partition ; les autres seront mappés vers des champs standards.
Horodatage des données
Pour les tables MaxCompute partitionnées par date, sélectionnez la date de partition à importer.
Configuration des index
Mode de stockage
Column-oriented storage (par défaut) : optimisé pour les requêtes complexes. Row-oriented storage : optimisé pour les requêtes ponctuelles sur clé primaire et les analyses séquentielles. Row-column storage : prend en charge tous les scénarios de stockage en lignes et en colonnes, y compris les requêtes ponctuelles sans clé primaire.
Cycle de vie des données de la table
La période de conservation des données. La valeur par défaut est Permanent. Les données non modifiées dans le délai spécifié sont automatiquement supprimées à l'expiration.
Binlog
Indique si le Binlog est activé. Pour plus de détails, consultez la rubrique S'abonner au Binlog Hologres.
Cycle de vie du Binlog
La durée de vie (TTL) du Binlog. La valeur par défaut est de 30 jours (2 592 000 secondes).
Colonnes de distribution
Hologres distribue les données aux shards en fonction de ces colonnes. Les lignes ayant les mêmes valeurs sont placées dans le même shard. L'utilisation des colonnes de distribution comme conditions de filtre améliore l'efficacité des requêtes.
Colonnes de segment
Colonnes utilisées comme clés de segment. Les requêtes incluant des colonnes de segment permettent de localiser rapidement les positions de stockage des données.
Colonnes de clustering
Colonnes utilisées comme clés de clustering. Les index de clustering accélèrent les requêtes de plage et de filtrage sur ces colonnes.
Colonnes avec encodage par dictionnaire
Colonnes pour lesquelles Hologres construit des mappages de dictionnaire. L'encodage par dictionnaire convertit les comparaisons de chaînes en comparaisons numériques, accélérant ainsi les requêtes GROUP BY et de filtrage. Toutes les colonnes text sont définies par défaut comme des colonnes avec encodage par dictionnaire.
Colonnes Bitmap
Colonnes pour lesquelles Hologres construit des index bitmap. Les colonnes Bitmap filtrent rapidement les données selon des conditions spécifiées. Toutes les colonnes text sont définies par défaut comme des colonnes Bitmap.
Cliquez sur Submit. Une fois l'importation terminée, interrogez la table interne pour vérifier les données.
Utiliser DataWorks pour une planification périodique
La synchronisation en un clic via HoloWeb ne prend pas en charge les planifications récurrentes. Pour les importations historiques volumineuses ou la synchronisation périodique, utilisez DataStudio dans DataWorks. Pour plus de détails, consultez la rubrique Bonnes pratiques pour l'importation périodique de données MaxCompute à l'aide de DataWorks.
Dépannage des erreurs OOM
Symptôme : Une erreur OOM survient pendant l'importation avec le message suivant : Query executor exceeded total memory limitation xxxxx: yyyy bytes used.
Suivez les étapes ci-dessous dans l'ordre jusqu'à ce que l'erreur soit résolue.
Étape 1 : Actualiser les statistiques de la table
Des statistiques obsolètes ou manquantes peuvent amener l'optimiseur de requêtes à choisir un ordre de jointure sous-optimal, entraînant une utilisation excessive de la mémoire. Ce problème est particulièrement fréquent lorsque la requête d'importation contient des sous-requêtes.
Exécutez la commande ANALYZE sur toutes les tables internes et externes impliquées dans l'importation :
ANALYZE foreign_customer;
ANALYZE holo_customer;
Cette opération met à jour les métadonnées statistiques et aide l'optimiseur de requêtes à générer un meilleur plan d'exécution.
Étape 2 : Réduire la taille du lot de lecture
Les tables larges comportant de nombreuses colonnes génèrent des volumes de données importants par lot de lecture, ce qui peut dépasser les limites de mémoire.
Définissez hg_experimental_query_batch_size sur une valeur plus faible avant l'instruction INSERT (la valeur par défaut est 8192) :
SET hg_experimental_query_batch_size = 1024;
INSERT INTO holo_table SELECT * FROM mc_table;
Étape 3 : Réduire la simultanéité d'importation (Hologres antérieur à V1.1)
Une forte simultanéité d'importation consomme davantage de CPU et de mémoire, ce qui peut affecter les autres requêtes sur les tables internes.
Définissez hg_experimental_foreign_table_executor_max_dop sur une valeur plus faible (la valeur par défaut correspond au nombre de cœurs de l'instance). Ce paramètre s'applique à toutes les tâches exécutées sur des tables externes.
SET hg_experimental_foreign_table_executor_max_dop = 8;
INSERT INTO holo_table SELECT * FROM mc_table;
Étape 4 : Réduire la simultanéité DML (Hologres V1.1 et versions ultérieures)
Dans Hologres V1.1 et versions ultérieures, utilisez hg_foreign_table_executor_dml_max_dop pour contrôler la simultanéité des instructions DML, y compris les importations (la valeur par défaut est 32). Définir ce paramètre sur une valeur plus faible réduit la simultanéité des instructions DML, en particulier dans les scénarios d'importation et d'exportation de données, et empêche les instructions DML de consommer des ressources excessives.
SET hg_foreign_table_executor_dml_max_dop = 8;
INSERT INTO holo_table SELECT * FROM mc_table;