Si vous devez synchroniser des données depuis une instance ApsaraDB RDS for MySQL vers un cluster Alibaba Cloud Elasticsearch, utilisez le plug-in logstash-input-jdbc d'Alibaba Cloud Logstash. Ce plug-in est installé par défaut et ne peut pas être désinstallé. Grâce à une configuration de pipeline, il synchronise les données complètes ou incrémentielles vers le cluster Alibaba Cloud Elasticsearch en temps réel. Cette rubrique explique comment mettre en œuvre cette synchronisation.
Limites
Assurez-vous que l'instance ApsaraDB RDS for MySQL, le cluster Alibaba Cloud Logstash et le cluster Alibaba Cloud Elasticsearch résident dans le même fuseau horaire. Sinon, lors de la synchronisation des données temporelles, un décalage horaire peut apparaître entre les données avant et après la synchronisation.
-
Le champ
_iddans Elasticsearch doit correspondre au champiddans MySQL.Cette condition garantit que lorsqu'un enregistrement MySQL est écrit dans Elasticsearch, la tâche de synchronisation peut établir un mappage direct entre l'enregistrement MySQL et le document Elasticsearch. Par exemple, lorsqu'un enregistrement est mis à jour dans MySQL, la tâche de synchronisation écrase le document Elasticsearch qui possède le même ID que l'enregistrement mis à jour.
RemarqueSelon le fonctionnement interne d'Elasticsearch, une mise à jour consiste essentiellement à supprimer l'ancien document, puis à indexer le nouveau. Par conséquent, l'écrasement d'un document dans Elasticsearch est aussi efficace qu'une opération de mise à jour.
-
Lors de l'insertion ou de la mise à jour de données dans MySQL, l'enregistrement correspondant doit contenir un champ stockant l'heure de mise à jour ou l'heure d'insertion.
À chaque interrogation de MySQL par Logstash, ce dernier enregistre l'heure de mise à jour ou d'insertion du dernier élément lu. Lors de la lecture des données, Logstash récupère uniquement les enregistrements répondant à la condition, c'est-à-dire ceux dont l'heure de mise à jour ou d'insertion est postérieure à celle du dernier enregistrement de l'interrogation précédente.
ImportantLe plug-in
logstash-input-jdbcne permet pas de synchroniser les suppressions. Vous devez exécuter la commande appropriée dans Elasticsearch pour supprimer manuellement les documents.
Prérequis
Nous vous recommandons de créer les instances suivantes au sein du même réseau privé virtuel (VPC) :
Vous pouvez également utiliser des services déployés sur Internet. Dans ce cas, vous devez configurer le SNAT, activer le point de terminaison public de l'instance ApsaraDB RDS for MySQL et retirer la restriction de liste d'autorisation. Pour plus d'informations sur la configuration du SNAT, consultez la section Configurer une passerelle NAT pour le transfert de données publiques. Pour plus d'informations sur la configuration d'une liste d'autorisation, consultez la section Configurer une liste d'autorisation d'adresses IP.
Créez une instance ApsaraDB RDS for MySQL. Pour plus d'informations, consultez la section Créer une instance ApsaraDB RDS for MySQL. Cette rubrique utilise MySQL 5.7.
Créez un cluster Alibaba Cloud Elasticsearch. Pour plus d'informations, consultez la section Créer un cluster Alibaba Cloud Elasticsearch. Cette rubrique utilise un cluster Elasticsearch V8.17.
Créez un cluster Alibaba Cloud Logstash. Pour plus d'informations, consultez la section Créer une instance Alibaba Cloud Logstash. Cette rubrique utilise un cluster Logstash V8.11.4.
Contexte
Alibaba Cloud Logstash est un outil de collecte et de traitement de données offrant des fonctionnalités de collecte, de transformation, d'optimisation et de sortie. Le plug-in logstash-input-jdbc de Logstash est installé par défaut et ne peut pas être désinstallé. Utilisez ce plug-in pour interroger par lots les données d'une instance ApsaraDB RDS for MySQL et les synchroniser vers Elasticsearch. Il interroge également périodiquement les données de l'instance ApsaraDB RDS for MySQL et synchronise vers Elasticsearch les enregistrements insérés ou modifiés depuis la dernière interrogation. Pour plus d'informations, consultez la documentation officielle sur la manière de maintenir Elasticsearch synchronisé avec une base de données relationnelle à l'aide de Logstash. Cette solution convient aux scénarios nécessitant la synchronisation complète des données avec une latence de quelques secondes acceptable, ou aux scénarios où les données répondant à des conditions spécifiques sont interrogées par lots avant synchronisation.
Instructions
Synchronisation des données
Étape 1 : Préparation de l'environnement
Activez la fonctionnalité Auto Indexing sur votre cluster Elasticsearch afin que Logstash puisse créer automatiquement les index. Pour plus d'informations, consultez la rubrique Accéder et configurer un cluster Elasticsearch.
Téléchargez un pilote JDBC compatible avec votre version de MySQL dans le cluster Logstash. Cet exemple utilise le fichier
mysql-connector-java-5.1.48.jar. Pour plus de détails, reportez-vous à la section Configurer des bibliothèques tierces.-
Préparez les données de test. L'instruction suivante permet de créer une table :
CREATE table food (
  id int PRIMARY key AUTO_INCREMENT,
  name VARCHAR (32),
  insert_time DATETIME,
  update_time DATETIME
);
L'instruction suivante permet d'insérer des données :
INSERT INTO food values(null,'Chocolates',now(),now());
INSERT INTO food values(null,'Yogurt',now(),now());
INSERT INTO food values(null,'Ham sausage',now(),now());
Ajoutez les adresses IP des nœuds Alibaba Cloud Logstash à la liste d'autorisation de l'instance ApsaraDB RDS for MySQL. Vous pouvez obtenir ces adresses IP depuis la page Basic Information du cluster Logstash.
Étape 2 : Configuration d'un pipeline Logstash
Accédez à la page Logstash Clusters.
-
Accédez au cluster cible.
Dans la barre de navigation supérieure, sélectionnez la région où se trouve le cluster.
Sur la page Logstash Clusters, localisez le cluster et cliquez sur son ID.
Dans le volet de navigation de gauche, cliquez sur Pipelines.
Cliquez sur Create Pipeline.
-
Sur la page Create Pipeline, saisissez un Pipeline ID et configurez le paramètre Config.
La configuration Config suivante est utilisée dans cette rubrique.
input { jdbc { jdbc_driver_class => "com.mysql.jdbc.Driver" jdbc_driver_library => "/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/mysql-connector-java-5.1.48.jar" jdbc_connection_string => "jdbc:mysql://rm-bp1xxxxx.mysql.rds.aliyuncs.com:3306/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false" jdbc_user => "xxxxx" jdbc_password => "xxxx" jdbc_paging_enabled => "true" jdbc_page_size => "50000" statement => "select * from food where update_time >= :sql_last_value" schedule => "* * * * *" record_last_run => true last_run_metadata_path => "/ssd/1/<Logstash cluster ID>/logstash/data/last_run_metadata_update_time.txt" clean_run => false tracking_column_type => "timestamp" use_column_value => true tracking_column => "update_time" } } filter { } output { elasticsearch { hosts => "http://es-cn-0h****dd0hcbnl.elasticsearch.aliyuncs.com:9200" index => "rds_es_dxhtest_datetime" user => "elastic" password => "xxxxxxx" document_id => "%{id}" } }RemarqueRemplacez l'espace réservé
<Logstash cluster ID>dans le code par l'ID du cluster Logstash que vous avez créé. Pour savoir comment obtenir cet ID, consultez la rubrique Afficher les informations de base d'un cluster.Configuration
Description
inputSpécifie la source de données d'entrée. Pour connaître les types de sources de données pris en charge, consultez la documentation relative aux plug-ins d'entrée. Cette rubrique utilise une source de données JDBC. Pour la description des paramètres, reportez-vous aux paramètres d'entrée.
filterSpécifie le plug-in utilisé pour filtrer les données d'entrée. Pour connaître les types de plug-ins pris en charge, consultez la documentation relative aux plug-ins de filtre.
outputSpécifie le type de destination des données. Pour connaître les types de destinations pris en charge, consultez la documentation relative aux plug-ins de sortie. Dans cette rubrique, les données MySQL sont synchronisées vers Elasticsearch. Par conséquent, les informations relatives au cluster Elasticsearch de destination doivent être spécifiées dans la section
output. Pour la description des paramètres, reportez-vous à l'étape 3 : Créer et exécuter un pipeline.ImportantSi le paramètre
file_extendest utilisé dans la sectionoutput, vous devez d'abord installer le plug-inlogstash-output-file_extend. Pour plus d'informations, consultez la rubrique Installer ou supprimer des plug-ins.Paramètre
Description
jdbc_driver_classConfiguration de la classe JDBC.
jdbc_driver_librarySpécifiez le fichier du pilote JDBC utilisé pour se connecter à MySQL. Le format est
/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/<driver file name>. Vous devez préalablement télécharger le fichier du pilote dans la console. Pour connaître les fichiers de pilotes pris en charge par Alibaba Cloud Logstash et la procédure de téléchargement, consultez Configurer des bibliothèques tierces.jdbc_connection_stringIndiquez le nom de domaine, le port et la base de données de la connexion. Le format est
jdbc:mysql://<MySQL endpoint>:<Port>/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false.<MySQL endpoint>: spécifiez l'endpoint interne de MySQL. Si vous utilisez l'endpoint public, vous devez configurer une passerelle NAT pour Logstash et définirjdbc:mysql://<MySQL endpoint>:<Port>sur le nom de domaine public afin que les données soient transmises via Internet. Pour plus d'informations, consultez Configurer une passerelle NAT pour le transfert de données public.<Port>: le port doit correspondre au port sortant de MySQL. Dans la plupart des cas, il s'agit du port 3306.
jdbc_userNom d'utilisateur de la base de données.
jdbc_passwordMot de passe de la base de données.
jdbc_paging_enabledActive ou désactive la pagination. Valeur par défaut :
false.jdbc_page_sizeTaille de la pagination.
statementSpécifiez l'instruction SQL. Pour une requête portant sur plusieurs tables, vous pouvez utiliser une instruction JOIN.
Remarquesql_last_valuesert à déterminer la ligne à interroger. Avant l'exécution de toute requête, cette valeur est définie au jeudi 1er janvier 1970. Pour plus d'informations, consultez Jdbc input plugin.scheduleDéfinissez l'opération planifiée. La valeur
*indique que les données sont synchronisées chaque minute. Ce paramètre utilise une expression cron de style Rufus.record_last_runIndique si le résultat de l'exécution précédente doit être enregistré. Si ce paramètre est défini sur
true, la valeur du champtracking_columnde l'exécution précédente est enregistrée et sauvegardée dans le fichier spécifié parlast_run_metadata_path.last_run_metadata_pathSpécifiez le chemin d'accès au fichier qui stocke l'heure de la dernière exécution. Le backend expose actuellement le chemin
/ssd/1/<Logstash cluster ID>/logstash/data/pour stocker le fichier. Après avoir spécifié le chemin, Logstash génère automatiquement un fichier à cet emplacement, mais le contenu du fichier n'est pas consultable.RemarqueLorsque vous configurez un pipeline Logstash, nous vous recommandons de configurer ce paramètre en vous basant sur le chemin
/ssd/1/<Logstash cluster ID>/logstash/data/. Si vous n'utilisez pas ce chemin, les enregistrements conditionnels synchronisés ne peuvent pas être stockés dans le fichier de configuration sous le cheminlast_run_metadata_pathen raison d'autorisations insuffisantes.clean_runIndique si les enregistrements de
last_run_metadata_pathdoivent être effacés. Valeur par défaut :false. Si ce paramètre est défini surtrue, tous les enregistrements de la base de données sont interrogés depuis le début à chaque exécution.use_column_valueIndique si la valeur d'une colonne doit être enregistrée. Si ce paramètre est défini sur
true, le système enregistre la dernière valeur de la colonne spécifiée partracking_columnet utilise la valeur de cette colonne lors de la prochaine exécution du pipeline pour déterminer les enregistrements à mettre à jour.tracking_column_typeType de la colonne de suivi. Valeur par défaut :
numeric.tracking_columnSpécifiez la colonne de suivi. La colonne doit être incrémentielle. Il s'agit généralement de la clé primaire MySQL.
ImportantLa configuration précédente repose sur des données de test. Dans des scénarios professionnels réels, adaptez les paramètres à vos besoins métier. Pour connaître les autres options de configuration prises en charge par le plug-in d'entrée, consultez la documentation officielle du plug-in d'entrée Jdbc Logstash.
Si la configuration inclut un paramètre tel que
last_run_metadata_path, Alibaba Cloud Logstash doit fournir le chemin d'accès au fichier. Le backend expose actuellement le chemin/ssd/1/<Logstash cluster ID>/logstash/data/à des fins de test et les données présentes dans ce répertoire ne sont pas supprimées. Assurez-vous donc que l'espace disque disponible est suffisant. Après avoir spécifié le chemin, Logstash génère automatiquement un fichier à cet emplacement, mais son contenu n'est pas visible.Pour renforcer la sécurité, si vous utilisez un pilote JDBC lors de la configuration du pipeline, vous devez ajouter
allowLoadLocalInfile=false&autoDeserialize=falseau paramètrejdbc_connection_string. À défaut, le système de planification signale un échec de vérification lorsque vous ajoutez le fichier de configuration Logstash. Exemple :jdbc_connection_string => "jdbc:mysql://xxx.drds.aliyuncs.com:3306/<Database name>?allowLoadLocalInfile=false&autoDeserialize=false".
Pour plus d'informations sur les configurations Config, consultez Fichiers de configuration Logstash.
-
Cliquez sur NextNext pour configurer les paramètres du pipeline.
AvertissementL'enregistrement et le déploiement du pipeline déclenchent un redémarrage du cluster Logstash. Confirmez qu'un redémarrage n'affectera pas vos charges de travail avant de poursuivre.
Parameter
Description
Default
Pipeline Workers
Nombre de threads exécutant les plug-ins de filtre et de sortie en parallèle. Augmentez cette valeur lorsque les ressources CPU sont sous-utilisées ou lorsque les événements s'accumulent.
Nombre de vCPUs
Pipeline Batch Size
Nombre maximal d'événements collectés par un seul worker depuis les entrées avant l'exécution des filtres et des sorties. Des valeurs plus élevées augmentent le débit, mais nécessitent davantage de mémoire JVM heap.
125
Pipeline Batch Delay
Durée d'attente d'un worker pour recevoir des événements supplémentaires avant de démarrer un petit lot, en millisecondes.
50
Queue Type
Modèle de file d'attente interne pour la mise en tampon des événements. MEMORY : file d'attente en mémoire. PERSISTED : file d'attente basée sur le disque avec accusé de réception pour la durabilité.
MEMORY
Queue Max Bytes
Taille maximale de la file d'attente sur le disque. Doit être inférieure à votre capacité disque disponible.
1024 MB
Queue Checkpoint Writes
Nombre maximal d'événements écrits avant qu'un point de contrôle ne soit forcé (files d'attente persistantes uniquement). Définissez sur 0 pour aucune limite.
1024
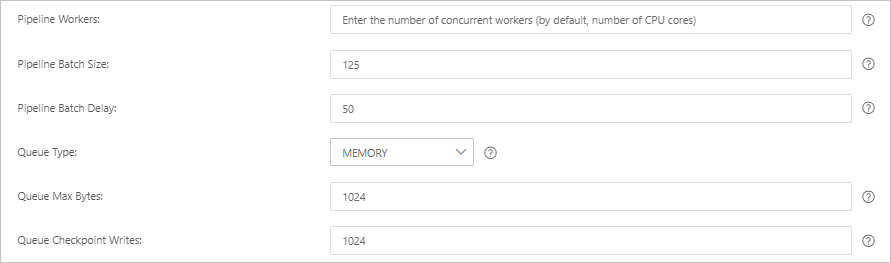
Cliquez sur Save and DeploySave and Deploy pour redémarrer le cluster Logstash et appliquer immédiatement la configuration. Vous pouvez également cliquer sur SaveSave pour enregistrer la configuration et déclencher une modification du cluster, mais les paramètres ne prennent pas effet immédiatement. Pour déployer ultérieurement, accédez à la page PipelinesPipelines, localisez le pipeline et cliquez sur Deploy NowDeploy Now dans la colonne ActionsActions.
Connectez-vous à la console Kibana de votre cluster Elasticsearch. Pour plus de détails, consultez Se connecter à la console Kibana.
Dans le coin supérieur gauche, cliquez sur l'icône
 et choisissez .
-
Sous l'onglet Console, exécutez la commande suivante pour confirmer que les trois lignes ont été synchronisées :
GET rds_es_dxhtest_datetime/_count
{
  "query": {"match_all": {}}
}
Réponse attendue :
{ "count" : 3, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 } } -
Mettez à jour et insérez des lignes dans MySQL pour tester la synchronisation incrémentielle :
UPDATE food SET name='Chocolates',update_time=now() where id = 1; INSERT INTO food values(null,'Egg',now(),now()); -
Dans la console Kibana, consultez les données mises à jour.
-
Recherchez la ligne mise à jour :
GET rds_es_dxhtest_datetime/_search
{
  "query": {
    "match": {
      "name": "Chocolates"
    }
  }
}
{ "took" : 2, "timed_out" : false, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : { "value" : 1, "relation" : "eq" }, "max_score" : 1.5580825, "hits" : [ { "_index" : "rds_es_dxhtest_datetime", "_type" : "_doc", "_id" : "1", "_score" : 1.5580825, "_source" : { "update_time" : "2020-03-23T03:43:19.000Z", "@version" : "1", "name" : "Chocolates", "insert_time" : "2020-03-23T03:00:36.000Z", "@timestamp" : "2020-03-23T03:44:00.1857", "id" : 1 } } ] } } -
Interrogez tous les documents :
GET rds_es_dxhtest_datetime/_search
{
  "query": {
    "match_all": {}
  }
}
La réponse inclut le document nouvellement ajouté avec id=4 et name=Egg, ce qui confirme que la synchronisation des données a réussi.
{
  "_index" : "rds_es_dxhtest_datetime",
  "_type" : "_doc",
  "_id" : "1",
  "_score" : 1.0,
  "_source" : {
    "update_time" : "2020-03-23T03:43:19.000Z",
    "@version" : "1",
    "name" : "Chocolates",
    "insert_time" : "2020-03-23T03:00:36.000Z",
    "@timestamp" : "2020-03-23T03:44:00.185Z",
    "id" : 1
  }
},
{
  "_index" : "rds_es_dxhtest_datetime",
  "_type" : "_doc",
  "_id" : "4",
  "_score" : 1.0,
  "_source" : {
    "update_time" : "2020-03-23T04:05:01.000Z",
    "@version" : "1",
    "name" : "Egg",
    "insert_time" : "2020-03-23T04:05:01.000Z",
    "@timestamp" : "2020-03-23T04:06:00.192Z",
    "id" : 4
  }
}
-
Étape 3 : Vérifier le résultat
FAQ
Mon pipeline reste bloqué à l'état d'initialisation, les données sont incohérentes après la synchronisation ou la connexion à la base de données échoue. Que faire ?
Commencez par vérifier les journaux du cluster Logstash. Accédez à la console Logstash et utilisez la fonctionnalité Query logs pour afficher les détails des erreurs. Pour plus d'informations, consultez la rubrique Query logs.
Si une mise à jour du cluster est en cours lorsque vous appliquez un correctif, suspendez d'abord la mise à jour. Consultez la rubrique View the progress of a cluster task . Après l'application du correctif, le système redémarre le cluster et reprend automatiquement la mise à jour.
Le tableau suivant répertorie les causes courantes et les solutions associées :
Cause | Solution |
Les adresses IP des nœuds Logstash ne figurent pas dans la liste d'autorisation de MySQL. | Ajoutez les adresses IP des nœuds Logstash à la liste d'autorisation de MySQL en suivant les instructions de la rubrique Use a database client or the CLI to connect to an ApsaraDB RDS for MySQL instance. Remarque Pour savoir comment obtenir les adresses IP des nœuds Logstash, consultez la rubrique View the basic information of a cluster. |
Synchronisation depuis une instance MySQL auto-gérée sur ECS : les adresses IP privées et les ports des nœuds ne figurent pas dans le groupe de sécurité ECS. | Ajoutez les adresses IP privées et les ports internes des nœuds Logstash au groupe de sécurité ECS. Consultez la rubrique Add a security group rule. |
Le cluster Elasticsearch ne se trouve pas dans le même VPC que le cluster Logstash. | Achetez un cluster Elasticsearch dans le même VPC ou configurez une passerelle NAT pour un accès via Internet. Consultez les rubriques Create an Alibaba Cloud Elasticsearch cluster et Configure a NAT gateway for data transmission over the Internet. |
L'endpoint MySQL est incorrect ou le port n'est pas 3306. | Obtenez l'endpoint et le port corrects en suivant les instructions de la rubrique View and manage instance endpoints and ports. Remplacez ensuite la valeur du paramètre Important
|
La fonction Auto Indexing est désactivée sur le cluster Elasticsearch. | Activez la fonction Auto Indexing. Consultez la rubrique Configure the YML file. |
La charge du cluster Elasticsearch ou Logstash est trop élevée. | Mettez à niveau la configuration du cluster en suivant les instructions de la rubrique Upgrade cluster configuration. Remarque Vous pouvez consulter la charge d'Elasticsearch via les métriques de surveillance dans la console. Pour plus d'informations, consultez la rubrique Monitoring metrics and exception handling. Vous pouvez consulter la charge de Logstash via la surveillance X-Pack dans Kibana. Pour plus d'informations, consultez la rubrique Configure X-Pack monitoring. |
Le pilote JDBC n'a pas été téléchargé. | Téléchargez le fichier du pilote. Consultez la rubrique Configure third-party libraries. |
| Installez le plug-in ou supprimez le paramètre |
Pour plus d'informations sur le dépannage, consultez la rubrique FAQ about data transfer by using Logstash.
Comment synchroniser les données de plusieurs tables MySQL vers des index Elasticsearch distincts ?
Définissez plusieurs blocs jdbc dans la section input, attribuez une valeur type à chacun, puis utilisez des conditions if[type] dans la section output pour router les données de chaque table vers un index différent :
input {
    jdbc {
      jdbc_driver_class => "com.mysql.jdbc.Driver"
      jdbc_driver_library => "/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/mysql-connector-java-5.1.48.jar"
      jdbc_connection_string => "jdbc:mysql://rm-bp1xxxxx.mysql.rds.aliyuncs.com:3306/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false"
      jdbc_user => "xxxxx"
      jdbc_password => "xxxx"
      jdbc_paging_enabled => "true"
      jdbc_page_size => "50000"
      statement => "select * from tableA where update_time >= :sql_last_value"
      schedule => "* * * * *"
      record_last_run => true
      last_run_metadata_path => "/ssd/1/<Logstash cluster ID>/logstash/data/last_run_metadata_update_time.txt"
      clean_run => false
      tracking_column_type => "timestamp"
      use_column_value => true
      tracking_column => "update_time"
      type => "A"
    }
    jdbc {
      jdbc_driver_class => "com.mysql.jdbc.Driver"
      jdbc_driver_library => "/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/mysql-connector-java-5.1.48.jar"
      jdbc_connection_string => "jdbc:mysql://rm-bp1xxxxx.mysql.rds.aliyuncs.com:3306/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false"
      jdbc_user => "xxxxx"
      jdbc_password => "xxxx"
      jdbc_paging_enabled => "true"
      jdbc_page_size => "50000"
      statement => "select * from tableB where update_time >= :sql_last_value"
      schedule => "* * * * *"
      record_last_run => true
      last_run_metadata_path => "/ssd/1/<Logstash cluster ID>/logstash/data/last_run_metadata_update_time.txt"
      clean_run => false
      tracking_column_type => "timestamp"
      use_column_value => true
      tracking_column => "update_time"
      type => "B"
    }
}
output {
    if[type] == "A" {
        elasticsearch {
            hosts => "http://es-cn-0h****dd0hcbnl.elasticsearch.aliyuncs.com:9200"
            index => "rds_es_dxhtest_datetime_A"
            user => "elastic"
            password => "xxxxxxx"
            document_id => "%{id}"
        }
    }
    if[type] == "B" {
        elasticsearch {
            hosts => "http://es-cn-0h****dd0hcbnl.elasticsearch.aliyuncs.com:9200"
            index => "rds_es_dxhtest_datetime_B"
            user => "elastic"
            password => "xxxxxxx"
            document_id => "%{id}"
        }
    }
}