EMR Serverless Spark se connecte à Hologres via le connecteur Spark pour Hologres. Ajoutez les configurations nécessaires pour lire et écrire dans Hologres depuis un environnement Serverless Spark.
Limites
Le connecteur Spark nécessite Hologres version 1.3 ou ultérieure. Vérifiez la version de votre instance sur la page Instance Details de la console Hologres. Si votre instance est antérieure à la version 1.3, mettez-la à niveau ou rejoignez le groupe DingTalk Hologres (ID : 32314975) pour demander une mise à niveau.
Méthodes d'accès
Deux méthodes permettent d'accéder à Hologres. Choisissez celle qui correspond le mieux à vos besoins :
|
Méthode d'accès |
Description |
Scénarios |
Références |
|
Méthode 1 : Configuration au niveau de la tâche ou de la session |
Configurez séparément les informations de connexion Hologres (URL JDBC, nom d'utilisateur, mot de passe et autres paramètres) dans chaque tâche ou session. |
|
Cette rubrique |
|
Méthode 2 : Configuration unifiée via les catalogues de données (recommandée) |
Ajoutez un catalogue de données Hologres via la fonctionnalité Data Catalogs d'EMR Serverless Spark. Une fois le catalogue ajouté, toutes les tâches et sessions de l'espace de travail peuvent accéder aux données autorisées par défaut. Remarque
Seules les versions du moteur esr-4.9.0 et ultérieures sont prises en charge. |
|
Pour les espaces de travail nécessitant un accès fréquent et à long terme aux données Hologres, la méthode 2 (catalogues de données) réduit les configurations répétitives et améliore l'efficacité du développement.
Procédure
Étape 1 : Obtenir et télécharger le fichier JAR hologres-connector-spark****
Les versions esr-4.8.0 et ultérieures d'EMR Serverless Spark incluent le connecteur Hologres intégré. Cette étape n'est requise que si vous utilisez une version antérieure à esr-4.8.0.
Pour lire et écrire dans Hologres, Spark nécessite un fichier JAR de connecteur. Téléchargez-le depuis le dépôt central Maven. Cette rubrique utilise la version 1.5.6 : hologres-connector-spark-3.x-1.5.6-jar-with-dependencies.jar.
Téléversez le fichier JAR hologres-connector-spark téléchargé vers OSS. Pour plus d'instructions, consultez Téléchargement simple.
Étape 2 : Ajouter une connexion réseau
-
Récupérez les informations réseau.
Accédez à la page Hologres et ouvrez les détails de l'instance Hologres cible pour trouver ses informations VPC et vSwitch.
-
Ajoutez une connexion réseau.
Serverless Spark nécessite une connexion réseau au cluster Hologres. Pour plus d'informations, consultez Connectivité réseau entre EMR Serverless Spark et d'autres VPC.
Étape 3 : Créer une base de données et une table Hologres
Connectez-vous à l'instance Hologres. Pour plus de détails, consultez Se connecter à une instance.
-
Dans l'onglet SQL Editor, saisissez les instructions SQL suivantes dans une nouvelle requête temporaire et exécutez-les.
-- Create a database.
CREATE DATABASE testdb;
-- Create a table.
CREATE TABLE "public"."test" (
    "id" text  NULL,
    "name" text  NULL);
-- Insert data.
INSERT INTO public.test VALUES ('1001','jack'),('1002','tony'),('1003','mike');
-- Query data.
SELECT * FROM public.test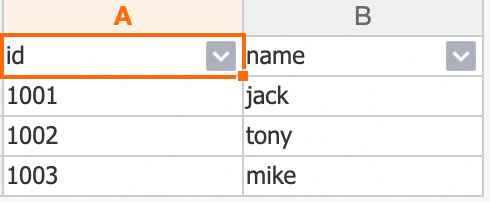
Étape 4 : Lire et écrire dans Hologres
Exemple 1 : Session SQL
Lisez et écrivez dans Hologres en utilisant une session SQL.
-
Créez une session SQL. Pour plus de détails, consultez Gérer les sessions SQL.
Lors de la création de la session, sélectionnez la connexion réseau créée à l'étape précédente dans la liste des connexions réseau. Dans la section Spark Configuration, ajoutez les paramètres suivants pour charger le hologres-connector-spark.
# Add the hologres-connector JAR file (only required for versions before esr-4.8.0).
spark.emr.serverless.user.defined.jars oss://<bucket>/hologres-connector-spark-3.x-<version>.jar

# Configure the Hologres catalog.
spark.sql.catalog.hologres_external_test_db com.alibaba.hologres.spark3.HoloTableCatalog
spark.sql.catalog.hologres_external_test_db.username ***
spark.sql.catalog.hologres_external_test_db.password ***
spark.sql.catalog.hologres_external_test_db.jdbcurl jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb
Le tableau suivant décrit les paramètres.
Paramètre
Exemple
Description
spark.emr.serverless.user.defined.jarsoss://<bucket>/hologres-connector-spark-3.x-<version>.jarChemin d'accès au fichier JAR défini par l'utilisateur.
spark.sql.catalog.hologres_external_test_dbcom.alibaba.hologres.spark3.HoloTableCatalogConfigure une source de données Hologres en tant que catalogue externe dans Spark 3.x. Il s'agit d'une valeur fixe.
spark.sql.catalog.hologres_external_test_db.usernameLTAI******AccessKey ID de votre compte Alibaba Cloud. Nous vous recommandons d'utiliser la gestion des secrets pour traiter les informations sensibles. Pour plus de détails, consultez Gérer les informations sensibles à l'aide de la gestion des secrets.
spark.sql.catalog.hologres_external_test_db.passwordmXYV******AccessKey Secret de votre compte Alibaba Cloud. Nous vous recommandons d'utiliser la gestion des secrets pour traiter les informations sensibles. Pour plus de détails, consultez Gérer les informations sensibles à l'aide de la gestion des secrets.
spark.sql.catalog.hologres_external_test_db.jdbcurljdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdbURL de connexion JDBC de l'instance Hologres.
Vous pouvez personnaliser la partie
hologres_external_test_dbdans les noms des paramètres. -
Sur la page Data Development, créez une tâche SparkSQL et sélectionnez la session SQL créée dans le coin supérieur droit.
Pour plus d'informations, consultez Développement SparkSQL.
-
Copiez le code suivant dans le nouvel onglet SparkSQL et cliquez sur Run.
-- Switch to the testdb database.
USE hologres_external_test_db;
-- Write data.
INSERT INTO `public`.test VALUES ('1004','tom');
-- Query data.
SELECT * FROM `public`.test;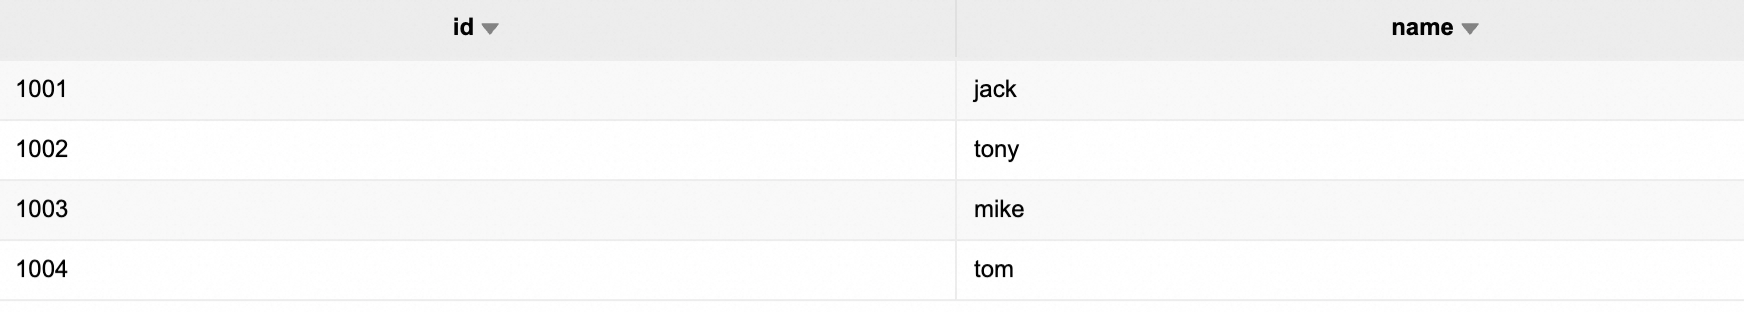
Exemple 2 : Tâche de streaming
Cet exemple PySpark lit les données depuis Kafka et les écrit dans Hologres en tant que tâche de streaming.
Assurez-vous que la connexion réseau entre Kafka et Hologres est active. Nous vous recommandons de déployer Kafka et Hologres dans le même VPC et le même vSwitch.
-
Dans cet exemple de code, remplacez les informations Kafka et la table Hologres par vos valeurs réelles.
from pyspark.sql import SparkSession from pyspark.sql.functions import col # Configure your Kafka information. servers = "alikafka-serverless-cn-xxxxx-vpc.alikafka.aliyuncs.com:9092" # Replace with your Kafka bootstrap servers. topic = "topic-name" # Replace with your Kafka topic. # Create a SparkSession. spark = SparkSession.builder \ .appName("test read kafka") \ .getOrCreate() # Read the Kafka stream. df = spark \ .readStream \ .format("kafka") \ .option("kafka.bootstrap.servers", servers) \ .option("subscribe", topic) \ .load() # Define a function to write to Hologres (called for each micro-batch). def write_to_hologres(batch_df, batch_id): print(f"Writing batch {batch_id} to Hologres...") batch_df.write \ .format("hologres") \ .mode("append") \ .insertInto("hologres_external_test_db.public.test") # Replace with your Hologres table. # Convert the key and value to strings and write the stream. query = df.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)") \ .writeStream \ .foreachBatch(write_to_hologres) \ .outputMode("append") \ .trigger(processingTime='30 seconds') \ .start() # Wait for the streaming query to terminate (this blocks cell execution in a notebook). query.awaitTermination() -
Téléversez le fichier.
Sur la page Artifacts, cliquez sur Upload File.
Dans la boîte de dialogue Upload File, cliquez sur la zone de téléchargement pour sélectionner le fichier Python de l'étape précédente, ou faites glisser le fichier dans la zone de téléchargement.
-
Créez et exécutez la tâche de streaming.
Sur la page Development, cliquez sur l'icône
 (Créer).
Dans la boîte de dialogue qui s'affiche, saisissez un Name, sélectionnez PySpark dans la liste Application (Streaming), puis cliquez sur OK.
-
Dans le nouvel onglet de développement, configurez les paramètres suivants et laissez les autres avec leurs paramètres par défaut. Ensuite, cliquez sur Publish.
Paramètre
Description
Main Python Resources
Sélectionnez le fichier Python téléversé à l'étape précédente.
Engine Version
Sélectionnez une version Spark compatible. Cet exemple utilise
esr-4.6.0.Network Connection
Sélectionnez la connexion réseau créée à l'étape 2.
Spark Configuration
# Add the hologres-connector JAR file (only required for versions before esr-4.8.0).
spark.emr.serverless.user.defined.jars              oss://<bucket>/test_script/hologres-connector-spark-3.x-1.5.6-jar-with-dependencies.jar
# Configure the Hologres catalog.
spark.sql.catalog.hologres_external_test_db com.alibaba.hologres.spark3.HoloTableCatalog
spark.sql.catalog.hologres_external_test_db.username ***
spark.sql.catalog.hologres_external_test_db.password ***
spark.sql.catalog.hologres_external_test_db.jdbcurl jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb
Pour une description détaillée des paramètres, consultez Exemple 1 : Session SQL.
Une fois la tâche publiée, cliquez sur Go to O&M. Sur la page qui s'ouvre, cliquez sur Start.
-
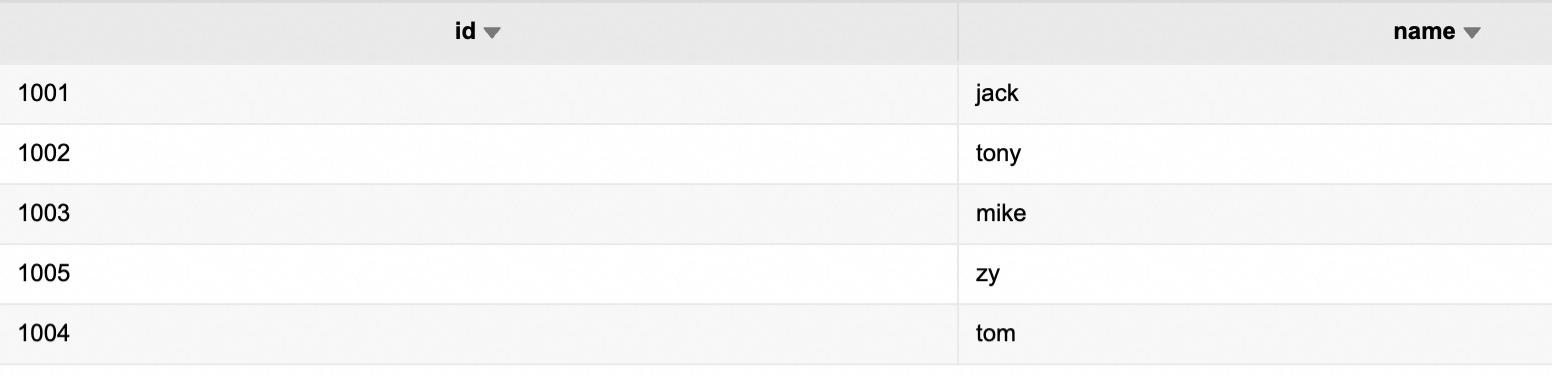
Vérifiez le résultat.
-
Envoyez des messages à Kafka.
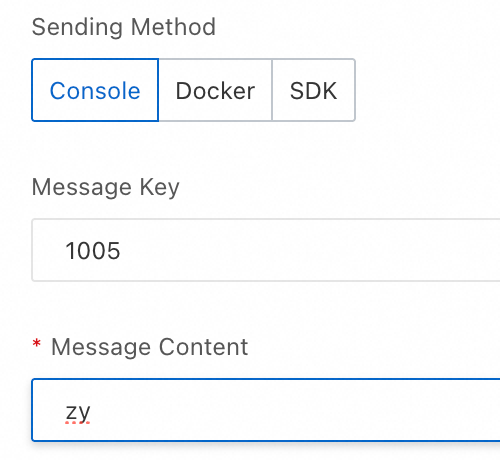
Interrogez les données à l'aide de Spark SQL.
-
Exemple 3 : Session Notebook
-
Créez une session Notebook. Pour plus de détails, consultez Gérer les sessions Notebook.
Lors de la création de la session, sélectionnez la connexion réseau créée à l'étape précédente dans la liste des connexions réseau. Dans la section Spark Configuration, ajoutez le paramètre suivant pour charger le hologres-connector-spark.
# Add the hologres-connector JAR file (only required for versions before esr-4.8.0).
spark.emr.serverless.user.defined.jars oss://<bucket>/hologres-connector-spark-3.x-<version>.jar
Sur la page Data Development, créez une tâche Notebook et sélectionnez la session Notebook créée dans le coin supérieur droit.
-
Copiez le code suivant dans le nouvel onglet Notebook et cliquez sur
 .
import pandas as pd
from pyspark.sql import SparkSession
from pyspark.sql.types import StructType, StructField, StringType, IntegerType, LongType

# 1. Prepare a Pandas DataFrame.
pdf = pd.DataFrame({
    "id": ["1006"],
    "name": ["sl"]
})

# 2. Convert to a PySpark DataFrame.
# (Optional: Explicitly define the schema to ensure correct data types)
schema = StructType([
    StructField("id", StringType(), True),
    StructField("name", StringType(), True)
])

df = spark.createDataFrame(pdf, schema=schema)

# Write to Hologres.
df.write \
  .format("hologres") \
  .option("username", "LTAI******") \
  .option("password", "mXYV******") \
  .option("jdbcurl", "jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb") \
  .option("table", "test") \
  .mode("append") \
  .save()

# Read data.
readDf = spark.read\
  .format("hologres") \
  .option("username", "LTAI******") \
  .option("password", "mXYV******") \
  .option("jdbcurl", "jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb") \
  .option("table", "test") \
  .load()

readDf.select("id", "name").show(10)
Le tableau suivant décrit les paramètres.
Paramètre
Exemple
Description
usernameLTAI******AccessKey ID de votre compte Alibaba Cloud. Nous vous recommandons d'utiliser la gestion des secrets pour traiter les informations sensibles. Pour plus de détails, consultez Gérer les informations sensibles à l'aide de la gestion des secrets.
passwordmXYV******AccessKey Secret de votre compte Alibaba Cloud. Nous vous recommandons d'utiliser la gestion des secrets pour traiter les informations sensibles. Pour plus de détails, consultez Gérer les informations sensibles à l'aide de la gestion des secrets.
jdbcurljdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdbURL de connexion JDBC de l'instance Hologres.
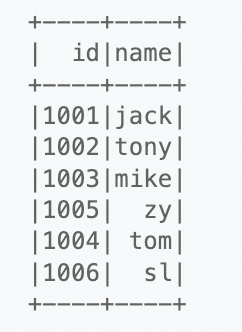
Vérifiez le résultat.
Commandes courantes du catalogue Hologres
Un catalogue Hologres connecte une base de données Hologres à Spark SQL en tant que catalogue externe. Chaque catalogue est lié à une seule base de données Hologres et l'accès inter-bases de données n'est pas pris en charge. La structure logique à l'intérieur d'un catalogue est cohérente avec celle de Hologres :
|
Concept Spark |
Concept Hologres |
Description |
|
catalogue |
base de données |
Par exemple, |
|
namespace |
schéma |
Par exemple, |
|
table |
table |
Vous devez spécifier explicitement |
Utilisation d'un catalogue Hologres
Un catalogue Hologres dans Spark correspond à exactement une base de données Hologres et ne peut pas être modifié après sa création.
USE hologres_external_test_db;Liste de tous les namespaces
Un namespace dans Spark correspond à un schéma dans Hologres. Le schéma par défaut est public. Utilisez la commande USE pour modifier le schéma par défaut d'une session.
-- View all namespaces in the Hologres catalog, which correspond to all schemas in Hologres.
SHOW NAMESPACES;
Liste des tables dans un namespace
-
Liste toutes les tables.
SHOW TABLES; -
Liste les tables dans un namespace spécifique.
USE test_schema;
SHOW TABLES;

-- Or use:
SHOW TABLES IN test_schema;
Documents connexes
Pour plus d'informations sur l'utilisation de Spark pour lire et écrire dans Hologres, consultez Lire et écrire des données dans Hologres à l'aide de Spark.