Une session est une instance Spark dans un espace de travail EMR Serverless Spark. Créez une session SQL pour exécuter des requêtes SQL et réaliser des analyses de science des données.
Créer une session SQL
Après avoir créé une session SQL, vous pouvez la sélectionner lors de la création d'une tâche SQL.
-
Accédez à la page Sessions.
Connectez-vous à la console EMR.
Dans le volet de navigation de gauche, choisissez EMR Serverless > Spark.
Sur la page Spark, cliquez sur le nom de l'espace de travail cible.
Sur la page EMR Serverless Spark, cliquez sur Sessions dans le volet de navigation de gauche.
Sur la page SQL Session, cliquez sur Connect to SQL Session.
-
Sur la page Create SQL Session, configurez les paramètres suivants et cliquez sur create.
ImportantNous vous recommandons de définir la concurrence maximale de la file d'attente de ressources sélectionnée à au moins la quantité de ressources requise par la session notebook. Cette valeur s'affiche dans la console.
Paramètre
Description
Name
Le nom de la session SQL.
Le nom doit comporter entre 1 et 64 caractères et peut contenir des lettres, des chiffres, des traits d'union (-), des traits de soulignement (_) et des espaces.
Resource Queue
La file d'attente de ressources pour la session SQL. Vous pouvez sélectionner une file d'attente dédiée au développement ou une file d'attente partagée entre le développement et la production.
Pour plus d'informations sur les files d'attente, consultez Gérer les files d'attente de ressources.
Engine Version
La version du moteur pour la session SQL. Pour plus d'informations, consultez Versions du moteur.
Use Fusion Acceleration
Fusion peut accélérer les charges de travail Spark et réduire le coût total des tâches. Pour obtenir des informations sur la facturation, consultez Facturation du produit. Pour plus d'informations sur le moteur Fusion, consultez Moteur Fusion.
Automatic Stop
Activé par défaut. Vous pouvez spécifier un délai d'inactivité personnalisé. Le système arrête automatiquement la session SQL après qu'elle est restée inactive pendant la période spécifiée.
Normal Network Connection
Une connexion réseau existante permettant d'accéder aux sources de données dans un VPC ou à des services externes. Pour plus d'informations, consultez Connectivité réseau entre EMR Serverless Spark et d'autres VPC.
spark.driver.cores
Le nombre de cœurs CPU pour le processus driver. Valeur par défaut : 1.
spark.driver.memory
La quantité de mémoire pour le processus driver. Valeur par défaut : 3,5 Go.
spark.executor.cores
Le nombre de cœurs CPU pour chaque processus executor. Valeur par défaut : 1.
spark.executor.memory
La quantité de mémoire pour chaque processus executor. Valeur par défaut : 3,5 Go.
spark.executor.instances
Le nombre d'executors. Valeur par défaut : 2.
Dynamic Resource Allocation
Désactivé par défaut. Lorsqu'il est activé, configurez les paramètres suivants :
-
Minimum Number of Executors : la valeur par défaut est 2.
-
Maximum Number of Executors : si spark.executor.instances n'est pas défini, la valeur par défaut est 10.
More Memory Configurations
-
spark.driver.memoryOverhead : la mémoire non heap disponible pour le driver. Si ce paramètre n'est pas défini, Spark alloue automatiquement une valeur basée sur la valeur par défaut, qui est
max(384 MB, 10 % * spark.driver.memory). -
spark.executor.memoryOverhead : la mémoire non heap disponible pour chaque executor. Si ce paramètre n'est pas défini, Spark alloue automatiquement une valeur basée sur la valeur par défaut, qui est
max(384 MB, 10 % * spark.executor.memory). -
spark.memory.offHeap.size : la quantité de mémoire off-heap disponible pour Spark. La valeur par défaut est 1 Go.
Ce paramètre prend effet uniquement lorsque
spark.memory.offHeap.enabledest défini surtrue. Lorsque le moteur Fusion est utilisé, cette fonctionnalité est activée par défaut avec 1 Go de mémoire off-heap.
Spark Configuration
Propriétés de configuration Spark personnalisées. Utilisez des espaces pour séparer les paires clé-valeur. Exemple :
spark.sql.catalog.paimon.metastore dlf.Après avoir créé une session SQL, son statut est initialement Starting. La session est prête lorsque son statut passe à Running. Sur la page SQL Session, vous pouvez arrêter, modifier ou supprimer des sessions.
-
Consulter les historiques d'exécution
Une fois une tâche terminée, vous pouvez consulter son historique d'exécution.
Sur la page SQL Sessions, cliquez sur le nom de la session souhaitée.
-
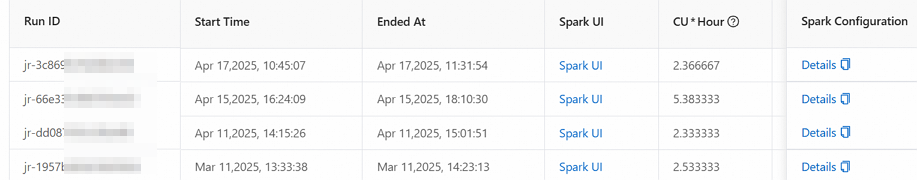
Cliquez sur l'onglet Execution Records.
Dans cet onglet, vous pouvez afficher les détails de chaque exécution, tels que l'ID d'exécution, l'heure de début et un lien vers l'interface utilisateur Spark.
Rubriques connexes
Pour les opérations liées aux files d'attente, consultez Gérer les files d'attente de ressources.
Pour obtenir des informations sur les rôles et les autorisations pour les sessions, consultez Gérer les utilisateurs et les rôles.
Pour un exemple complet du flux de travail de développement de tâches SQL, consultez Démarrage rapide de Spark SQL.