Exécutez des tâches d'entraînement distribué DeepSpeed avec Arena et visualisez les résultats à l'aide de TensorBoard.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un cluster ACK doté de nœuds accélérés par GPU. Consultez la rubrique Créer un cluster ACK avec des nœuds accélérés par GPU.
La suite cloud-native AI installée, avec l'interface CLI
ack-arenaen version 0.9.10 ou ultérieure. Consultez la rubrique Déployer la suite cloud-native AI.Le client Arena installé en version 0.9.10 ou ultérieure. Consultez la rubrique Configurer le client Arena.
Des Persistent Volume Claims (PVC) créés dans le cluster. Consultez la rubrique Configurer un volume NAS partagé.
Fonctionnement
Une tâche DeepSpeed dans ACK s'exécute selon une topologie launcher-worker :
Le nœud Launcher coordonne l'exécution de l'entraînement distribué. Ce nœud n'utilise pas de GPU.
Les nœuds Worker exécutent l'entraînement proprement dit. Chaque worker reçoit un ou plusieurs GPU et exécute le script d'entraînement DeepSpeed.
Étant donné que la communication entre les nœuds utilise SSH, toutes les images doivent avoir OpenSSH installé.
L'accès aux tâches d'entraînement se fait exclusivement via SSH sans mot de passe. Protégez les Secrets Kubernetes dans les environnements de production.
Exemple de configuration
Ce guide utilise un exemple qui entraîne un modèle de langage masqué. Le code source et le jeu de données provenant de microsoft/DeepSpeedExamples sont préemballés dans l'image registry.cn-beijing.aliyuncs.com/acs/deepspeed:hello-deepspeed. L'exemple utilise un PVC nommé training-data (adossé à un volume NAS partagé) pour stocker les résultats de l'entraînement.
Utiliser une image personnalisée
Pour utiliser votre propre code d'entraînement, choisissez l'une des approches suivantes :
-
Générer à partir de l'image de base DeepSpeed ACK :
registry.cn-beijing.aliyuncs.com/acs/deepspeed:v072_base Générer à partir de votre propre image de base : Suivez le Dockerfile et installez OpenSSH dans l'image.
Synchroniser le code depuis un dépôt Git privé
Transmettez les options --sync-mode=git et --sync-source pour extraire le code d'entraînement au moment de l'exécution. Arena utilise git-sync pour synchroniser le dépôt. Définissez les identifiants à l'aide des variables d'environnement GIT_SYNC_USERNAME et GIT_SYNC_PASSWORD.
Soumettre et surveiller une tâche DeepSpeed
Étape 1 : Vérifier les ressources GPU disponibles
arena top nodeRésultat attendu :
NAME                       IPADDRESS      ROLE    STATUS  GPU(Total)  GPU(Allocated)
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   0           0
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   0           0
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   1           0
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   1           0
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   1           0
---------------------------------------------------------------------------------------------------
Allocated/Total GPUs In Cluster:
0/3 (0.0%)
Trois nœuds accélérés par GPU sont disponibles.
Étape 2 : Soumettre la tâche DeepSpeed
La commande suivante soumet une tâche nommée deepspeed-helloworld avec un nœud Launcher et trois nœuds worker, chacun utilisant un GPU :
arena submit deepspeedjob \
    --name=deepspeed-helloworld \
    --gpus=1 \
    --workers=3 \
    --image=registry.cn-beijing.aliyuncs.com/acs/deepspeed:hello-deepspeed \
    --data=training-data:/data \
    --tensorboard \
    --logdir=/data/deepspeed_data \
    "deepspeed /workspace/DeepSpeedExamples/HelloDeepSpeed/train_bert_ds.py --checkpoint_dir /data/deepspeed_data"
Paramètres
| Paramètre | Obligatoire | Description | Valeur par défaut |
|---|---|---|---|
--name |
Oui | Nom de la tâche, unique à l'échelle globale | — |
--image |
Oui | Image de conteneur pour l'environnement d'exécution | — |
--gpus |
Non | Nombre de GPU alloués à chaque nœud worker | 0 |
--workers |
Non | Nombre de nœuds worker | 1 |
--data |
Non | Monte un PVC dans l'environnement d'exécution. Format : <pvc-name>:<mount-path>. Exécutez arena data list pour afficher les PVC disponibles. |
— |
--tensorboard |
Non | Active un service TensorBoard. Doit être utilisé conjointement avec --logdir. |
— |
--logdir |
Non | Chemin d'accès depuis lequel TensorBoard lit les fichiers d'événements. Doit être utilisé conjointement avec --tensorboard. |
/training_logs |
Pour synchroniser le code depuis un dépôt Git privé au lieu de l'empaqueter dans l'image, ajoutez les options suivantes :
arena submit deepspeedjob \
    ...
    --sync-mode=git \
    --sync-source=<private-git-repo-url> \
    --env=GIT_SYNC_USERNAME=<username> \
    --env=GIT_SYNC_PASSWORD=<password> \
    "deepspeed /workspace/DeepSpeedExamples/HelloDeepSpeed/train_bert_ds.py --checkpoint_dir /data/deepspeed_data"
Résultat attendu après la soumission :
trainingjob.kai.alibabacloud.com/deepspeed-helloworld created
INFO[0007] The Job deepspeed-helloworld has been submitted successfully
INFO[0007] You can run `arena get deepspeed-helloworld --type deepspeedjob` to check the job status
Étape 3 : Vérifier que la tâche est en cours d'exécution
Listez toutes les tâches d'entraînement Arena :
arena listRésultat attendu :
NAME                  STATUS   TRAINER         DURATION  GPU(Requested)  GPU(Allocated)  NODE
deepspeed-helloworld  RUNNING  DEEPSPEEDJOB    3m        3               3               192.168.9.69
Consultez l'utilisation des GPU par tâche :
arena top jobRésultat attendu :
NAME                  STATUS   TRAINER         AGE  GPU(Requested)  GPU(Allocated)  NODE
deepspeed-helloworld  RUNNING  DEEPSPEEDJOB    4m   3               3               192.168.9.69

Total Allocated/Requested GPUs of Training Jobs: 3/3
Consultez l'utilisation des GPU à l'échelle du cluster :
arena top nodeRésultat attendu :
NAME                       IPADDRESS      ROLE    STATUS  GPU(Total)  GPU(Allocated)
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   0           0
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   0           0
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   1           1
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   1           1
cn-beijing.192.1xx.x.xx   192.1xx.x.xx   <none>  Ready   1           1
---------------------------------------------------------------------------------------------------
Allocated/Total GPUs In Cluster:
3/3 (100%)
Étape 4 : Obtenir les détails de la tâche et l'URL TensorBoard
arena get deepspeed-helloworldRésultat attendu :
Name:      deepspeed-helloworld
Status:    RUNNING
Namespace: default
Priority:  N/A
Trainer:   DEEPSPEEDJOB
Duration:  6m

Instances:
  NAME                           STATUS   AGE  IS_CHIEF  GPU(Requested)  NODE
  ----                           ------   ---  --------  --------------  ----
  deepspeed-helloworld-launcher  Running  6m   true      0               cn-beijing.192.1xx.x.x
  deepspeed-helloworld-worker-0  Running  6m   false     1               cn-beijing.192.1xx.x.x
  deepspeed-helloworld-worker-1  Running  6m   false     1               cn-beijing.192.1xx.x.x
  deepspeed-helloworld-worker-2  Running  6m   false     1               cn-beijing.192.1xx.x.x

Your tensorboard will be available on:
http://192.1xx.x.xx:31870
Les deux dernières lignes n'apparaissent que si TensorBoard est activé.
Étape 5 : Afficher les résultats de l'entraînement dans TensorBoard
-
Redirigez le service TensorBoard vers un port local :
kubectl port-forward svc/deepspeed-helloworld-tensorboard 9090:6006 -
Ouvrez
localhost:9090dans un navigateur.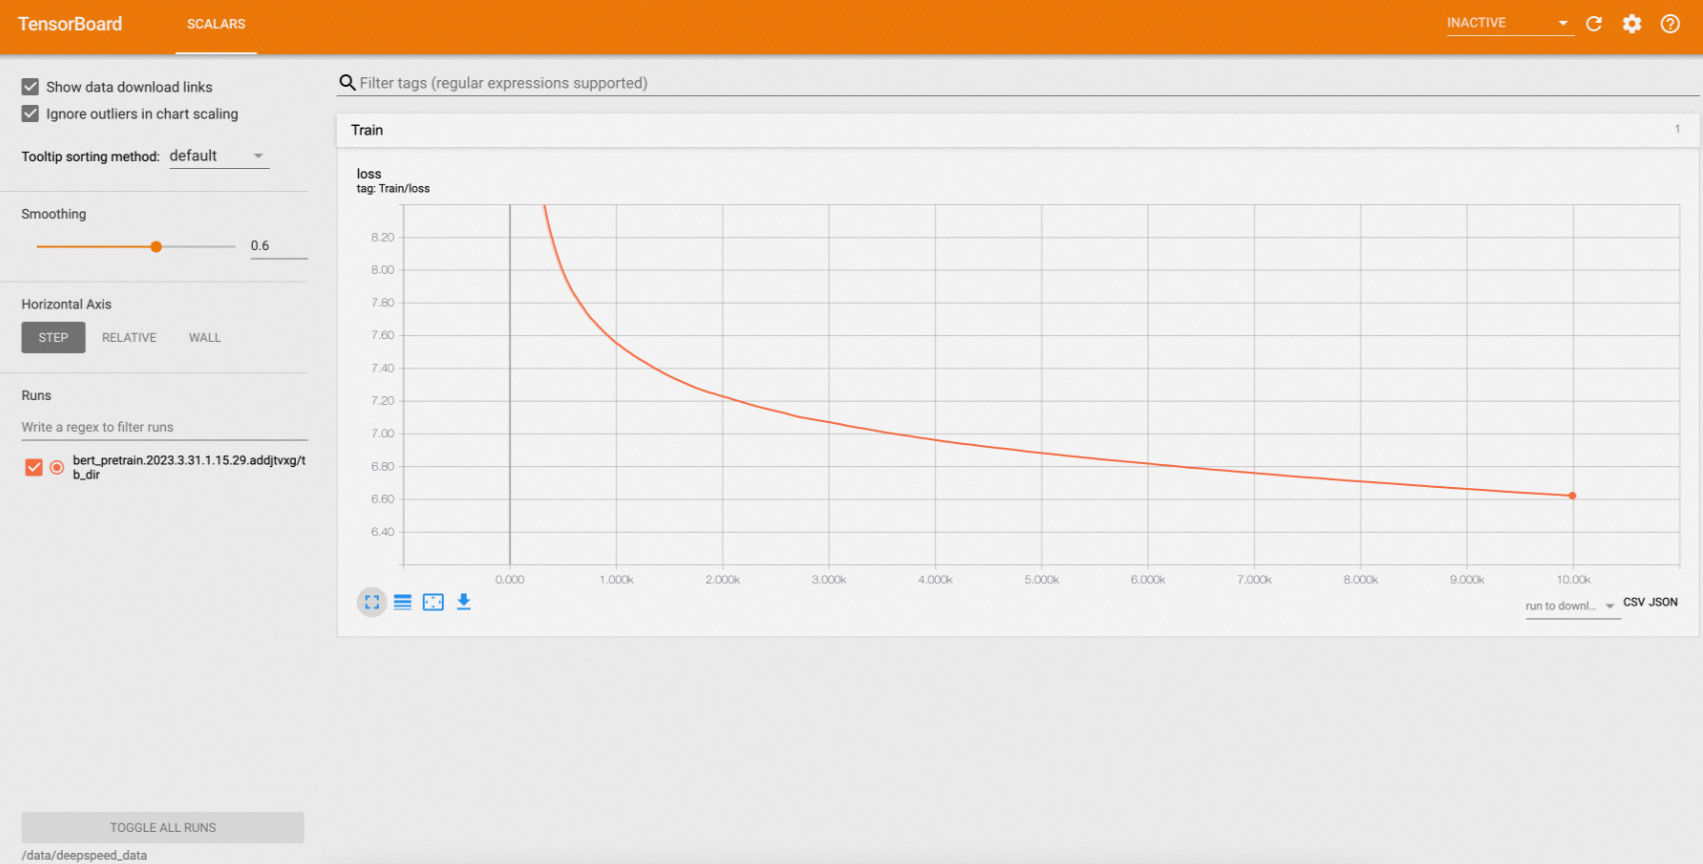
Étape 6 : Consulter les journaux d'entraînement
Affichez tous les journaux de la tâche :
arena logs deepspeed-helloworldRésultat attendu :
deepspeed-helloworld-worker-0: [2023-03-31 08:38:11,201] [INFO] [logging.py:68:log_dist] [Rank 0] step=7050, skipped=24, lr=[0.0001], mom=[(0.9, 0.999)]
deepspeed-helloworld-worker-0: [2023-03-31 08:38:11,254] [INFO] [timer.py:198:stop] 0/7050, RunningAvgSamplesPerSec=142.69733028759384, CurrSamplesPerSec=136.08094834473613, MemAllocated=0.06GB, MaxMemAllocated=1.68GB
deepspeed-helloworld-worker-0: 2023-03-31 08:38:11.255 | INFO     | __main__:log_dist:53 - [Rank 0] Loss: 6.7574
deepspeed-helloworld-worker-0: [2023-03-31 08:38:13,103] [INFO] [logging.py:68:log_dist] [Rank 0] step=7060, skipped=24, lr=[0.0001], mom=[(0.9, 0.999)]
deepspeed-helloworld-worker-0: [2023-03-31 08:38:13,134] [INFO] [timer.py:198:stop] 0/7060, RunningAvgSamplesPerSec=142.69095076844823, CurrSamplesPerSec=151.8552037291255, MemAllocated=0.06GB, MaxMemAllocated=1.68GB
deepspeed-helloworld-worker-0: 2023-03-31 08:38:13.136 | INFO     | __main__:log_dist:53 - [Rank 0] Loss: 6.7570
deepspeed-helloworld-worker-0: [2023-03-31 08:38:14,924] [INFO] [logging.py:68:log_dist] [Rank 0] step=7070, skipped=24, lr=[0.0001], mom=[(0.9, 0.999)]
deepspeed-helloworld-worker-0: [2023-03-31 08:38:14,962] [INFO] [timer.py:198:stop] 0/7070, RunningAvgSamplesPerSec=142.69048436022115, CurrSamplesPerSec=152.91029839772997, MemAllocated=0.06GB, MaxMemAllocated=1.68GB
deepspeed-helloworld-worker-0: 2023-03-31 08:38:14.963 | INFO     | __main__:log_dist:53 - [Rank 0] Loss: 6.7565
Pour diffuser les journaux en temps réel, utilisez l'option -f. Pour afficher uniquement les N dernières lignes, utilisez l'option -t N :
# Stream logs in real time
arena logs deepspeed-helloworld -f

# Print the last 5 lines
arena logs deepspeed-helloworld -t 5
Résultat attendu pour l'option -t 5 :
deepspeed-helloworld-worker-0: [2023-03-31 08:47:08,694] [INFO] [launch.py:318:main] Process 80 exits successfully.
deepspeed-helloworld-worker-2: [2023-03-31 08:47:08,731] [INFO] [launch.py:318:main] Process 44 exits successfully.
deepspeed-helloworld-worker-1: [2023-03-31 08:47:08,946] [INFO] [launch.py:318:main] Process 44 exits successfully.
/opt/conda/lib/python3.8/site-packages/apex/pyprof/__init__.py:5: FutureWarning: pyprof will be removed by the end of June, 2022
  warnings.warn("pyprof will be removed by the end of June, 2022", FutureWarning)
Exécutez arena logs --help pour voir toutes les options de journalisation disponibles.