Le composant kube-scheduler est l'ordonnanceur par défaut d'un cluster Kubernetes. Il affecte les Pods aux nœuds appropriés. Cette rubrique décrit les métriques de surveillance du composant kube-scheduler, explique comment utiliser son tableau de bord et détaille la résolution des anomalies de métriques courantes.
Avant de commencer
Accéder au tableau de bord
Consultez la section Afficher les tableaux de bord de surveillance des composants du plan de contrôle.
Liste des métriques
Les métriques exposent l'état et les paramètres d'un composant. Le tableau suivant répertorie celles du composant kube-scheduler.
Métrique | Type | Description |
scheduler_scheduler_cache_size | Gauge | Nombre de nœuds, de Pods et d'AssumedPods (Pods supposés planifiés) dans le cache de l'ordonnanceur. |
scheduler_pending_pods | Gauge | Nombre de Pods en attente, classés par type de file :
|
scheduler_pod_scheduling_attempts_bucket | Histogram | Nombre de tentatives nécessaires pour planifier un Pod. Les seuils des compartiments sont |
memory_utilization_byte | Gauge | Utilisation mémoire, en octets. |
cpu_utilization_core | Gauge | Utilisation CPU, en cœurs. |
resource_utilization_level | Gauge | Niveau d'utilisation des ressources.
|
rest_client_requests_total | Counter | Nombre de requêtes HTTP, classées par code d'état, méthode et hôte. |
rest_client_request_duration_seconds_bucket | Histogram | Latence des requêtes HTTP, classée par verbe et URL. |
Les métriques d'utilisation des ressources suivantes sont obsolètes. Supprimez toute alerte ou règle de surveillance qui s'appuie dessus :
cpu_utilization_ratio : utilisation CPU.
memory_utilization_ratio : utilisation mémoire.
Tableau de bord
Le tableau de bord visualise les métriques des composants via des requêtes PromQL. Les sections suivantes décrivent ces visualisations et les métriques associées.
Overview
Visualisation
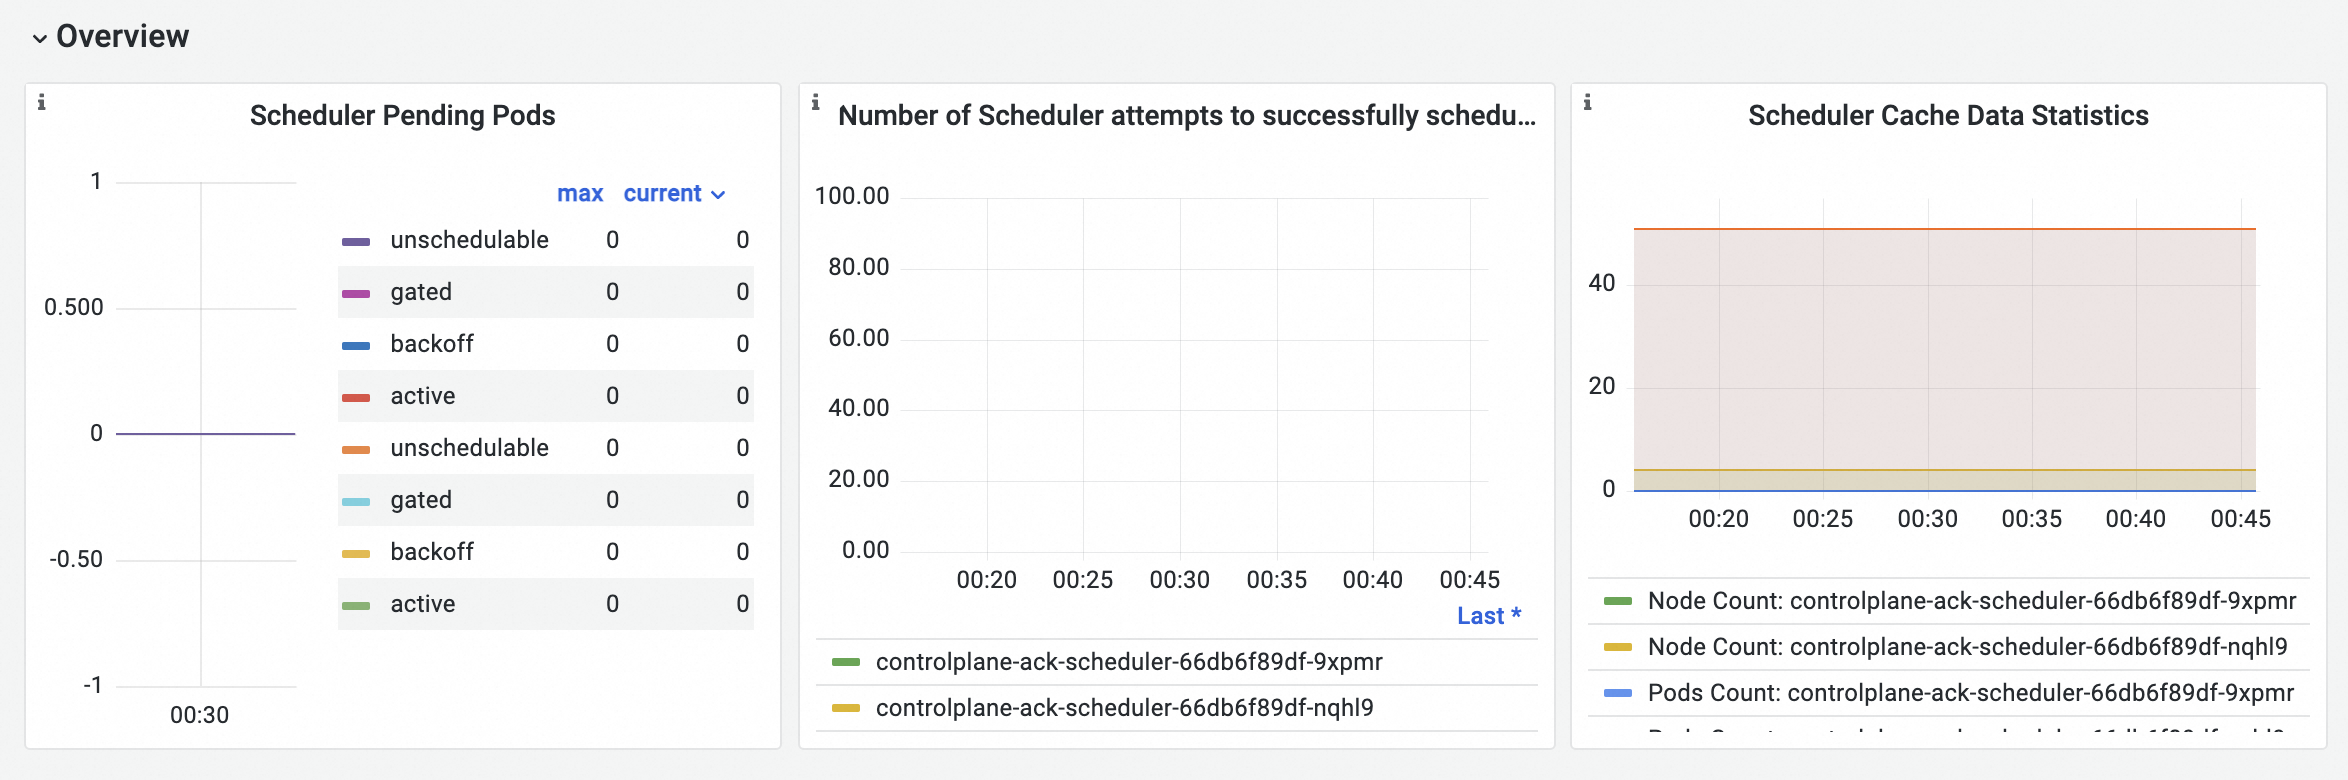
Détails des métriques
Métrique | PromQL | Description |
Pods en attente de l'ordonnanceur | scheduler_pending_pods{job="ack-scheduler"} | Nombre de Pods en attente, classés par type de file :
|
Tentatives de planification des Pods par l'ordonnanceur | histogram_quantile($quantile, sum(rate(scheduler_pod_scheduling_attempts_bucket{job="ack-scheduler"}[$interval])) by (pod, le)) | Nombre de tentatives nécessaires pour planifier un Pod. Les seuils des compartiments sont |
Statistiques du cache de l'ordonnanceur |
| Nombre de nœuds, de Pods et d'AssumedPods dans le cache de l'ordonnanceur. |
Resources
Visualisation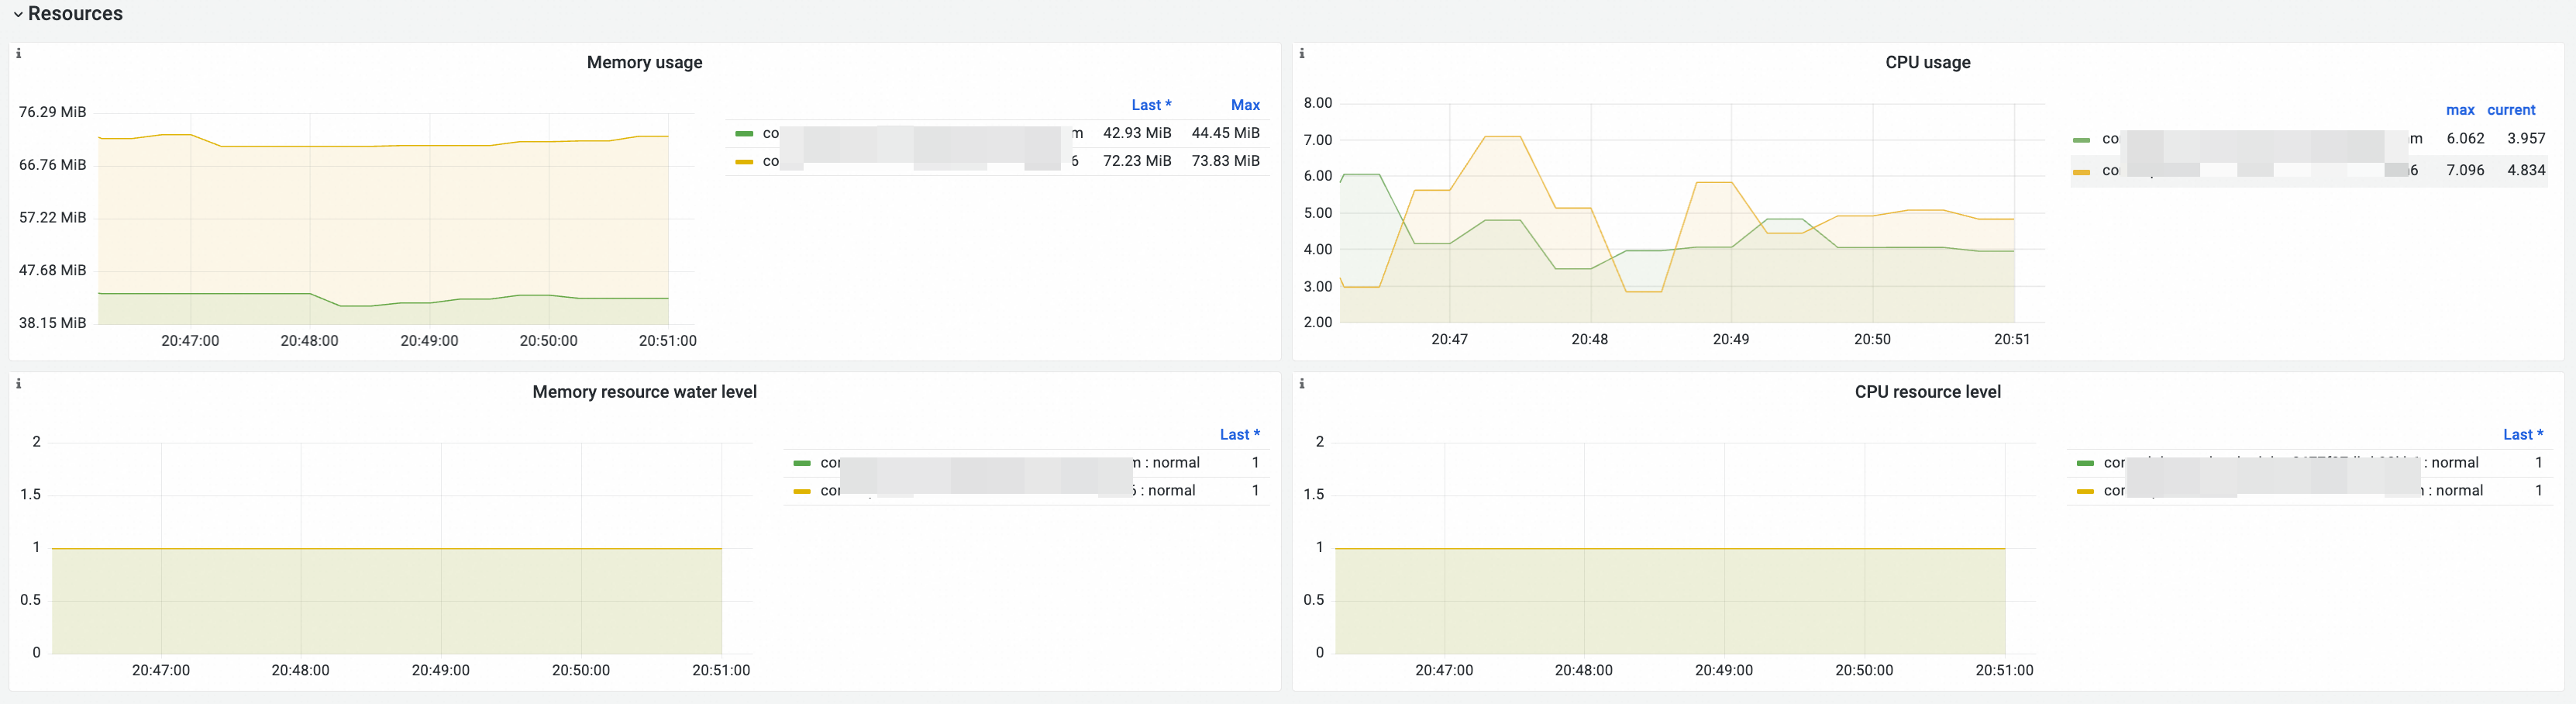
Détails des métriques
Métrique | PromQL | Description |
Utilisation mémoire | memory_utilization_byte{container="kube-scheduler"} | Utilisation mémoire, en octets. |
CPU Usage | cpu_utilization_core{container="kube-scheduler"}*1000 | Utilisation CPU, en millicœurs. |
Niveau d'utilisation des ressources mémoire |
|
|
Niveau d'utilisation des ressources CPU |
|
Kube API
Visualisation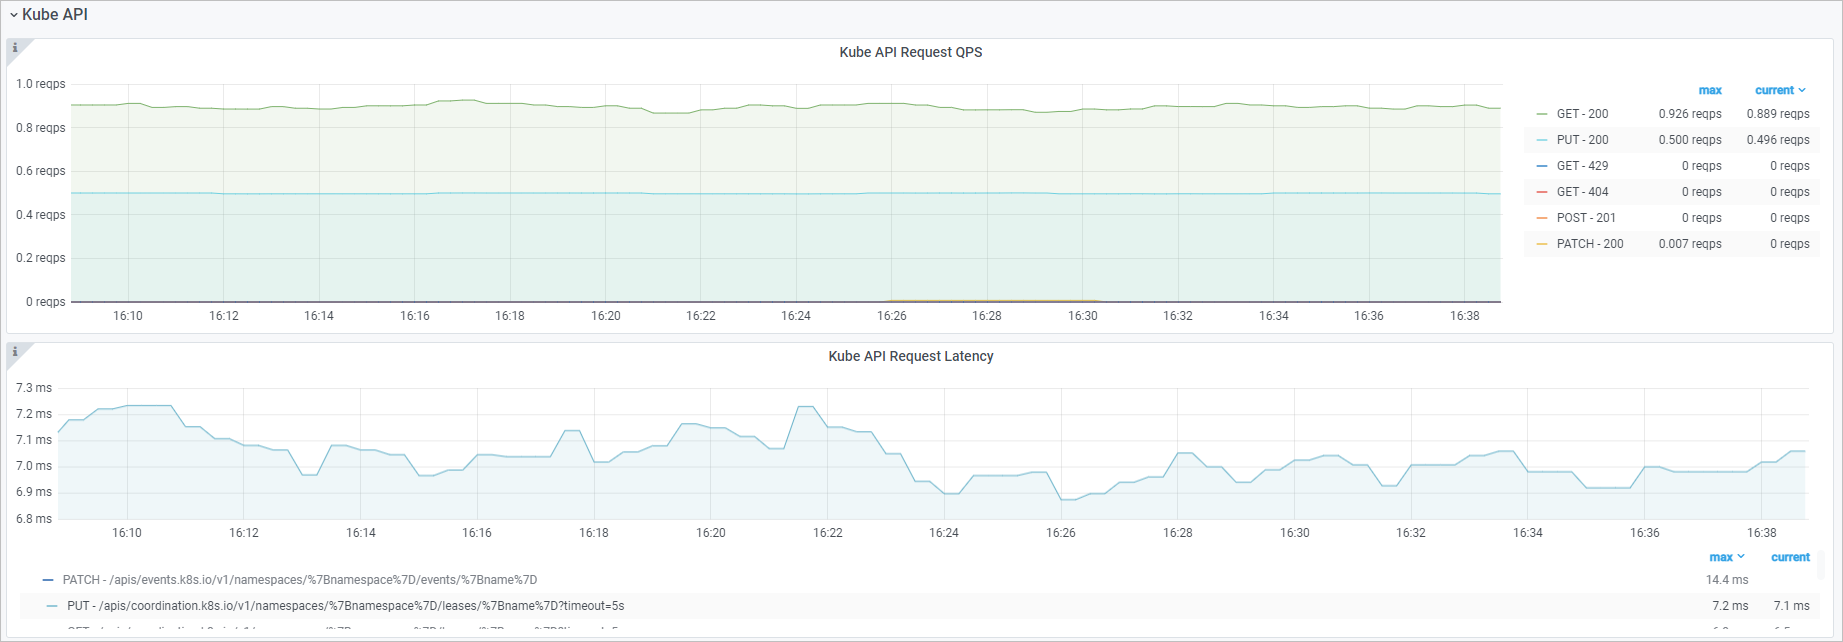
Détails des métriques
Métrique | PromQL | Description |
QPS des requêtes Kube API |
| Taux de requêtes HTTP envoyées par kube-scheduler au composant kube-apiserver, classées par méthode et code d'état. |
Latence des requêtes Kube API | histogram_quantile($quantile, sum(rate(rest_client_request_duration_seconds_bucket{job="ack-scheduler"}[$interval])) by (verb,url,le)) | Latence des requêtes HTTP envoyées par kube-scheduler au composant kube-apiserver, classée par verbe et URL de requête. |
Anomalies de métriques courantes
En cas d'anomalie de métrique, vérifiez si le comportement observé est attendu à l'aide des descriptions ci-dessous.
Nombre de Pods d'ordonnanceur actifs
Condition normale | Condition anormale | Description | Recommandation |
Le nombre de Pods d'ordonnanceur actifs est supérieur ou égal à 1. | Le nombre de Pods d'ordonnanceur actifs est égal à 0. | Aucun ordonnanceur n'est disponible dans le cluster. |
|
Nombre de Pods en attente
Condition normale | Condition anormale | Description | Recommandation |
Le taux de planification des Pods est stable et le nombre de Pods en attente reste faible. |
| Les demandes de ressources des Pods du cluster sont inappropriées ou les ressources des nœuds sont insuffisantes. |
|
Tentatives de planification des Pods
Condition normale | Condition anormale | Description | Recommandation |
Un Pod est planifié sur un nœud après quelques tentatives. | Un Pod reste non planifié après plusieurs tentatives. | Les demandes de ressources des Pods du cluster sont inappropriées ou les ressources des nœuds sont insuffisantes. |
|
Rubriques connexes
Pour en savoir plus sur les métriques, les tableaux de bord et les anomalies courantes des autres composants du plan de contrôle, consultez les rubriques suivantes : Métriques de surveillance du composant kube-apiserver, Métriques de surveillance du composant etcd, Métriques de surveillance du composant kube-controller-manager et Métriques de surveillance du composant cloud-controller-manager.