Surveillez les clusters ACK à travers quatre couches : infrastructure, conteneur, application et métier.
Observabilité d'ACK
L'architecture d'observabilité d'ACK comprend quatre couches, de bas en haut : infrastructure, performance des conteneurs, performance des applications et métier.
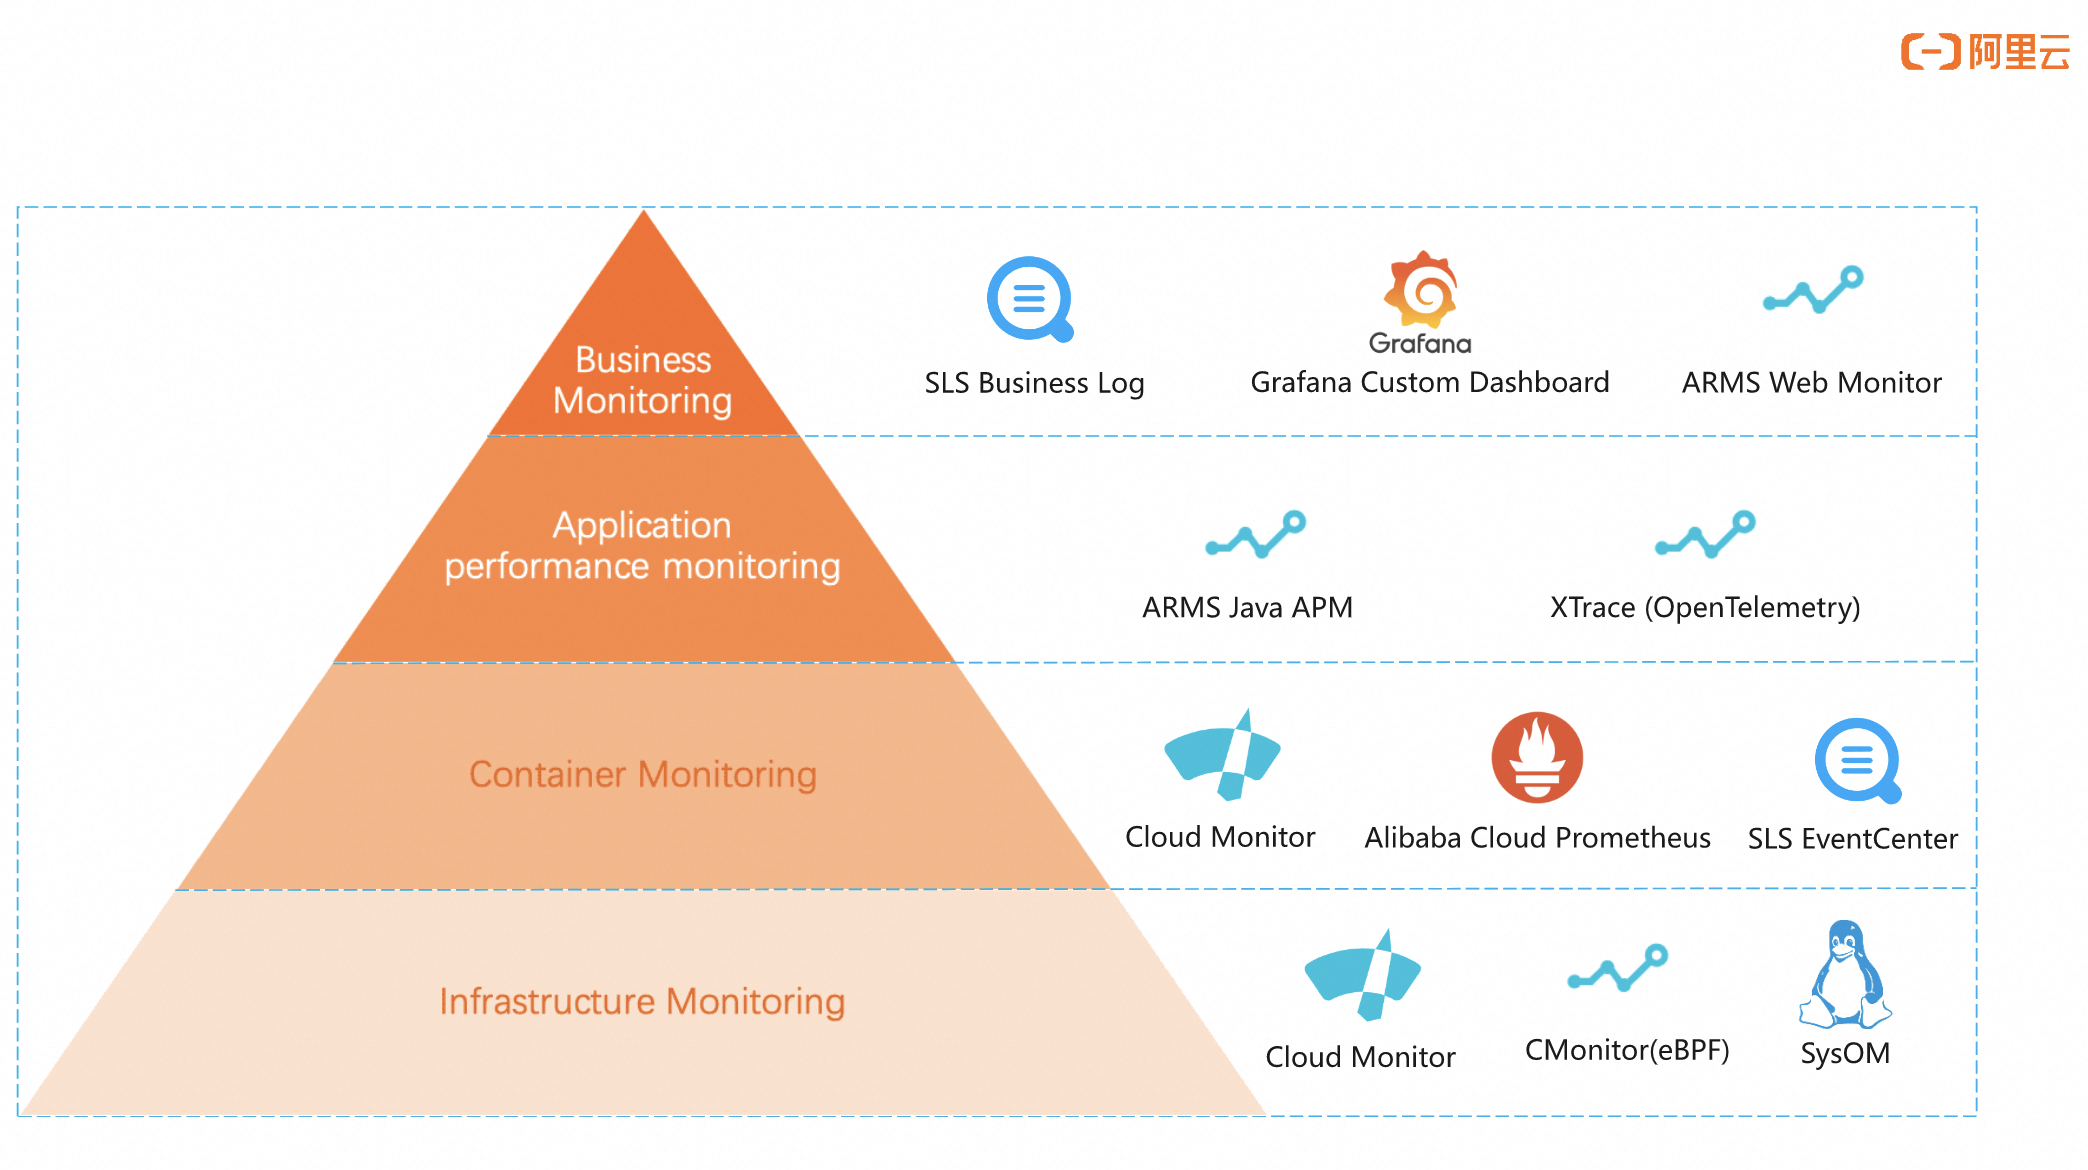
Les sections suivantes décrivent chaque couche.
Observabilité de l'infrastructure
Cette couche surveille les ressources sous-jacentes des clusters ACK, notamment les pools de ressources de pods et de nœuds, les relations topologiques ainsi que les performances de l'hôte et du plug-in réseau.
Solution | Description | Scenario | References |
Visualized architecture discovery | Les charges de travail ACK s'exécutent dans des pools de ressources basés sur des nœuds, où il est difficile de suivre les traces des pods et les relations topologiques. La surveillance Kubernetes dans ACK intègre Extended Berkeley Packet Filter (eBPF) et Managed Service for Prometheus pour la collecte de métriques de bout en bout, le traçage, l'analyse des journaux et la surveillance des événements, avec une visibilité du réseau et de l'architecture sans intrusion. | Tous les scénarios.
| |
Kernel-level container monitoring | ACK fournit une surveillance des conteneurs au niveau du noyau basée sur System Observer Monitoring (SysOM) pour faciliter le déploiement, la migration et la surveillance des applications conteneurisées. | Tous les scénarios. | |
Collection of infrastructure metrics | Surveillez l'utilisation des ressources CPU, mémoire et réseau pour les clusters ACK. | Tous les scénarios. |
Observabilité des performances des conteneurs
Surveillez les métriques de performance des clusters, des conteneurs et des composants, et détectez les événements du cluster.
Collecter les métriques de performance des clusters et des conteneurs
|
Solution |
Description |
Scenario |
References |
|
Intégration de Cloud Monitor avec ACK |
ACK surveille les métriques de performance des clusters et des conteneurs, avec une visualisation intégrée dans la console ACK. |
Scénarios limités. Métriques de performance personnalisées des conteneurs et observabilité. |
Voir [[Deprecated] Basic resource monitoring](t947566.dita#task_1180854). |
|
Managed Service for Prometheus |
Service de surveillance entièrement géré compatible avec l'écosystème open source Prometheus. Fournit des tableaux de bord prêts à l'emploi pour un large éventail de composants sans infrastructure de surveillance autogérée. Recommandé. |
Tous les scénarios, tels que les microservices, la collecte de métriques de composants et la personnalisation avancée de l'observabilité. |
|
|
Prometheus open source |
Disponible sur le marketplace de la console ACK. |
Tous les scénarios, tels que les microservices (Service Mesh), la collecte de métriques de composants et la personnalisation avancée de l'observabilité. |
Surveiller les événements des clusters et des conteneurs
|
Solution |
Description |
Scenario |
References |
|
Surveillance des événements |
Complète la surveillance des ressources par une capture d'événements en temps réel pour le diagnostic des anomalies du cluster. Simple Log Service (SLS) recommandé. |
Tous les scénarios. |
Observabilité des performances des applications
Couvre les métriques, le traçage et la journalisation des applications. Par exemple, vous pouvez surveiller le nombre de threads des applications Java déployées dans ACK.
Solution | Description | Scenario | References |
APM sans intrusion pour la surveillance des applications Java | Application Real-Time Monitoring Service (ARMS) fournit une APM sans intrusion pour les applications Java dans ACK. Installez le module complémentaire ARMS pour localiser les interfaces défaillantes et lentes, ajuster les paramètres, détecter les fuites de mémoire et identifier les goulets d'étranglement de performance. Recommandé. | Surveillance des applications Java. Sans intrusion. | |
APM instrumenté par code | Tracing Analysis diagnostique les goulets d'étranglement de performance dans les architectures distribuées grâce à la cartographie des traces, au comptage des requêtes, à la visualisation de la topologie et à l'analyse des dépendances. Prend en charge OpenTracing, OpenTelemetry et divers SDK open source. | Tous les scénarios, y compris les microservices (Service Mesh) et les applications multilingues. Conforme à OpenTelemetry. Nécessite une instrumentation du code. | |
Managed Service for OpenTelemetry fournit un ensemble d'outils pour le développement d'applications distribuées. Il collecte les données de trace de vos microservices, les agrège en temps réel et vous aide à identifier les goulets d'étranglement de performance, à cartographier les traces, à compter les requêtes, à afficher les topologies de traces et à analyser les dépendances des applications dans les architectures distribuées. Cela améliore l'efficacité du développement et du diagnostic des microservices. | Conforme à OpenTracing. Prend en charge des plateformes telles que Jaeger et Zipkin, et des langages incluant Java, PHP, Go, Python, Node.js, .NET, C++, Ruby et Swift. | Voir What is Tracing Analysis OpenTelemetry Edition? et Integrate services or components. |
Observabilité métier
Suit les statistiques au niveau métier telles que les pages vues (PV) et les visiteurs uniques (UV), et prend en charge l'audit des coûts pour les applications déployées sur ACK.
|
Solution |
Description |
Scenario |
References |
|
Journalisation et surveillance personnalisées |
Personnalisez le contenu et le format des journaux d'application, collectez les journaux avec SLS et configurez des tableaux de bord pour la surveillance métier ou l'audit système. Recommandé. |
Tous les scénarios, tels que la surveillance du trafic, l'audit des coûts et l'analyse des tendances des commandes. |
|
|
Tableaux de bord personnalisés avec Managed Service for Grafana |
Managed Service for Grafana est une plateforme de visualisation cloud-native avec des environnements d'exécution sans maintenance opérationnelle. Ingère les données des services Alibaba Cloud tels que les bases de données, Message Queue, Prometheus et SLS, et fournit des tableaux de bord de surveillance granulaires. Analysez les métriques, les journaux et les traces sans gérer de serveurs ni de mises à jour, avec sécurité et haute disponibilité intégrées. |
Tous les scénarios. Configurez des tableaux de bord pour les besoins métier, tels que la surveillance en temps réel des PV et UV. |
Voir What is Grafana? |
|
Surveillance du trafic et de la santé métier avec ARMS Browser Monitoring |
Surveille les applications web, Weex et les mini-programmes en suivant les vitesses de chargement des pages, la stabilité des erreurs JS et les taux de réussite des appels API. |
Applications JavaScript front-end. |
Références
Surveillance des journaux : Log management, Collect log data from containers by using SLS et Configure Log4jAppender for Kubernetes and SLS.
Métriques : Java application monitoring, [[Deprecated] Cluster topology monitoring](t2214403.xdita#) et Event monitoring.
Services de surveillance et tableaux de bord : Configure Managed Service for Prometheus, Ingress Dashboard, Monitor the CoreDNS component, Query Prometheus monitoring data by using PromQL et SysOM kernel-level container monitoring.