Dans une architecture à accès mémoire non uniforme (NUMA), les charges de travail gourmandes en GPU sur des nœuds multi-GPU pâtissent de la séparation des CPU et des GPU sur des nœuds NUMA distincts. Les accès mémoire inter-nœuds augmentent la latence, limitent la bande passante et dégradent le débit. La planification sensible à la topologie NUMA d'ACK place les CPU et les GPU d'un Pod sur le même nœud NUMA, éliminant ainsi le trafic inter-nœuds inutile.
Fonctionnement
Le nœud NUMA est l'unité de base d'un système NUMA. Un ensemble NUMA regroupe plusieurs nœuds sur un seul nœud de calcul pour allouer efficacement les ressources et réduire la contention mémoire du processeur. Les nœuds de calcul équipés de huit GPU comportent généralement plusieurs nœuds NUMA. Sans colocalisation des CPU et des GPU sur le même nœud NUMA, les applications subissent une contention CPU et une surcharge de communication entre nœuds NUMA.
Kubernetes natif s'appuie sur les politiques CPU et NUMA de kubelet pour la liaison des ressources au niveau d'un seul nœud, mais cette approche présente des lacunes à l'échelle du cluster :
Absence de visibilité du planificateur : Le planificateur ne peut pas évaluer les ressources NUMA restantes lors des décisions de placement, ce qui entraîne des états
AdmissionErrorpour les Pods et déstabilise le cluster.Placement incontrôlable : Les politiques de topologie sont des paramètres au niveau du nœud ; vous ne pouvez donc pas utiliser l'affinité de nœud pour contrôler la colocalisation à l'échelle du cluster.
Manque de flexibilité des politiques : Chaque nœud ne prend en charge qu'une seule politique de topologie, ce qui nécessite un partitionnement manuel du cluster et l'ajout d'étiquettes, réduisant ainsi l'utilisation globale des ressources.
ACK résout ces limitations grâce au Scheduler Framework. Les composants gputopo-device-plugin et ack-koordlet d'ack-koordinator signalent la topologie CPU et GPU de chaque nœud au planificateur, vous permettant ainsi de déclarer des politiques de placement NUMA au niveau du Pod.

Prérequis
Avant de commencer, assurez-vous que vous disposez des éléments suivants :
Cluster :
Un cluster ACK Pro exécutant la version 1.24 ou ultérieure. Pour mettre à niveau, consultez la rubrique Mettre à niveau un cluster.
Nœuds :
Des nœuds de la famille d'instances sccgn7ex (clusters de supercalcul accélérés par GPU) ou des nœuds Lingjun. Pour plus de détails sur les familles d'instances, consultez la rubrique Familles d'instances. Pour les nœuds Lingjun, reportez-vous à la section Gérer les clusters LINGJUN et les nœuds Lingjun.
L'étiquette
ack.node.gpu.schedule=topologyajoutée à chaque nœud pour lequel vous souhaitez activer la planification GPU sensible à la topologie. Pour obtenir des instructions, consultez la rubrique Activer les fonctionnalités de planification.
Composants :
kube-scheduler version 6.4.4 ou ultérieure. Pour mettre à niveau, accédez à la console ACK, cliquez sur le nom de votre cluster, puis choisissez Operations Management > Add-ons. Pour plus d'informations, consultez la documentation kube-scheduler.
-
Le module complémentaire ack-koordinator (anciennement ack-slo-manager) installé avec la configuration suivante :
Clusters ACK Lingjun : Installez directement ack-koordinator sans configuration supplémentaire.
Clusters ACK Pro : Définissez le champ
NodeTopologyReportdans la Feature GateagentFeaturessurtruelors de l'installation.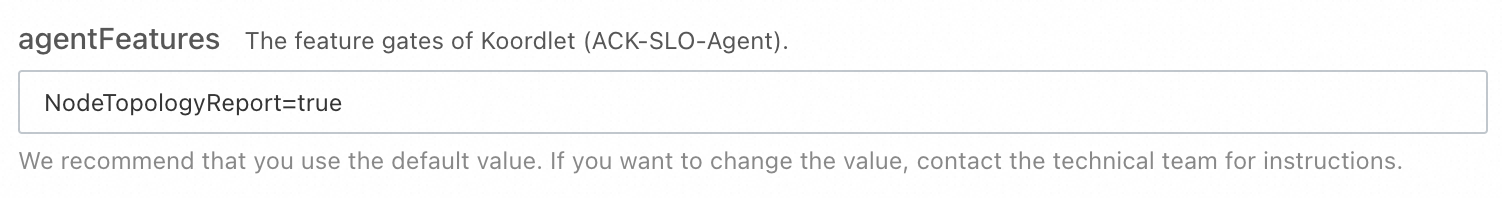
Le module complémentaire de signalement de la topologie GPU (gputopo-device-plugin) installé. Ce module collecte les informations de topologie NUMA GPU-CPU et les signale au cluster. Pour les instructions d'installation, consultez la rubrique Installer le module complémentaire de planification sensible à la topologie GPU.
Si vous installez le module complémentaire de signalement de la topologie GPU avant ack-koordinator, redémarrez le module complémentaire de signalement de la topologie GPU une fois l'installation d'ack-koordinator terminée.
Limitations
Incompatibilité :
Cette fonctionnalité fournit une planification unifiée de l'affinité NUMA pour les CPU et les GPU. Elle est mutuellement exclusive avec les anciennes politiques de planification autonomes. N'activez pas cette fonctionnalité sur les charges de travail qui utilisent déjà la planification CPU sensible à la topologie ou l'ancienne version autonome de la planification GPU sensible à la topologie.
Seule la colocalisation CPU et GPU est prise en charge.
Exigences relatives aux spécifications des ressources :
Les requêtes CPU pour tous les conteneurs d'un Pod doivent être des nombres entiers (unité : cœurs) et les requêtes doivent être égales aux limites.
Les ressources GPU doivent être demandées en utilisant
aliyun.com/gpuet nonnvidia.com/gpu. Seules les cartes GPU entières sont prises en charge.
Facturation
Cette fonctionnalité nécessite la suite Cloud-Native AI, qui peut engendrer des frais supplémentaires. Pour plus de détails, consultez la rubrique Facturation de la suite Cloud-Native AI.
Ressources des nœuds de calcul : ack-koordinator s'exécute en tant que composant auto-géré sur les nœuds de calcul et consomme du CPU et de la mémoire. Configurez les requêtes de ressources pour chaque module lors de l'installation.
Métriques de surveillance Prometheus : Si vous sélectionnez Enable Prometheus Metrics for ACK-Koordinator lors de l'installation et que vous utilisez Alibaba Cloud Prometheus, les métriques sont comptabilisées comme des métriques personnalisées et engendrent des frais basés sur la taille du cluster et le nombre d'applications. Avant d'activer cette option, examinez la documentation sur la facturation de Prometheus pour connaître le quota gratuit et les détails de facturation. Surveillez l'utilisation via les requêtes de facturation et d'utilisation.
Activer la planification sensible à la topologie NUMA
Ajoutez les annotations suivantes à la spécification de votre Pod. Les commentaires dans le fichier YAML répertorient toutes les valeurs valides pour chaque champ.
apiVersion: v1
kind: Pod
metadata:
  name: example
  annotations:
    # Enables CPU binding. Only "required" is supported.
    cpuset-scheduler: required
    # numaTopologyPolicy controls placement scope:
    #   "SingleNUMANode" – all CPUs and GPUs on the same NUMA node (strict)
    #   "Restricted"     – all CPUs and GPUs within the same NUMA set (strict)
    #   "BestEffort"     – attempts same-node placement; falls back if unavailable
    # singleNUMANodeExclusive controls which NUMA node types are eligible:
    #   "Required" (default) – avoids NUMA nodes already used by pods with a different topology type
    #   "Preferred"          – no restriction on NUMA node type
    scheduling.alibabacloud.com/numa-topology-spec: |
      {
        "numaTopologyPolicy": "SingleNUMANode",
        "singleNUMANodeExclusive": "Preferred"
      }
spec:
  containers:
  - name: example
    image: ghcr.io/huggingface/text-generation-inference:1.4
    resources:
      limits:
        aliyun.com/gpu: '4'
        cpu: '24'
      requests:
        aliyun.com/gpu: '4'
        cpu: '24'
Politique de placement (numaTopologyPolicy)
numaTopologyPolicy contrôle l'étendue du placement des CPU et des GPU.
| Valeur | Comportement | Lorsque la politique ne peut pas être satisfaite |
|---|---|---|
SingleNUMANode |
Place tous les CPU et GPU sur le même nœud NUMA | Le Pod n'est pas planifié |
Restricted |
Place tous les CPU et GPU au sein du même ensemble NUMA (plusieurs nœuds sur un seul nœud de calcul) | Le Pod n'est pas planifié |
BestEffort |
Tente de placer les CPU et les GPU sur le même nœud NUMA | Sélectionne le meilleur nœud disponible suivant |
Politique d'exclusivité (singleNUMANodeExclusive)
singleNUMANodeExclusive contrôle les types de nœuds NUMA que le Pod peut utiliser.
Les nœuds NUMA sont catégorisés selon leur occupation actuelle :
| Type de nœud NUMA | Description |
|---|---|
idle |
Aucun Pod n'est en cours d'exécution dessus |
single |
Seuls les Pods liés à un seul nœud NUMA sont en cours d'exécution dessus |
shared |
Seuls les Pods répartis sur plusieurs nœuds NUMA sont en cours d'exécution dessus |
| Valeur | Règle de placement |
|---|---|
Required (par défaut) |
Les Pods Single-NUMA ne peuvent atterrir que sur les nœuds idle ou single. Les Pods Multi-NUMA ne peuvent atterrir que sur les nœuds idle ou shared. |
Preferred |
Aucune restriction sur le type de nœud NUMA |
Comparaison des performances
Le test suivant mesure le temps de chargement du modèle avant et après l'activation de la planification sensible à la topologie NUMA. Le test utilise text-generation-inference pour charger un modèle sur quatre cartes GPU, NVIDIA Nsight Systems mesurant la vitesse de chargement du GPU.
Environnement de test : nœuds Lingjun, text-generation-inference v1.4 (télécharger), NVIDIA Nsight Systems (télécharger)
Les résultats des tests varient selon l'outil et l'environnement. Les données ci-dessous ont été collectées à l'aide de NVIDIA Nsight Systems ; vos résultats peuvent différer.
Le Deployment suivant utilise des requêtes de ressources nvidia.com/gpu standard, sans annotations NUMA.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: tgi
  name: tgi-deployment-basic
  namespace: test
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tgi
  template:
    metadata:
      labels:
        app: tgi
    spec:
      containers:
        - command:
            - sleep
            - 3600d
          image: ghcr.io/huggingface/text-generation-inference:1.4
          imagePullPolicy: IfNotPresent
          name: tgi
          ports:
            - containerPort: 80
              protocol: TCP
          resources:
            limits:
              cpu: '24'
              nvidia.com/gpu: '4'
            requests:
              cpu: '24'
              nvidia.com/gpu: '4'
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /llm
              name: volume-1710932083254
      restartPolicy: Always
      schedulerName: default-scheduler
      volumes:
        - name: volume-1710932083254
          persistentVolumeClaim:
            claimName: model
Temps de chargement du modèle : 15,9 s

Avec planification sensible à la topologie
Le Deployment suivant ajoute des annotations de topologie NUMA et remplace la requête de ressource GPU de nvidia.com/gpu par aliyun.com/gpu. Cette modification permet au planificateur ACK d'identifier et de gérer l'affinité NUMA GPU-CPU.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: tgi-numa
  name: tgi-numa-deployment-basic
  namespace: yueming-test
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tgi-numa
  template:
    metadata:
      annotations:
        cpuset-scheduler: required
        scheduling.alibabacloud.com/numa-topology-spec: |
          {
            "numaTopologyPolicy": "SingleNUMANode"
          }
      labels:
        app: tgi-numa
    spec:
      containers:
        - command:
            - sleep
            - 3600d
          image: ghcr.io/huggingface/text-generation-inference:1.4
          imagePullPolicy: IfNotPresent
          name: numa
          resources:
            limits:
              aliyun.com/gpu: '4'
              cpu: '24'
            requests:
              aliyun.com/gpu: '4'
              cpu: '24'
          volumeMounts:
            - mountPath: /llm
              name: volume-1710932083254
      restartPolicy: Always
      schedulerName: default-scheduler
      volumes:
        - name: volume-1710932083254
          persistentVolumeClaim:
            claimName: model
Temps de chargement du modèle : 5,4 s, soit une amélioration de 66 % par rapport à la référence.

Étapes suivantes
Activer l'accélération de l'accès mémoire le plus proche pour les conteneurs