Sur les instances multi-NUMA, les charges de travail colocalisées peuvent saturer la mémoire locale et repousser les pages mémoire d'une application vers des nœuds NUMA distants. L'accès entre nœuds via le bus QuickPath Interconnect (QPI) est plus lent que l'accès local, ce qui dégrade le débit et augmente la latence. La fonction d'accélération de l'accès mémoire local d'ack-koordinator détecte les pages mémoire distantes à l'exécution et les migre vers le nœud NUMA local sans interrompre les services en cours d'exécution.
Prérequis
Avant de commencer, vérifiez que vous disposez des éléments suivants :
Un cluster ACK Pro exécutant Kubernetes 1.18 ou une version ultérieure. Pour plus d'informations, consultez la rubrique Créer un cluster ACK managé.
Un client kubectl connecté au cluster. Pour plus d'informations, consultez la rubrique Obtenir le fichier kubeconfig d'un cluster et utiliser kubectl pour se connecter au cluster.
-
ack-koordinator (anciennement ack-slo-manager) version 1.2.0-ack1.2 ou ultérieure installée. Pour plus d'informations, consultez la rubrique ack-koordinator (anciennement ack-slo-manager).
Remarqueack-koordinator inclut toutes les fonctionnalités de resource-controller. Si vous utilisez actuellement resource-controller, désinstallez-le avant d'installer ack-koordinator. Pour plus d'informations, consultez la rubrique Désinstaller resource-controller.
-
Des instances Elastic Compute Service (ECS) de 5e, 6e, 7e ou 8e génération appartenant aux familles d'instances ecs.ebmc, ecs.ebmg, ecs.ebmgn, ecs.ebmr, ecs.ebmhfc ou ecs.scc, déployées en tant qu'instances multi-NUMA.
RemarqueLa fonction offre les meilleures performances sur les instances ECS de 8e génération des types ecs.ebmc8i.48xlarge, ecs.c8i.32xlarge et ecs.g8i.48xlarge. Pour plus d'informations, consultez la rubrique Familles d'instances ECS.
Des applications déployées sur des instances multi-NUMA avec des cœurs CPU liés à l'aide de la planification CPU consciente de la topologie. Pour plus d'informations, consultez la rubrique Activer la planification CPU consciente de la topologie.
Facturation
L'installation et l'utilisation d'ack-koordinator sont gratuites. Toutefois, les scénarios suivants peuvent engendrer des frais :
ack-koordinator est un composant non managé qui consomme des ressources des nœuds de calcul après l'installation. Vous pouvez spécifier la quantité de ressources demandée par chaque module lors de l'installation.
Par défaut, ack-koordinator expose les métriques de surveillance (telles que le profilage des ressources et les métriques de planification fine) sous forme de métriques Prometheus. Si vous activez les métriques Prometheus pour ack-koordinator et utilisez Managed Service for Prometheus, ces métriques sont comptabilisées comme des métriques personnalisées et des frais s'appliquent. Avant l'activation, lisez la rubrique Facturation relative à Managed Service for Prometheus pour comprendre le quota gratuit et les règles de facturation. Pour plus d'informations, consultez la rubrique Interroger la quantité de données observables et les factures.
Fonctionnement
Dans l'architecture multi-NUMA, les processus s'exécutant sur un vCore d'un nœud NUMA peuvent avoir besoin d'accéder à la mémoire d'un nœud NUMA distant. Cet accès entre nœuds transite par le bus QPI et prend plus de temps que l'accès à la mémoire locale. Sous de fortes charges mémoire, par exemple lorsque les charges de travail colocalisées sur le même nœud NUMA épuisent la mémoire locale, les pages mémoire d'une application peuvent être repoussées vers un nœud NUMA distant, réduisant ainsi le taux de succès des accès à la mémoire locale et dégradant les performances.
ack-koordinator remédie à cette dérive mémoire à l'exécution. Lorsque la localité mémoire est activée pour un pod, l'agent koordlet sur chaque nœud détecte quelles pages mémoire du pod résident sur des nœuds NUMA distants et les migre vers le nœud local. La migration est sûre et ne nécessite ni le redémarrage du pod ni l'interruption du trafic.
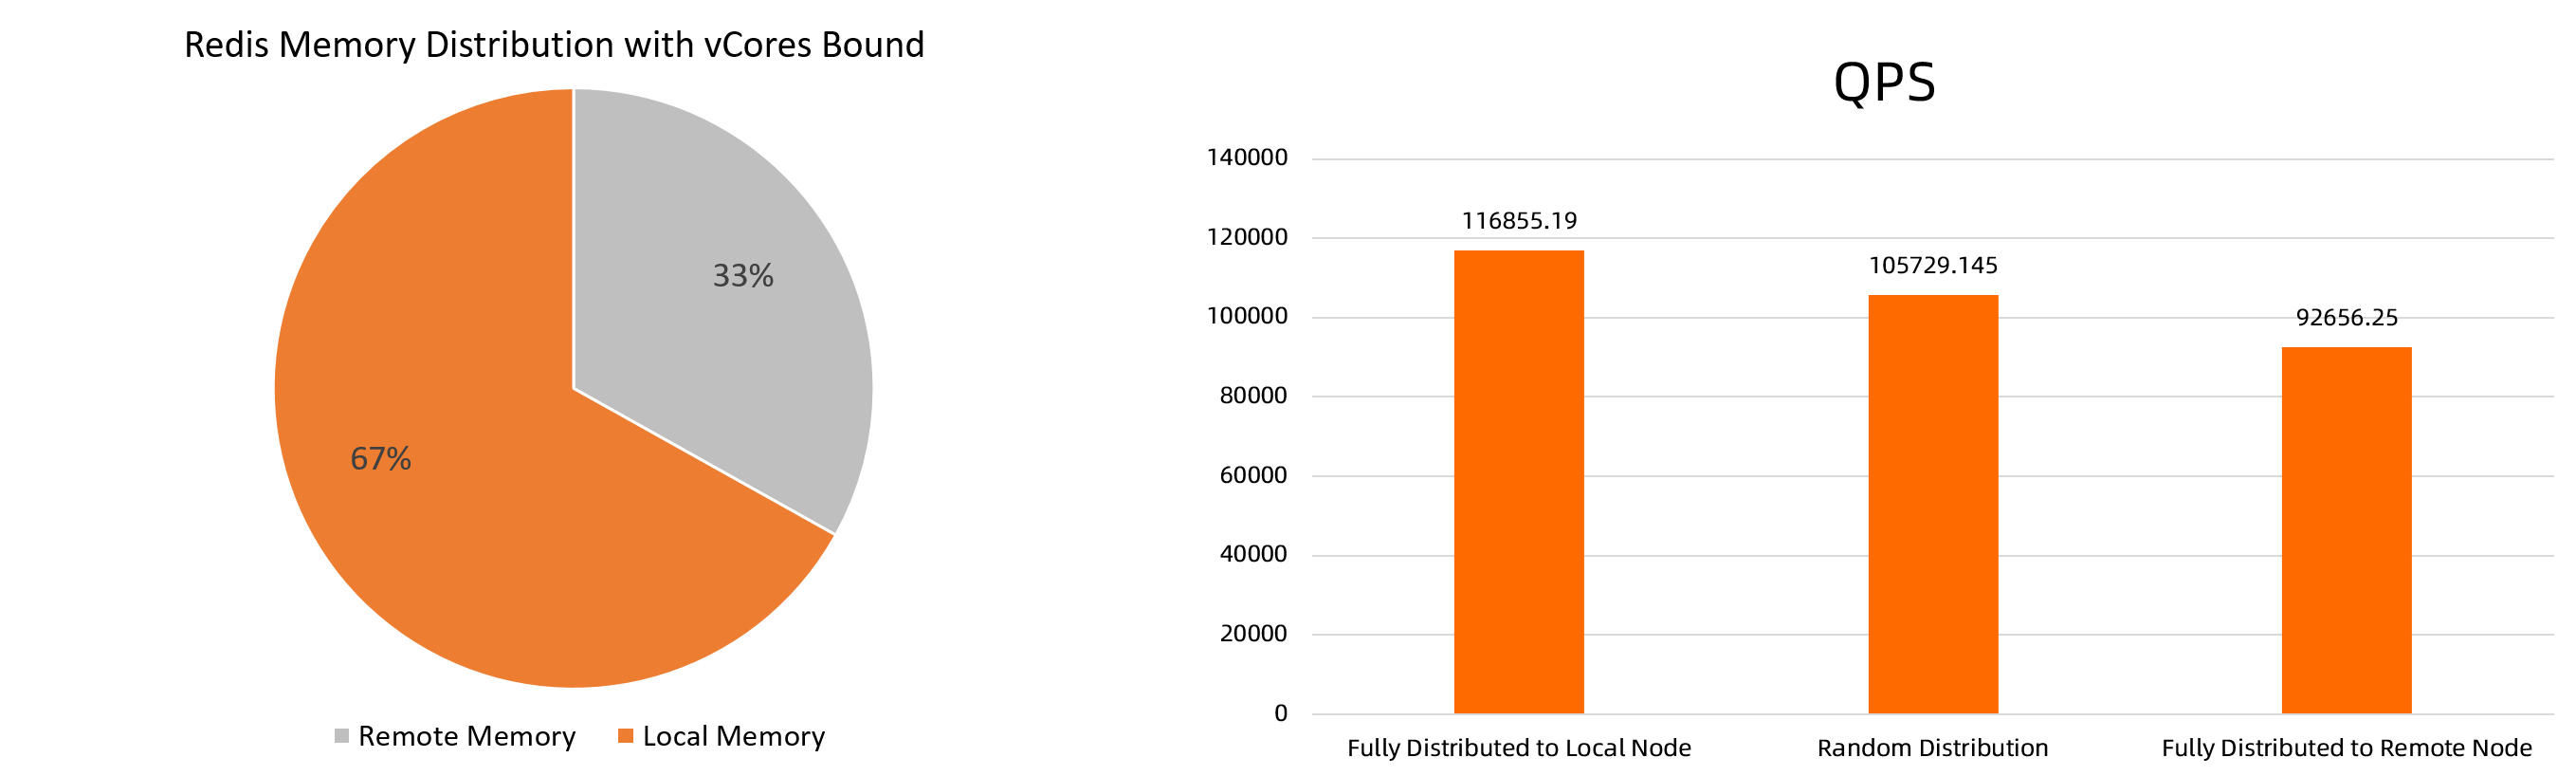
Des tests de référence effectués sur une instance ecs.ebmc8i.48xlarge exécutant Redis montrent qu'une mémoire entièrement locale offre un débit QPS supérieur de 10,52 % par rapport à une mémoire distribuée aléatoirement et un débit QPS supérieur de 26,12 % par rapport à une mémoire entièrement distante.
Les chiffres de référence sont théoriques. Les résultats réels varient selon l'environnement.
Cas d'utilisation
La fonction d'accélération de l'accès mémoire local convient aux scénarios suivants :
Charges de travail intensives en mémoire — bases de données en mémoire Redis à grande échelle et charges de travail similaires où la latence d'accès à la mémoire affecte directement le débit.
Instances ECS compatibles DSA — les instances ECS intégrées à Intel Data Streaming Accelerator (DSA) peuvent améliorer les performances de la fonction et réduire la consommation CPU.
Limites
La fonction est ignorée lorsque l'instance utilise une architecture non-NUMA ou lorsque le processus s'exécute sur tous les nœuds NUMA. Dans les deux cas, il n'y a pas de nœud NUMA distant à partir duquel migrer.
Si un processus se termine pendant la migration, la migration de ce processus échoue. ack-koordinator enregistre l'ID du processus ayant échoué dans l'événement du pod et continue de migrer les autres processus.
Lors de l'utilisation de l'accélération périodique (
migrateIntervalMinutes > 0), un événement est enregistré uniquement lorsque la variation du ratio de mémoire locale ou le résultat de l'accélération dépasse 10 %.
Activer l'accélération de l'accès mémoire local
Étape 1 : Activer la fonction
Deux méthodes sont disponibles. Utilisez la méthode d'annotation pour cibler des pods individuels, ou utilisez la méthode ConfigMap pour appliquer le paramètre à tous les pods d'une classe de qualité de service (QoS) donnée.
Activer pour un pod individuel
Exécutez la commande suivante pour activer l'accélération de l'accès mémoire local pour un pod :
kubectl annotate pod <pod-name> koordinator.sh/memoryLocality='{"policy": "bestEffort"}' --overwriteLe paramètre policy accepte les valeurs suivantes :
| Valeur | Comportement |
|---|---|
bestEffort |
Déclenche une migration immédiate des pages mémoire des nœuds NUMA distants vers le nœud NUMA local |
none |
Désactive l'accélération de l'accès mémoire local |
Activer pour tous les pods d'une classe QoS
-
Créez un fichier nommé
ml-config.yamlavec le contenu suivant :apiVersion: v1 data: resource-qos-config: |- { "clusterStrategy": { "lsClass": { "memoryLocality": { "policy": "bestEffort" } } } } kind: ConfigMap metadata: name: ack-slo-config namespace: kube-system -
Vérifiez si la ConfigMap
ack-slo-configexiste déjà dans le namespace kube-system :kubectl get cm ack-slo-config -n kube-system-
Si la ConfigMap n'existe pas, créez-la :
kubectl apply -f ml-config.yaml -
Si la ConfigMap existe déjà, appliquez un patch pour éviter d'écraser les paramètres QoS existants :
kubectl patch cm -n kube-system ack-slo-config --patch "$(cat ml-config.yaml)"
-
Étape 2 : Vérifier la fonction
Exécutez la commande suivante pour vérifier les événements du pod :
kubectl describe pod <pod-name>Le tableau suivant décrit les types d'événements attendus et leur signification :
| Type d'événement | Exemple de message | Signification |
|---|---|---|
MemoryLocalityCompleted |
Container <name> completed: migrated memory from remote numa: 1 to local numa: 0 ... Total: 2 container(s) completed, 0 failed, 0 skipped; cur local memory ratio 100, rest remote memory pages 0 |
La migration a réussi. L'événement enregistre la direction de la migration pour chaque conteneur et le ratio de mémoire locale résultant. |
MemoryLocalityCompleted (avec échecs) |
failed to migrate the following processes: failed pid: 111111, error: No such process, from remote numa: 0 to local numa: 1 |
Un ou plusieurs processus se sont terminés pendant la migration. L'événement enregistre le PID de chaque processus ayant échoué. Les autres conteneurs ont été migrés avec succès. |
MemoryLocalitySkipped |
no target numa |
Aucun nœud NUMA distant n'a été trouvé. Cela se produit sur les instances non-NUMA ou lorsque le processus s'exécute sur tous les nœuds NUMA. Aucune action n'est requise. |
MemoryLocalityFailed |
Le message d'erreur varie | Une erreur inattendue s'est produite. Consultez le message d'erreur pour plus de détails. |
Étape 3 (Facultative) : Configurer l'accélération périodique
Par défaut, l'annotation déclenche une seule migration. Pour exécuter des migrations de manière répétée selon une planification, ajoutez le paramètre migrateIntervalMinutes.
Avant de définir un intervalle récurrent, assurez-vous que la migration la plus récente est terminée. Un événement est enregistré uniquement lorsque le ratio de mémoire locale ou le résultat de l'accélération change de plus de 10 %.
kubectl annotate pod <pod-name> koordinator.sh/memoryLocality='{"policy": "bestEffort","migrateIntervalMinutes":10}' --overwriteLe paramètre migrateIntervalMinutes spécifie l'intervalle minimum entre les migrations, en minutes :
| Valeur | Comportement |
|---|---|
0 |
Déclenche une seule migration immédiate (identique à l'omission du paramètre) |
> 0 |
Déclenche une migration immédiate, puis répète l'opération à l'intervalle spécifié |
none |
Désactive la fonction d'accélération de l'accès mémoire local |
Test de référence : impact sur les performances de Redis
Cette section décrit les résultats des tests de référence pour les types d'instances ecs.ebmc8i.48xlarge et ecs.ebmg7a.64xlarge.
Les résultats dépendent de l'outil de test de charge et de l'environnement. Les résultats suivants sont spécifiques à ces deux types d'instances.
Environnement de test
Machines testées : instances ecs.ebmc8i.48xlarge et ecs.ebmg7a.64xlarge exécutant une application Redis
Application Redis : multithread, 4 vCores, 32 Go de mémoire (image :
redis:6.0.5)-
Machine de test de charge : une machine distincte qui envoie des requêtes à la machine testée
RemarquePour les machines de test aux spécifications inférieures, déployez une instance Redis monothread et réduisez les demandes de CPU et de mémoire en conséquence.
Procédure de test

-
Déployez une application Redis à l'aide du YAML suivant. Ajustez
redis-configpour correspondre aux spécifications de votre machine de test.--- kind: ConfigMap apiVersion: v1 metadata: name: example-redis-config data: redis-config: | maxmemory 32G maxmemory-policy allkeys-lru io-threads-do-reads yes io-threads 4 --- kind: Service apiVersion: v1 metadata: name: redis spec: type: NodePort ports: - port: 6379 targetPort: 6379 nodePort: 32379 selector: app: redis --- apiVersion: v1 kind: Pod metadata: name: redis annotations: cpuset-scheduler: "true" # Bind vCores using topology-aware CPU scheduling labels: app: redis spec: containers: - name: redis image: redis:6.0.5 command: ["bash", "-c", "redis-server /redis-master/redis.conf"] ports: - containerPort: 6379 resources: limits: cpu: "4" # Adjust based on test machine specifications volumeMounts: - mountPath: /redis-master-data name: data - mountPath: /redis-master name: config volumes: - name: data emptyDir: {} - name: config configMap: name: example-redis-config items: - key: redis-config path: redis.conf -
Augmentez les charges mémoire pour simuler la dérive mémoire vers les NUMA distants.
-
Écrivez des données métier dans Redis à l'aide du script shell suivant. Le script écrit les données par lots via des pipelines. Remplacez
<max-out-cir>et<max-in-cir>par les valeurs appropriées pour votre configuration. Pour une instance Redis de 4 vCores et 32 Go, utilisezmax-out-cir=300etmax-in-cir=1000000.RemarqueL'écriture de grands volumes de données prend du temps. Exécutez le script sur la machine testée pour maximiser la vitesse d'écriture.
for((j=1;j<=<max-out-cir>;j++))
do
        echo "set k$j-0 v$j-0" > data.txt
        for((i=1;i<=<max-in-cir>;i++))
        do
                echo "set k$j-$i v$j-$i" >> data.txt
        done
        echo "$j"
        unix2dos data.txt  # Pipeline writes require DOS format
        cat data.txt | redis-cli --pipe -h <redis-server-IP> -p <redis-server-port>
done
Pendant l'écriture des données, augmentez les charges mémoire des charges de travail colocalisées sur le même nœud NUMA pour simuler la dérive mémoire. Utilisez
numactl --membindpour lier les charges de travail à un nœud NUMA spécifique. -
Exécutez la commande suivante pour augmenter la pression mémoire. Remplacez
<workers-num>par le nombre de processus de stress et<malloc-size-per-workers>par la mémoire allouée par processus.RemarqueÉtant donné que les vCores sont liés au pod Redis, la mémoire NUMA locale lui est attribuée en priorité jusqu'à ce que la mémoire locale soit épuisée et que le débordement se produise vers les nœuds NUMA distants. Exécutez
numactl -Hpour vérifier l'utilisation de la mémoire par nœud NUMA et définissez les paramètres en conséquence.numactl --membind=<numa-id> stress -m <workers-num> --vm-bytes <malloc-size-per-workers>
-
-
Exécutez des tests de charge avec l'accélération désactivée puis activée.
-
Test de charge avec accélération désactivée
Envoyez des requêtes depuis la machine de test de charge pour générer des charges moyennes et élevées sur redis-server.
-
500 requêtes concurrentes (charge moyenne) :
redis-benchmark -t GET -c 500 -d 4096 -n 2000000 -h <redis-server-IP> -p <redis-server-port> -
10 000 requêtes concurrentes (charge élevée) :
redis-benchmark -t GET -c 10000 -d 4096 -n 2000000 -h <redis-server-IP> -p <redis-server-port>
-
-
Activer l'accélération de l'accès mémoire local
Exécutez la commande suivante pour activer l'accélération pour le pod Redis :
kubectl annotate pod redis koordinator.sh/memoryLocality='{"policy": "BestEffort"}' --overwriteVérifiez que la migration est terminée :
kubectl describe pod redisSortie attendue (le transfert de grands volumes de mémoire distante peut prendre du temps) :
Normal MemoryLocalitySuccess 0s koordlet-resmanager migrated memory from remote numa: 0 to local numa: 1, cur local memory ratio 98, rest remote memory pages 28586 -
Test de charge avec accélération activée
Répétez les tests de charge de l'étape a pour générer des charges moyennes et élevées.
-
Résultats pour ecs.ebmc8i.48xlarge
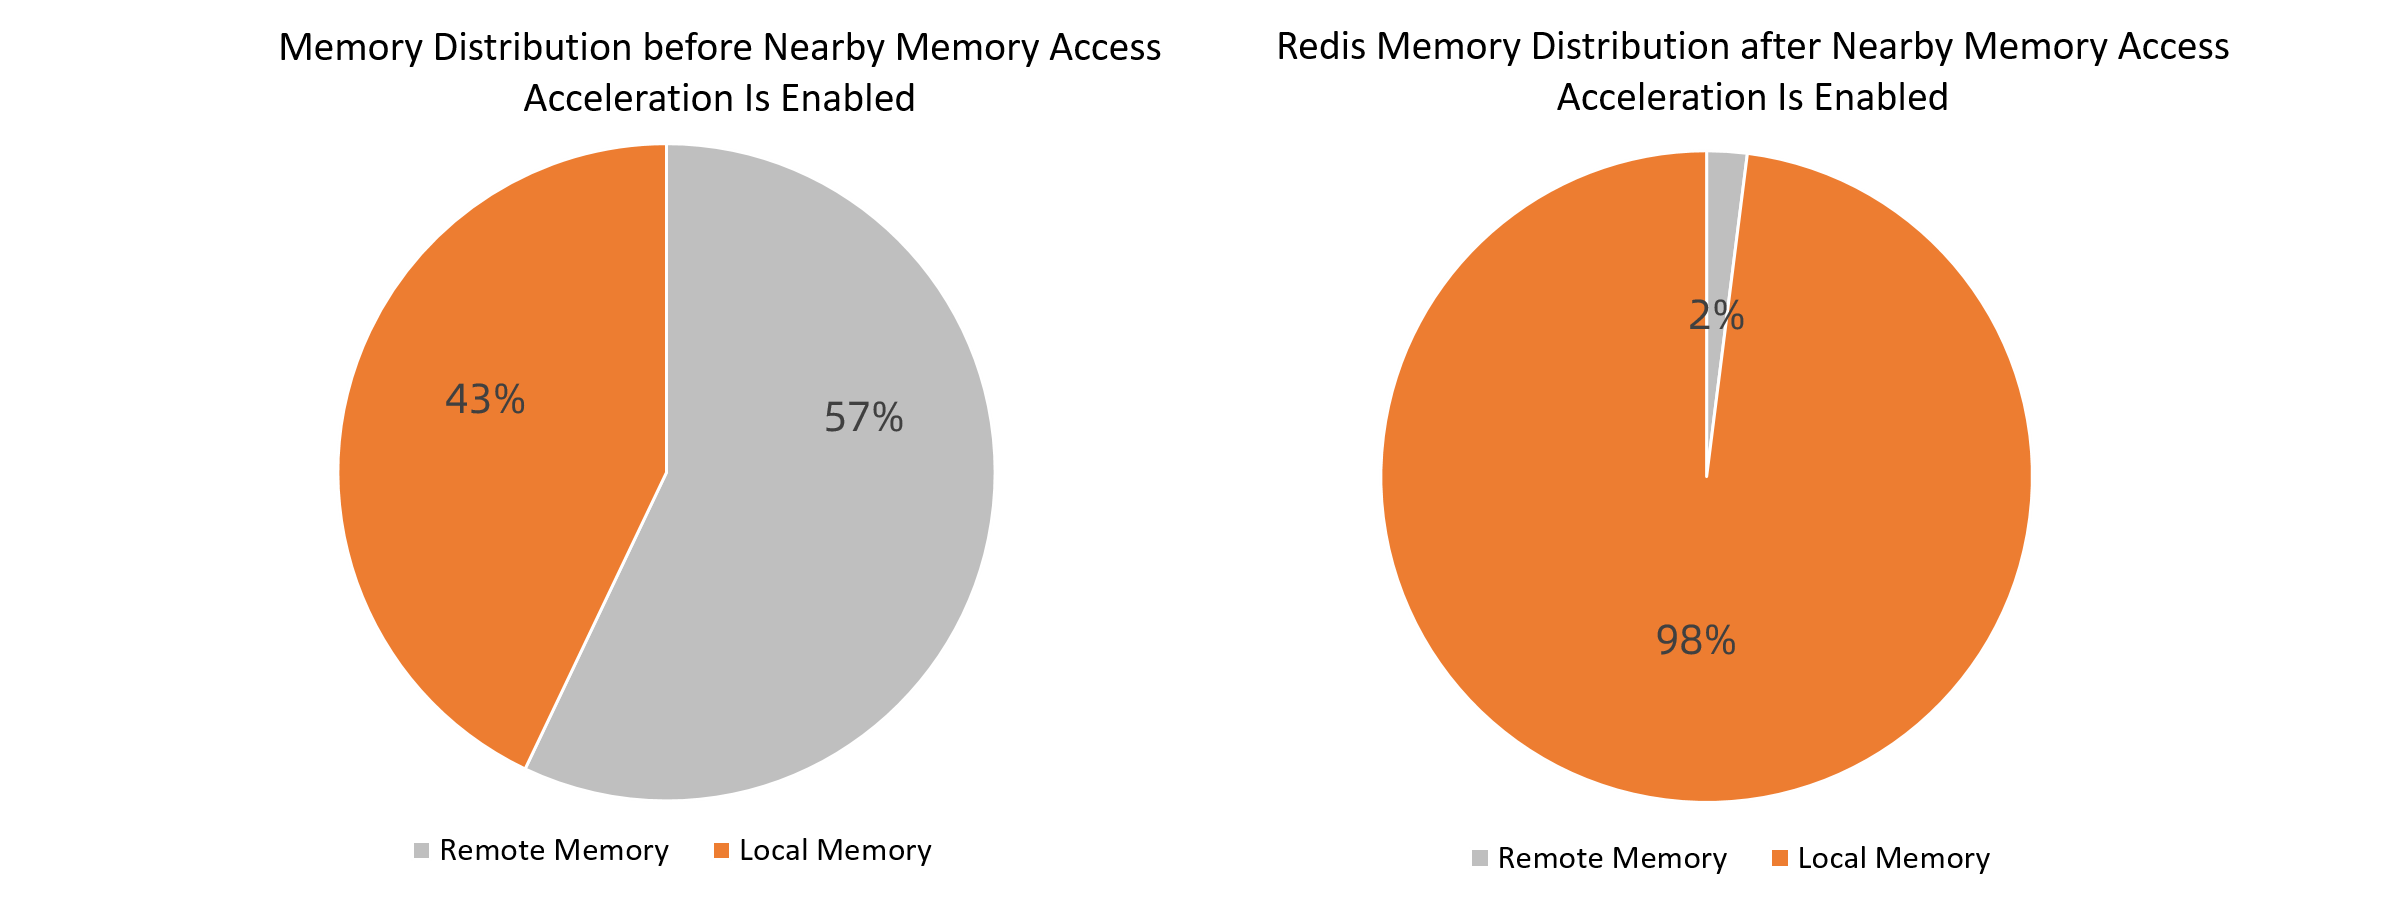
Distribution de la mémoire : 43 % locale avant l'accélération, 98 % locale après l'accélération.
-
500 requêtes concurrentes
|
**Scénario**
|
**P99 ms**
|
**P99,99 ms**
|
**QPS**
| | --- | --- | --- | --- | |
Avant l'accélération
|
3
|
9,6
|
122 139,91
| |
Après l'accélération
|
3
|
8,2
|
129 367,11
|La latence P99 reste inchangée. La latence P99,99 est réduite de 14,58 %. Le débit QPS augmente de 5,917 %.
-
10 000 requêtes concurrentes
|
**Scénario**
|
**P99 ms**
|
**P99,99 ms**
|
**QPS**
| | --- | --- | --- | --- | |
Avant l'accélération
|
115
|
152,6
|
119 895,56
| |
Après l'accélération
|
101
|
145,2
|
125 401,44
|La latence P99 est réduite de 12,17 %. La latence P99,99 est réduite de 4,85 %. Le débit QPS augmente de 4,59 %.
Résultats pour ecs.ebmg7a.64xlarge
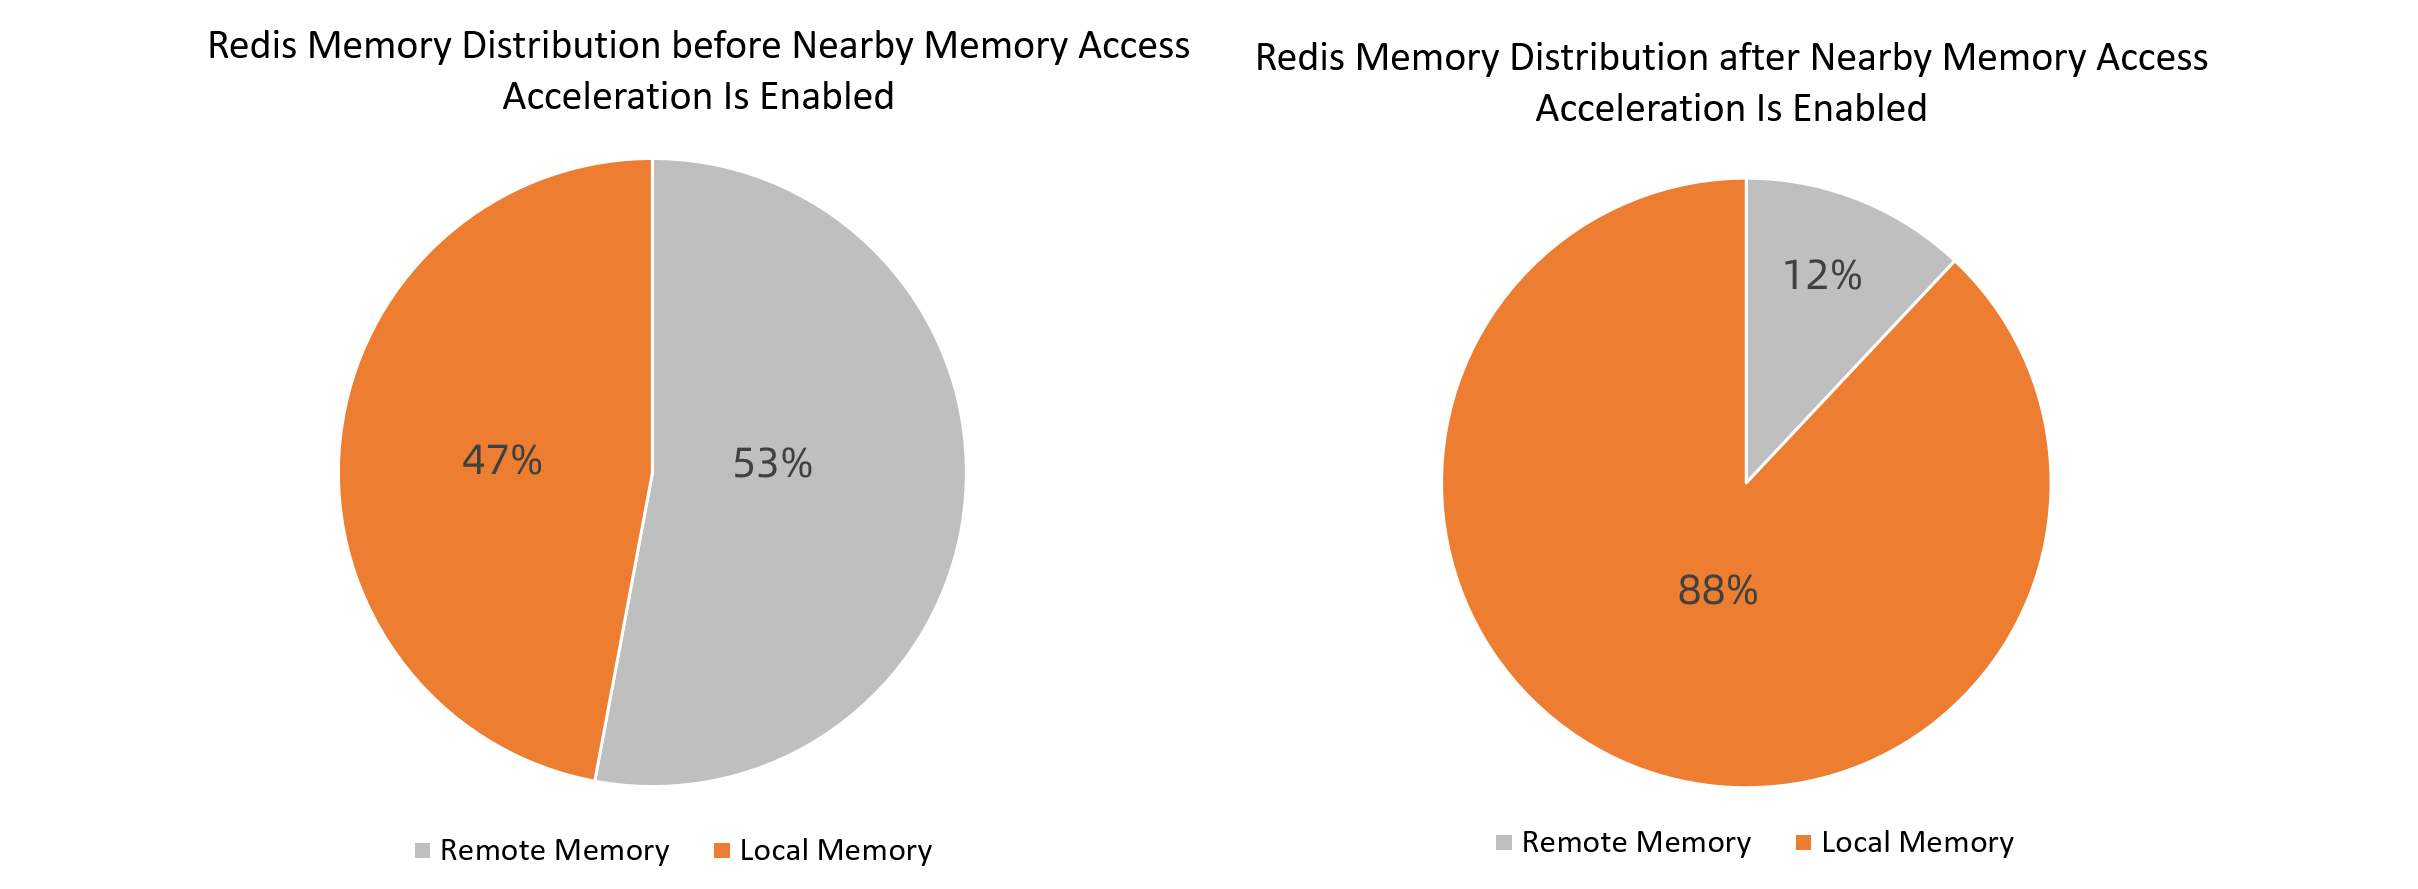
Distribution de la mémoire : 47 % locale avant l'accélération, 88 % locale après l'accélération.
-
500 requêtes concurrentes
|
**Scénario**
|
**P99 ms**
|
**P99,99 ms**
|
**QPS**
| | --- | --- | --- | --- | |
Avant l'accélération
|
2,4
|
4,4
|
135 180,99
| |
Après l'accélération
|
2,2
|
4,4
|
136 296,37
|La latence P99 est réduite de 8,33 %. La latence P99,99 reste inchangée. Le débit QPS augmente de 0,83 %.
-
10 000 requêtes concurrentes
|
**Scénario**
|
**P99 ms**
|
**P99,99 ms**
|
**QPS**
| | --- | --- | --- | --- | |
Avant l'accélération
|
58,2
|
80,4
|
95 757,10
| |
Après l'accélération
|
56,6
|
76,8
|
97 015,50
|La latence P99 est réduite de 2,7 %. La latence P99,99 est réduite de 4,4 %. Le débit QPS augmente de 1,3 %.
Conclusion : Sous de fortes charges mémoire où les données de l'application ont dérivé vers des nœuds NUMA distants, la liaison des vCores et l'activation de l'accélération de l'accès mémoire local réduisent la latence d'accès et augmentent le débit de Redis, tant pour une concurrence moyenne que élevée.