Les volumes persistants (PV) OSS prennent en charge plusieurs clients, mais une prise en charge complète de l'écriture dégrade les performances en lecture. La séparation lecture/écriture résout ce problème en acheminant les lectures et les écritures via des chemins de montage distincts, améliorant ainsi le débit pour les charges de travail intensives en lecture, telles que l'entraînement de modèles, l'inférence et l'analyse de données.
Mettez en œuvre la séparation lecture/écriture pour les PV OSS avec ossfs ou le SDK OSS, comme illustré par une tâche d'entraînement de reconnaissance d'écriture manuscrite MNIST.
Prérequis
Assurez-vous d'avoir :
Le dernier composant CSI (Container Storage Interface) est installé. Différents clients nécessitent différentes versions de CSI. Consultez Gérer les composants csi-plugin et csi-provisioner.
Un bucket OSS dans le même compte Alibaba Cloud que le cluster.
L'accès OSS inter-comptes n'est pas recommandé.
Choisir un client
Les PV OSS prennent en charge trois clients — ossfs 1,0, ossfs 2,0 et strmvol. Chaque client prend en charge l'accès en lecture seule ; les capacités d'écriture diffèrent :
|
Client |
Lecture seule |
Lecture/écriture |
Idéal pour |
|
ossfs 1,0 |
Oui |
Écriture complète |
Charges de travail générales en lecture/écriture ; mode de lecture directe disponible (v1.91+) |
|
ossfs 2,0 |
Oui |
Écritures séquentielles en ajout uniquement |
Charges de travail à forte dominance de lecture ; nécessite CSI >= 1.33.1 |
|
strmvol |
Oui |
— |
Nombreux petits fichiers (ensembles de données, journaux de séries temporelles, backtesting quantitatif) |
Consultez référence de sélection du client.
Cas d'utilisation
Accès en lecture seule
Définissez le mode d'accès du PV sur ReadOnlyMany pour empêcher toute modification accidentelle des données. Cette configuration convient à l'inférence, à l'analyse de données et aux requêtes de journaux.
Pour les charges de travail à forte dominance de lecture, utilisez ossfs 2.0 (CSI >= 1.33.1). Consultez Utiliser les PV ossfs 2,0.
Pour les nombreux petits fichiers, utilisez strmvol. Consultez Utiliser les PV strmvol.
Configurez ces paramètres otherOpts pour optimiser ossfs 1.0 dans les scénarios en lecture seule. La plupart des charges de travail peuvent utiliser les valeurs par défaut.
|
Paramètre |
Valeur par défaut |
Description |
|
|
Désactivé |
Active le cache tampon du noyau pour les lectures non temps réel. Utilise la mémoire libre pour la mise en cache. |
|
|
20 |
Shards concurrents pour les téléchargements et téléversements de grands fichiers. |
|
|
20 |
Nombre maximal de requêtes de liste de métadonnées concurrentes. Doit être >= |
|
|
1000 |
Nombre d'entrées de métadonnées mises en cache. Définissez sur |
|
|
Désactivé |
Mode de lecture directe pour les scénarios en lecture seule (ossfs >= 1.91). Consultez Fonctionnalités et tests de performance de la nouvelle version ossfs 1.0 et Optimisation des performances pour les scénarios en lecture seule. |
Accès en lecture/écriture
Définissez le mode d'accès du PV sur ReadWriteMany pour les charges de travail qui écrivent des données.
ossfs ne garantit pas la cohérence pour les écritures simultanées — plusieurs rédacteurs sur les mêmes objets peuvent entraîner une corruption des données. Utilisez un seul rédacteur par chemin pour les écritures de points de contrôle.
La suppression ou la modification de fichiers dans le chemin monté supprime ou modifie également les objets dans le bucket OSS. Activez versioning pour protéger contre la perte de données.
Pour les charges de travail intensives en lecture avec des chemins de lecture et d'écriture séparés (comme l'entraînement de modèles), montez le chemin de lecture en tant que ReadOnlyMany avec la mise en cache activée, et gérez les écritures via un PV ReadWriteMany ou le SDK OSS.
Fonctionnement de la séparation lecture/écriture
La séparation lecture/écriture achemine les lectures et les écritures via des points de montage distincts, chacun pointant vers un sous-chemin différent du même bucket OSS. Cela isole les E/S de lecture des E/S d'écriture.
Chemin de lecture — Montez un sous-chemin (par exemple,
/tf-train/train/data) en tant queReadOnlyManyavec la mise en cache activée. Les lectures répétées sont servies depuis la mémoire.Chemin d'écriture — Montez un autre sous-chemin (par exemple,
/tf-train/training_logs) en tant queReadWriteMany, ou écrivez directement via le SDK.
Exemple : Entraînement de reconnaissance d'écriture manuscrite MNIST
La tâche d'entraînement :
Lit l'ensemble de données d'entraînement depuis
/tf-train/train/datadans le bucket OSS à l'aide d'un PV en lecture seule.Écrit les points de contrôle d'entraînement dans
/tf-train/training_logsen utilisant soit un PV en lecture/écriture, soit le SDK OSS.
Téléchargez l'ensemble de données MNIST et téléversez-le dans /tf-train/train/data de votre bucket OSS :
Organisation des fichiers dans le bucket OSS :

Implémenter les opérations de lecture/écriture à l'aide d'ossfs
Étant donné que les écritures de points de contrôle sont des ajouts séquentiels, ossfs 1,0 et ossfs 2,0 fonctionnent tous deux pour le chemin d'écriture.
-
Déployez l'application d'entraînement. L'application monte le sous-chemin
/tf-traindu bucket OSS dans le répertoire/mntdu pod. Consultez Utiliser les volumes provisionnés statiquement ossfs 1.0 ou Utiliser les PV ossfs 2.0.-
Créez un PV ossfs 1,0 :
cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv EOF -
Créez le pod d'entraînement :
Pendant l'entraînement, ossfs téléverse les fichiers depuis
/mnt/training_logs(pod) vers/tf-train/training_logs(bucket OSS).cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
-
-
Vérifiez les lectures et écritures de données.
-
Vérifiez l'état du pod :
kubectl get pod tf-mnistAttendez que l'état passe de
RunningàCompleted:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m12s -
Vérifiez le temps de chargement des données :
kubectl logs tf-mnist | grep dataloadSortie attendue :
dataload cost time: 1.54191803932 Connectez-vous à la Console de gestion OSS et vérifiez que les fichiers existent sous
/tf-train/training_logsdans le bucket.
-
Optimiser les performances de lecture à l'aide de la séparation lecture/écriture
Divisez le PV unique en lecture/écriture en deux : un PV en lecture seule avec réglage du cache pour l'ensemble de données, et un PV d'écriture pour les points de contrôle. Seule la configuration de montage change — le code d'entraînement reste identique.
Deux options d'écriture :
Option 1 : Utilisez un PV ossfs en lecture/écriture distinct pour les écritures de points de contrôle.
Option 2 : Utilisez le SDK OSS pour écrire les points de contrôle directement, en contournant complètement ossfs.
Option 1 : Écrire à l'aide d'un PV ossfs en lecture/écriture
-
Créez un PV ossfs 1,0 en lecture seule pour l'ensemble de données. Les modifications clés de configuration :
Définissez
accessModessurReadOnlyManysur le PV et le PVC. Montez le sous-chemin de l'ensemble de données/tf-train/train/data.-
Dans
otherOpts, ajoutez-o kernel_cache -o max_stat_cache_size=10000 -o umask=022:kernel_cacheactive la mise en cache des lectures en mémoire.max_stat_cache_size=10000met en cache 10 000 entrées de métadonnées (~40 Mo). Ajustez en fonction du type d'instance et de la taille de l'ensemble de données.umask=022accorde l'accès en lecture aux processus de conteneur non root.
cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv EOF -
Créez un PV ossfs 1,0 en lecture/écriture pour les points de contrôle, en montant le sous-chemin
/tf-train/training_logs. La mise en cache des métadonnées est désactivée (max_stat_cache_size=0) car les écritures séquentielles de points de contrôle ne bénéficient pas de la mise en cache.cat << EOF | kubectl apply -f - apiVersion: v1 kind: PersistentVolume metadata: name: tf-logging-pv labels: alicloud-pvname: tf-logging-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-logging-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train/training_logs" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-logging-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-logging-pv EOF -
Déployez le pod d'entraînement avec les deux PV montés.
Aucune modification de code n'est nécessaire. Montez les deux PV — le PV en lecture seule sur
/mnt/train/dataet le PV en lecture/écriture sur/mnt/training_logs.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" - name: logging mountPath: "/mnt/training_logs" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc - name: logging persistentVolumeClaim: claimName: tf-logging-pvc EOF
Option 2 : Écrire à l'aide du SDK OSS
Écrivez les points de contrôle directement dans OSS avec le SDK — aucun PV en lecture/écriture n'est nécessaire. Le pod lit à partir d'un PV en lecture seule et écrit via le SDK.
-
Ajoutez le SDK Python OSS à l'image du conteneur :
RUN pip install oss2Consultez Installation.
-
Modifiez le code d'entraînement pour téléverser les points de contrôle à l'aide du SDK. Le code original enregistre les points de contrôle dans
log_dirtoutes les 100 itérations en utilisanttf.train.Saveravecmax_to_keep=0, produisant 10 ensembles de points de contrôle après 1 000 itérations.Définissez
max_to_keep=1pour ne conserver que le dernier point de contrôle, réduisant ainsi l'utilisation de la mémoire.Téléversez chaque point de contrôle dans OSS avec
put_object_from_fileaprès l'enregistrement.
Utilisez les E/S asynchrones avec le SDK pour améliorer davantage le débit lorsque les chemins de lecture et d'écriture sont séparés.
def train():
    ...
saver = tf.train.Saver(max_to_keep=0)

    for i in range(FLAGS.max_steps):
        if i % 10 == 0:  # Record summaries and test-set accuracy
            summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
            print('Accuracy at step %s: %s' % (i, acc))
            if i % 100 == 0:
                print('Save checkpoint at step %s: %s' % (i, acc))
                saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
Remplacez par des téléversements basés sur le SDK. Deux modifications réduisent l'utilisation de la mémoire et éliminent le PV en lecture/écriture : lisez la AccessKey et les paramètres du bucket à partir des variables d'environnement. Consultez Configurer les informations d'identification d'accès.
import oss2
from oss2.credentials import EnvironmentVariableCredentialsProvider

auth = oss2.ProviderAuth(EnvironmentVariableCredentialsProvider())
url = os.getenv('URL','<default-url>')
bucketname = os.getenv('BUCKET','<default-bucket-name>')
bucket = oss2.Bucket(auth, url, bucketname)

...
def train():
  ...
  saver = tf.train.Saver(max_to_keep=1)

 for i in range(FLAGS.max_steps):
    if i % 10 == 0:  # Record summaries and test-set accuracy
      summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
      print('Accuracy at step %s: %s' % (i, acc))
      if i % 100 == 0:
        print('Save checkpoint at step %s: %s' % (i, acc))
        saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
        # FLAGS.log_dir = os.path.join(os.getenv('TEST_TMPDIR', '/mnt'),'training_logs')
        for path,_,file_list in os.walk(FLAGS.log_dir) :
          for file_name in file_list:
            bucket.put_object_from_file(os.path.join('tf-train/training_logs', file_name), os.path.join(path, file_name))
L'image de conteneur modifiée est
registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro. -
Déployez le pod avec le PV en lecture seule et les informations d'identification du SDK. Le pod définit
accessModessurReadOnlyManyet transmetOSS_ACCESS_KEY_IDetOSS_ACCESS_KEY_SECRETafin que le SDK s'authentifie avec les mêmes informations d'identification que le PV.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv --- apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" - name: OSS_ACCESS_KEY_ID #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akId - name: OSS_ACCESS_KEY_SECRET #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akSecret - name: URL #You can ignore this if a default URL is configured. value: "https://oss-<region>.aliyuncs.com" - name: BUCKET #You can ignore this if a default BUCKET is configured. value: "<bucket-name>" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
Vérifier la séparation lecture/écriture
Après le déploiement avec l'une ou l'autre option d'écriture :
-
Vérifiez l'état du pod :
kubectl get pod tf-mnistAttendez que l'état passe à
Completed:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m25s -
Vérifiez le temps de chargement des données :
kubectl logs tf-mnist | grep dataloadAvec la séparation lecture/écriture et le cache du noyau activé, le temps de chargement des données diminue :
dataload cost time: 0.843528985977La référence sans séparation est d'environ 1,54 seconde. Les tâches d'entraînement plus importantes et les chargements de données répétés montrent une amélioration plus importante.
-
Connectez-vous à la Console de gestion OSS et vérifiez que les fichiers de points de contrôle sont présents sous
/tf-train/training_logsdans le bucket.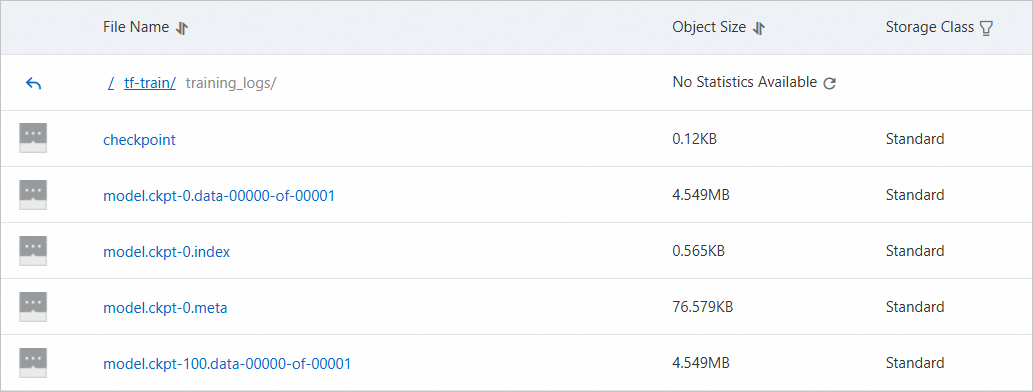
Références
Référence du SDK OSS
Cette rubrique utilise le SDK Python. Autres SDK disponibles :
Pour les autres SDK (PHP, Node.js, Browser.js, .NET, Android, iOS, Ruby), consultez la Référence SDK.
Autres outils d'écriture
Ces outils prennent également en charge l'écriture dans OSS :
|
Outil |
Référence |
|
OpenAPI |
|
|
Interface de ligne de commande ossutil |
|
|
Outil de gestion graphique ossbrowser |