Un índice de búsqueda utiliza índices invertidos y almacenes de columnas para admitir consultas multidimensionales y análisis estadísticos sobre big data. Utilice índices de búsqueda para consultas en columnas que no son clave principal, consultas booleanas, consultas difusas, búsqueda de texto completo, búsqueda vectorial y agregaciones como max, min, count y group by.
Contexto
Los índices de búsqueda solo se aplican a wide table models .
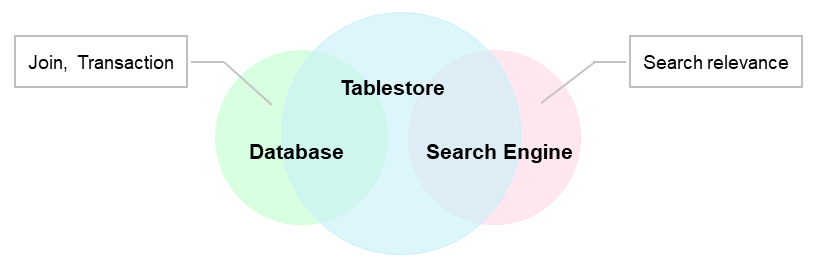
Los índices de búsqueda, las bases de datos y los motores de búsqueda resuelven problemas complejos de consulta en big data, pero difieren en los siguientes aspectos:
A excepción de las uniones (joins), las transacciones y el análisis de relevancia, Tablestore ofrece las funciones tanto de bases de datos como de sistemas de búsqueda. Combina la alta confiabilidad de datos de una base de datos con las capacidades avanzadas de consulta de un sistema de búsqueda, lo que reemplaza la arquitectura común database + search engine.
Si su escenario no implica uniones, transacciones ni análisis complejos de relevancia, utilice un índice de búsqueda de Tablestore.
Descripción general del índice
Un índice de búsqueda utiliza índices invertidos y almacenes de columnas para resolver problemas de consulta multidimensional y análisis estadístico en big data. Admite consultas en columnas que no son clave principal, consultas por prefijo, consultas difusas, consultas booleanas, consultas anidadas, consultas geográficas, búsqueda de texto completo, búsqueda vectorial y agregación estadística (max, min, count, sum, avg, distinct_count, group_by, percentiles e histogram).
La siguiente figura muestra las estructuras de índice invertido, almacén de columnas e índice espacial multidimensional que utiliza un índice de búsqueda.
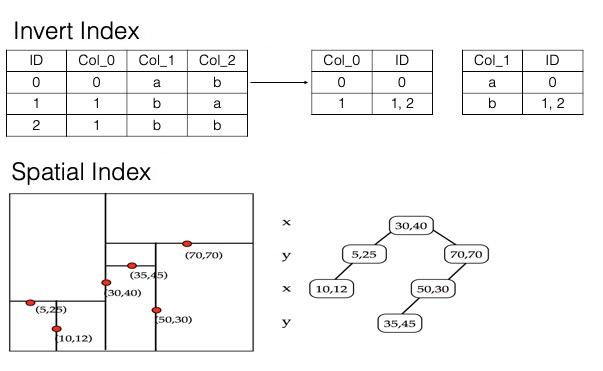
A diferencia de los índices de bases de datos tradicionales (como MySQL), un índice de búsqueda no está limitado por la regla de coincidencia de prefijo más a la izquierda. En la mayoría de los casos, solo necesita un índice de búsqueda por tabla. Por ejemplo, una tabla de estudiantes con columnas como nombre, matrícula, género, grado, clase y domicilio requiere únicamente un índice de búsqueda para admitir consultas combinadas como students named John Doe in the third grade, male students whose home address is within 1 km o students in Class 2 of Grade 3 who live in a specific residential area.
Comparación de índices
Tablestore admite consultas por clave principal en tablas de datos, además de dos tipos de índices para acelerar las consultas: índice secundario e índice de búsqueda. La siguiente tabla compara estos tres métodos de consulta.
|
Método de consulta |
Principio |
Escenario |
|
Clave principal |
Una tabla de datos funciona como un mapa grande. Solo puede consultar datos mediante la clave principal. |
Adecuado para escenarios donde conoce la clave principal completa o un prefijo de clave. |
|
Índice secundario |
Crea tablas de índice cuyas columnas de clave principal amplían la capacidad de consulta de la tabla de datos a diferentes columnas. |
Adecuado para escenarios donde las columnas de consulta están predeterminadas, el número de columnas es pequeño y usted conoce la clave principal completa o un prefijo de clave. |
|
Índice de búsqueda |
Utiliza estructuras como índices invertidos, árboles BKD y almacenes de columnas para ofrecer capacidades de consulta avanzadas. |
Adecuado para todos los escenarios de consulta y análisis fuera del alcance de la clave principal y el índice secundario: consultas en columnas que no son clave principal, consultas booleanas en cualquier columna, consultas de relaciones, búsqueda de texto completo, consultas geográficas, consultas difusas, consultas anidadas, consultas de valores NULL y agregación estadística. |
Escenarios
Los índices de búsqueda se utilizan ampliamente para la consulta y el análisis de datos en diversos sistemas de aplicaciones. La siguiente tabla enumera los escenarios comunes.
|
Sistema de aplicación |
Ejemplo de escenario |
|
Plataforma de comercio electrónico |
Implemente categorización de productos y filtrado de atributos para ayudar a los usuarios a buscar y filtrar productos rápidamente. |
|
Aplicación social |
Consulte relaciones de seguimiento y amistad entre usuarios, o recomiende y empareje usuarios según etiquetas de intereses. |
|
Análisis de registros |
Realice búsquedas por palabras clave y consultas por rango de tiempo para localizar problemas rápidamente y analizar datos de registros. |
|
Análisis de datos del Internet de las cosas |
Consulte y analice datos de dispositivos. Por ejemplo, filtre y cuente datos por tipo de dispositivo o ubicación geográfica. |
|
Monitoreo del rendimiento de aplicaciones |
Agregue y consulte datos de métricas. Por ejemplo, filtre y resuma datos por rango de tiempo o nombre de aplicación. |
|
Servicio basado en ubicación |
Realice consultas geográficas y búsquedas cercanas para proporcionar información sobre tiendas, atracciones y servicios próximos. |
|
Motor de búsqueda de texto |
Ejecute búsquedas de texto completo y ordenamiento por relevancia para encontrar documentos, artículos y otro contenido de forma rápida. |
Funciones
Lista de funciones
La siguiente tabla enumera las funciones del índice de búsqueda.
|
Función |
Descripción |
Documento |
|
Consulta en cualquier columna (incluidas columnas de clave principal y columnas que no son clave principal) |
Consulte datos por cualquier columna. Adecuado para la mayoría de los escenarios de consulta. Si las consultas por clave principal o por prefijo no satisfacen sus necesidades, cree un índice de búsqueda con los campos objetivo y consulte por valores de columna. |
Cualquier consulta de índice de búsqueda, como una basic query |
|
Consulta booleana |
Combine varios campos para un filtrado eficiente. Adecuado para sistemas de pedidos, análisis de registros y perfiles de usuarios. En una base de datos relacional, una tabla con decenas de campos puede requerir cientos de índices para cubrir todas las combinaciones de campos. Las combinaciones faltantes provocan consultas ineficientes. Con Tablestore, un solo índice de búsqueda cubre todas las combinaciones de campos. Agregue al índice los campos que podría consultar y luego combínelos libremente mediante lógica And, Or y Not. |
|
|
Consulta geográfica |
Los dispositivos móviles han hecho que los datos de ubicación geográfica sean cada vez más valiosos. Las aplicaciones de redes sociales, entrega de comida, deportes e Internet de vehículos (IoV) requieren consultas basadas en ubicación. Los índices de búsqueda admiten las siguientes funciones de consulta geográfica:
Si su aplicación requiere consultas basadas en ubicación, un índice de búsqueda de Tablestore proporciona una solución integral sin necesidad de bases de datos o sistemas de búsqueda adicionales. |
|
|
Índice de texto completo |
Encuentre datos que contengan una frase específica. Adecuado para análisis de big data, búsqueda de contenido, gestión del conocimiento, análisis de redes sociales, análisis de registros, sistemas de chat con IA, revisiones de cumplimiento y recomendaciones personalizadas. Los índices de búsqueda utilizan tokenización para la búsqueda de texto completo. Ofrecen relevancia básica BM25, pero no relevancia personalizada. Para necesidades complejas de búsqueda por relevancia, utilice un sistema de búsqueda dedicado; de lo contrario, un índice de búsqueda es suficiente. Hay cinco tipos de tokenización disponibles: palabra única, delimitador, semántico mínimo, semántico máximo y difuso. Para resaltar palabras clave en los resultados, utilice la función de resumen y resaltado. |
|
|
Búsqueda vectorial |
Los índices de búsqueda admiten búsqueda vectorial para consultas eficientes de vecinos más cercanos aproximados en conjuntos de datos a gran escala. Adecuado para generación aumentada por recuperación (RAG), sistemas de recomendación, detección de similitudes (imágenes, videos y voz) y procesamiento de lenguaje natural. |
|
|
Consulta difusa |
Los índices de búsqueda proporcionan consultas por comodín, prefijo y sufijo para la coincidencia difusa en diferentes escenarios.
|
|
|
Consulta de existencia de columna (consulta NULL) |
Comprueba si una columna tiene un valor nulo. Adecuado para verificaciones de integridad de datos y limpieza de datos. |
|
|
Consulta anidada |
Más allá de las estructuras planas, los datos de las aplicaciones suelen tener estructuras anidadas de varios niveles. Por ejemplo, un sistema de etiquetado de imágenes almacena imágenes con múltiples entidades (casas, autos, personas), cada una con diferente posición, tamaño y peso (puntuación). Cada imagen se asigna a varias etiquetas, y cada etiqueta tiene un nombre y una puntuación de peso. Para filtrar imágenes según condiciones de etiquetas, utilice la consulta de tipo anidado. Las etiquetas de imagen se almacenan en formato JSON: Las consultas de tipo anidado manejan datos con relaciones lógicas multinivel, lo que brinda flexibilidad para el modelado complejo de datos. Para estructuras de datos anidadas complejas (como JSON), utilice la función de resumen y resaltado para localizar con precisión la información requerida. |
|
|
Deduplicación |
Los índices de búsqueda deduplican los resultados de consulta para mejorar la diversidad. La deduplicación limita cuántas veces aparece un valor de atributo específico en un solo conjunto de resultados. Por ejemplo, al buscar |
|
|
Ordenamiento |
Tablestore ordena los datos por clave principal en orden alfabético de forma predeterminada. Para ordenar por otros campos, utilice la función de ordenamiento de un índice de búsqueda. Los índices de búsqueda admiten orden ascendente o descendente, ordenamiento por condición única y ordenamiento por múltiples condiciones. Todo el ordenamiento es global. De forma predeterminada, los resultados del índice de búsqueda se ordenan por clave principal en orden alfabético. |
|
|
Número total de filas |
Al consultar datos con un índice de búsqueda, puede devolver el número de filas coincidentes. Esto es útil para la validación y operación de datos.
|
|
|
Agregación estadística |
Los índices de búsqueda proporcionan funciones de agregación comunes: Max, Min, Avg, Sum, Count, DistinctCount, GroupBy, Percentile e Histogram. Estas satisfacen necesidades estadísticas básicas para análisis ligeros. |
Regiones compatibles
Actualmente, la función de índice de búsqueda está disponible en las siguientes regiones: China (Hangzhou), China (Shanghai), China (Qingdao), China (Beijing), China (Zhangjiakou), China (Ulanqab), China (Shenzhen), China (Guangzhou), China (Chengdu), China (Hong Kong), Japan (Tokyo), Singapore, Malaysia (Kuala Lumpur), Indonesia (Jakarta), Philippines (Manila), Thailand (Bangkok), Germany (Frankfurt), UK (London), US (Silicon Valley), US (Virginia), SAU (Riyadh - Partner Region), y . La función de búsqueda vectorial aún no es compatible con la región US (Silicon Valley).
Recuperación ante desastres
En regiones con capacidades de recuperación ante desastres por zona, los índices de búsqueda proporcionan almacenamiento redundante por zona de forma predeterminada. Los datos se almacenan en varias zonas dentro de la región. Si falla una sola zona, los servicios de lectura y escritura continúan sin interrupciones.
Actualmente, el índice de búsqueda admite almacenamiento redundante por zona en las siguientes regiones: China (Hangzhou), China (Shanghai), China (Beijing), China (Zhangjiakou), China (Ulanqab), China (Shenzhen), China (Hong Kong), Japan (Tokyo), Singapore, Indonesia (Jakarta), Germany (Frankfurt), y .
Ciclo de vida de los datos
Si su tabla de datos no tiene operaciones UpdateRow, puede utilizar el TTL del índice de búsqueda. Lifecycle management.
Si solo necesita conservar datos durante un período específico y el campo de tiempo no requiere actualizaciones, implemente TTL mediante la fragmentación de tablas por tiempo.
|
Dimensión |
Fragmentación de tabla por tiempo |
|
Principio |
Fragmente las tablas por un intervalo fijo (día, semana, mes o año). Cree un índice de búsqueda para cada tabla y conserve las tablas de datos durante el tiempo necesario. Por ejemplo, para conservar datos durante seis meses, almacene los datos de cada mes en una tabla separada (table_1 a table_6) con su propio índice de búsqueda. Cada mes, elimine la tabla correspondiente a hace seis meses. Al consultar, si el rango de tiempo cae dentro de una sola tabla, consulte solo esa tabla. Si abarca varias tablas, consulte cada una y combine los resultados. |
|
Regla |
Una sola tabla (índice único) no debe exceder los 50 mil millones de filas. El rendimiento de consulta es óptimo cuando el recuento de filas se mantiene por debajo de 20 mil millones. |
|
Ventajas |
|
Versiones de datos
Los índices de búsqueda no admiten múltiples versiones de datos. No puede crear un índice de búsqueda para una tabla de datos que tenga habilitadas múltiples versiones.
En una tabla de versión única, si personaliza la marca de tiempo para cada escritura, escribir datos con un número de versión menor después de uno mayor puede sobrescribir la versión mayor.
Los datos devueltos por las solicitudes Search y ParallelScan no necesariamente incluyen la propiedad de marca de tiempo.
Límites
Los índices de búsqueda sincronizan datos desde la tabla de datos de manera asíncrona, por lo que no son posibles las consultas en tiempo real. La latencia típica es inferior a 3 segundos. Search index limits.
Facturación
Los índices de búsqueda se facturan según el espacio de almacenamiento ocupado por los datos del índice y los recursos de cómputo consumidos para consultas y análisis. Billing overview.
Desarrollo e integración
Referencia de API
Los índices de búsqueda proporcionan operaciones de API para la gestión de índices y la consulta de datos. La consulta de datos incluye la API Search de propósito general y la API ParallelScan para exportación de datos. ParallelScan sacrifica algunas funciones (ordenamiento, agregación) para lograr un mayor rendimiento y throughput.
|
Categoría |
API |
Descripción |
|
Gestión de índices |
Crea un índice de búsqueda. |
|
|
Actualiza la configuración de un índice de búsqueda, incluido su tiempo de vida (TTL) y el esquema del índice. |
||
|
Obtiene la descripción detallada de un índice de búsqueda. |
||
|
Enumera los índices de búsqueda. |
||
|
Elimina un índice de búsqueda. |
||
|
Consulta de datos |
API de consulta con todas las funciones. Admite todas las funciones del índice de búsqueda, incluidas funciones de consulta, ordenamiento y agregación estadística. Los resultados se devuelven en el orden especificado.
|
|
|
API de exportación de datos con soporte para escaneo paralelo. Incluye todas las funciones de consulta, pero omite el ordenamiento y la agregación estadística. Devuelve todos los datos coincidentes a mayor velocidad. Con una sola concurrencia, el throughput de ParallelScan es 5 veces superior al de la API Search.
Al exportar datos con múltiples solicitudes concurrentes, utilice la API ComputeSplits para obtener la concurrencia máxima para una sola solicitud ParallelScan. |
Métodos de integración
Puede utilizar los siguientes SDK o herramientas CLI para trabajar con índices de búsqueda.
Preguntas frecuentes
How do I choose between a secondary index and a search index?
Why can't I retrieve data using the Search API of a search index?
What are the differences between using the GetRange API and the Search API for range queries?
Does Tablestore support queries similar to 'in' and 'between...and' in relational databases?
How do I increase the 'limit' for the Search API of a search index to 1,000?
Why are reserved read CUs generated when I use a search index?
Can the reserved read CU configuration for a search index be adjusted?
Can the reserved read throughput of a search index be covered by a reserved CU plan?
Referencias
-
Para consultar y analizar datos con SQL, utilice la función SQL query de Tablestore.
NotaTambién puede analizar datos en Tablestore mediante motores de cómputo como MaxCompute, Spark, Hive, HadoopMR, Function Compute o Flink. Compute and analysis overview.
Apéndice: mapeo SQL
Algunas funciones del índice de búsqueda tienen una correspondencia directa con funciones SQL. A continuación se listan estos mapeos.
|
SQL |
Search index |
Documentación del search index |
|
Show |
DescribeSearchIndex |
|
|
Select |
Parámetro ColumnsToGet en cualquier consulta |
Cualquier consulta de search index, como una basic query |
|
From |
Parámetro IndexName en cualquier consulta Importante
Se admite un solo índice. Aún no hay compatibilidad para varios índices. |
Cualquier consulta de search index, como una basic query |
|
Where |
Condiciones en cualquier consulta |
Cualquier consulta de search index, como una basic query |
|
Order by |
Parámetro sort en cualquier consulta |
|
|
Limit |
Parámetro limit en cualquier consulta |
|
|
Delete |
|
|
|
Like |
WildcardQuery |
|
|
And |
operator = and en BoolQuery |
|
|
Or |
operator = or en BoolQuery |
|
|
Not |
BoolQuery(mustNotQueries) |
|
|
Between |
RangeQuery |
|
|
Null |
ExistsQuery |
|
|
In |
TermsQuery |
|
|
Min |
Aggregation: min |
|
|
Max |
Aggregation: max |
|
|
Avg |
Aggregation: avg |
|
|
Count |
Aggregation: count |
|
|
Count(distinct) |
Aggregation: distinctCount |
|
|
Sum |
Aggregation: sum |
|
|
Group By |
GroupBy |