La búsqueda vectorial de Tablestore (KnnVectorQuery) ejecuta consultas de vecino más cercano aproximado mediante vectores numéricos para encontrar los elementos de datos más similares en conjuntos de datos a gran escala. Los casos de uso comunes incluyen la generación aumentada por recuperación (RAG), sistemas de recomendación, detección de similitud, procesamiento de lenguaje natural y búsqueda semántica.
Escenarios
La búsqueda vectorial se aplica en sistemas de recomendación, recuperación de imágenes y videos, procesamiento de lenguaje natural y búsqueda semántica.
-
Generación aumentada por recuperación (RAG)
RAG es un framework de IA que combina la recuperación con modelos grandes de lenguaje (LLM) para mejorar la precisión de las salidas del LLM, especialmente con datos privados o profesionales. RAG se utiliza ampliamente en escenarios de base de conocimientos.
-
Sistema de recomendación
En plataformas de comercio electrónico, redes sociales y streaming, los comportamientos, preferencias y características de contenido de los usuarios se codifican en vectores. La búsqueda vectorial encuentra productos, artículos o videos coincidentes, lo que permite recomendaciones personalizadas que mejoran la satisfacción y retención de los usuarios.
-
Detección de similitud (imágenes, videos y voz)
En el reconocimiento de imágenes, videos, voz, huella vocal y facial, los datos no estructurados se convierten en representaciones vectoriales. La búsqueda vectorial encuentra los objetivos más similares. Por ejemplo, cuando un usuario carga una imagen en una plataforma de comercio electrónico, el sistema busca imágenes de productos con estilos, colores o patrones similares.
-
Procesamiento de lenguaje natural y búsqueda semántica
En el procesamiento de lenguaje natural (NLP), el texto se convierte en representaciones vectoriales como embeddings de Word2Vec o BERT. La búsqueda vectorial asocia la semántica de la consulta para encontrar los documentos, noticias o pares de preguntas y respuestas más relevantes, lo que mejora la pertinencia de los resultados de búsqueda y la experiencia del usuario.
-
Grafo de conocimiento y chat de IA
Los nodos y relaciones de un grafo de conocimiento pueden representarse como vectores. La búsqueda vectorial acelera la vinculación de entidades, la inferencia de relaciones y los tiempos de respuesta del chat de IA, lo que permite respuestas más precisas a preguntas complejas.
Ventajas principales
Bajo costo
El motor principal utiliza tecnología DiskAnn optimizada. A diferencia del algoritmo Hierarchical Navigable Small World (HNSW), DiskAnn no carga todos los datos del índice en memoria. Logra una tasa de recuperación y un rendimiento comparables a HNSW mientras usa menos del 10% de la memoria, lo que reduce significativamente los costos en comparación con sistemas similares.
Facilidad de uso
La búsqueda vectorial es una subfunción serverless del índice de búsqueda. No requiere compilación ni despliegue del sistema. Para comenzar, cree una instancia en la consola de Tablestore.
Esta función admite el método de facturación pay-as-you-go, sin necesidad de gestionar niveles de uso ni realizar escalado horizontal manual. El sistema escala horizontalmente tanto en almacenamiento como en cómputo. La búsqueda vectorial admite hasta cientos de miles de millones de entradas de datos, mientras que la búsqueda no vectorial admite hasta diez billones de entradas.
Durante una búsqueda vectorial, el motor interno utiliza un optimizador de consultas para seleccionar automáticamente el mejor algoritmo y la ruta de ejecución óptima. Es posible lograr alta recuperación y rendimiento sin ajustar extensivamente los parámetros, lo que reduce la barrera de entrada y acorta el ciclo de desarrollo.
La búsqueda vectorial está disponible mediante SQL, SDK para varios lenguajes como Java, Go, Python y Node.js, y frameworks de código abierto como LangChain, LangChain4J y LlamaIndex.
Descripción general de funciones
Una KnnVectorQuery encuentra los elementos de datos más similares en un conjunto de datos a gran escala al ejecutar una consulta de vecino más cercano aproximado sobre vectores numéricos.
La búsqueda vectorial hereda todas las funciones de un índice de búsqueda. Al ser un servicio listo para usar con modelo pay-as-you-go, no requiere despliegue del sistema. La construcción de índices basada en flujos permite consultar los datos casi en tiempo real después de su escritura. También admite adiciones, actualizaciones y eliminaciones con alto throughput, con un rendimiento de consulta comparable al de los sistemas basados en HNSW.
Para usar KnnVectorQuery, especifique el vector de consulta, el campo vectorial donde buscar y el número de vecinos más cercanos (TopK) por recuperar. La consulta devuelve los vectores TopK más similares al vector de consulta. Puede combinarla con otras funciones de búsqueda no vectorial para filtrar resultados según sea necesario.
Descripción del campo vectorial
Antes de usar KnnVectorQuery, configure un campo vectorial al crear un índice de búsqueda. Especifique las dimensiones del vector, el tipo de datos y el algoritmo de medición de distancia.
El campo correspondiente en la tabla de datos debe usar el tipo de datos String, y el índice de búsqueda debe usar una cadena de matriz Float32. Para obtener detalles sobre la configuración del campo vectorial, consulte la siguiente tabla.
|
Elemento de configuración |
Descripción |
|
dimension |
Las dimensiones del vector. La dimensión máxima admitida es 4096. El valor debe coincidir con la dimensión de los vectores generados por el sistema de embedding ascendente. La longitud de la matriz del campo vectorial debe ser igual al parámetro de dimensión configurado. Por ejemplo, si el valor del campo vectorial es la cadena Nota
Solo se admiten vectores densos. La dimensión del campo vectorial debe coincidir con la dimensión establecida en el esquema al crear el índice. Una discrepancia provoca que falle la construcción del índice para esa fila. |
|
dataType |
El tipo de datos del vector. Solo se admite Float32. Float32 no admite valores extremos como NaN e Infinite. El tipo de datos debe coincidir con el tipo de datos vectoriales generado por el sistema de embedding ascendente. Nota
Para usar vectores de otros tipos de datos, envíe un ticket para contactarnos. |
|
metricType |
El algoritmo utilizado para medir la distancia entre vectores. Valores válidos: euclidean, cosine y dot_product. El algoritmo de medición de distancia debe coincidir con el algoritmo recomendado del sistema de embedding ascendente. Para obtener más información, consulte Distance measure algorithms. |
Diferentes modelos o versiones de un sistema de embedding generan vectores con distintas propiedades, incluidas dimensión, tipo de datos y algoritmo de medición de distancia. Las propiedades del campo vectorial en el sistema de búsqueda vectorial (dimensión, tipo de datos y algoritmo de medición de distancia) deben coincidir con las propiedades de los vectores generados por el sistema de embedding. Para obtener más información sobre cómo generar vectores, consulte Two ways to generate vectors.
Algoritmos de medición de distancia
La búsqueda vectorial admite tres algoritmos de medición de distancia: euclidean, cosine y dot_product. Una puntuación más alta indica mayor similitud entre dos vectores.
|
MetricType |
Fórmula de puntuación |
Rendimiento |
Descripción |
|
Distancia euclidiana (euclidean) |
|
Alto |
La distancia euclidiana mide la distancia en línea recta entre dos vectores en un espacio multidimensional. Por razones de rendimiento, la implementación de Tablestore omite el cálculo final de la raíz cuadrada. Una puntuación más alta indica mayor similitud. |
|
Producto punto (dot_product) |
|
Más alto |
El producto punto multiplica las coordenadas correspondientes de dos vectores de la misma dimensión y suma los resultados. Una puntuación más alta indica mayor similitud. Importante
Normalice los vectores Float32 antes de escribirlos en una tabla, por ejemplo, mediante la norma L2. Sin normalización, pueden presentarse problemas como resultados de consulta deficientes, construcción lenta del índice vectorial y bajo rendimiento de consulta. Para ver un ejemplo de normalización de vectores, consulte Appendix 2: Vector normalization example. |
|
Similitud coseno (cosine) |
|
Bajo |
Mide el coseno del ángulo entre dos vectores. Una puntuación más alta indica mayor similitud. La similitud coseno se usa comúnmente para datos de texto. Dado que la división por cero no está definida, la similitud coseno no puede calcularse si la suma de cuadrados de un vector Float32 es 0. Importante
El cálculo de la similitud coseno es complejo. Se recomienda normalizar los vectores antes de escribir datos en la tabla y luego usar dot_product como algoritmo de medición de distancia. Para ver un ejemplo de normalización de vectores, consulte Appendix 2: Vector normalization example. |
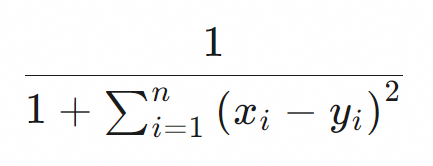
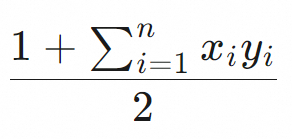
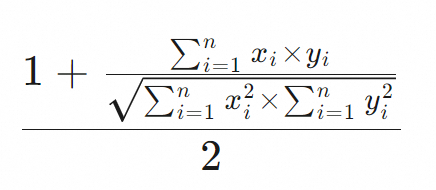
Notas
Tenga en cuenta lo siguiente al utilizar la búsqueda vectorial:
Existen límites aplicables al número de tipos de campos vectoriales, dimensiones y otras propiedades. Para obtener más información, consulte Search index limits.
El índice de búsqueda se particiona en el lado del servidor. Cada partición devuelve sus propios vecinos más cercanos TopK, y los resultados se agregan posteriormente en el nodo cliente. Por lo tanto, si se usa un token para paginar todos los datos, el número total de filas devueltas depende del número de particiones del servidor.
Actualmente, la función de búsqueda vectorial está disponible en las siguientes regiones: China (Hangzhou), China (Shanghai), China (Qingdao), China (Beijing), China (Zhangjiakou), China (Ulanqab), China (Shenzhen), China (Guangzhou), China (Chengdu), China (Hong Kong), Japan (Tokyo), Singapore, Malaysia (Kuala Lumpur), Indonesia (Jakarta), Philippines (Manila), Thailand (Bangkok), Germany (Frankfurt), UK (London), US (Virginia), US (Silicon Valley), SAU (Riyadh - Partner Region).
Procedimiento
-
Utilice modelos de código abierto para convertir los datos en Tablestore en vectores y almacenarlos.
Write vector data a Tablestore.
-
Cuando create a search index, configure el campo vectorial.
Configure el tipo, las dimensiones y el algoritmo de medición de distancia del campo vectorial.
Use vector search para consultar datos.
Facturación
Durante la vista previa pública, no se le cobra por conceptos facturables específicos de la función de consulta vectorial KNN. Se le cobra por otros conceptos facturables según las reglas de facturación existentes.
Cuando utiliza un índice de búsqueda para consultar datos, se le cobra por el throughput de lectura consumido. Para obtener más información, consulte Billable items of search indexes.
Apéndice 1: Uso con BoolQuery
KnnVectorQuery y BoolQuery pueden combinarse de diferentes maneras. Los siguientes dos ejemplos asumen un escenario donde un filtro coincide con una pequeña cantidad de datos.
Suponga que una tabla contiene 100 millones de imágenes. Un usuario tiene 50,000 imágenes en total, pero solo 50 se agregaron en los últimos 7 días. El usuario desea encontrar las 10 imágenes más similares de entre las agregadas en los últimos 7 días mediante búsqueda por imagen. La siguiente tabla muestra cómo difieren estos dos métodos de combinación.
|
Uso combinado |
Diagrama de condición de consulta |
Descripción |
|
Usar BoolQuery dentro del filtro de KnnVectorQuery |
|
KnnVectorQuery localiza las filas que cumplen la condición de BoolQuery y devuelve las filas TopK más similares. La respuesta de SearchRequest devuelve las primeras En este ejemplo, KnnVectorQuery primero usa el filtro para seleccionar las 50 imágenes pertenecientes al usuario "a" de los últimos 7 días, luego encuentra las 10 imágenes más similares de esas 50 y las devuelve. |
|
Usar KnnVectorQuery dentro de BoolQuery |
|
Cada subconsulta en BoolQuery se ejecuta primero, y luego se calcula la intersección de todos los resultados de las subconsultas. En este ejemplo, KnnVectorQuery devuelve las 500 imágenes más similares de los 100 millones de imágenes en la tabla, y luego busca secuencialmente las 10 imágenes del usuario "a" de los últimos 7 días. Sin embargo, es posible que las 500 imágenes principales no incluyan las 50 imágenes del usuario "a" de los últimos 7 días. Por lo tanto, este método de consulta podría no encontrar las 10 imágenes más similares de los últimos 7 días, e incluso podría no devolver datos. |


Apéndice 2: Ejemplo de normalización de vectores
El siguiente código normaliza un vector:
  public static float[] l2normalize(float[] v, boolean throwOnZero) {
    double squareSum = 0.0f;
    int dim = v.length;
    for (float x : v) {
      squareSum += x * x;
    }
    if (squareSum == 0) {
      if (throwOnZero) {
        throw new IllegalArgumentException("can't normalize a zero-length vector");
      } else {
        return v;
      }
    }
    double length = Math.sqrt(squareSum);
    for (int i = 0; i < dim; i++) {
      v[i] /= length;
    }
    return v;
  }