SQL Enhancement aplica escalado elástico a los recursos de almacenamiento y cómputo para acelerar las consultas y el análisis en Simple Log Service sin intervención manual.
Funcionamiento
Contexto
Simple Log Service desacopla el almacenamiento del cómputo: la capa de almacenamiento basada en shard se encarga de guardar y gestionar los datos, mientras que la capa de cómputo utiliza SQL para las consultas y el análisis.
Para mejorar el rendimiento del análisis, optimice una o ambas capas. A continuación se comparan los enfoques más comunes.

Solución 1: dividir un shard
split a shard manualmente para ampliar la capacidad de almacenamiento e incrementar de forma indirecta el rendimiento de cómputo.
Limitaciones:
Este método solo aplica a los datos recién escritos.
Los shards activos generan cargos. Facturación.
Una consulta individual está limitada por la concurrencia y el volumen de datos.
Debe dividir o combinar los shards de manera manual.
Solución 2: consultas con divide y vencerás
Divida una consulta grande en varias subconsultas y agregue los resultados.
Limitaciones:
Requiere mantener lógica de agregación secundaria y almacenamiento intermedio. Utilice Scheduled SQL para este fin.
Cambiar las dimensiones de análisis implica reconstruir la lógica de agregación.
Pueden presentarse cuellos de botella de cómputo con volúmenes de datos muy grandes.
Solución 3: usar SQL Enhancement
SQL Enhancement escala dinámicamente los recursos de almacenamiento y cómputo según el volumen de datos. Esto ofrece un análisis más rápido sin ajustes manuales.

|
Comparación |
Solución 1: dividir un shard |
Solución 2: consultas con divide y vencerás |
Solución 3: usar SQL Enhancement |
|
Aislamiento de recursos |
Recursos de almacenamiento independientes, recursos de cómputo compartidos |
Recursos de almacenamiento independientes, recursos de cómputo compartidos |
Recursos de almacenamiento independientes y recursos de cómputo dedicados con escalado elástico |
|
Granularidad de escalado |
Escalado de la capa de almacenamiento |
Escalado de la capa de cómputo |
Escalado elástico para las capas de almacenamiento y cómputo |
|
Carga de mantenimiento |
Requiere intervención manual. |
Debe dividir las consultas grandes en subconsultas. |
Programación completamente automatizada. |
|
Complejidad de la consulta |
Admite SQL nativo. |
Requiere desarrollo personalizado. |
Admite SQL nativo. |
Requisitos previos
Se creó un logstore estándar. Para obtener más información, consulte Create a basic LogStore.
Se recopilaron los registros. Para obtener más información, consulte Data collection.
Se configuraron los índices. Para obtener más información, consulte Configure indexes.
Procedimiento
Habilite SQL Enhancement mediante uno de los siguientes métodos:
Habilitar para una sola consulta: aplica únicamente a la consulta actual en el logstore.
Habilitar de forma predeterminada: aplica a todas las consultas del proyecto, incluidas las alertas y los paneles.
Console
Habilitar para una sola consulta
Inicie sesión en la consola de Simple Log Service.
-
En la sección Projects, haga clic en el proyecto deseado.
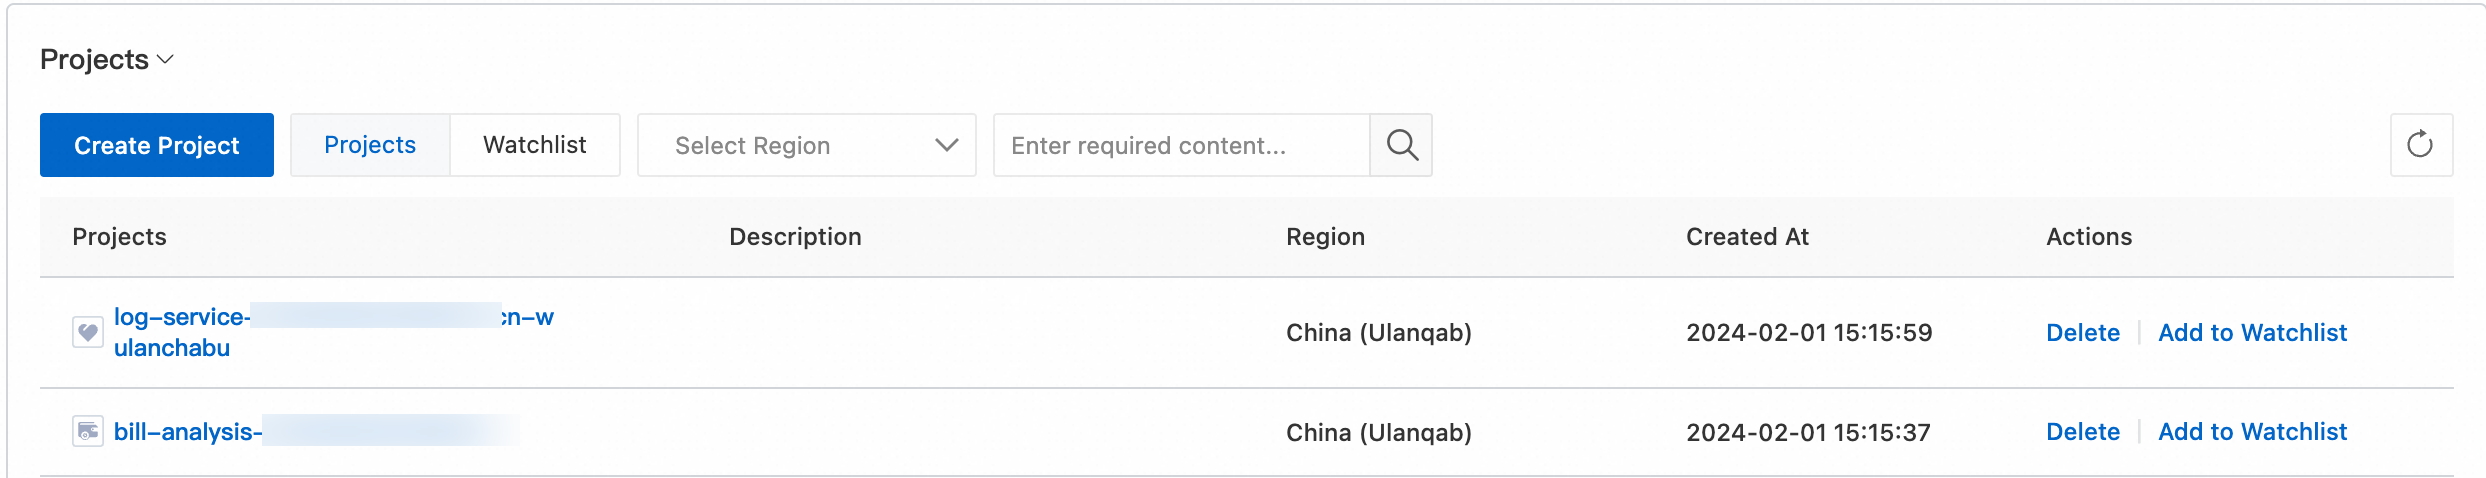
-
En la pestaña , haga clic en el logstore deseado.
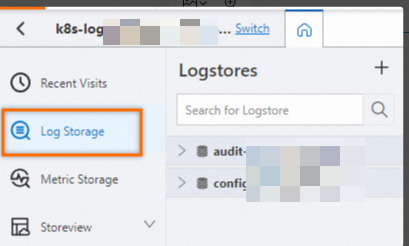
Haga clic en
 > SQL Enhancement.
Habilitar de forma predeterminada
Inicie sesión en la consola de Simple Log Service.
-
En la sección Projects, haga clic en el proyecto deseado.
-
Haga clic en el icono
 .
Haga clic en el icono Home de la barra de navegación superior para volver a la lista de proyectos o cambiar de proyecto.
Coloque el cursor sobre CUs of SQL-dedicated Instance y haga clic en Settings.
En el panel Modify CUs of SQL-dedicated Instance, active el interruptor Enable by Default y luego haga clic en OK.
API
Habilitar para una sola consulta
-
GetLogs (returns uncompressed results) - Query logs in a Logstore
Configure uno de los siguientes parámetros.
El parámetro
powerSql: establézcalo en true para SQL Enhancement o en false (valor predeterminado) para SQL estándar.El parámetro
query: antepongaset session parallel_sql=true;a su instrucción SQL. Por ejemplo,* | select count(*) as pvse convierte en* | set session parallel_sql=true; select count(*) as pv.
-
GetLogsV2 (returns compressed results) - Query log data in a Logstore
Configure uno de los siguientes parámetros.
El parámetro
powerSql: establézcalo en true para SQL Enhancement o en false (valor predeterminado) para SQL estándar.El parámetro
query: antepongaset session parallel_sql=true;a su instrucción SQL. Por ejemplo,* | select count(*) as pvse convierte en* | set session parallel_sql=true; select count(*) as pv.
Habilitar de forma predeterminada
En la operación Create a Dedicated SQL instance, establezca useAsDefault=true para habilitar SQL Enhancement de forma predeterminada en el proyecto.
SDK
Los siguientes ejemplos utilizan el SDK de Java.
Requisitos previos
Habilitar para una sola consulta
-
Método GetLogs()
Configure uno de los siguientes parámetros.
El parámetro
powerSql: establézcalo en true para SQL Enhancement o en false (valor predeterminado) para SQL estándar.El parámetro
query: antepongaset session parallel_sql=true;a su instrucción SQL. Por ejemplo,* | select count(*) as pvse convierte en* | set session parallel_sql=true; select count(*) as pv.
import com.aliyun.openservices.log.Client;
import com.aliyun.openservices.log.exception.LogException;
import com.aliyun.openservices.log.response.GetLogsResponse;
import java.util.Date;
public class CreateSqlInstance {
    public static void main(String[] args) throws LogException {
        // This example shows how to obtain an AccessKey ID and an AccessKey secret from environment variables.
        String accessId = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_ID");
        String accessKey = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_SECRET");
        // The endpoint for Simple Log Service. This example uses the endpoint for the China (Hangzhou) region. Replace it with the actual endpoint.
        String host = "https://cn-hangzhou.log.aliyuncs.com";
        // Create a Simple Log Service client.
        Client client = new Client(host, accessId, accessKey);
        // The Project name.
        String projectName = "aliyun-project-test";
        // The Logstore name.
        String logstore = "request_log";
        // Specifies whether to enable SQL Enhancement by default. Default value: false.
        boolean useAsDefault = true;
        // The SQL query statement.
        String query = "* | select count(1)";
        // The maximum number of logs to return. This parameter is valid only when the query parameter is a search statement. Value range: 0 to 100. Default value: 100.
        int line = 3;
        // The line number from which to start the query. This parameter is valid only when the query parameter is a search statement. Default value: 0.
        int offset = 0;
        // Specifies whether to return logs in reverse chronological order of log timestamps, accurate to the minute.
        // true: Returns logs in reverse chronological order.
        // false (default): Returns logs in chronological order.
        boolean reverse = false;
        // Specifies whether to use SQL Enhancement.
        // true: Use SQL Enhancement.
        // false (default): Use Standard SQL.
        boolean powerSql = true;
        int from = (int) (new Date().getTime() / 1000 - 600);
        int to = (int) (new Date().getTime() / 1000);
        GetLogsResponse getLogsResponse = client.GetLogs(projectName, logstore, from, to, "", query, line, offset, reverse, powerSql);
        System.out.println(getLogsResponse.getCpuSec());
    }
}
Habilitar de forma predeterminada
Establezca boolean useAsDefault = true para habilitar SQL Enhancement de forma predeterminada en el proyecto.
import com.aliyun.openservices.log.Client;
import com.aliyun.openservices.log.exception.LogException;
import com.aliyun.openservices.log.request.CreateOrUpdateSqlInstanceRequest;
public class CreateSqlInstance {
    public static void main(String[] args) throws LogException {
        // This example shows how to obtain an AccessKey ID and an AccessKey secret from environment variables.
        String accessId = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_ID");
        String accessKey = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_SECRET");
        // The Project name.
        String projectName = "aliyun-test-project";
        // The endpoint for Simple Log Service. This example uses the endpoint for the China (Hangzhou) region. Replace it with the actual endpoint.
        String host = "https://cn-hangzhou.log.aliyuncs.com";
        // Create a Simple Log Service client.
        Client client = new Client(host, accessId, accessKey);
        int cu = 100;
        boolean useAsDefault = true;
        client.createSqlInstance(new CreateOrUpdateSqlInstanceRequest(projectName, cu, useAsDefault));
    }
}Preguntas frecuentes
-
¿Cómo compruebo el tiempo de CPU?
Después de ejecutar una consulta, coloque el cursor sobre Analysis Results para consultar el tiempo de CPU. El campo Consumed CPU Time, ubicado en el panel de estadísticas superior derecho, muestra el tiempo de CPU en segundos.
-
Costo de una consulta de Dedicated SQL
El costo varía según el volumen de datos y la complejidad de la consulta.
Instrucción de consulta
Volumen de datos (filas)
Costo por ejecución (USD)
* | select avg(double_0) from stress_s1_mil14 mil millones
0.004435
* | select avg(double_0), sum(double_0), max(double_0), min(double_0), count(double_0) from stress_s1_mil14 mil millones
0.006504
* | select avg(double_0), sum(double_1), max(double_2), min(double_3), count(double_4) from stress_s1_mil14 mil millones
0.013600
* | select key_0 , avg(double_0) as pv from stress_s1_mil1 group by key_0 order by pv desc limit 10004 mil millones
0.011826
* | select long_0, avg(double_0) as pv from stress_s1_mil1 group by long_0 order by pv desc limit 10004 mil millones
0.011087
* | select long_0, long_1, avg(double_0) as pv from stress_s1_mil1 group by long_0,long_1 order by pv desc limit 1000300 millones
0.010791
* | select avg(double_0) from stress_s1_mil1 where key_0='key_987'4 mil millones
0.00007