Simple Log Service (SLS) permite importar archivos de registro desde Amazon S3 para su consulta, análisis y procesamiento. Se admiten objetos individuales de S3 de hasta 5 GB (para objetos comprimidos, se considera el tamaño después de la compresión).
Requisitos previos
Cargue los archivos de registro en Amazon S3.
Cree un proyecto y un logstore. Manage a project, Create a logstore.
-
Configure permisos personalizados:
-
Cree una directiva personalizada que otorgue permisos para gestionar recursos de S3, como se muestra en el siguiente ejemplo (AWS: Custom permission sets).
NotaSe requieren permisos personalizados de S3 para importar archivos a SLS.
{ "Version": "1", "Statement": [ { "Effect": "Allow", "Action": [ "s3:GetObject", "s3:ListBucket" ], "Resource": [ "arn:aws:s3:::your_bucket_name", "arn:aws:s3:::your_bucket_name/*" ] } ] } -
Cree una directiva personalizada que otorgue permisos para gestionar recursos de SQS (AWS: Custom permission sets).
NotaEsto es necesario solo si habilita la integración con SQS. Una cola de SQS debe dedicarse exclusivamente a una única tarea de importación. No utilice la cola para otras tareas de importación ni para ningún otro propósito. Si los datos en la cola no coinciden con las condiciones de filtro de la tarea de importación, el sistema los elimina de forma predeterminada.
{
  "Effect": "Allow",
  "Action": [
    "sqs:ReceiveMessage",
    "sqs:DeleteMessage",
    "sqs:GetQueueAttributes",
    "kms:Decrypt"
  ],
  "Resource": "*"
}
-
Crear una configuración de importación de datos
Inicie sesión en la consola de Simple Log Service.
Vaya a Import Data > Data Import y seleccione S3 - Data Import.
Seleccione el proyecto y el logstore de destino, y luego haga clic en Next.
-
Configure los ajustes de importación.
-
En el paso Import Configuration, establezca los siguientes parámetros.
Parámetro
Descripción
Task Name
El nombre único para el trabajo de Data Import.
S3 Region
La región donde se encuentra el bucket de origen.
AWS AccessKey ID
El AWS AccessKey ID utilizado para acceder a su cuenta de AWS.
ImportanteAsegúrese de que su AccessKey ID tenga los permisos necesarios para acceder a los recursos relevantes de AWS.
AWS Secret AccessKey
El AWS Secret AccessKey correspondiente a su AccessKey ID.
SQS Queue URL
La URL de la cola de SQS (AWS: Queue and message identifiers).
ImportanteEste parámetro es obligatorio solo si habilita la integración con SQS.
File Path Prefix Filter
Filtra los objetos de S3 por prefijo de clave. Por ejemplo, establezca el prefijo en
csv/para importar únicamente los objetos de ese directorio.Si deja este parámetro vacío, se escanea todo el bucket de S3.
NotaConfigure un prefijo para buckets grandes. Escanear un bucket completo ralentiza la importación.
File Path Regex Filter
Filtra los objetos de S3 mediante una expresión regular que coincide con la ruta completa del objeto. Solo se importan los objetos coincidentes. Está vacío de forma predeterminada (sin filtrado).
Por ejemplo, si un objeto de S3 se encuentra en
testdata/csv/bill.csv, puede establecer la expresión regular en(testdata/csv/)(.*).File Modification Time Filter
Filtra los objetos de S3 según su última hora de modificación.
All: Seleccione esta opción para importar todos los objetos que cumplan con las condiciones especificadas.
From Specific Time: Seleccione esta opción para importar objetos modificados después de un momento específico.
Specific Time Range: Seleccione esta opción para importar objetos modificados dentro de un rango de tiempo específico.
Data Format
El formato para analizar los archivos de registro:
CSV: Texto delimitado. Puede usar la primera fila del archivo como nombres de campo o especificarlos manualmente. Cada fila subsiguiente se analiza como los valores de una entrada de registro.
Single-line JSON: Lee el objeto de S3 línea por línea y analiza cada línea como un objeto JSON. Las claves del objeto JSON se convierten en los nombres de campo del registro.
Single-line Text Log: Analiza cada línea del objeto de S3 como una entrada de registro independiente.
Multi-line Text Logs: Analiza varias líneas como una sola entrada de registro. Debe especificar una expresión regular que coincida con el inicio o el final de la entrada.
Compression Format
El formato de compresión de los objetos de S3 de origen. SLS descomprime los objetos según el formato seleccionado antes de leer los datos.
Encoding Format
El formato de codificación de los objetos de S3 de origen. Solo se admiten UTF-8 y GBK.
New File Check Cycle
Si se agregan nuevos objetos continuamente a la ruta de S3 de origen, configure el New File Check Cycle según sea necesario. El trabajo de importación descubre y lee periódicamente los nuevos objetos. Cada objeto de S3 se importa como máximo una vez.
Si no se agregarán más objetos, seleccione Never Check. El trabajo se detiene después de importar todos los objetos coincidentes.
Log Time Configuration
Time Field
Si selecciona Data Format o Single-line JSON como Single-line JSON, puede especificar un campo que contenga la marca de tiempo. SLS utiliza este campo como la marca de tiempo del registro.
Time Field Extraction Regular Expression
Puede utilizar una expresión regular para extraer la marca de tiempo del contenido del registro.
Por ejemplo, si una entrada de registro de muestra es 127.0.0.1 - - [10/Sep/2018:12:36:49 0800] "GET /index.html HTTP/1.1", puede establecer la Time Field Extraction Regular Expression en
[0-9]{0,2}\/[0-9a-zA-Z]+\/[0-9:,]+.NotaPara otros formatos de datos, también puede usar una expresión regular para extraer solo una parte de un campo de tiempo.
Time Field Format
El formato utilizado para analizar el valor del campo de tiempo.
Admite la sintaxis de Java SimpleDateFormat, como
yyyy-MM-dd HH:mm:ss. Time formats.Se admiten formatos epoch, incluidos epoch, epochMillis, epochMicro y epochNano.
Time Zone
Seleccione la zona horaria para el campo de tiempo. No se requiere zona horaria para los formatos epoch.
Para considerar el horario de verano, seleccione un formato UTC. De lo contrario, seleccione un formato GMT.
NotaLa zona horaria predeterminada es UTC+8.
Si selecciona Data Format como Data Format, debe configurar los parámetros adicionales descritos en la siguiente tabla.
-
Parámetros específicos de CSV
Parámetro
Descripción
Delimiter
El delimitador utilizado para separar campos. El valor predeterminado es una coma (,).
Quote
El carácter de comilla utilizado para cadenas CSV.
Quote
El carácter de escape utilizado para escapar caracteres especiales. El valor predeterminado es una barra invertida (\).
Maximum Lines
Si habilita First Line as Field Name, la primera línea del archivo CSV se utiliza como nombres de campo.
Custom Fields
Si deshabilita First Line as Field Name, debe especificar nombres de campo personalizados para los registros. Separe varios nombres de campo con comas (,).
Lines to Skip
El número de líneas de registro que se omitirán desde el inicio del archivo. Por ejemplo, si establece esto en 1, la recopilación de datos comienza desde la segunda línea del archivo CSV.
-
Parámetros específicos de registros de texto multilínea
Parámetro
Descripción
Position to Match Regular Expression
La posición en la que se debe hacer coincidir la expresión regular. Están disponibles las siguientes opciones:
Regular Expression to Match First Line: Utiliza una expresión regular para coincidir con la primera línea de una entrada de registro. Las líneas no coincidentes se consideran parte de la entrada de registro actual hasta alcanzar el número máximo de líneas.
Regular Expression to Match Last Line: Utiliza una expresión regular para coincidir con la última línea de una entrada de registro. Las líneas no coincidentes se consideran parte de la siguiente entrada de registro hasta alcanzar el número máximo de líneas.
Regular Expression
La expresión regular que define el inicio o el final de una entrada de registro.
Maximum Lines
El número máximo de líneas para una sola entrada de registro.
Haga clic en Preview para comprobar el resultado de la importación.
Después de confirmar la configuración, haga clic en Next.
-
-
Visualice los datos, cree un índice y luego haga clic en Next.
SLS habilita el índice de texto completo de forma predeterminada. También puede crear índices de campo manualmente o hacer clic en Automatic Index Generation para generarlos automáticamente. Create an index.
ImportantePara consultar y analizar registros, debe habilitar un índice de texto completo o un índice de campo. Si ambos están habilitados, el índice de campo tiene prioridad.
Consultar la configuración de importación
Consulte los detalles de configuración y los informes estadísticos en la consola.
En la lista de proyectos, haga clic en el proyecto de destino.
En la sección , busque el logstore de destino, elija y luego haga clic en el nombre de la configuración.
Consulte la información básica y los informes estadísticos de la configuración de importación.
-
También puede modificar, iniciar, detener o eliminar la configuración de importación.
AvisoEsta operación no se puede deshacer. Proceda con precaución.
Facturación
SLS no cobra por la función Data Import. Sin embargo, pueden aplicarse cargos por transferencia de datos y solicitudes de API de su proveedor de nube. El siguiente modelo describe los costos potenciales. Consulte la factura de su proveedor para ver los cargos reales.
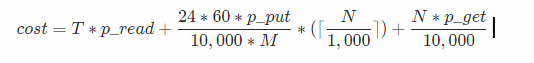
|
Field |
Description |
|
|
Total daily data import volume, in GB. |
|
|
Cost per GB of outbound internet traffic. |
|
|
Cost per 10,000 PUT requests. |
|
|
Cost per 10,000 GET requests. |
|
|
New file check interval, in minutes. You can set the New File Check Cycle when you create the data import configuration. |
|
|
The number of listable objects in the bucket that match the specified prefix. |
Preguntas frecuentes
Problema | Causa posible | Solución |
La vista previa no muestra datos. | No hay objetos en el bucket de S3, los objetos no contienen datos o ningún objeto coincide con las condiciones de filtro. |
|
Los datos importados contienen texto ilegible. | Las configuraciones de Data Format, Compression Format o Encoding Format no coinciden con el archivo de origen. | Confirme el formato real de los objetos de S3 y luego ajuste las configuraciones de Data Format, Compression Format o Encoding Format según corresponda. Para corregir datos ilegibles existentes, debe crear un nuevo logstore y una nueva configuración de importación. |
Las marcas de tiempo de los registros en SLS no coinciden con las de los datos de origen. | No se especificó el campo de tiempo del registro, o bien el formato de hora o la zona horaria se configuraron incorrectamente en la configuración de importación. | Especifique el campo de tiempo del registro y establezca el formato de hora y la zona horaria correctos. Log Time Configuration. |
No se pueden consultar ni analizar los datos después de importarlos. |
|
|
El número de entradas de registro importadas es menor de lo esperado. | Las entradas de registro individuales mayores de 3 MB se descartan durante la importación (Data collection limits). | Al escribir datos en archivos de S3, asegúrese de que una sola línea de datos no exceda los 3 MB. |
Algunos archivos no se importan. | Las condiciones de filtro están configuradas incorrectamente o algunos archivos superan el límite de tamaño de 5 GB (Data collection limits). |
|
Los registros de texto multilínea se analizan incorrectamente. | La expresión regular para coincidir con la primera o la última línea es incorrecta. | Verifique que la expresión regular para coincidir con la primera o la última línea sea correcta. |
La importación de nuevos archivos presenta alta latencia. | Demasiados objetos existentes coinciden con el filtro de prefijo de ruta de archivo. | Si el número de objetos que coinciden con el filtro de prefijo de ruta de archivo es demasiado grande (por ejemplo, más de un millón), establezca un prefijo más específico y cree varios trabajos de importación. De lo contrario, el descubrimiento de nuevos archivos se ralentiza significativamente. |
Manejo de errores
|
Error |
Descripción |
|
Fallo en la lectura de archivo |
Si la lectura de un archivo falla debido a problemas de red, corrupción u otros errores, el trabajo de importación reintenta hasta tres veces antes de omitir el archivo. El intervalo de reintento es el mismo que el New File Check Cycle. Si New File Check Cycle está configurado en Never Check, el intervalo de reintento es de 5 minutos. |
|
Error de análisis de formato de compresión |
Si ocurre un error de formato de compresión no válido al descomprimir un archivo, el trabajo de importación omite el archivo. |
|
Error de análisis de formato de datos |
Cuando falla el análisis de datos, la tarea de importación almacena el contenido de texto original en el campo content del registro. |
|
El bucket de S3 no existe |
El trabajo de importación reintenta periódicamente. Una vez recreado el bucket, el trabajo de importación se reanuda automáticamente. |
|
Error de permisos |
Si ocurre un error de permisos al leer desde S3 o escribir en un logstore, el trabajo de importación reintenta periódicamente y se reanuda después de corregir los permisos. No se omite ningún archivo durante un error de permisos. Una vez resuelto el problema, el trabajo importa todos los objetos no procesados. |